当前位置:首页>排行榜>问止中医发布中医AI评测基准TCMQA并全面开源

问止中医发布中医AI评测基准TCMQA并全面开源

  • 更新时间 2026-11-05 03:24:06
问止中医发布中医AI评测基准TCMQA并全面开源

2026年9月26日,国际学术平台arXiv发布中医人工智能论文《TCMQA:一个含执业中医师参考基线的3.8万题中医评测基准》(arXiv:2609.33014)。

该研究由林大栋博士带领的问止中医医学研究中心完成并代表公司发布,构建了目前全球规模领先且由持证执业中医师系统性参与标注的中医大模型评测基准TCMQA,旨在客观衡量AI大模型的真实中医水平,厘清“答题能力”与“临床辨证思维”的差异。数据集已在Hugging Face完整开源(TechTCM/TCMQA)。

https://huggingface.co/datasets/TechTCM/TCMQA(需爬梯)

作为国内深耕中医人工智能的先行团队之一,问止中医多年来始终走在行业前沿:从研发AI中医大脑辅助诊疗系统,到持续沉淀海量真实世界临床数据,再到此次以学术论文形式向全球发布评测基准,当多数从业者仍在讨论“AI能不能懂中医”时,问止中医已经用严谨的研究,给出了衡量这一问题的方法与标尺。

01

为中医AI立一把“客观标尺”

为语言模型设立的医学评测,过去几乎全部基于西方生物医学体系。中医有独立的理论框架与文献传统,却长期缺乏系统的测量工具;现有评测普遍规模小、覆盖窄,且很少配套“人类参考基线”。模型即便考出分数,外界也无从判断这究竟意味着“够格”还是“不及格”。这一空白的代价最终由用户承担。

论文指出,患者越来越多地用中文向通用AI询问“某味药是否适合某种证型”“两首方剂是否冲突”“处方写了什么”,而模型无论是否真懂中医,都能对答如流。出于隐私考虑,许多用户还倾向于选择可本地运行的开源小模型,而这类模型恰恰最缺乏中医知识储备。

文字流畅,并不等于答案在中医理论上站得住脚;市面上也几乎没有榜单能报告模型的真实中医能力。TCMQA正是为补上这把标尺而生。

02

研究方法
3.8万真题、百位医师、29个模型
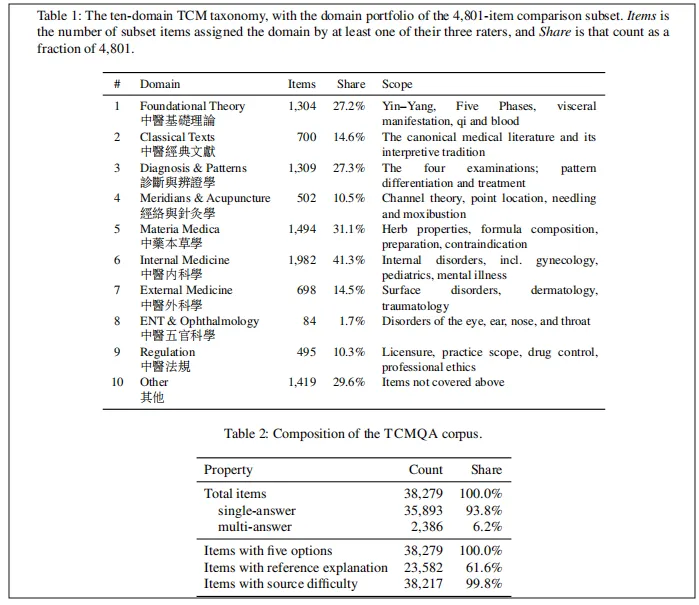
题库方面,研究团队从中医执业医师资格考试题库整理出38279道选择题,统一为五选项格式,其中2386道为多选题,覆盖中医基础理论、中医诊断学、中药学、方剂学、内外妇儿、针灸及中医药法规等十大板块。

人类基线方面,团队邀请101位持证执业中医师通过专门搭建的标注平台作答,累计回收15151份作答;其中4801道题由三位医师独立作答,构成核心对照子集,以多数答案作为“人类参考基线”,测得中医师群体整体准确率为64.9%。作答同时,医师还为每题标注学科归属、按五档评定难度,并可标记题目瑕疵。

模型方面,团队选取来自9个系列的29个指令微调大模型,参数量从0.27B到14.8B,涵盖Qwen、Gemma、OLMo等主流开源模型,在统一流程下完成对照测试,系统比较其在各学科、各难度题目上的表现,并分析模型与医师在答题逻辑上的差异。

发现一:决定中医能力的是“中文语料”,不是参数规模。

29个模型的准确率跨度高达59个百分点,无一接近满分。结论很明确:模型的中医能力主要取决于预训练中文语料,而非单纯增大参数量。

论文给出鲜明对比:一个约12B、以西方语料为主预训练的模型,准确率仅39.6%;而参数量仅为其约八分之一、以中文语料预训练的模型,反而达到60.8%。参数大,并不等于中医知识强。

研究据此指出,对于中医这类高度依赖特定语言与文献传统的领域,“喂对语料”远比“堆大参数”更关键,这也为中医AI的研发路径提供了清晰参考。

发现二:部分模型在共同题目子集的选择题准确率高于三位医师的多数答案基线,“难点感知”却完全错位。

测试中,9个模型整体准确率超过医师64.9%的基线,且全部来自同一中文预训练家族;最优者超出基线达21.8个百分点,在核心子集上达到86.73%。

但高分不等于具备辨证思维。在三位医师全部答错的616道难题上,领先模型反而答对87.34%,甚至略高于其整体平均;与此同时,在8.4%的题目上,医师答对了、领先模型却答错,双方逐题一致性几乎为零。中医师眼中的难题,AI往往轻松拿下;而一部分临床辨证类题目,AI反而出错,两者对“哪里难”的感知完全错位。

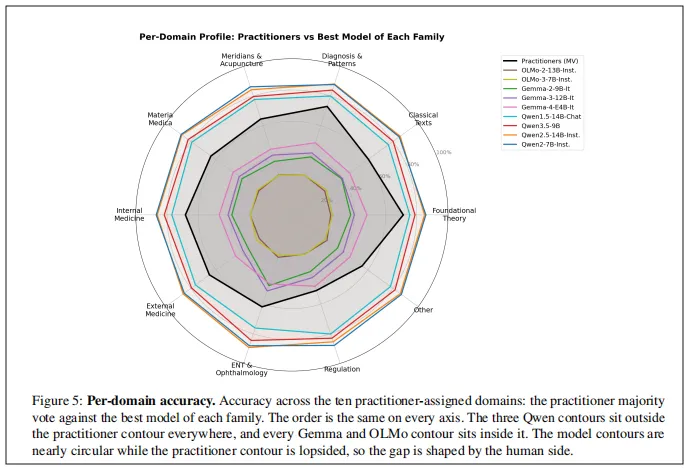
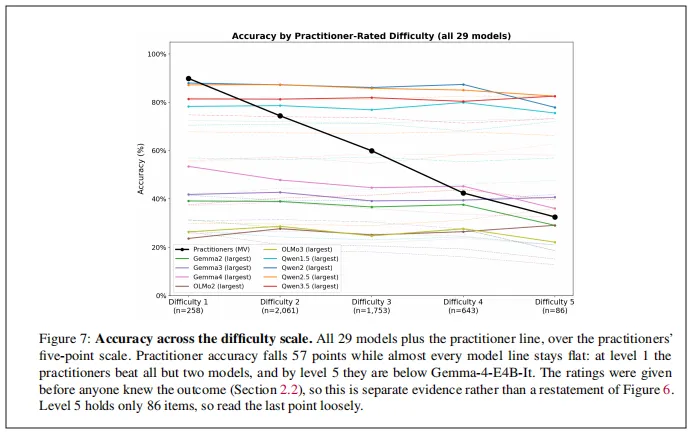
从学科看,模型在偏重记忆的“法规”板块领先最多,在最需临床推理的“诊断与辨证”板块短板最明显。研究还发现,随题目难度升高,医师准确率最多相差57个百分点,而多数模型的表现几乎纹丝不动。

发现三:AI“错得很笃定”,多选题是普遍短板。

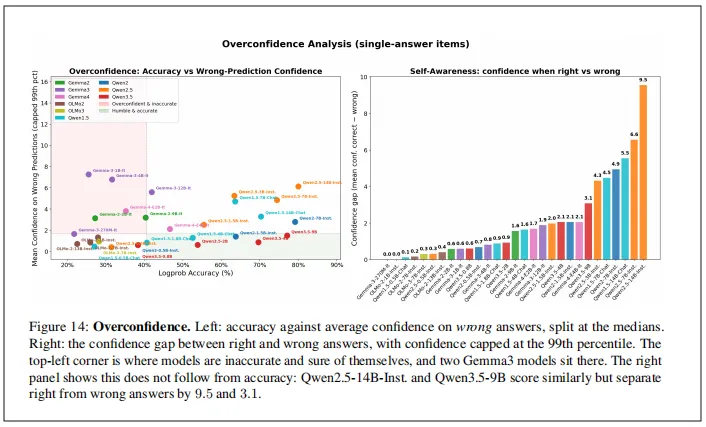
置信度分析还揭示了模型的“过度自信”:即便答错,许多模型仍给出高度确定的输出,可谓“错得很笃定”。难以对自身的不确定有所觉察。多选题上这一缺陷尤为突出——多正确选项题目要求“既不漏选、也不误选”才算答对,而模型普遍倾向于把多选题当单选题处理,部分弱模型有此倾向;强模型则可能选项数接近正确数,仍在精确匹配上失分,暴露出推理与判别上的系统性不足。

03

结论
笔试高分≠临床诊疗能力

TCMQA以大规模实证表明:大模型在中医纸笔考试中可以取得亮眼分数,但考试成绩不等于临床诊疗能力。模型依托文本统计与知识记忆作答,与中医师基于望、闻、问、切“四诊”、围绕病机综合推演的辨证体系存在本质区别。

论文同时指出,目前也没有任何模型接近能力饱和,意味着其真实水平仍有相当大的提升与检验空间,不能仅凭高分就把模型视为可独立执业的中医师。

这项研究最突出的价值,是以大规模执业医师标注数据集,为中医AI建立起客观、可复现的评价标尺。

在此之前,行业很难判断一个AI究竟“懂不懂中医”,不少产品文字流畅,内在知识却存在大量漏洞。题库、医师作答、评测框架与逐题结果的完整公开,使任何团队都能据此检验和迭代自己的模型。团队更选择彻底开源:“后续研发、验证中医AI产品,都可以直接站在我们的肩膀上继续向前。”

问止中医工作人员表示,研究并非制造“人机对立”,而是帮助行业分清模型能力的可靠边界。考试回答的是记没记住,临床真正要回答的,是面对一个具体的人,如何在复杂的四诊信息中抓准病机、随证立法。唯有理性看待AI、用其所长、补其所短,中医人工智能才能走得更稳、更远。

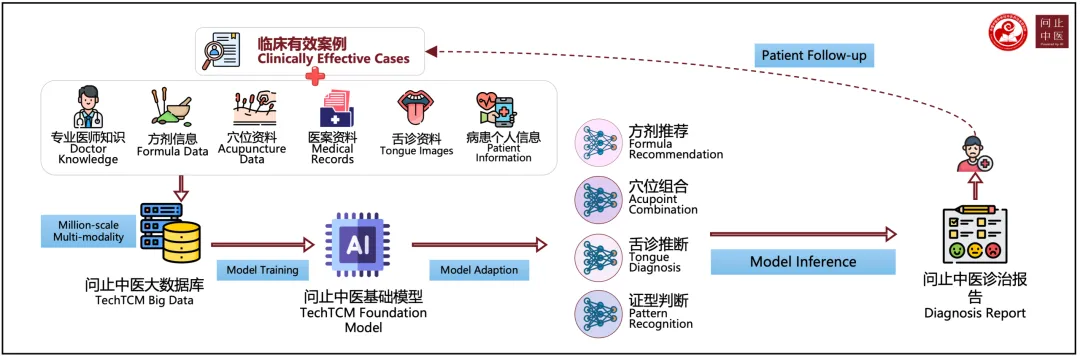
值得说明的是,本次TCMQA基准的评测对象为通用大语言模型,而问止中医旗下核心产品「中医大脑」并不属于同一品类。中医大脑是一套基于医学规则与海量真实案例训练的专用诊疗推理引擎,而非开放式、发散式的通用大语言模型。它完全围绕临床中医师的真实诊疗路径深度定制,训练数据全部源自中医临床案例,聚焦于辅助医师完成辨证、立法、处方等临床核心环节,与面向通用问答场景的大语言模型在产品定位与技术路径上均有本质区别,因此未纳入本次评测范围。
站在行业发展视角看,随着医学人工智能的持续演进,AI真正的长期价值,在于从「对话答题」走向「深度嵌入临床工作流」。相较于“AI替代医师”的设想,更符合医疗本质的未来路径,是AI作为标准化、高效率的辅助工具,融入诊察、辨证、处方、随访等全诊疗环节,帮助中医师提升诊疗效率、规范诊疗路径、拓展服务边界,最终形成人机协同、优势互补的中医诊疗新形态。

随着中医AI产品加速进入大众视野,这套由一线执业医师参与、向全社会开放的基准,有望成为行业长期、中立的基础设施。

• • • END• • •

随机文章