机器发现 · 日报 2026-11-04
④ 计算与系统(下)
重放一次基于评判的代码评测:语法检查暴露高分未显示的损坏
Impossible Code, Barely Changed Score: A Replay Study of Judge-Based Evaluation|arXiv|预印本,未经同行评审|2026-11-04|UNSW Sydney
要点: 作者重放一次基于评判的代码评测:Qwen-2.5-7B-Instruct 的 base model 与两个 checkpoint 重新生成答案,训练过的 checkpoint 产出的答案多数语法不合法。强评判给出的 Pass@32 只降了约 3 个百分点。
研究动机: 编程任务里,执行测试能直接给出正确性证据,但耗时且需要沙箱,许多流程改为让语言模型读代码打分,这类判断也能当作训练奖励。作者要考察的是,这类选择会带来哪些被高分掩盖的弱点:评判模型偏好看起来熟悉的答案,优化学到的评分器可以在真实质量下降时抬高分数,模型也可能利用检查器。构造的基准能控制输入构成,部署模型产出的答案却会变。本研究考察基于评判的分数能否显示这种变化,也考察重复评测时分数是否会在答案变差后仍然很高。
实验设计: 作者重放一次已有评测:421 道编程题,比较 Qwen-2.5-7B-Instruct 的 base model 与两个 checkpoint,分别用执行测试奖励和强 AI 评判奖励做 GRPO 训练。原研究每题存 32 个答案,重放从发布的 checkpoint 在相同题目、不同硬件上每题生成 128 个,交由不运行代码的 Qwen-2.5-72B-Instruct 评判打分。作者另设语法闸门:答案须同时通过评判和 Python 的 ast.parse,再与执行测试对照。
结果: 重放后,SLJ-trained 的不合法答案比例由 0.42% 升到 66.90%,HumanEval 与 MBPP 两个基准上都上升(图 1)。base model 的对应比例几乎没有变化。同一批第二次运行的答案上,强评判的 Pass@128 为 96.44%,执行测试为 28.27%。作者指出,评判经常批准语法不合法的答案;这类错误在不合法答案稀少时影响很小。
结论: 作者认为,基于评判的高分可以与生成代码的大面积损坏同时存在,建议在每个基于评判的分数旁报告能通过语法检查的答案比例。
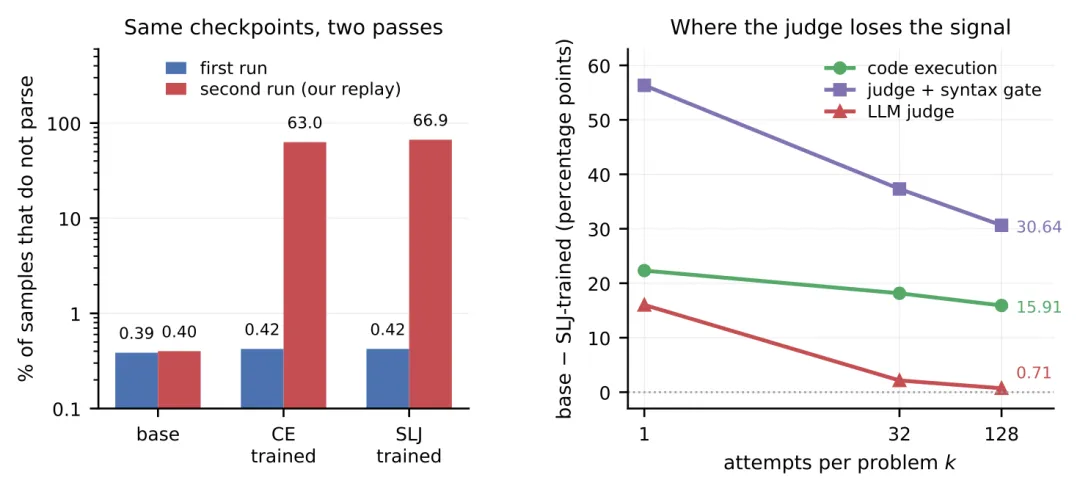
图 1|重放前后各 checkpoint 无法解析的代码比例,以及 base model 与 SLJ-trained 在评判和执行下的分差随每题尝试次数的变化。图源:原文 Fig. 1
意义与启示: 作者还建议,每次运行保留生成的答案、评判的输入与判定、生成设置和模型文件的校验和,便于日后查清两次运行之间的差异。
arXiv: 2611.01572
https://arxiv.org/abs/2611.01572
Agent 合成并经形式化验证的数据库引擎
Stop Handcrafting Your Engine! GenDB-V: Towards AI-Generated and Formally Verified Database Systems|arXiv|预印本,未经同行评审|2026-11-04|Cornell University
要点:作者构建 GenDB-V,让 agent 在固定的形式化合成目标下同时合成数据库引擎代码与证明,再由独立流水线验证。它为全部 28 个 SQL 模板生成了带证明的实现。
研究动机:数据库领域五十多年来围绕两个问题推进:系统如何跑得更快,以及如何保证正确性。性能取决于硬件与负载,两者的变化反复带来代价高昂的重新设计与重新实现。正确性同样困难:EET 在五个数据库系统中发现 35 个逻辑 bug,而形式化验证需要大量人力,验证 seL4 的 8,700 行 C 内核约需 20 人年。近期 LLM 让 agent 能优化软件并生成机器可检验的证明,GenDB-V 由此让 agent 合成针对硬件与负载特化、且经形式化验证的数据库引擎。
实验设计:作者在 TPC-H SF100 的 22 个模板和 SEC-EDGAR SF3 的 6 个模板上评测,每个模板用三种参数绑定。agent 先在不跑验证的模式下编译、运行并计时候选设计,比较后只为最快且达标的设计写证明;存储与查询可联合优化,也可固定为原始列数组、只优化查询。代码与证明由 Verus 在隔离流水线中对照固定目标检查。
结果:跨模板与线程数,联合优化存储与查询的模板实现相对 DuckDB 与 Umbra 的几何平均加速在 TPC-H 上为 51.6× 和 22.0×,在 SEC-EDGAR 上相对 DuckDB 为 61.3×(图 2)。同一个通用引擎在 TPC-H 上相对两者的总工作负载加速为 1.27–3.4×。该引擎接受 TPC-H schema 上 SQLSpec 支持片段内的任意良类型查询,并在运行时应用合成中已验证的重写规则。
结论:作者认为,结果显示形式化正确性可与相对既有引擎的大幅加速并存,是一条通往 AI 生成且经形式化验证的数据库系统的有前景路径。
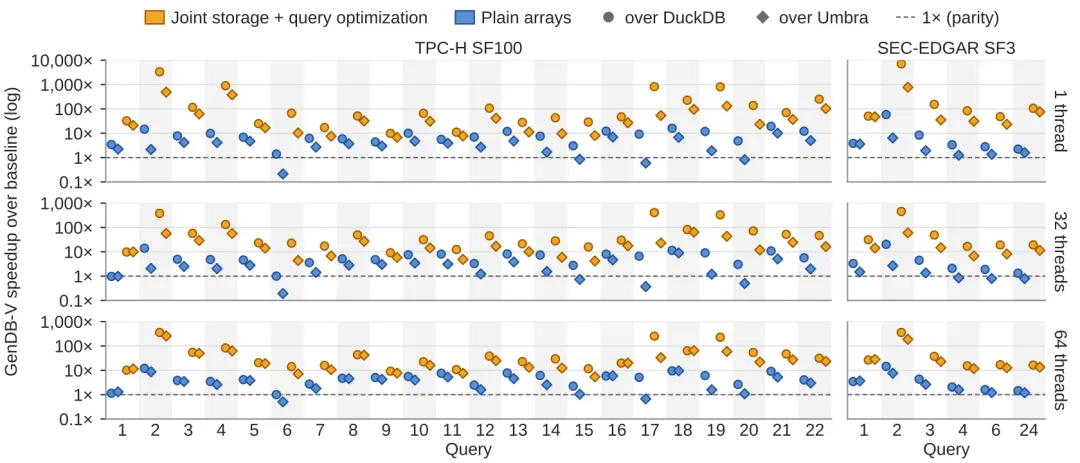
图 2|模板实现相对 DuckDB 与 Umbra 的逐查询加速。图源:原文 Fig. 4
意义与启示:作者指出,与以往验证项目所需的大量人力相比,模板合成花费约 2,310 美元,通用引擎合成则花费 1,229 美元。
arXiv: 2611.02779
https://arxiv.org/abs/2611.02779
心智推理策略的演化与审计
CogRSI: Evolving and Auditing Cognitive Reasoning Strategies|arXiv|预印本,未经同行评审|2026-10-31|南洋理工大学、斯坦福大学、VinUniversity
要点: CogRSI 把标注谁看见事件的读者、写规则的自我改进循环和对规则的语义审计合在一起,审计发现 86.7% 的学习规则在至少一个声称覆盖的情形给出错误答案。
研究动机: 自我改进系统按分数保留产物,但循环学到的策略能否迁移到训练数据之外,以及帮助提升的策略是否也正确,这两个问题仍待回答。递归自我改进让模型修改提示、工具或代码,并保留有帮助的改动;心智推理是它的一项困难测试,因为系统要追踪每个人看到、被告知和相信什么。心智理论基准在故事和对话里探查这些状态(图 3)。看似通用的技能可能依赖表面线索,现有按分数保留的做法没有检查策略本身是否成立,这使迁移与规则正确性成为两个分开的检查对象。
实验设计: 读者先标注每句话的目击者,再带标注和不带标注各读一遍,用短原则裁决分歧。策略循环维护规则库,候选更新须在开发题上超过 3 分校准边际,门控变体还须通过 96 对反事实。语义审计让两个未写规则的模型把每条规则译成代码,在约 85k 个已知答案的小故事问题上运行。
结果: 专家原则下 CogRSI 在八个基准的主测试平均达 73.1,同 token 成本的自一致性为 68.7。在未见的 BigToM 对上,门控库的配对有效率达到 96.6%,专家原则为 94.5%。语义审计显示,准确率不能区分有效与无效规则,门控也没有改变这一点;许多规则在它们声称覆盖的情形里给出错误答案。迁移来自演化出的原则。这些结果使用同一读者、backbone 和采样,只改变原则。
结论: 作者认为,推理他人心智的自我改进系统既需要检查策略做了什么,也需要检查策略说了什么,语义审计应纳入策略注册。
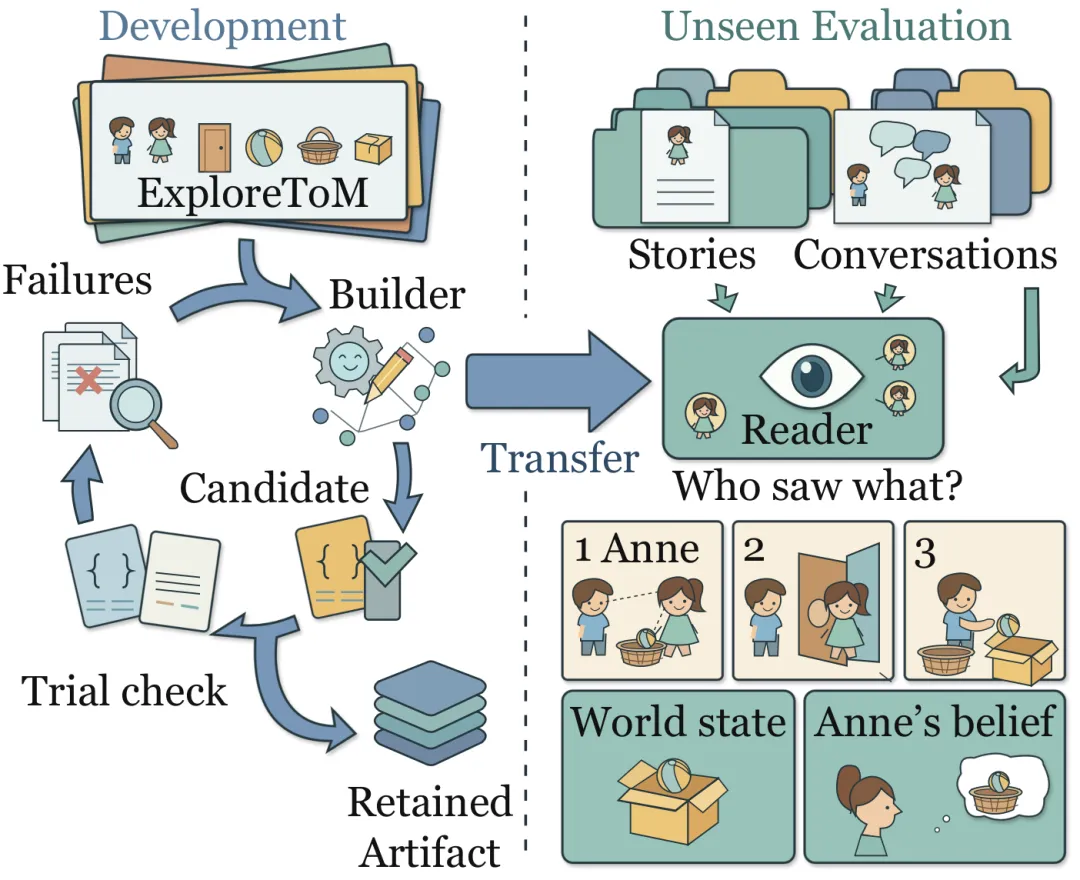
图 3|任务示意:在一个生成器上学到的策略,须在未见基准上追踪谁看到了什么。图源:原文 Fig. 1
意义与启示: 作者指出,回放显示当前候选很少能通过审计,瓶颈因此从选择策略转向提出正确策略。
arXiv: 2611.01113
https://arxiv.org/abs/2611.01113
论文修订轨迹与 AI 评审打分
Can AI Reviewers See Your Efforts to Improve Your Paper? A Large-Scale Study of Paper Revision Trajectories|arXiv|预印本,未经同行评审|2026-11-04|MBZUAI、Virginia Tech、University of Maryland、University of Notre Dame
要点: 作者构建 PaperTrajectory-2026,收录 6,959 篇论文的修订轨迹,让八种 AI reviewer 独立评审同一论文的不同版本,检验打分是否反映修订改进,以及用户意见能否抹掉修订带来的分数优势。
研究动机: LLM 越来越多用于提供科学反馈,支持研究与审稿流程。作者修订论文时会补实验、改方法、补强证据、改进呈现,但 AI 评审分数是否反映这些改进仍不清楚。已有研究考察 AI 评审的反馈质量与缺陷,以及模型评审与人类评审的强项和盲点;自动改写研究显示,改写论文或只改修辞而不动已报告的科学内容,都会改变 AI 评审分数。这些工作说明呈现会影响 AI 评价,但没有确定作者补上科学证据后分数如何响应;修订轨迹可以检验独立的 AI 评审是否跟随同一论文的质量变化。
实验设计: 作者从 2026 年五个 AI 会议的接收论文重建 arXiv 版本轨迹,相邻版本间隔超过 30 天,配成修订对,各会议分布见图 1。GPT-6 Astra 按 14 个修订维度比较两版稿件,并单独判断整体质量变化。五名研究生级研究者隐藏标签后核验 150 对。八种 AI reviewer 独立评审匿名后的每个版本,看不到版本配对与改动记录。
结果: 多数实质性改进后分数不变:各 reviewer 下有 55–78% 保持原分。提分比降分常见,但即便最敏感的 reviewer,提分比例也低于一半;在人工确认改进的子集里,每个 reviewer 仍让一半以上的可用分数保持不变。八个 reviewer 共同评过的修订中,只有七篇被全体提分。用修订维度预测提分的分类器 AUC 为 0.51–0.64,对概率准确度的改善很小。GPT-5.5 在只批评修订版时,54.3% 的案例分数低于原版。
结论: 作者在结论中指出,这些发现说明需要能识别实质性改进、且在用户偏好变化而没有新科学证据时保持稳定的 AI reviewer。
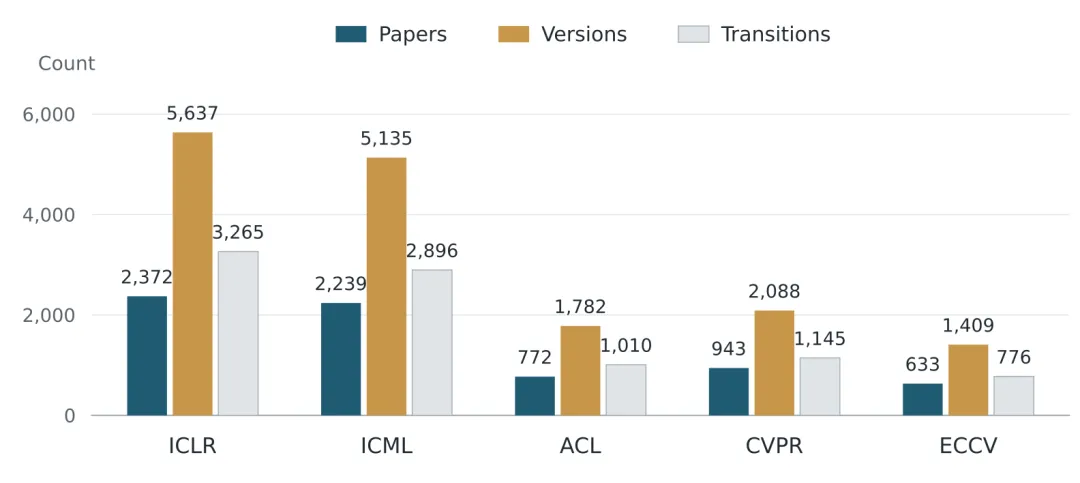
图 4|五个 2026 年 AI 会议的论文与修订对分布。图源:原文 Fig. 2
意义与启示: 作者指出,给修订版加分与维持这一分数优势是两件事,提分频率本身不能说明提分有多稳定。
arXiv: 2611.02244
https://arxiv.org/abs/2611.02244
外骨骼助力策略在人体反馈下自主改写
Recursive Self-Improvement of Exoskeleton Assistance Policies through Human-in-the-Loop Feedback|arXiv|预印本,未经同行评审|2026-11-04|中国科学院大学人工智能学院、中国科学院自动化研究所多模态人工智能系统全国重点实验室
要点: 作者让 LLM agent 自主生成并修改外骨骼助力控制代码,在三个任务上由参与者试戴评价,并在试次之间按反馈改写代码,比较 GPT、DeepSeek、GLM 和 Kimi 首轮反馈前后的策略。
研究动机: 外骨骼助力能否见效,不只取决于驱动器能力或机械设计,还取决于助力如何与佩戴者动作配合、如何适应个体反应。用预设助力曲线时,时机、幅值等控制参数须逐项选定,开发因此仍与控制器设计、实验评估和反复改进绑在一起。人在回路的优化减少了手工调参,但每次调整都需要反复的人体评估,收益同时受控制器定制和佩戴者适应的影响。LLM 已被用于理解指令和生成动作,但命令执行成功不等于肌肉负担下降;如何按连续人体试次的反馈自主修改可执行助力代码,仍未解决。
实验设计: 作者用一名 20 岁男性参与者试戴肘部外骨骼,做 2 kg 哑铃弯举三次、把 2 kg 箱子搬到桌上、搬运约 17.5 kg 水袋走两步。GPT(6-astra、6-sol)、DeepSeek(V4.1-Flash)、GLM(GLM-5.3)、Kimi(Kimi-K3)各自生成可执行控制代码并分析反馈,每个任务跑起始策略和第一轮反馈后选中的策略。操作员起停每个试次,肌电与无外骨骼时的同一任务比较。
结果: 第一轮反馈后,参与者用各模型选中的策略完成了全部任务;起始策略下 DeepSeek、GLM、Kimi 的哑铃弯举和 Kimi 的水袋搬运未能完成。搬箱任务中,6-astra 起始策略下右、左肱二头肌平均激活分别比无外骨骼基线低 67.8% 和 55.7%。水袋搬运中,修正后的 6-astra 使右、左肱二头肌激活分别低 44.6% 和 19.8%。参与者对修正后 6-astra 弯举策略的反馈好于起始版本,但两块肌肉的平均激活都升高。
结论: 作者认为,反馈后的选中策略相对无外骨骼基线降低了肱二头肌激活,感知助力随模型和任务而变。
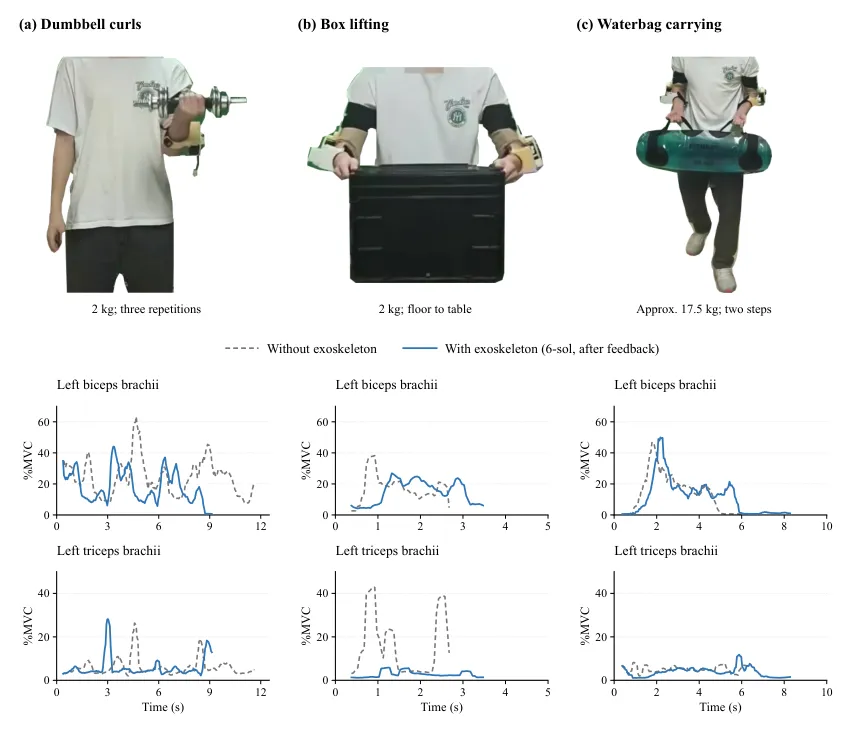
图 5|三个任务的动作与有、无外骨骼时的肱二头肌、肱三头肌肌电时程。图源:原文 Fig. 2
意义与启示: 作者还指出,按试次人体反馈改写助力代码,可相对无外骨骼基线降低肱二头肌激活,并使感知助力随模型与任务变化。
arXiv: 2611.01581
https://arxiv.org/abs/2611.01581
