科技虫致力于分享一些优秀的开源程序和客户端软件。比如商城、小程序、H5、网站、办公系统、OA、CRM、ERP、内容管理系统CMS、物联网系统、智能硬件、人工智能AI、大数据分析、智慧大屏、工具类软件、编程类软件工具、服务器运维、网络安全、前端技术、后台技术。
为了方便大家,我把往期所有发表过的内容按分类整理成一个文档发表到了gitee上。地址:https://gitee.com/php_andy/software-box喜欢的可以去给个免费的star,你的鼓励是我继续创作的动力。非常感谢。写 Skill 的人大概都经历过这种时刻:改了两句话,感觉“应该更好了”,但到底好了没有,谁也说不清。上线三天,同事说“它现在不按格式输出了”,你翻遍SKILL.md也找不出是哪次改动惹的祸。
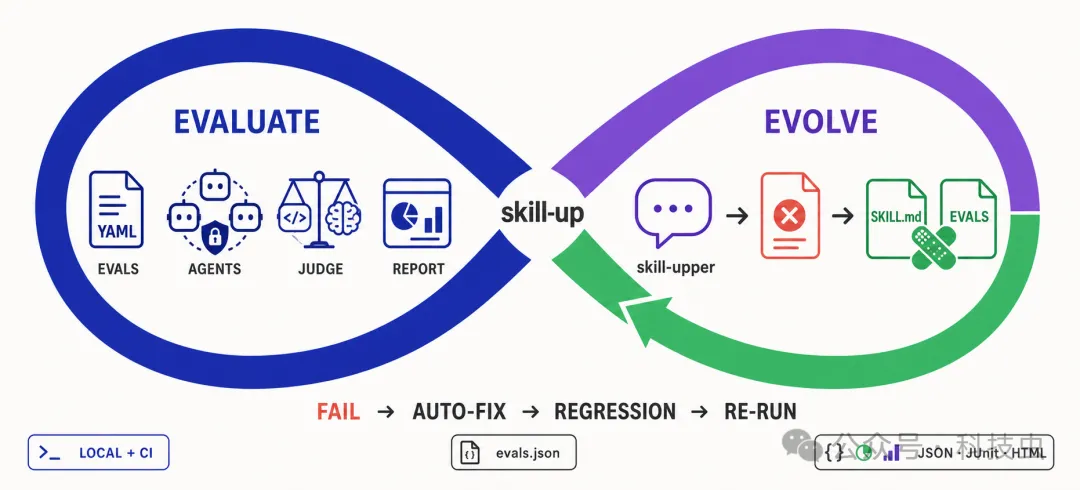
阿里开源的skill-up就是来解决这件事的——一个用 YAML 定义用例、给 Agent Skill 打分、顺手把改进闭环也做掉的命令行工具。
项目基础档案
| |
|---|
| skill-up(配套 Skill:skill-upper) |
| github.com/alibaba/skill-up |
| alibaba.github.io/skill-up(含中文手册) |
| |
| Go(CLI 本体,cmd/skill-up + internal/ + pkg/) |
| macOS / Linux 原生;Windows 有单独文档与限制说明;CI 场景为 Linux + Docker |
| Star 约 1.4k,Fork 124,Commits 465 |
| 维护 Agent Skill 的开发者、做 AI 应用测试的工程师、需要给 Agent 加回归门禁的团队 |
核心功能亮点
1. 声明式评测:把“我觉得”变成 eval.yaml
过去做 Skill 对比,常见做法是建一堆run-1、run-2文件夹,靠肉眼翻输出。skill-up 改成一份eval.yaml加cases/*.yaml:环境、引擎、模型、用例全部写进配置,能进 Git、能被 review、能被 diff。
解决的是“评测过程不可追溯”的痛点,换来的是同一套用例反复跑、结果可横向比。
2. 多引擎横评:不绑死任何一家客户端
内置claudecode、codex、qodercli、qwencode四个引擎,还能通过engine.custom接自己的本地命令或 HTTP 服务。
同一份用例,换个 engine.name 就能看看“这个 Skill 在别的 Agent 里还灵不灵”——这是单一客户端工具做不到的。
3. 判分分三层,贵的地方才花钱
支持rulebased(规则匹配,几乎零成本)、script(脚本校验文件与工作区变化)、agentjudge(模型打分,适合开放式任务)。
更关键的是Judge 可以单独配引擎和模型,不继承被测 Agent 的配置——避免“自己给自己打分”。
4. 多轮对话 + 用户模拟
user_simulator能扮演用户,根据 Agent 的真实回复追问,而不是照着脚本念台词。适合评测“会反问、会确认需求”这类交互型 Skill,比如二十问猜物、需求澄清。
5. 报告与 CI 一条龙
输出grading.json、benchmark.json、benchmark.md、result.json,外加 JUnit XML 和 HTML 报告,顺手就能接 Jenkins、GitLab CI。仓库自带 GitHub Action,一次 PR 可同时跑多个引擎。
6. skill-upper:把闭环交给对话
这是仓库里唯一的可编辑 Skill 源(skills/skill-upper/)。你只需要说一句“用 skill-upper 评测这个 Skill”,它会读 SKILL.md、造用例、跑 CLI、读失败报告、改 Skill 或补用例、再跑一轮。
值得点赞的一点:官方明确写了“候选方案没有被证据支持时,保留原版也是合法结果”——这种克制,比“一键变强”的叙事可信得多。
适用场景 & 适配人群
适合用的人
- 个人开发者:手上维护 3 个以上 Skill,改完想知道有没有回退。
- 团队协作:Skill 库多人共用,需要一个“合并前先跑一遍”的验收门禁。
- AI 应用测试:想把 Agent 的行为从“人工点点看”升级成自动化用例。
- 自定义 Agent 开发者:skills: [] 就跑纯 Agent 评测,不需要 Skill 也能测引擎本身。
- 运维 / CI 负责人:想在 PR 流程里挂一道模型行为检查。
没必要用的人
- 只写一两条一次性提示词,用完就扔,跑评测的时间比写提示词还长。
- 没有模型 API Key 或额度预算——评测是真调模型,不是免费模拟。
- 想要“开箱即用的 Skill 市场”,这项目是评测工具,不是资产库。
实测体验 & 客观优缺点
上手难度:中等偏上。装 CLI 是三十秒的事,真正的门槛在理解它的四层概念——environment(跑在哪)、engine(谁在跑)、judge(谁来判)、user_simulator(谁来演用户)。第一次写 eval.yaml 大概率要对着文档抄一遍。
界面体验:纯 CLI,没有 GUI,输出是结构化文件。想要漂亮看板得自己接 HTML 报告或 CI 展示。这对习惯图形化的人不友好,对工程师反而是加分项。
性能表现:取决于模型响应速度,用例并行度可调(--parallelism)。用例越多、引擎越多,跑一次越慢——这也是它适合放 CI 而不是“随手跑一下”的原因。
核心优势
- 配置即文档,评测套件能跟着 Skill 一起版本化。
- 中文文档完整(README.zh.md + 中文手册),国内团队友好。
目前的不足
- GitHub Action 限定 Linux + Docker,Windows 本地开发要另配(官方有单独 Windows 指南)。
- agent_judge 有主观性,判分标准写不细,结论就不稳。
- 项目仍处早期:schema_version 为 v1alpha1,25 个 Issue、21 个 PR 在跑,配置字段后续可能调整,别把它当稳定 API 用。
极简快速上手教程
第 1 步:装 CLI
curl -fsSL https://raw.githubusercontent.com/alibaba/skill-up/main/install.sh | bashskill-up --version
第 2 步(可选,推荐):装 skill-upper,让 Agent 帮你写用例
npx skills add https://github.com/alibaba/skill-up/tree/main/skills/skill-upper -g -a claude-code -y
第 3 步:写一份最小评测(先测纯 Agent,不装 Skill)
evals/eval.yaml:
schema_version: v1alpha1environment: type: noneskills: []engine: name: codexcases: files: - evals/cases/agent-response.yaml
evals/cases/agent-response.yaml:
input: prompt: Reply with READY.expect: must_contain: [READY]
第 4 步:先校验,再跑
skill-up validate ./evals/eval.yamlskill-up run ./evals/eval.yaml
跑完会在工作区生成 result.json 等报告,想单独出报告:
skill-up report ./result.json
第 5 步:想省事就让 Agent 全程代劳
在含 SKILL.md 的项目里开一个会话,直接说:
用 skill-upper 评测这个 Skill:读 SKILL.md,找出最重要的行为,造真实用例和合适的判分标准,校验配置并跑 skill-up,然后总结结果和影响最大的失败点。
装之前记得先配好模型 API Key,否则第一步就会卡住。
全文总结
skill-up 的定位很清楚:它不是帮你写 Skill 的工具,而是帮你判断 Skill 到底行不行的工具。声明式用例 + 多引擎 + 分层判分 + CI 集成,把 Agent Skill 的“手感调优”拉回到可复现的实验里。适合已经有多份 Skill、开始被回归问题折磨的开发者与团队;只想快速试水的人,先用 skill-upper 跑一个最小用例再决定。
你现在的 Skill 是怎么“验收”的——靠手动点几下,还是有真在跑的回归用例?评论区说说你的土办法。