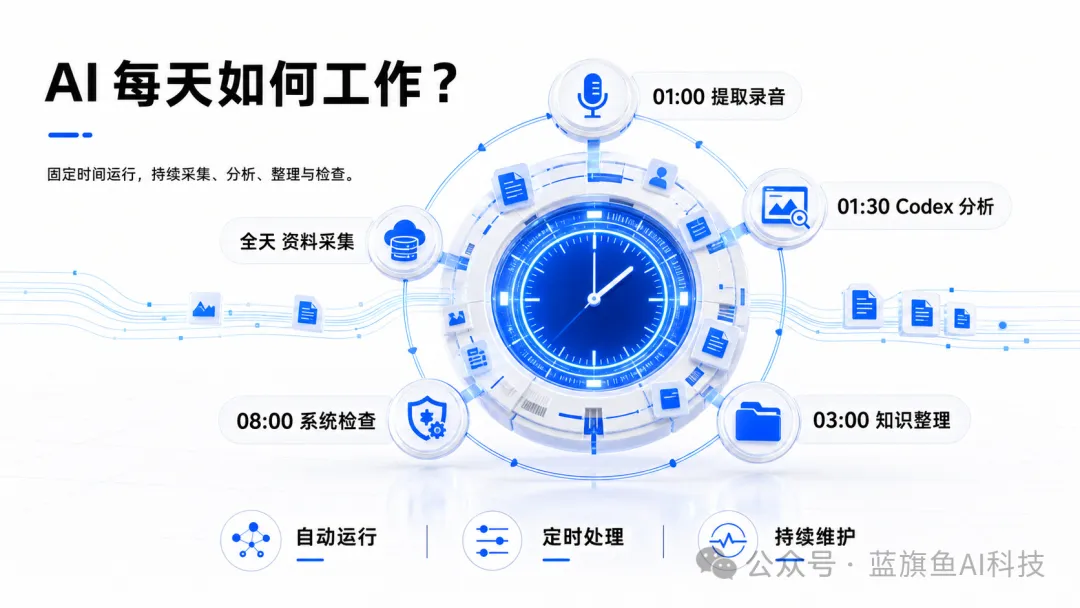
▲ 好的智能体不是一次性回答,而是持续值守
演示是别人排练好的,交付是你自己验收的。没有最好的工具,只有接得住的交付。
10 月 16 日晚上,蓝旗鱼 AI 俱乐部深圳线下场。开场我先立了个规矩:今晚不做排行榜。演示视频都很惊艳,但演示不付电费。大家只回答三个问题:你用过什么?它替你做了什么?哪里不值得用?失败、成本、权限和人工返工,同样重要。
01 为什么今晚不做排行榜
因为排行榜比的是分数,生意比的是「这活交给它,我放心吗」。所以每个人分享时,只准回答六个问题:它属于哪一类?背后是谁、用什么模型?你用它做了什么真实任务?最后交付了什么?中间你干预了几次?什么情况你不会用它?
这六个问题逼着大家说清一件事:输入是什么、过程发生了什么、最后交付了什么。凡是说不清交付物的分享,我们一律当作「看广告」处理。
「演示是别人排练好的,交付是你自己验收的——这两件事隔着一条街。」
02 四类智能体,真实定位与限制
第一类 · 综合工作型
ChatGPT Work、Claude Cowork、Grok、Manus——从资料和研究出发,最后交付办公成果。共同方向是读资料、规划步骤、调用工具;真正差异在本地文件、生态连接、云电脑和长任务稳定性。共同限制:复杂结论仍要人工验收。
第二类 · 国内办公型
WorkBuddy、豆包工作、千问办公,还有内测中的微信小微——更贴近中文文件和本地办公习惯。对中文团队友好,但不同客户端、不同版本能力可能不一样,高级能力和连接器要实测,不能只看宣传页。
第三类 · 编程开发型
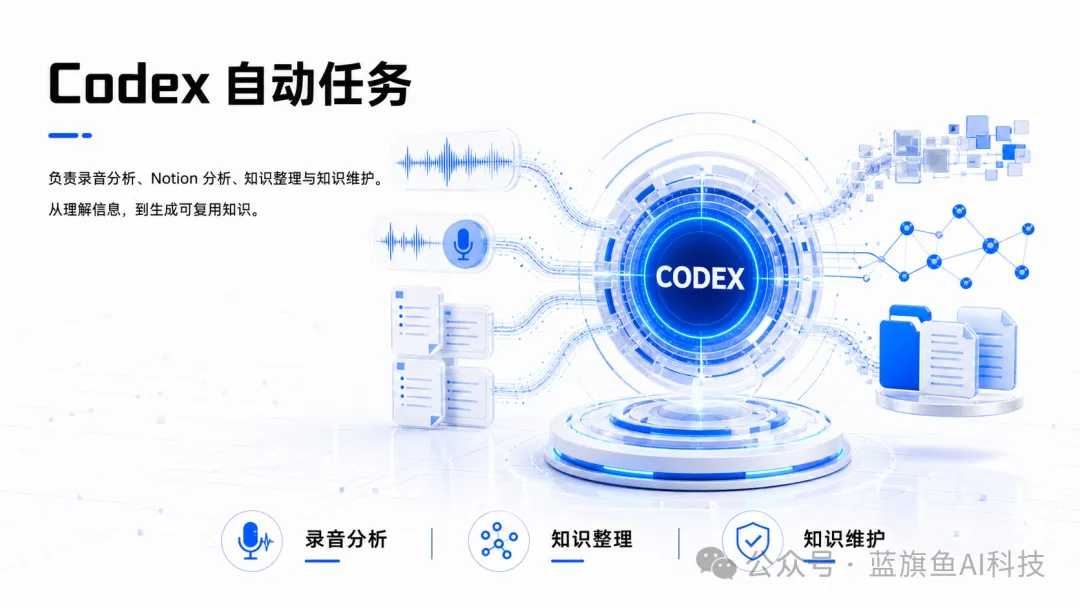
Codex、Claude Code、Cursor、TRAE——从一句需求到代码、测试与交付。IDE 内协作适合已有项目,终端代理能规划、执行、审查,对话建应用适合原型和业务工具。硬规矩:必须先定义测试和验收标准,否则越自动越危险。
第四类 · 长期运行型
Hermes、OpenClaw、腾讯 QClaw、扣子——从「一次回答」变成「持续值守」:记忆、定时任务、消息入口。这类最容易出彩也最容易出事,安全、权限和运维责任必须想清楚再上。
▲ 长期代理的价值在你离开之后,风险也是
整场沙龙收敛出一组数字:没有最好的工具,只有接得住的交付。
03 选型只看四件事
沙龙最后大家收敛出一个简单的决策过滤器:交付什么(回答、文件、代码,还是持续运行的流程);数据在哪里(公开网页、本地电脑,还是企业内部系统);要跑多久(一次任务、每天重复,还是长期无人值守);谁来负责(出错谁发现、谁复核、谁能立即停止)。
拿外贸询盘跟进举例:智能体适合做的是提取客户、产品、数量、目的港,识别缺失字段并追问,生成带依据的回复草稿;但价格、交期、承诺这三样,必须留人工关口。系统要做的是写入 CRM、保留原消息版本、定时提醒和状态流转。
选哪个工具真的可以换,但验收标准不能模糊。你的企业缺的可能不是更强的模型,而是一条跑得通的流程。
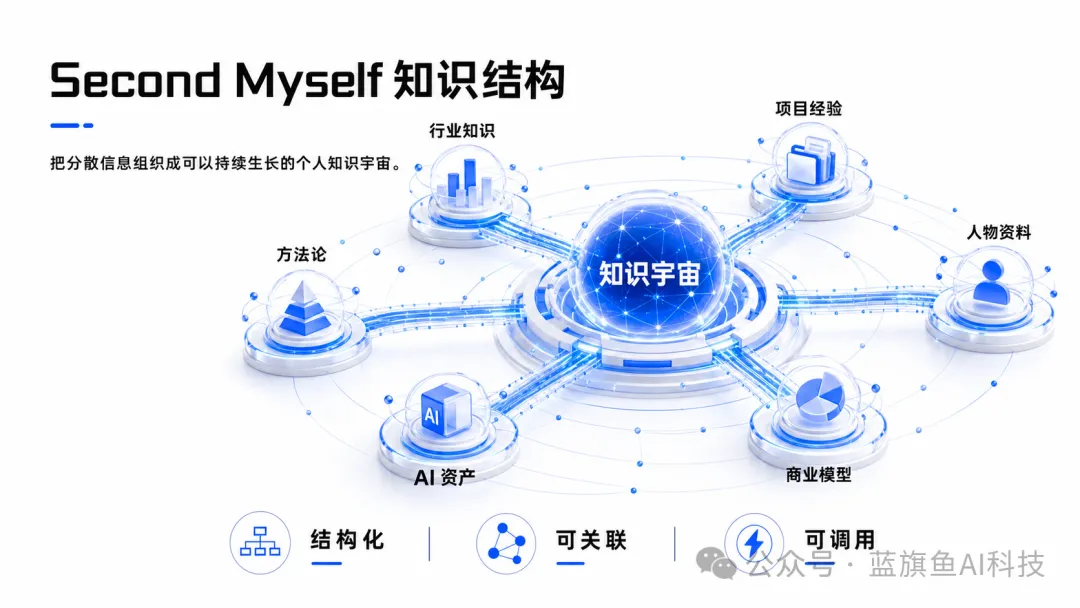
▲ 有知识库的 Agent,才真正接得住你的经验
红线提醒:AI 生成回复草稿可以,直接发客户不行。凡是涉及钱、货、账号、合同、客户的动作,一律停下来等人工确认。
写在最后
每场俱乐部活动,我们只聊三样东西:一个真正省时间的场景、一个踩过的坑、一个最想尝试的任务。
评论区聊聊:你愿意把哪件事交给 AI?今天就能交的、试运行后再交的,还是暂时谁都不能交的?