一文看懂如何做Agent 评测及提升精准度(建议收藏)
- 更新时间 2026-11-04 11:46:16
上篇文章我们跑通了 Agent Eval,但万一执行失败了,该怎么排查原因呢?
更多Agent评测系列爆文,可以戳:
是模型理解错了,是工具选错了,是参数传错了,是工具返回异常,是重复调用,还是它明明已经拿到答案却不肯收工?
如果只能看输入和最终的输出,这些问题一个都答不上来。
1 先看一个Agent Bug
用户说:帮我分析 payment 模块,重点找可能导致资金损失的问题。
Agent 最后交出的答案是这样:
重复扣款 支付成功但订单状态未更新 超时关闭与支付成功竞争 支付结果和订单状态不一致
看起来完全正确。只看 Final Output:PASS。
但把执行过程打开,画面是这样的:
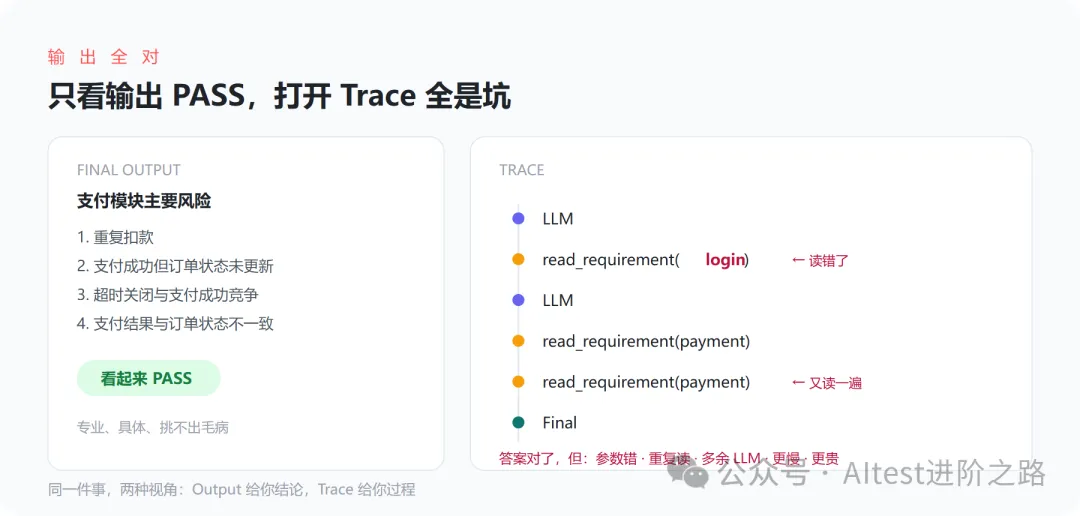 图 1 · 输出全对,过程却有问题
它先读了 login,读错了;再读 payment;还不放心,又把 payment 读了一遍。
这时候大家应该看出问题来了。第一次工具参数错误、重复读取、多余的 LLM 调用、更高的延迟、更高的 Token 消耗。
输出是结果,Trace 是过程证据。
2 Output 与 Trace
Final Output 只告诉你“支付存在重复扣款风险”,这是结果。它不会告诉你这个结果是怎么得来的。
Trace 才会告诉你过程:用户提问 → LLM 判断 → 调用 read_requirement(module=payment) → 拿回 payment.md → LLM 生成 → 结束。
所以,Output 是结果,Trace 是过程证据。
3 Observability
在 Agent 场景里,Observability(可观测性)可以这样理解:通过运行过程中产生的 Trace、Span、Metric、Error 等数据,理解 Agent 内部到底发生了什么。
OpenAI Agents SDK 当前内置 tracing,一次 Agent Run 可以记录 LLM 生成、工具调用、Handoff、Guardrail 和自定义事件,并通过 Trace / Span 组织起来。
4 为什么 Agent 比传统程序更需要可观测
传统代码是这样的:
if module == "payment": read_payment()执行路径开发人员提前就知道了。
Agent 不是:LLM 判断 → 选工具 → 生成参数 → 拿工具结果 → 再判断。这条路径在运行之前未必完全可知。
测试工程师因此需要一种手段:把 Agent 实际走过的路重新还原出来。
这就是 Trace 的价值。
5 Trace 和 Span
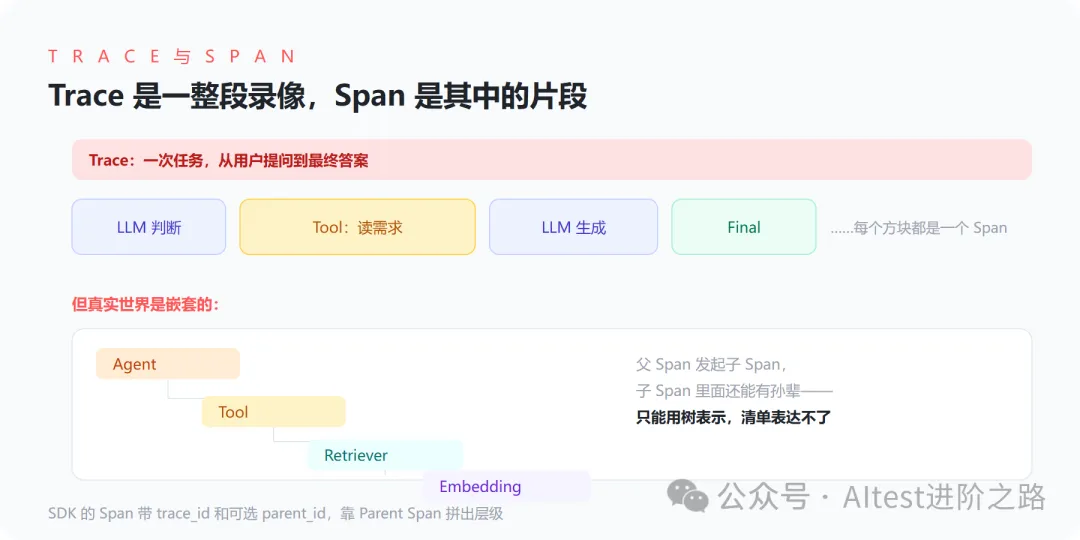 图 2 · Trace 与 Span 的层级关系
Trace:一次 LLM / Agent 应用从开始到结束的完整执行记录。从用户发起“分析 payment”,到 Agent 给出最终答案,全程属于同一条 Trace。
Span:Trace 中的一个具体操作。调一次 LLM 是一个 Span,调一次工具是一个 Span,做一次检索也是。每个 Span 自带输入、输出、耗时、Token、错误。
打个比方:Trace 是一整段行车记录仪录像,Span 是其中一段段片段——“这段在变道”“这段在刹车”。
6 为什么是一棵树,不是一张清单
因为真实 Agent 的执行是嵌套的:Agent 调工具,工具内部调检索器,检索器内部再做向量化。这种“爷爷—儿子—孙子”的结构,平铺的清单表达不了,只能用树。
Agent 是父 Span(Parent Span) 它发起的 LLM、工具调用是子 Span(Child Span) 工具内部的检索、向量化是孙辈 Span
OpenAI Agents SDK 的 Span 当前带 trace_id 和可选的 parent_id,靠 Parent Span 把一次 Agent Run 的各组件组织成层级。
7 SDK 默认就替你录了
我们前面一直用的 Runner.run_sync(...),SDK 当前默认开启 tracing:整个 Runner.run() / run_sync() / run_streamed() 会被 Trace 包裹,自动记录 Agent、Model Generation、Function Tool、Guardrail、Handoff 等 Span。
继续用第 2 课的测试分析 Agent(1 个 Agent + 1 个 Tool)来看,一条 Trace 大概长这样:
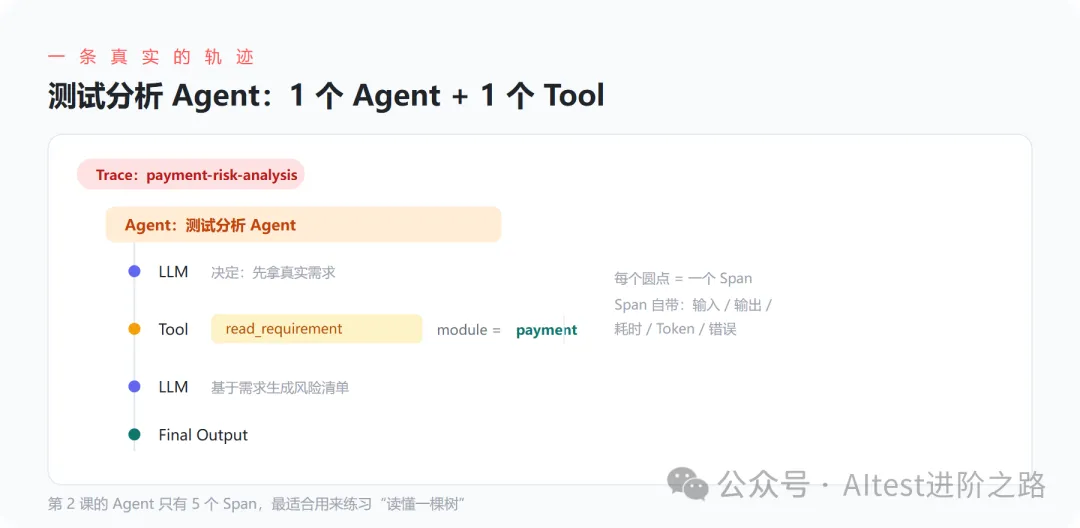 图 3 · 测试分析 Agent 的一条 Trace
LLM 决定“我要先拿真实需求”,于是调了 read_requirement(module=payment)。
8 读 Trace 的八看清单
有了录像,怎么看出问题?一份八看清单如下:
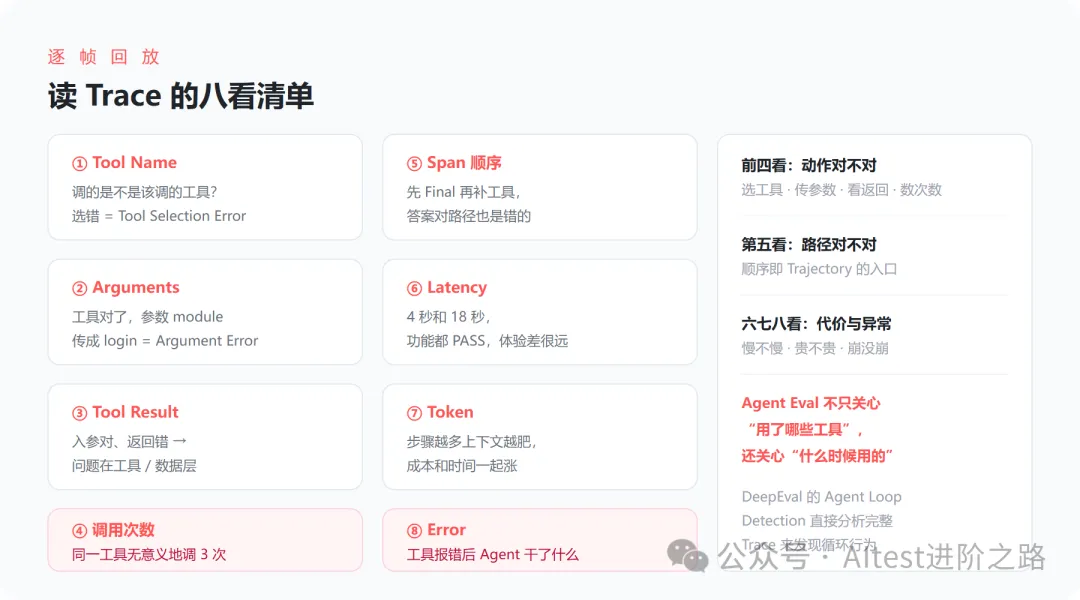 图 4 · 读 Trace 的八看清单
9 分清 Agent Bug 和 Tool Bug
假设最终答案错了。不看 Trace,第一反应几乎都是“Prompt 不好”,然后开始狂改提示词。
但 Trace 会给出两种完全不同的真相:
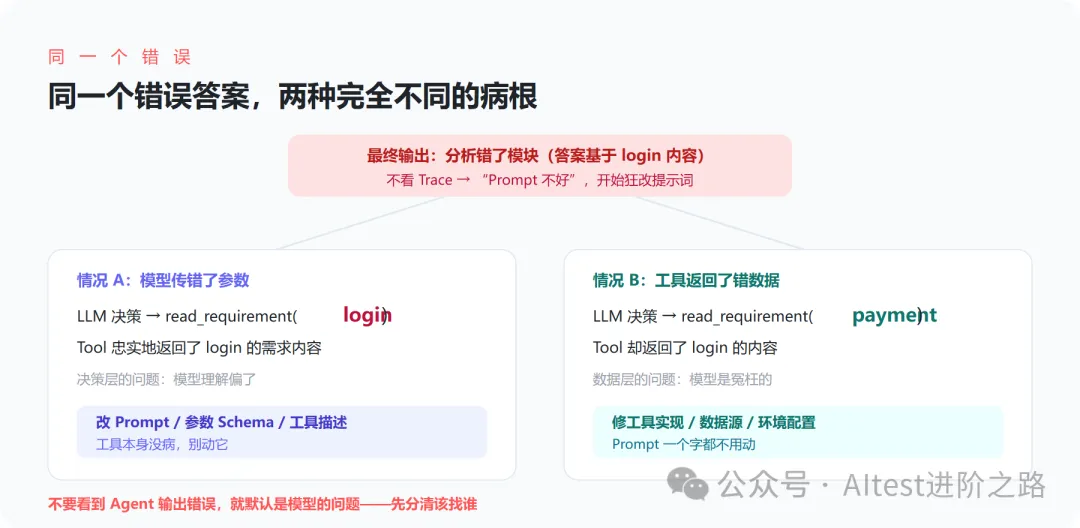 图 5 · 同一个错误答案,两种病根
- A:
模型把参数传成了 login → 决策层问题,改 Prompt、参数 Schema、工具描述 - B:
模型规规矩矩传了 payment,工具却返回 login 的内容 → 数据层问题,修工具,Prompt 一个字都不用动
不要看到 Agent 输出错误,就默认是模型的问题。
10 慢在哪里
只看总耗时 10 秒,你什么都做不了。拆到 Span,两种情形立刻现形:
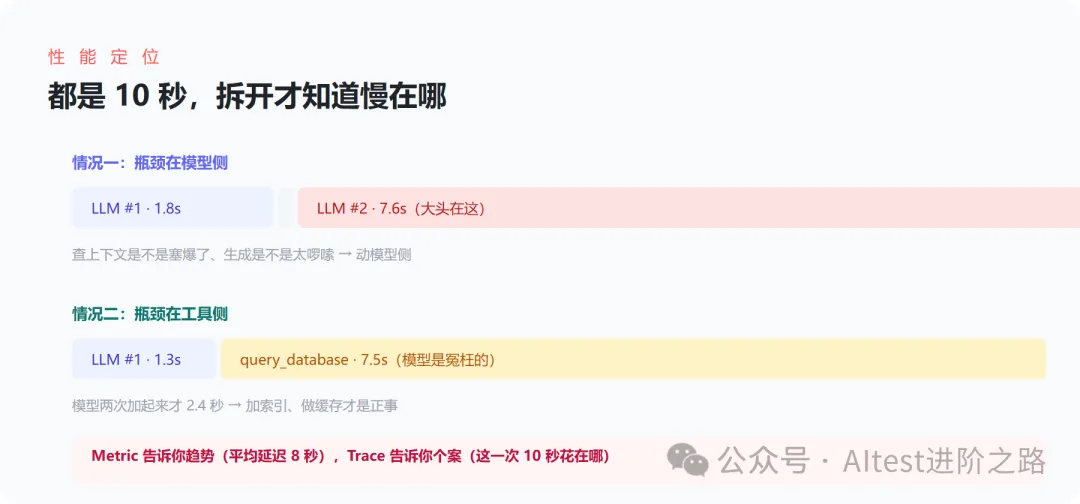 图 6 · 总时长相同,病根不同
所以 Trace 还有第二个身份:性能定位工具。
11 工具出错之后
不要看到 Agent 输出错误,就默认是模型的问题。
工具超时只是个事件,Agent 怎么处理才是测试重点:
- A 合理重试一次
,仍失败就诚实告诉用户拿不到 → 合理 - B 无限重试
,连最终输出都没有 → 需要最大重试次数兜底 - C 假装没事,自己编需求
→ 最严重,Grounding Failure - D 切换备用数据源
,拿到可靠结果 → 如果系统允许,这是优秀的恢复能力
通过 Trace 才能看到 Agent 到底恢复了没有,而不是只看到“最终回答成功”。
12 分清Trace、Log、Metric
Log 是“事件记录”,Trace 是“一次任务完整的执行拓扑”,还会带上父子关系、耗时、输入输出、元数据、错误。
生产环境的典型工作流是接力的:过去一小时 P95 延迟 17 秒(Metric 发现趋势)→ 下钻到慢的 Trace → 发现 search_document 的 Retriever 耗时异常(Trace 定位个案)。LangSmith 当前的 Monitoring 就支持查看 Trace 数量、延迟、错误率、Feedback、成本等聚合指标,再从异常指标下钻到具体 Run。
13 给 Trace 起个名字
from agents import Runner, tracewith trace("payment-risk-analysis"): result = Runner.run_sync(agent, "分析 payment 模块资金风险。")为什么名字重要?生产环境十万条 Trace 全叫“Agent workflow”,排查时只想撞墙。payment-risk-analysis、login-security-analysis、bug-triage、test-case-generation 才能搜索、过滤、统计。
再补元数据:
with trace("payment-risk-analysis", metadata={"agent_version": "v1.3", "prompt_version": "p7","model": "model-a", "environment": "staging","case_id": "AGENT-PAY-001"}): ...以后 Prompt 升到 V8 突然变差,按 prompt_version 分组比较,退化一目了然。
Trace ID 同样重要:线上用户说“刚才 Agent 把订单查错了”,一条 Trace ID 就能定位那一次真实执行。SDK 会给 Trace 生成唯一 trace_id,还支持可选的 group_id 把同一段对话的多条 Trace 关联起来——多轮场景里,Turn 1 是一条 Trace、Turn 2 是另一条,用 Session / Thread / Group ID 串成一段会话,这是后面多轮评测的数据基础。
14 同一条 Trace,三种评法
from agents import add_trace_processorfrom deepeval.openai_agents import DeepEvalTracingProcessoradd_trace_processor(DeepEvalTracingProcessor())注册之后,Agent Run、LLM 调用、工具调用会自动变成可评测的 Span。于是同一条 Trace 出现三种评价范围:
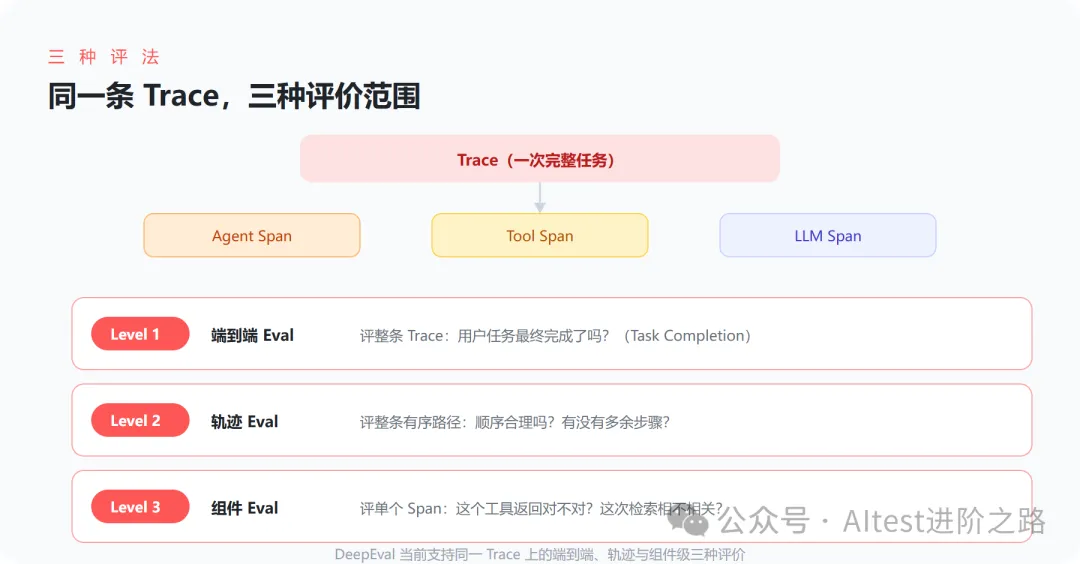 图 7 · 三种 Eval 范围
组件级评测是失败分析的利器。
15 Trace 直接变成缺陷报告
传统缺陷报告是“步骤 + 实际结果”。Agent 的 Bug 报告要多一整层字段:
这已经非常接近一份 AI Agent Failure Record。顺着思路,失败分类也从一句“AI 答错了”变成一张清单:
分类越细,修复越准。100 条失败里要是有 35 条是参数错,你该改的是参数 Schema,不是天天换模型。
16 粒度与脱敏
Trace 不是越详细越好。一条 Trace 三百个 Span,连 string.strip() 都记,结果就是完全看不懂。
值得成为 Span 的通常是:Agent、LLM、Tool、Retriever、Reranker、Handoff、Guardrail。Phoenix 的 OpenInference 当前就定义了 AI 特有的 Span Kind,包括 LLM、AGENT、TOOL、RETRIEVER、EMBEDDING、RERANKER、GUARDRAIL。而普通函数调用没必要单独建 Span。
更要紧的是安全。Trace 会记录用户输入、模型输入输出、工具参数与返回,里面可能藏着个人信息、订单号、手机号、API Key、数据库结果。
举个例子:query_customer 返回了姓名、身份证、手机号、银行卡号,如果原样进了云端 Trace 平台,你就在制造新的数据治理风险。
所以:OpenAI Agents SDK 当前说明 Generation Span 与 Function Span 会记录输入输出,可以用 RunConfig.trace_include_sensitive_data 控制是否捕获;LangSmith 当前支持隐藏输入输出、隐藏元数据、规则脱敏、Secret Redaction、条件关闭 Tracing。设计可观测性时,永远在“可调试”和“数据安全”之间找平衡。
以后拿到一个失败 Case,按这十步走:
看 Input / Goal 看 Agent / Model / 版本 看第一个 Decision 看 Tool Selection 看 Arguments 看 Tool Result 看后续 Trajectory 看 Retry / Error 看 Latency / Token - 最后才看 Final Output
为什么最后才看输出?因为测试人员特别容易被一段写得很好的答案骗到——过程一塌糊涂,最终碰巧答对。行为证据先于输出结论,这是 Agent 失败分析和传统失败分析最大的姿势差异。
在成熟团队里,Trace 是公共的质量数据:
它还是 Agent Testability 的基础:如果系统连“调用了什么工具”都拿不到,工具测试、轨迹测试、安全测试全都无从下手。Traceability 本身就是可测试性设计。
- Trace 表示一次 Agent / LLM 应用的完整执行
- Span 表示 Trace 内的一个具体组件(Agent / LLM / Tool / Retriever),DeepEval 靠 Trace + Span 支撑端到端、轨迹、组件三种评测
OpenAI Agents SDK 当前默认开启 tracing,自动记录 Agent、Generation、Function Tool、Guardrail、Handoff Trace 里最值得测试人员关注的是:Tool、Arguments、Result、Order、Error、Latency、Token - Trace 解决“发生了什么”,Eval 解决“做得好不好”
Trace 不只是 Debug 工具,还是评测、性能分析、安全分析、失败分析、生产监控的数据地基 Trace 可能记录敏感输入输出与工具数据,Observability 设计必须同时考虑脱敏与权限治理
到这里,我们已经能看见 Task、Tool、Arguments、Trajectory、Output、Latency。那么哪些东西该被定义成 Agent 的核心质量指标?客服 Agent、测试 Agent、代码 Agent 能不能用同一套标准?
更多Agent评测的内容全部整理到我的知识星球:AItest进阶之路
系统学习AI全栈测试看这两篇:
一个残酷的真相:35岁之后还能走上坡路的测试人,大都是学透了这个能力,可惜99.9%人不敢承认
3个月带你从小白到AI测试专家,从功能到性能全搞定,全网性价比最高的AI测试行动+高能量学习(Skill AI测试实操案例)
看到这里如果你觉得有帮助,欢迎关注、在看、转发!
推荐阅读
太幸福了吧!Playwright 官方推出这三个Agent,轻松搞定AI测试全流程,建议转发收藏(附详细操作步骤)
用Skills+知识图谱实现多接口串联测试,简直王炸(建议转发收藏)
一个测试人必备的需求分析Skill,搞定需求分析8大维度,生成用例采纳率直接拉满
太幸福了,10万行代码接口测试,我用知识图谱+Skill 让 AI 半小时全干完了,一学就会
太幸福了吧!Playwright 官方推出这三个Agent,轻松搞定AI测试全流程,建议转发收藏(附详细操作步骤)
一个测试人必备的需求分析Skill,搞定需求分析8大维度,生成用例采纳率直接拉满
3个测试Skills,让工作效率直接拉满!从入门到工程化全覆盖
