教学、数据叙事和机制演示视频,常要求公式正确、图表数值一致、游戏过程遵守规则,并让旁白与画面事件同步。智能体可以通过代码构建每一帧和声音,但还要在有限时间内完成渲染与封装,才能交付真正可播放的作品。
VibeVideoBench 为这类制作方式建立评测。239 项中英文任务要求智能体在一小时沙箱中输出 MP4、可编辑源工程与时间表,分别检查交付规格、具体要求和整体质量。本文依据更新后的 v2 版本。
自包含任务规定内容与创作空间
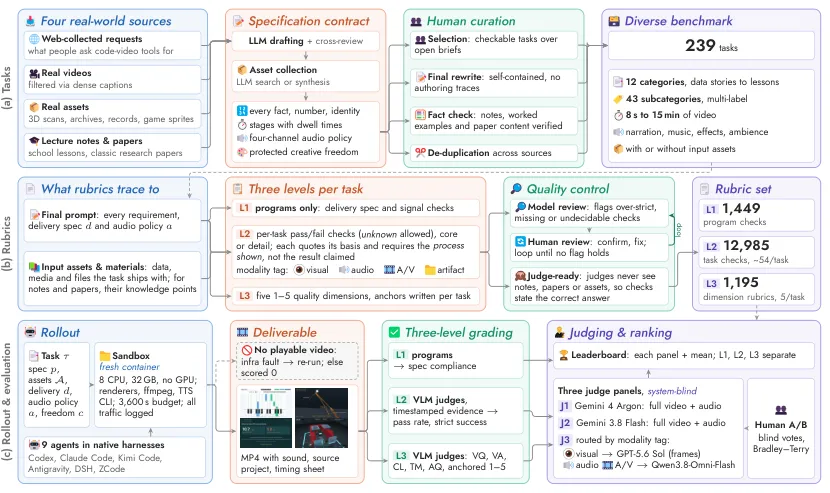
任务来自真实需求、真实视频描述、素材包,以及讲义与研究论文。模型辅助起草后,人工将其改写为可独立执行的规格,核对事实、素材与可验证条件,同时保留明确的创作自由。
输入包括自然语言说明、可选只读素材、分辨率与帧率等交付规格,以及旁白、音乐、音效和环境声四个通道的使用要求。各通道可标记为必需、可选或不使用。
图 1:规格与输入素材共同决定验收标准,程序检查和模型评分分别执行。来源:论文图 2。
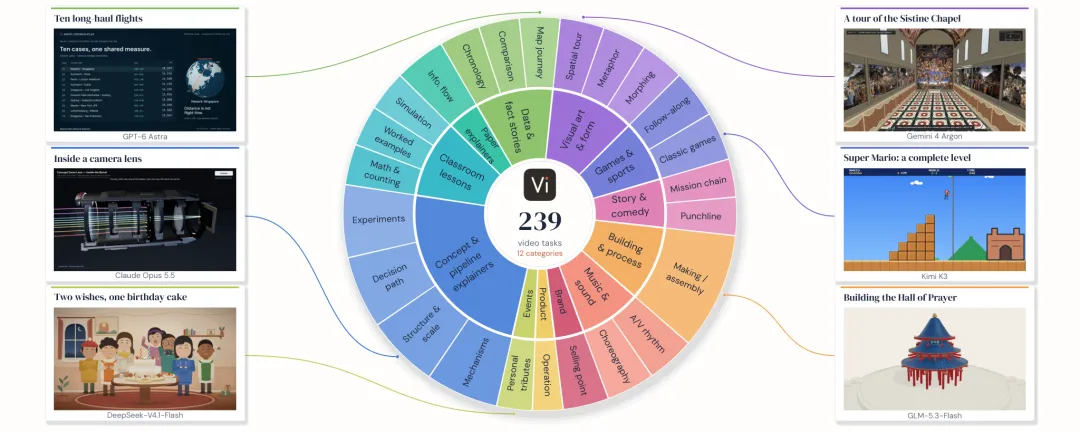
239 项任务分属 12 类,带有可重叠的子类标签;209 项为英文、30 项为中文,目标时长从八秒到十五分钟。201 项附带素材,约七成要求至少一种声音通道。
智能体可自行选择渲染技术栈。环境提供 Python、Node、无头浏览器、ffmpeg 和 TTS,但不提供图像或视频生成模型。每个系统使用原生执行框架,在相同的一小时预算内自主完成任务。
图 2:任务覆盖数据故事、课堂教学、机制解释、音乐与游戏等;周围示例来自实际交付。来源:论文图 3。
三层评测分别回答不同问题
L1 由程序检查可解码性、尺寸、帧率、时长及适用的音轨、源工程等要求。交付率只表示有可播放视频,规格符合率则要求所有适用程序检查通过。
L2 包含 12,985 条任务专用检查,分别给出通过、失败、未知或不适用。逐条通过率排除未知与不适用项;严格任务成功要求没有核心项失败、且至少一项核心检查通过。未知项不计为失败,因此这一指标也不等于已证实所有核心项都通过。
L3 按任务特定锚点,对视觉质量、美学、内容逻辑、时序运动、音频与视听同步五个维度打 1 至 5 分。总体质量是这些维度的均值,不与 L1、L2 混合加权。
交付可靠性会改变排名
九个系统共执行 2,151 条轨迹,每个系统与任务组合只有一次计分运行。下表摘录结果,质量均值在已交付视频上计算,L2 严格成功则把未交付记为失败。
论文同时报告未交付记零的质量均值。Gemini 4 Argon 因交付不足,从只看已交付质量时的第四名降到第七名,说明作品质量与能否按时交付需要分别阅读。
224 次未交付的主要原因
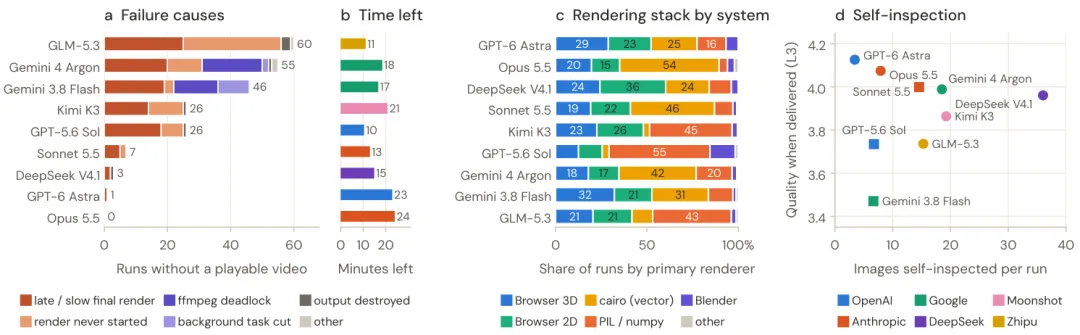
作者逐条检查全部 224 次未产生可播放视频的运行。其中 169 次与最终渲染启动过晚、运行过慢或根本没有启动有关,约占四分之三;45 次为渲染停滞,另有七次是智能体自行损坏已生成文件。
例如,有的轨迹只在截止前九分钟启动需时较长的逐帧抓取;有的持续向 ffmpeg 管道写入帧,却不读取错误流,最终死锁。相比之下,全部成功交付的 Opus 5.5 中位提前约 24 分钟完成视频,后续改进与验证使用副本。
图 3:时间分配与渲染流程是未交付的重要因素,查看更多图像并未在系统间对应更高质量。来源:论文图 4。
95% 的运行查看过自己渲染的帧,但系统间自检图像数量与交付质量没有正相关。该观察不能单独推断自检无用,因为模型、技术栈和执行策略共同变化。
自动评判与人工偏好的范围
三个评判面板分别给分,再取均值;其中一个按视觉、音频与视听要求分流。盲测人工偏好只比较双方都能播放的视频,因此检验的是交付质量,不能验证交付可靠性。
三面板均值与人工系统排名的 Spearman 相关为 0.98,但对单个决定性视频对的偏好一致率为 73.3%。论文据此区分系统级排序与单视频判定:相近评分不能充当单个作品已达到可用标准的保证。
相关链接
- 原始论文:https://arxiv.org/abs/2610.35864
- 项目主页:https://vibevideobench.github.io/
- 官方代码:https://github.com/vibevideobench/VibeVideoBench
- 评测数据:https://huggingface.co/datasets/diaomuxi/vibevideobench