测试岗不降反增的背后:会做评测基线的人正在被重新定价
模型供应商在你不知情的时候升级了版本,prompt 只改了一句话,线上回答的质量就悄悄滑了一截。可你的测试报告依然是全绿的,因为没有任何一条用例在测“质量有没有变差”。这篇文章讲的是:怎么把“感觉变差了”变成一条能被机器判定、能被流水线拦截的质量基线。一、问题背景
招聘市场的信号已经很明显:传统功能测试和手工接口测试的岗位在收缩,而要求“设计评测数据集、搭建自动化评测与版本回归体系”的岗位在放量。同一个人、同样的测试思维,定价却不在一个体系里。原因不在岗位名字,而在测试对象变了。确定性系统里,输入 A 必然返回 B,断言写死就能覆盖。嵌入大模型和 Agent 的系统里,同一句输入两次输出措辞可以完全不同,而“最后答对了”也不代表过程正确。更麻烦的是回归的触发条件变了。过去只有代码变更需要回归;现在代码、prompt、知识库、模型版本,任何一项变动都可能让质量漂移。没有基线,团队根本无法判断这次改动是变好还是变差。二、核心概念解释
这篇文章里我反复用一个词:质量基线。它不是一份测试报告,而是三样东西的组合——一份可比的评测集、一组可解释的分层指标、一条能阻断发布的门禁规则。可比的意思是,同一批题、同一套判定标准,换模型、换 prompt 之后还能横向对齐。可解释的意思是,分数掉了要能定位到检索层还是生成层,而不是只告诉你“总分降了 5 分”。可阻断的意思是,阈值不通过就卡住合并,而不是写进周报等人来看。三、案例分析
案例:示例方案——客服 Agent 的评测门禁重建
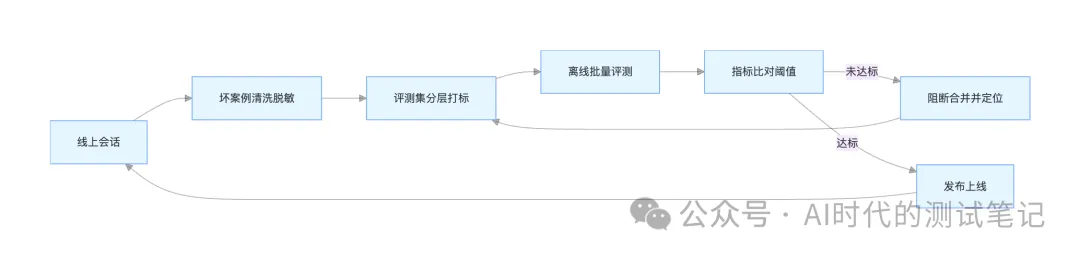
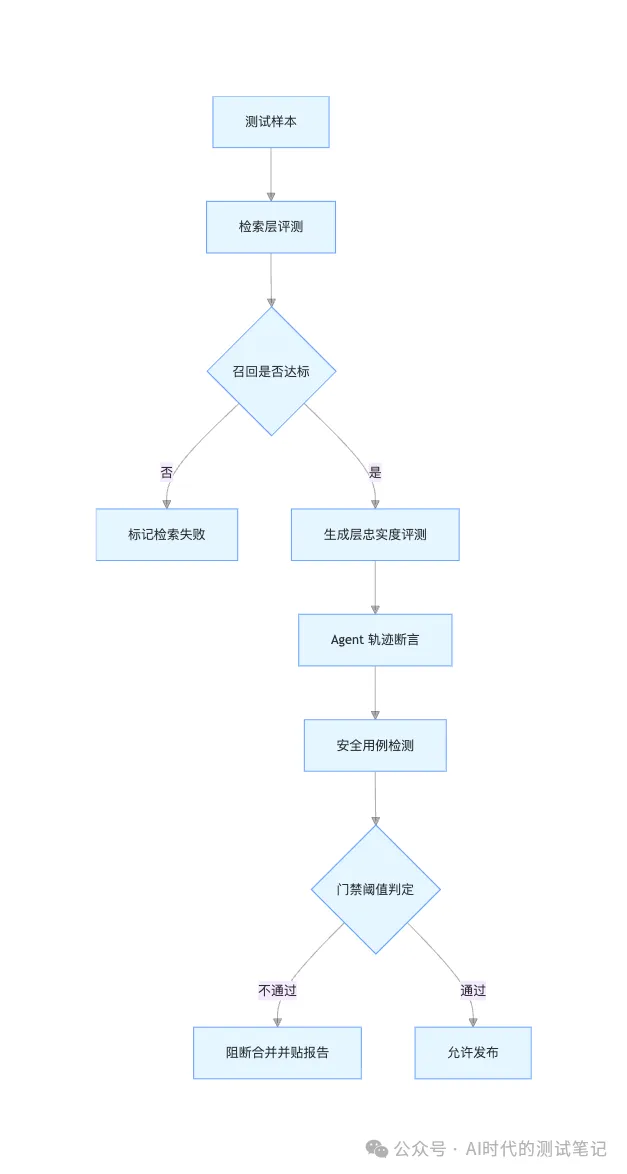
背景:一个接入内部知识库、可调用工单查询工具的客服 Agent。模型由外部供应商提供,prompt 和知识库每周都在迭代,上线前的回归方式是产品经理抽十来个问题手动问一遍,看回答顺不顺眼。团队只有两名测试,没有专职算法同学。问题:供应商某次静默升级后,回答变得“更自信也更不准”,出现了原文里根本没有的说法。想追责却发现无从下手:只测最终答案,无法区分是没检索到相关资料,还是检索到了却生成跑偏。更致命的是没有任何历史基线,谁也说不清这次到底是变差了还是本来就这样。测试同学能做的只有写缺陷单,但缺陷单描述的是“感觉不对”,研发不认。方案:按四个步骤重建,全程用 Python 脚本加现成评测框架实现,不引入平台。第一步,建分层评测集。从线上会话记录里抽取约两百条样本,好坏案例都要,清洗脱敏后按检索、生成、工具调用、安全四类打标,每条标注“合格答案应包含哪些事实点”。第二步,指标分层落地。检索层看召回与排序是否把相关文档排在前列;生成层看忠实度,也就是把回答拆成独立事实断言,逐条判断能否从检索原文推出,算支持率;Agent 层看工具有没有被调用、调用顺序是否合理、参数是否合法;安全层单独放越权访问与提示词注入用例。第三步,判定方式组合。语义相似度打底处理措辞差异,边界模糊的样本交给裁判模型按验收标准打分,且裁判模型与业务模型必须不同源,避免自己给自己放水。四层判定都不过的样本转入人工复核队列。第四步,门禁进流水线。把评测脚本挂到合并请求触发,设阈值,未达标阻断合并并把明细自动贴到 PR 评论里,研发点开就能看到是哪几条样本、哪一层掉分。结果:这套方案在写作时属于建议实施路径,以下指标可作为验证效果的口径,而非既成事实:忠实度阈值触发后人工复核的命中率,用来判断门禁是否误报过多;单次全量评测的耗时与调用成本,决定它能否撑得住每天多次触发;以及改动上线后线上差评率的环比变化。局限也很清楚:评测集规模有限,长尾问题覆盖不到;裁判模型本身有波动,需要定期用人工抽检结果校准它的打分。四、实践经验
第一个坑是拿精确匹配起步。最初用字符串包含关系判断答案是否正确,结果误报率高到没人愿意看报告,团队一度得出“AI 没法自动化测”的错误结论。判定方式必须按场景分层,不要指望一种断言打天下。第二个坑是只测最终答案。答案错了但检索是对的,说明问题在生成侧;检索就错了,改 prompt 毫无意义。不拆层,所有缺陷单都会变成“答得不好”,研发无法行动。第三个坑是评测集只放好案例。全是标准问法的数据集,门禁永远通过,等于没有门禁。坏案例、边界问法、恶意输入才是真正的价值所在,它们应当从线上持续回流。第四个坑是裁判模型和被测模型同源。同源裁判会系统性偏向自己的表达习惯,分数虚高。这一点在选型阶段就要确认,不要等出了问题才发现。可复用的经验是:把评测当成一条需要长期养的资产线,每次线上事故都必须沉淀成一条评测样本,否则同样的坑会重复踩。五、落地建议
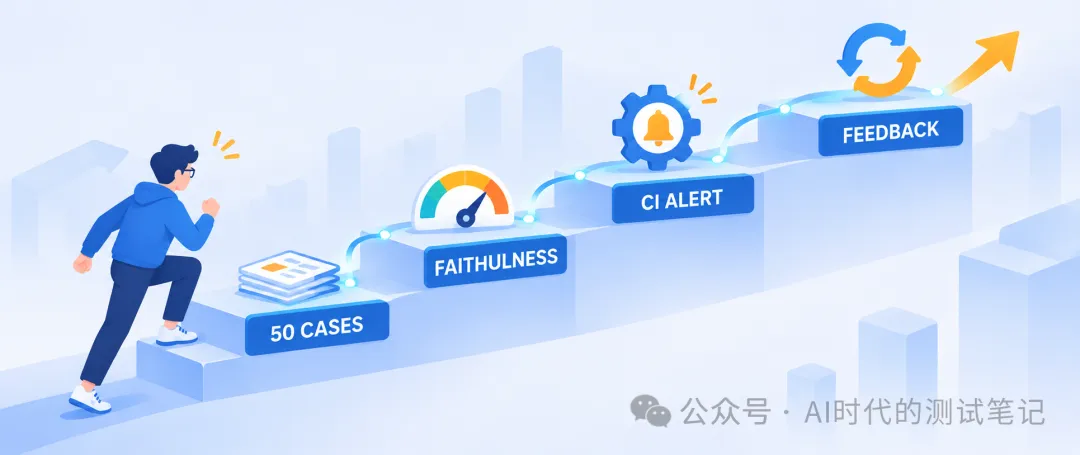
第一,先做一份五十条起步的分层评测集,从最近三个月的线上问题里捞样本,标注事实点。目的是让“质量”第一次有可对齐的参照物,规模不重要,覆盖失效类型才重要。第二,把忠实度作为第一优先指标上线,设一个保守阈值并记录每次触发的明细。目的是用最低成本先拦住“回答里没有原文支撑”这一类最伤用户的幻觉。第三,评测脚本挂到合并请求上,先只报警不阻断,跑两周看误报率再决定是否开启拦截。目的是让门禁先获得团队信任,避免一上线就被当成噪音关掉。第四,每次线上事故强制回填一条评测样本,指定责任人。目的是让评测集随业务增长,而不是一次性项目交付完就荒废。六、我的观点
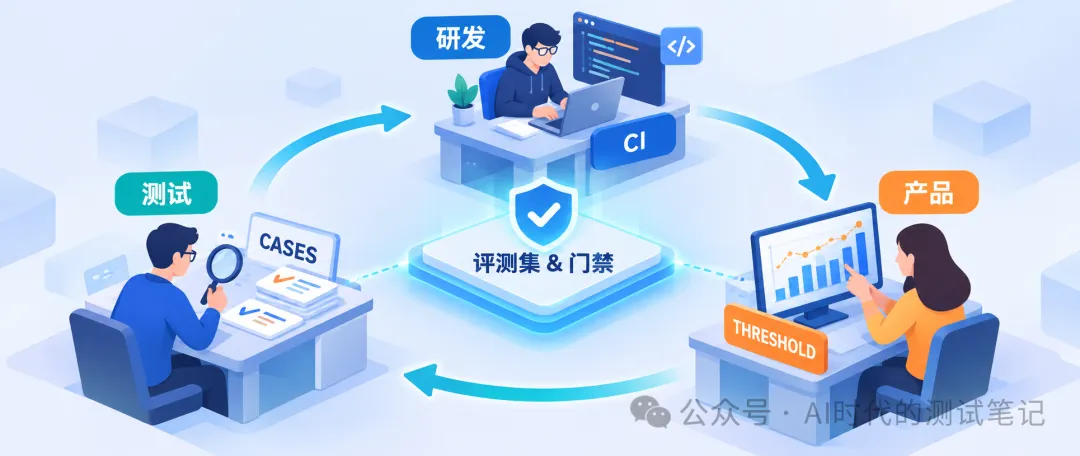
我的观点是:AI 测试真正的护城河在评测集和门禁,不在断言脚本的数量。理由有两个。第一,断言脚本是可复制的,一份写得再漂亮的语义相似度校验,开源框架里半小时就能抄走;而一份标注了半年、覆盖了真实坏案例的评测集,没有人能替你攒出来,它记录的是你业务独有的失效方式,这是别人拿不走的资产。第二,门禁决定了测试在组织里的话语权。测试如果只能输出“我测过了,感觉还行”,那永远是被动角色;一旦质量分数能卡住合并请求,测试就从建议方变成了决策的一环。这件事的门槛不在技术,在于你愿不愿意先把那五十条样本标完。所以不必纠结 AI 会不会取代测试。真正会被淘汰的,是只能穷举规则的验证方式,而不是会设计评测的人。七、总结
回到开头那个场景:模型悄悄升级、报告全绿、质量下滑,本质上是我们的判定手段停留在确定性时代。解决它的路径并不复杂——攒一批带标注的坏案例,把指标拆到检索层和生成层,再用一条门禁把分数卡在合并之前。先标五十条样本,比先写一百条断言更值得。质量这件事,只有能被比较,才谈得上被守住。
关注测试开发、AI 测试、Agent 评测与工程实践。希望帮助更多测试工程师,在 AI 时代构建自己的核心竞争力。