AI应用提高了业务效率,解决大部分业务问题,但是少数的幻觉和不可控问题有可能导致产品体验下降甚至带来破坏性的影响,本篇文章主要是讲解如何做AI应用评测,评估应用能不能发、效果怎么样。
从数据集构建、评估方法,到评测驱动开发的完整闭环
四大板块·数据集 / 评估 / 方法论 / Agent 评测
目录
- 〇、概述
- 一、数据集
- 二、评估
- 三、评测方法论
- 四、评测驱动开发
- 五、Agent 评测
- 六、业界专家方法论与观点:Anthropic / Hamel Husain / LangSmith / OpenAI / Google / EDD 社区 / 学术侧,附原文链接
- 七、一页速查
- 附录
〇、概述:AI 应用评测是什么,为什么重要What & Why
概念:评测(Evals)到底是什么
定义:AI 应用评测(Evals)是一套系统化地检验 AI 应用输出质量与效率的方法体系——给定一批有代表性的输入(数据集),让 AI 应用运行,用预先定义好的标准(评估器)判断它做得好不好,并用分数回答三个问题:能不能发布?改动是变好还是变坏?下一步该修什么?
一个最简的评测 = 三件套:
| | |
|---|
| 数据集 | | |
| 被测系统 | AI 应用本身(模型 + prompt + 工具 + 流程) | |
| 评估器 | 判断输出好坏的逻辑(代码规则 / LLM judge / 人工) | |
但它和传统测试有本质区别:AI 的输出是不确定的——同一个输入两次运行可能结果不同;"对"往往不是唯一答案;过程(走了哪些步骤、调了哪些工具)和结果一样重要。所以传统"断言相等"的测试框架不够用,需要整套新的方法论——这正是本文档的内容。
意义:为什么非做不可
- 没有评测,改进靠感觉:改了 prompt 觉得"好像变好了",两天后用户报告客服场景坏了。评测把"感觉"变成"分数",每次改动都有量化的答案。
- 没有评测,回归不可见:AI 应用改一处动全身,没有评测套件挡着,质量回退只能在生产环境被用户发现。
- 没有评测,优先级靠猜:错误分析 + 计数告诉你最常见的问题是什么,让工程资源花在刀刃上,而不是修想象出来的边缘问题。
- 没有评测,不敢发布:Agent 能自主执行动作(发邮件、改数据),没有质量证据就上线等于裸奔。业界的结论被压缩成一句话:无评测,不发布;不迭代。
- 公开榜单不可替代:基准会饱和、会被污染、题目本身可能有 bug(详见第六章)。唯一完全作数的,是你自己的应用、你自己的数据。
全局框架:本文档的地图
整个评测体系可以画成一张闭环地图,先看懂它,后面每一章就都知道自己在哪:
| | |
|---|
| ① 建数据集 | | 拿什么测?——example 三要素(输入 / 参考输出 / 元数据),必须自建、贴近真实分布 |
| ② 定评估方法 | | 怎么判好坏?——代码评估、LLM-as-a-Judge、人工评估三法并用;指标从业务目标倒推 |
| ③ 认清困难 | | 难在哪?——三条鸿沟:看不见数据、看不见过程、看不见边界 |
| ④ 跑通流程 | | 什么时候做什么?——原型(10–20 条验证可行)→ 开发(可观测 + 实验 + 循环)→ 生产(巡检 + 人工 + 沉淀),评测进 CI 做门禁 |
| ⑤ 拆解 Agent | | 复杂系统怎么测?——路由(决策)、Trace(过程)、Skill(执行)三维度;常规任务评结果,危险动作评路径 |
| ⑥ 对标业界 | | 大厂和大牛怎么做?——Anthropic、Hamel Husain、LangSmith、OpenAI、Google、EDD 社区的方法论、共识与分歧 |
| ⑦ 速查 | | |
"评测不是'打分',而是把不可见的 AI 应用变成可观测、可比较、可改进的系统。数据集让它可测,三种评估方法让它可判,三条鸿沟说明为什么要测,三阶段说明什么时候测什么,Agent 三维度说明复杂系统要拆开测。"
—— 全文主线,读完后再回来看这句话会有不同的感受
最小可行路径:如果你只有一天
- 从生产日志 / 客服工单里取 20 个真实案例,亲手逐条读,记下每个案例最上游的第一个错误(第六章 Hamel 的开放编码法)
- 按错误频率排序,挑最高频的 2–3 类,为它们各写一条二元判定规则(能用代码判就用代码)
- 把 20 个案例整理成数据集(含元数据),跑通"输入 → 记录输出 → 打分"一轮
- 此后每次改动 prompt / 模型 / 工具,都重跑这 20 条,任何维度变差就不发布
- 生产上遇到的每个新失败,收进数据集——让评测集和产品一起长大
这五步就是第四章"三阶段"里原型 + 开发早期的最小闭环,也是 Google 说的"没有黄金集也能起步"。剩下的章节,都是在把这条路径的每一段做深。
一、数据集Dataset
评测数据集在整个评测体系里最重要的数据,数据集的质量直接决定了评测的效果。一定要重视评测数据的质量。
评测数据长什么样?评测的基本单位是 example(样本)。一个 example 由三部分组成。
1输入 Input
喂给 AI 应用的原始请求,也就是用户真实会输入的东西。可以是单轮问题、多轮对话、一段文档、一张图片,或者一个待执行的任务指令。
设计要点
输入应当尽量贴近真实线上分布——包含真实用户的错别字、口语、超长输入、模糊指令。只写"标准问法"的数据集,测出来的分数会虚高。
2输出 Output
期望 AI 给出的答案,用来和模型实际输出做对比打分。但它是可选的——很多真实场景根本没有唯一正确答案。
有参考输出
可以直接比对:完全匹配、语义相似度、关键点覆盖。适合有标准答案的任务,如分类、抽取、计算。
无参考输出
开放生成类任务(写作、咨询、摘要)。只能无参考评分——让评估者按质量维度直接判断好坏。
无参考答案怎么办
靠 LLM-as-a-judge:用强模型按评分标准(rubric)判断 AI 的回答在逻辑、完整性、有用性上是否达标。
3元数据 Metadata
附着在 example 上的辅助信息,本身不参与打分,但极大影响后续分析的深度。常见字段:
关键认知:metadata 是做筛选和切片分析的基础。没有它,你只知道"整体 78 分";有了它,你才知道"是代码场景的难题拖低了 12 分"。评测的价值往往不在总分,而在分层的差异。
为什么必须自建数据集
核心结论
AI 应用评测不能指望开源评测集(如 MMLU、C-Eval)。自建数据集才是评测工作的核心,应关注真实业务数据在应用上的真实表现,而不是刷通用榜单分数。
原因很直接:
- 开源集测的是模型通用能力,不是你的业务效果。
- 开源集已被"见过"。
- 业务问题往往有私有约定。
- 决策场景需要分布匹配。评测集的输入分布若与线上不一致,分数就没有预测力。
二、评估Evaluation
评估 = 判断 AI 应用输出的质量与效率。
三种评估方法
① 代码评估 Code-based
基于预定义规则的代码逻辑判断,客观、可复现、零成本、可大规模跑。典型判据:
- 输出格式:是否为合法 JSON、字段是否齐全、是否满足 schema
- 单元测试
- 字符串匹配
- 约束检查
局限:只能判断"形式对不对",判断不了"说得好不好"。
② LLM-as-a-Judge
利用 LLM 的模型能力,评估没有标准答案的开放式问题。让一个(通常更强的)模型扮演裁判,按评分标准给 AI 的回答打分或比较优劣。可以选择Jev等决策模型或者能力更强的通用模型,最好使用的模型有差别。
- 适用的:写作质量、摘要忠实度、回答有帮助程度、推理链条合理性
- 可能需参考模型:需要一个更强的模型(如 GPT-4 级)作为 judge 基准
- 常见形式:单点打分(1–5 分)、成对比较(A/B 哪个更好)、按 rubric 逐项判定
必须警惕的三个偏差
- 位置偏差:倾向选第一个(或最后一个)答案 → 解法是交换顺序各测一次
- 长度偏差:倾向给更长的回答高分 → 解法是评分标准里明确禁止"以长论优"
- 自我偏好:judge 偏爱同族模型输出 → 解法是用不同厂商模型做 judge
③ 人工评估 Human Evaluation
专家评估——由领域专家判断。成本最高,但它是所有自动指标的"金标准",用于校准 LLM judge、验证自动指标是否可信。
实务做法:小样本(几十到几百条)专家精评 + 大规模自动评估,两者定期对照。
评估什么:先定指标,再谈分数
选择什么评估指标? 先回答:核心的业务指标是什么?要解决什么业务问题?
指标必须从业务目标倒推,不能从"哪个指标好算"出发。举例:
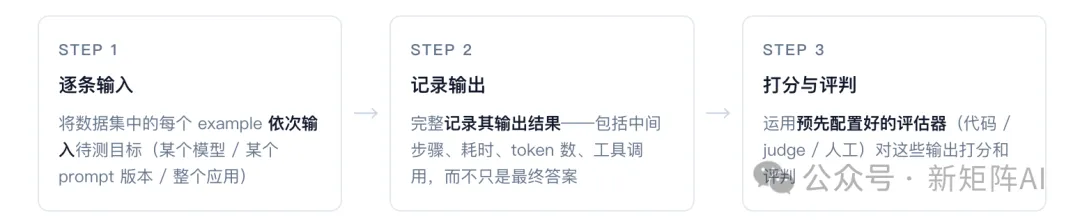
实验怎么做
注意第一条是"依次"——评测必须可重复、可对照。同一批数据、同一套评估器,才能比较出"A 版本比 B 版本好多少"。
常见误区
只记录最终答案,丢掉了过程信息(用了哪个工具、走了几步、耗时多少)。这样只能测"对不对",测不了"为什么错"——排障时无从下手。
三、AI 应用评测方法论Three Gaps
AI 应用研发存在三条结构性"鸿沟"。评测的作用,就是把这三条鸿沟逐一填平。
| | |
|---|
| 理解鸿沟 | | 开发者不知道有哪些数据,对数据的分布、边界、脏数据情况缺乏观测与理解。评测的第一步是把数据"看清楚"——观测、理解、清洗,建立对数据的基本认知。 |
| 具象鸿沟 | | 开发者对应用的具体行为不可见。需要依靠 LLM 去解释和执行具体路径——看到它到底怎么想、怎么走、怎么调用,把抽象的系统变成可观察的具体链路。 |
| 泛化鸿沟 | | 应用要面对数据多样性与未知输入,而开发者无法预见全部情况。评测要主动构造多样、分布外的输入,检查应用在未知数据上是否仍然理解和执行正确。 |
一句话串起来:理解鸿沟解决"我不知道数据长什么样";具象鸿沟解决"我不知道系统在干什么";泛化鸿沟解决"我不知道没见过的输入会不会挂"。三条鸿沟 = 看不见数据、看不见过程、看不见边界。
四、评测驱动开发Eval-Driven Development
总原则:无评测,不发布
评测不是一个"上线前跑一遍"的动作,而是贯穿研发全流程的决策依据:能不能发布、该不该改、改完是否真的变好了,都靠它来回答。
1原型阶段 Prototype
- 目标:验证这事大概是否可行——不追求效果完美,先确认方向没错。
- 数据集:10–30 条黄金数据集(golden set)。手工精挑、覆盖核心场景,人工逐条看。
- 为什么这么少:原型期主要靠人眼看,几十条足够发现"这个方向根本走不通"或"prompt 有系统性缺陷"。此时铺大集是浪费。
2开发阶段 Development
这一阶段的核心是让系统变得可观测,然后建立持续改进的循环。三件事:
2.1 数据可观测:把每一步"摊开"
把每一步都记录下来,让链路透明、可追溯、可优化:
关键能力是可分组、可切片——按场景、按错误类型、按模型版本切分看,才能定位"哪一类输入在系统性出错"。这是上一节"理解鸿沟"的具体落地。
2.2 通过工具发起实验
- ① 黄金数据集测试:用原型期那 10–30 条做回归,确保改动没把核心场景弄坏
- ② 构建更全面的开放数据集:从线上真实流量、长尾场景、对抗样本中持续补充,逐步扩大覆盖面
数据集是长出来的,不是一次写完的。每发现一个失败案例,就应该收进数据集,让它永不复发(回归测试的思想)。
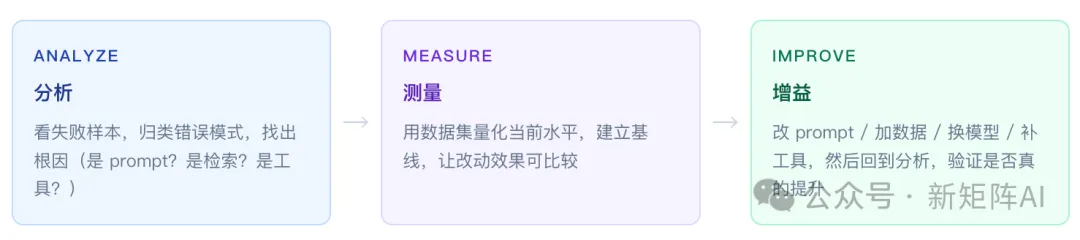
2.3 建立"分析—测量—增益"循环
这个循环是闭环:改完必须重新测量,否则你不知道改动是"真提升"还是"感觉良好"。很多"优化"在数据上其实是退步的。
3生产与迭代阶段 Production
① 发现异常:两条路并行
- 自动化巡检:定时跑数据集、监控线上指标(成功率、耗时、拒答率)、异常告警。覆盖广度,7×24 小时。
- 人工介入:人工标注、真实用户反馈、bad case 收集。覆盖深度,发现自动化测不出的新问题。
自动化发现"已知的已知",人工发现"未知的未知"。两条路缺一不可。
② 实验优化:把问题转化为资产
业界补充:评测进 CI,做发布门禁(Google / Braintrust / DeepEval 共识)
评测不应只是"上线前跑一遍",而应作为自动质量门禁集成进 CI/CD:每次提交改动(prompt、模型、工具配置)时,流水线自动对参照数据集运行评测,分数跌破预设阈值就直接 fail build,从机制上防止质量回归进入生产。"预算和阈值写在文档里会被忽视;写进测试里才会被执行。"
把每个问题转化为新增数据,并更新数据集。失败样本不是负担,而是最宝贵的评测资产——它精确指出了系统的能力边界。收集进数据集后,下次迭代就能自动验证是否修好,且永不复发。
五、Agent 评测Agent Evaluation
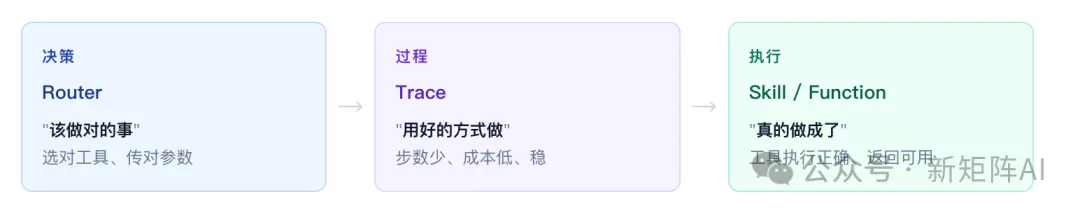
Agent 和普通 LLM 应用最大的不同:它不只是"回答",还会做决定、走步骤、调工具。所以评测要拆成三个维度。
Agent 评测的三大核心维度:决策(路由)、过程(轨迹)、执行(工具)。
1 路由评估 Router Eval— 决策
判断 Agent 在每一步是否做出了正确的决策:
- 是否传了正确的参数(查询日期、ID、筛选条件对不对)
- 是否需要调用工具(该直接回答时有没有多此一举去调工具)
为什么先评路由
"便用决策模型"——路由错了,后面所有步骤都是错的。工具选错,再好的参数、再漂亮的输出也没意义。路由是整条轨迹的第一块多米诺骨牌。
2 轨迹评估 Trace Eval— 过程
关注 Agent 走了多少步、走了哪条路。同一个任务可能有很多条路径都能达成结果,但它们的代价完全不同。
需要同时考虑三个量:
| | |
|---|
| 成本 | Cost | token 消耗、工具调用费用、API 计费。同样结果,成本差 10 倍就是产品级差距 |
| 延迟 | Latency | 端到端响应时间。多步 Agent 的延迟是各步累积,步数直接决定用户等待多久 |
| 可靠性 | Reliability | 同样输入多次运行,结果是否稳定一致。Agent 的随机性放大了不确定性 |
怎么评估轨迹
运行 N 次,统计路径分布,重点看两个量:
- 最少路径
- 最优路径:在成本 / 延迟 / 可靠性综合权衡下最好的那条。衡量"现在的差距有多大"
多次运行还能暴露不稳定性:如果一个任务有时 3 步、有时 15 步,说明 Agent 的行为不可控,这在生产环境是隐患。
业界补充:pass@k 与 pass^k(来自 Anthropic)
衡量可靠性时,两次指标含义完全不同:
Anthropic 的洞察:大多数产品需要的是 pass^k,但社区默认报告 pass@k——这让 Agent 看起来比实际可用。汇报指标时先想清楚自己的产品属于哪一类。
3 Skill / Function 评估 Execution— 执行
评估每个具体工具 / 技能本身执行得对不对。核心认知:
不同工具,不同的评估方式。没有万能的工具评估标准,每个工具都要根据它的输入输出形态设计专属判据。
| |
|---|
| SQL 是否合法、能否执行、结果集是否正确、是否超时 |
| |
| |
| |
| |
业界争议:要不要评固定路径?(Anthropic vs 高风险派)
多数派(Anthropic、context engineering 社区):评结果,不评具体步骤——Agent 常常走出一条评测设计者没预料到、但同样正确的路;僵硬的路径断言会把优质方案误判为失败(Anthropic 举过 Opus 4.5 在 τ²-bench 订机票时发现政策漏洞、"评不上分但对用户更好"的例子)。
少数派(高风险派):对发钱、删数据、发邮件这类危险动作,关键步骤必须逐断言检查——结果对了但过程违规,一样不可接受。两派其实不矛盾,合并成一条实践准则:常规任务评结果,危险动作评路径。
三个维度的关系
三者是串联关系:决策错 → 过程再优也没用;过程差 → 结果对了但成本高;执行错 → 前面全白费。排障时也要按这个顺序查:先看路由对不对,再看路径是否冗余,最后看工具是否执行成功。
六、业界专家方法论与观点Expert Views
以下内容整理自 2025–2026 年业界公开的工程博客、论文与官方文档,原文链接统一列在文末附录。来源:Anthropic 工程博客、Hamel Husain、Shreya Shankar(UC Berkeley)、LangSmith、OpenAI、Google Cloud、Braintrust / DeepEval、τ-bench 与 Stanford AI Index。
1 Anthropic:Agent 评测解密(2026-01,公认最系统)
作者 Mikaela Grace 等,核心观点:让 Agent 有用的特性(自主决策、多轮行动、工具调用、修改环境)恰恰是它难评的原因——错误会沿轨迹传播、行为有随机性、正确路径不唯一。
| |
|---|
outcome ≠ 嘴上说的 | Agent 说"预订成功"不算成功,环境中真的出现订单才算成功(outcome = 环境最终状态) |
| 同样的结果可能掩盖完全不同的行为:靠危险命令"撞"对的结果不可上生产;方案正确但因外部超时失败的过程不该被一票否决 |
pass@k | 前者 = k 次至少一次成功(工具型场景);后者 = k 次每次都成功(产品型场景)。多数产品需要 pass^k,但社区默认报告 pass@k |
| 跑很多次都是 0%(如 pass@100 = 0)——通常是题坏了,不是 Agent 不行;环境要每次隔离;题集要覆盖"该做"与"不该做"两类样本 |
| 从 20–50 个真实失败案例起步,不要凭空想象失败模式;用便宜的小模型挖生产轨迹,"把观测数据变成评测数据" |
2 Hamel Husain:不看数据,一切白搭
AI 评测社区最有影响力的实践者(前 GitHub 数据科学负责人)。核心主张一句话:去看你的 traces——他咨询时的第一句话总是这句,且"每一次都能发现对方没想到的问题"。
错误分析三步法(源自社会科学扎根理论)
| | |
|---|
| 逐条读 trace,每条只记最上游的第一个错误,一行笔记 | 一个人做("仁慈独裁者"),不搞委员会;至少 100 条 |
| 笔记喂给 LLM 聚类成命名的、可行动的失败类别,人工审校 | |
| | |
几个反直觉观点
- 别用 1–7 分打分,用二元 pass/fail——"4.2 和 3.7 有什么区别?"没人说得清;二元判断强迫你定义清楚成功标准
- 能直接修的,不写 eval——只有不知道怎么修、需要反复实验的,才值得建 eval
- eval 别做到 100% 通过率——100% 通过说明 eval 不再提供任何信息;不要饱和你的 evals
- 用户点踩反馈远远不够——用户对 AI 极度宽容,会默默绕过失败而不报告
- prompt 编辑权交给领域专家——工程师不是领域专家,prompt 藏在代码里会拖垮迭代速度
3 Shreya Shankar(UC Berkeley):谁来验证验证器?
论文《Who Validates the Validators?》一作。核心结论:未经校准的 LLM judge 与人类判断的一致率可能低到没有使用价值。她的 judge 设计纪律:每个 judge 只管一种失败模式;只输出二元 true/false;上线前用 100–200 条人工标注算混淆矩阵校准;judge 会漂移,需定期重校。
4 LangSmith:Trace → 数据集 → 评测的工程闭环
- 闭环:线上标注队列(标记坏 case → 人工标注 → 晋升为数据集条目)→ offline eval(改动前跑数据集)→ online eval(上线后抽样打分)→ 线上发现的问题变成线下用例
- 轨迹也要打分:"一个 25 步才完成任务(基线 6 步)的运行,即使输出正确也是回归"
- 数据集会过时:"一个从不更新的评测集,描述的是一个已经不存在的产品版本"——建议每月从生产 trace 策展一次
- 每个生产失败,先变成 eval case,再修
5 OpenAI:把任务描述成 eval(类 BDD)
官方 workflow 三步:把任务描述成 eval → 用测试输入运行 → 分析并迭代,官方明确说这是行为驱动开发(BDD)的 AI 对应物。最佳实践五部曲:定义目标 → 收集数据集(开发时把日志全记下来,从日志挖用例)→ 定义指标(拒答列表需要单独的测试集)→ 运行与对比 → 持续评测。点名的反模式:评测集与生产流量分布不一致。
6 Google:多支柱评测 + 质量门禁(ADK 团队)
- 四支柱:程序化评估(客观、做回归)+ LLM-as-a-judge(主观质量规模化)+ 人工评估(金标准,校准用)+ 对抗测试(测失败方式:是安全地失败还是产生有害输出)
- 没有黄金集也能起步:先人工 + vibe 指标定方向,把早期反馈聚合成二元指标交给 judge 自动跑,用 A/B/C 等级汇总——别让"等黄金集建好"阻塞启动
- 评测是 CI 门禁:每次提交自动跑评测,跌破阈值 fail build
- 双 LLM 对打造数据:一个 LLM 扮演用户与被测 Agent 多轮对话,批量生成多样数据
7 评测驱动开发(EDD):AI 时代的 TDD
"生成(generator)吸引了所有注意力;但让输出值得被信任的是验证器(verifier)。验证一个方案通常比生成它容易——这正是为什么一个 modest 的评测套件能够驾驭一个强大得多的生成器。"
—— evaldrivendevelopment.dev
- 形态与 TDD 相同(先写检查、再写到通过),变的是"检查"本身:TDD 用确定性单元测试,EDD 用能评估非确定性输出的 eval
- grader 优先级:代码/执行判定(最快最难钻空子)→ LLM-as-judge(须先经人工校准)→ 人工评审(校准基准,太贵不用于每次运行)
- Braintrust 四要素:eval 即规格(需求先改进评测标准)、数据与运行可溯源、judge 校准、回归门禁
- DeepEval 的数字:~100 条黄金用例起步、上限 500;定义 3–5 个与业务强相关的指标;质量远比数量重要——自动生成几千条只会得到"AI slop"
8 学术侧:基准可信度危机
- 数据污染:OpenAI 2025 年审计发现前沿模型能逐字复现 SWE-bench Verified 部分任务的标准 patch;HumanEval 约 40% 样本已被污染;GSM8K 去掉污染样本后准确率掉 13 分。OpenAI 于 2025 年底不再报告 SWE-bench Verified 成绩
- 题目本身有 bug:ABC paper 检查十个 agentic benchmark——七个结果效度有问题、七个任务效度有问题,性能估计偏差最高可达相对 100%;有团队用一个扫描 Agent"攻破"了 8 个最常被引用的基准
- 只看结果不看过程
- 回应:τ²-bench / Gaia2 动态生成题目、异步双控设计;METR 用"任务时长"做统一标尺(AI 能完成的任务时长约每 7 个月翻倍);Stanford AI Index 2026 指出基准饱和周期从年缩短到月
对业务团队的推论:公开基准分数只是参考指标(proxy),不是判决书。唯一完全作数的基准是你自己的 Agent、你自己的任务、接近你自己的环境——这正是第一章"必须自建数据集"的业界印证。
9 共识与分歧
高度一致的共识
| |
|---|
| 从真实 trace 建数据集,别凭空想象 | Anthropic、Hamel、LangSmith、OpenAI、Google——五方完全一致 |
| 结果和过程都要评 | Anthropic、LangSmith、Google ADK |
| 代码判定优先,judge 次之,人工做校准 | EDD 社区、Anthropic、Hamel、Braintrust |
| LLM judge 必须先经人工校准 | Shreya Shankar(最强调)、Hamel、Anthropic、Google |
| 每个生产失败都沉淀为 eval case | LangSmith、Google、Braintrust |
| 评测进 CI,成为发布门禁 | Google、Braintrust、DeepEval、OpenAI |
| 数据集是活的,会过时,需持续策展 | LangSmith、Anthropic、Hamel |
| 多次运行测可靠性(k 次而非 1 次) | Anthropic(pass^k)、τ-bench |
有分歧的地方
| |
|---|
| 评测集该多大 | Anthropic:20–50 个真实失败起步;DeepEval:~100 条起步、上限 500;Hamel:LLM judge 每种失败模式需 100–200 条人工标注。底线一致:质量远比数量重要 |
| 要不要评固定路径 | 多数派:评结果不评步骤(Agent 常走出没预料但正确的路);高风险派:发钱、删库等危险动作关键步骤必须逐断言检查。合并准则:常规任务评结果,危险动作评路径(已补入第五章) |
| "评测驱动"这个名字对不对 | Hamel:"它就是开发本身";Braintrust/EDD 社区:名字值得强调,因为生成便宜之后瓶颈在验证。实质是同一件事 |
七、一页速查Cheat Sheet
数据集三要素
| |
|---|
input | |
reference_output | 期望答案,可选;无标准答案时靠 LLM-as-a-judge 做无参考评分 |
metadata | 元数据,用于 example 的筛选和分层分析(来源、难度、场景、时间) |
评估三方法
三阶段与三鸿沟
| |
|---|
| 三鸿沟 | 理解鸿沟(开发者↔数据)、具象鸿沟(开发者↔应用)、泛化鸿沟(应用↔数据) |
| 三阶段 | 原型(10–20 条,验证可行)→ 开发(可观测 + 实验 + 循环)→ 生产(巡检 + 人工 + 沉淀数据) |
| 核心循环 | Analyze → Measure → Improve |
| 总原则 | |
Agent 三维度
| |
|---|
| 路由 Router | |
| 轨迹 Trace | 成本 Cost、延迟 Latency、可靠性 Reliability;跑 N 次看最少/最优路径;产品型场景看 pass^k(每次都成功),工具型场景看 pass@k(至少一次成功) |
| 技能 Skill | |
附录:参考资料References
工程博客与官方文档
- Anthropic — Demystifying evals for AI agents (2026-01-09,第六章第 1 节)
- Anthropic — Building Effective Agents (第六章第 1 节)
- OpenAI — OpenAI Evals Guide (第六章第 5 节)
- Google Cloud — A methodical approach to agent evaluation (第六章第 6 节)
- LangSmith — 平台官网 · Evaluation 文档 (第六章第 4 节)
实践者长文与课程
- Hamel Husain — Your AI Product Needs Evals (第六章第 2 节)
- Hamel Husain — AI Evals: Everything You Need to Know (FAQ,第六章第 2 节)
- EDD 社区 — What is eval-driven development? (第六章第 7 节)
- Braintrust — Eval-driven development (第六章第 7 节)
- DeepEval — Eval Driven Development: What it is, how to do it right (第六章第 7 节)
学术论文、基准与行业报告
- Shreya Shankar et al. — Who Validates the Validators? (第六章第 3 节)
- Xia et al. — Evaluation-Driven Development and Operations of LLM Agents (EDDOps 框架,第六章第 7 节)
- Sierra Research — τ-bench · τ-bench 已知问题汇总 (第六章第 8 节)
- Stanford HAI — AI Index Report 2026 (第六章第 8 节)