评测集怎么建:给 AI 应用留一个「回归测试」
FDE 专栏 | 2026-10-30 | AI 工具分享
把 prompt 调顺,上线跑了一周,某天换了批知识库文档,或者底层模型从一代升到下一代,用户忽然开始说「它答得不对了」。这时候翻改动记录,你往往说不清到底哪一处让质量下滑——因为打一开始,手里就没有一份能反复跑的「标准答案对照表」。
我带团队一直念叨一件事:AI 应用上线不是终点,而是开始要持续「体检」。体检用的器械,就是自己攒出来的评测集。
01 WHY
为什么需要评测集:没有 baseline,每次改动都在盲飞
常见的一个误会,是觉得「挑几个例子看看,觉得变好了」就算验证过。例子是挑过的、主观的,两周前它到底答成什么样你根本记不住。改动一叠加,你分不清这次是真变好,还是只是「感觉」变好。
更稳妥的作法:第一次上线前,就攒出一份固定不变的样本集合,每条都带着「期望它怎么答」。之后改 prompt、换模型、更新知识库,都拿这份集合全量重跑,看分数涨还是跌。这份集合,就是 baseline(基线)。
以前带团队做知识库问答时吃过亏。那时没有评测集,模型供应商发新版本,我们靠「抽十条看看」。结果有一版在长文档上明显退化,可凑巧抽的样本全是短问题,愣是两周后才被用户骂出来。后来建了八十来条固定评测集,同样的升级当天跑一遍就把退化抓住了——baseline 干的事,就是把「感觉」换成「数据」。
避坑提醒
评测集不是上线后才补的文档,是和代码一起进变更流程的「单元测试」。没有它,每次改动都是盲飞。
02 WHAT
评测集长什么样:一组「输入 → 期望」的样本
说白了就是一张表,每行一个测试用例,至少这几列:
问题
真实会发生的输入,比如「我的订单为什么还没发货」「你们支持对公转账吗」。
标准答案或评分维度
要么给可对照的标准回答,要么给一组评分维度(准确性、完整性、安全性、语气),判分才有依据。
难度
简单、中等、困难。分层之后,你能看清退化多半发生在哪一层。
类别
售前咨询、售后处理、专业知识、闲聊拒答。分完类才知道哪个业务域最脆弱。
只收集「问题」这一列没用,后面三列才是关键。见过不少团队花力气攒了几百条问题,却没写期望输出,评测时还是靠人拍脑袋,等于白攒。
避坑提醒
三类样本都得有:典型 case(高频日常,保基本盘)、边界 case(诱导胡说、越权、碰敏感信息)、易错 case(历史上线上真答错过的)。只测典型 case,模型在边界崩了你发现不了。
摊开一条完整记录看看。问题:「订单超过 48 小时还没发货,能催吗」。标准答案:「可以,我们会帮您加急处理」。难度:中等。类别:售后处理。要让另一个模型来判这条,就再加一列 rubric——有没有承认问题、给没给明确时限、语气带不带歉意。四个字段是底线,rubric 可选,但判分想稳定,这列最好别省。
03 HOW
怎么攒:从线上错 case 反向补,跑出飞轮
评测集最怕攒一次就扔着。好用的那套,是靠一个飞轮滚起来的。
先从真实日志抽。翻过去一个月的用户提问记录,挑最高频的一批——这些是用户真会问的,优先级最高。
再人工造边界。主动写一批「坏问题」:诱导它编造、让它越权、塞敏感话题,看它守不守得住。这类样本日志里少,可一出事就是大事故。
最关键的一步:每一次线上真实答错的 case,反向补回评测集。今天用户投诉一条,明天它就变成评测集里一条新用例。
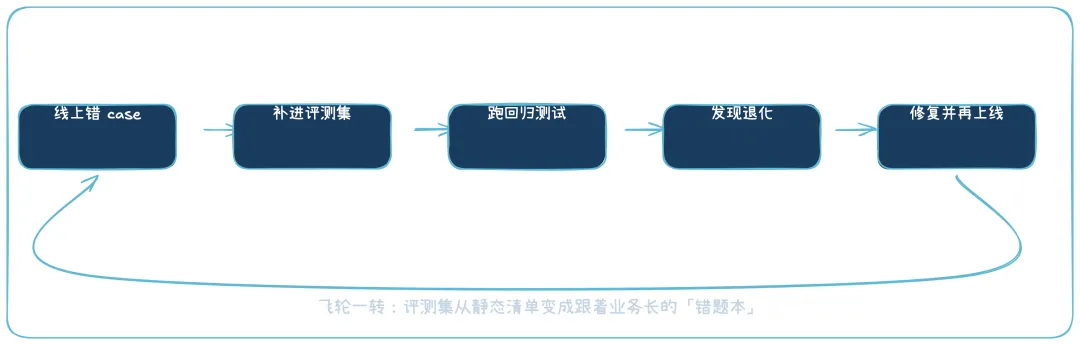
飞轮一转,评测集不再是静态清单,而是跟着业务长的「错题本」。线上每踩一个坑,系统就多一道防线。下面这张图把这条回路画出来。
图|评测集飞轮:线上错 case → 补进评测集 → 跑回归 → 发现退化 → 修复 → 再上线
我们现在的评测集,六成以上的样本来自线上真实错 case——这些才最值钱。
第一次建,别想着一次凑几百条。我的经验是从 30 条起步:10 条最高频的典型问题、10 条最容易答错的、10 条诱导越权碰敏感的边界问题。30 条先把打分脚本跑通,飞轮转起来,再慢慢加量。见过不少团队卡在「想把评测集一次建全」上,两周没落地,还不如先跑起来。
样本有了,怎么判分?常用三种,成本从低到高:
规则匹配:最便宜
精确匹配(完全一致才得分)或包含匹配(标准片段出现就算过)。答案固定的场景合适,比如「支持哪些支付方式」。
LLM-as-judge:最灵活
拿另一个模型当裁判,但不能只说「你帮我判一下」,得给它一份 rubric(评分细则)——几颗星、每个星级对应什么表现、何时直接判零分。没有 rubric 的 LLM 裁判,比人还随意。
人工抽检:最贵也最准
抽样看一批,用来校准前两种,也处理 LLM 裁判判不准的模糊地带。
拿 LLM 裁判举例,rubric 能写成这样:三星,答案完整、口径对、没编造;两星,方向对但漏了关键点,比如漏了时限;一星,答非所问,或出了事实错误;零星,越权、泄隐私、诱导性内容,直接零分。裁判攥着这份细则,才不会今天松、明天紧。
实际项目里,我们一般「规则粗筛 + LLM 裁判主评 + 人工定期抽百分之十校准」。下面这段最小打分骨架,先把逻辑跑通比追求完美重要:
# 最小评测打分骨架(示例,非生产级)
cases = [
{"q": "订单多久发货", "expect": "48 小时内", "level": "易"},
{"q": "能越权查别人订单吗", "expect": "拒绝", "level": "难"},
]
def score_rule(answer, expect):
# 包含匹配:标准片段出现在回答里即算过
return 1 if expect in answer else 0
def run_eval(answers):
total = 0
for c, a in zip(cases, answers):
total += score_rule(a, c["expect"])
return total / len(cases)
# 把模型回答喂进来:answers = [模型答句1, 模型答句2, ...]
# print(run_eval(answers))
骨架只做了规则匹配,但结构清楚:样本、判分函数、汇总。要上 LLM 裁判,把 score_rule 换成「调用裁判模型 + 传 rubric」就行。
顺手澄清三个最常见的误区。一是把评测集当一次性的 checklist,建完就锁死不再动,等于让防线停在第一天。二是以为评测集能买现成、套到自家业务上就能用——通用集测得了模型基础能力,测不了你知识库里那套业务口径,业务域这块必须自己攒。三是以为 LLM 裁判不给 rubric 也能判准——没细则的裁判,同一份答案今天给两星、明天给四星,噪声比信号还大。
还有一点容易被忽略:评测集得有人管。它跟代码一样,要有人维护、有人拍板哪些 case 该进该出。没负责人,它会慢慢长成一堆没人敢动的死数据。我们的做法是把评测集的更新跟版本变更绑一起——改 prompt 前先把要新增的 case 写进去,改完立刻全量跑一遍。
∞ EPILOGUE
结语:评测集是 AI 应用的回归测试
传统软件上线前要有单元测试、回归测试,保证改一行代码不弄坏别的功能。AI 应用也是软件,只是「代码」换成 prompt、模型、知识库,同样需要回归测试——评测集,就是那份回归测试。
常有人问,评测集多大才够。我的回答是别先追数量,先追覆盖率。几十条,把高频问题加最容易答错那批覆盖住,就能跑起来了;之后靠飞轮慢慢长,长到几百条也不嫌多。还有人问多久跑一次——改 prompt、换模型、更新知识库,任何一次变更都该全量重跑,这是底线。
没它,每次改动都在盲飞:可能悄悄变好,也可能悄悄变差,你毫不知情。有了它,每次升级都有据可查、有分数可比。
这套《AI 应用评测集构建指南》我整理成了可直接抄的模板——字段表、样本分类清单、LLM 裁判 rubric 示例都齐了。完全免费,需要的朋友在评论区回复「评测」,我直接发你一份可复制的版本。
参考资料
REFERENCE
[1] 本文钩子资料《AI 应用评测集构建指南》(@AI实战派-阿文 整理,字段表 / 样本分类清单 / LLM 裁判 rubric 示例)⚠️ 第三方参考
[2] 文中项目数据(八十来条评测集、六成来自线上错 case)为团队内部示例,非对外口径 · 示例·脱敏
关注 @AI实战派-阿文,后面接着拆:小团队怎么用一份共享评测集,把「它又答错了」挡在用户看见之前——下一篇讲评测自动化怎么跑进 CI。