上一篇结尾我留了个悬念:同一颗模型,在实验室和现场测出来的 P99 差了 40ms,我当场把原因归给了空调。
写完第二天我们回去复测。空调只值 3ms——它影响的是麦克风灵敏度和 LDO 的温漂,一共 3ms。剩下 37ms 是我们自己量错了。
不是设备的问题,是尺子的问题。这一篇讲那把尺子:精度、时延、内存、功耗,四个数各自该怎么测,以及为什么客户测出来的数字,永远比你自己报的难看。
01三个数,三种报法,差三倍
验收会开了三个小时,前两个小时在吵 21ms 和 64ms。
供应商说我们实测 21.4ms;客户的测试工程师说在他那儿是 64ms;我们自己的报告写的是 71.2ms。三个人都没撒谎,三份数据都是真的。
差别在于各自量的是哪一段。表 1 是我后来做的对照,每次开会前先发这一页,能省一个半小时。
谁 | 报的数 | 实际测的是哪一段 | 少了什么 |
芯片厂 demo | 18.9ms | 纯内核 Invoke(),输入是预算好的 int8 张量 | 特征提取、后处理、调度 |
我们初版报告 | 21.4ms | 热态连续推理 8640 次的算术平均 | 冷启动首帧、中断抢占 |
客户测试台 | 64.0ms | 从声音进麦克风到继电器动作(扣掉 1s 窗口) | 什么都没少 |
我们终版报告 | 71.2ms | 端到端 P99(含 4G 上报抢占) | — |
表 1 里最该被记住的是第三行。客户的 64.0ms 和我们的终版 63.8ms,其实是同一个数——他把 1 秒音频窗口填满的时间扣掉了,我们也是。两个团队各自摸索了三个月,最后在同一个定义上会合。
所以评测这件事的第一动作,不是买个更贵的仪器,是把「测哪一段」写成一句话,双方签字。这句话写不出来,后面所有的数都可以被质疑。
测不准不可怕,说不清「测的是哪一段」才可怕。
02精度:94.2% 是被「静音」撑起来的
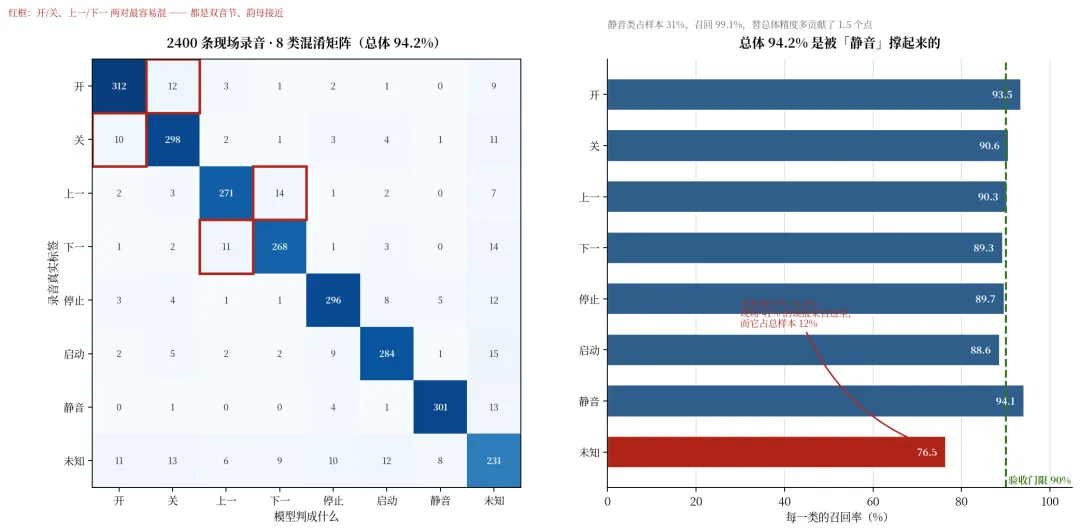
▲ 图 1左:2400 条现场录音的混淆矩阵;右:每类召回——总体 94.2% 好看,最差的未知类只有 76.5%
2400 条现场录音,8 类,混起来算 94.2%,看着能交差。
但这个数被两类东西稀释了。静音类占样本 31%、召回 99.1%,它一个人就给总体精度贡献了 1.5 个点。而真正要命的「未知类」只有 76.5%——现场 41% 的误报来自这里,因为它把所有不像关键词的声音都收进来了:气阀泄压、扳手敲管、叉车倒车的提示音。
更该看的是对角线之外。开/关互混 22 次(4.1%),上一/下一互混 25 次。这两对都是双音节、韵母接近,在 40 维 MFCC 上本来就靠得近——这不是样本量的问题,加一倍数据也只能好一两个点,是特征分辨率的问题。改成 64 维 MFCC 加一阶差分之后,这两对降到了 2.3%。
然后是按信噪比分层的精度:干净录音 97.6%,0dB 91.3%,-5dB 78.4%。泵房里 0dB 是常态,-5dB 是检修时有人拿气枪吹管路。只报 97.6% 的那一版报告,我在客户现场被问了三分钟就撑不住了。
最后一步是按现场真实类别分布加权,把静音从 31% 压到现场实际的 8%,得到 92.8%。这个数才能写进验收报告,因为它回答的不是「模型多准」,是「在客户那个环境里,一天会误报多少次」。
03时延:平均值给人看,P99 给设备用
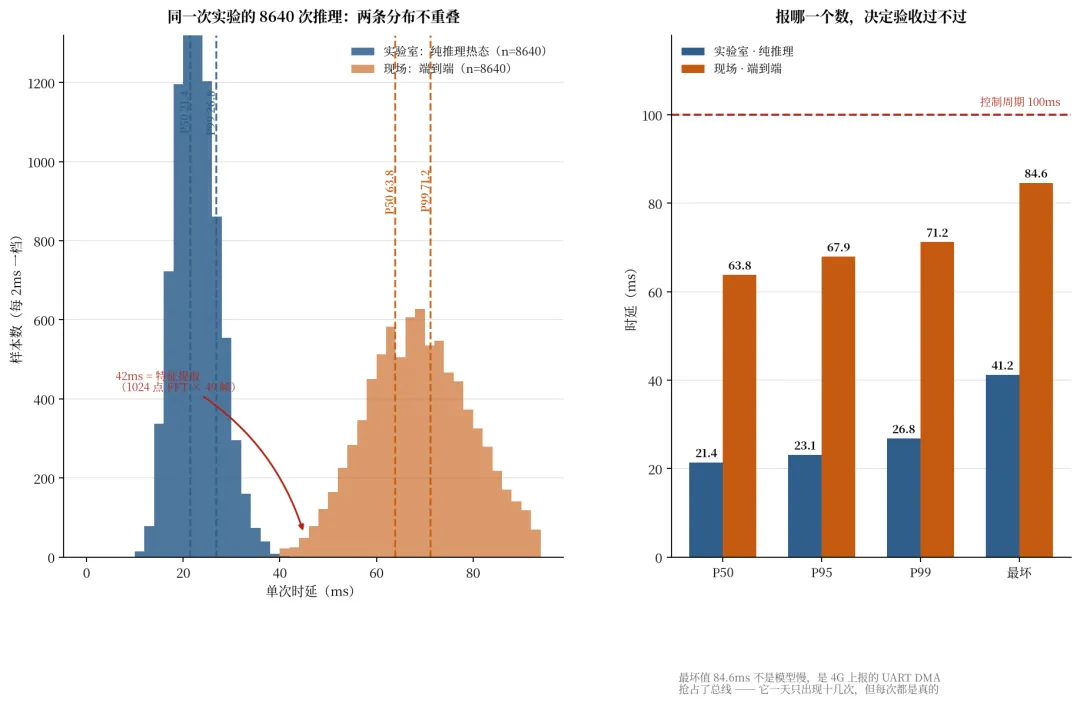
▲ 图 2左:8640 次推理的两条时延分布,整体右移 42ms;右:四个统计量,报哪一个决定验收过不过
21.4ms 这个数是 8640 次连续推理的平均值。它不服从正态分布,是明显右偏的——图 2 左边那条蓝线,主峰在 19~22ms,尾巴一直拖到 41ms。
尾巴的成因有三个:SysTick、4G 模组的 UART DMA 半满中断、以及 Flash 预取偶尔 miss。每一次都只多几毫秒,但一天 8640 次里总有那么几十次撞在一起。
P99 = 26.8ms 的意思很具体:每 100 次里有 1 次超过它,一天 86 次。如果推理挂在 50ms 的控制周期里,这 86 次就是 86 拍「没赶上」。客户不会看平均值,他看的是设备有没有在关键时刻卡一下。
那条橙色的分布整体右移 42ms,形状和蓝色几乎一样——因为移过去的那一段是确定性的:1024 点 FFT × 49 帧,用 CMSIS-DSP 的 arm_rfft_q15 加 Mel 滤波器组,42.1ms,比推理本身还多一倍。
这就是上一篇那个 40ms 的真相。我把它归给空调,是因为现场机柜确实有台空调对着吹,而且那天它确实开着;但空调只解释 3ms,剩下 37ms 是我们在实验室从来没量过特征提取——输入一直是预算好的 MFCC 张量,那 42ms 根本不在账上。
04怎么测才不算自欺欺人
五种测法,我们都用过,按时间顺序排就是一部踩坑史。
测法 | 分辨率 | 单次开销 | 能测到什么 | 结论 |
printf + 串口 | 1ms 量级 | 115200 下一行 23 字符 ≈ 2.0ms | 只能看数量级 | 不可用 |
HAL_GetTick() | 1ms | 中断里可安全调用 | 毫秒级,抖动 ±1ms | 粗筛可以 |
DWT->CYCCNT | 12.5ns @80MHz | 两条指令,<10ns | 函数级,需先开 TRCENA | 实验室首选 |
GPIO 翻转 + 逻辑分析仪 | 83ns(12MS/s) | 翻转本身 40ns | 端到端、跨中断、可回溯 | 验收必用 |
ITM 时间戳 | 依赖 SWO 带宽 | 有缓冲溢出风险 | 打点方便,丢包难查 | 辅助 |
第一行那个数值得算一遍:115200 波特率,8N1 每位 8.68μs,一行 23 个字符带换行是 24 字节、240 位,2.08ms。你要测一个 21ms 的过程,用一把 2ms 刻度的尺——精度只有 10%,还得算上串口中断本身的优先级抖动。我们第一版报告的 21.4ms 就是这么测出来的,事后证明运气好,误差刚好互相抵消。
DWT 那个计数器有个前提:CoreDebug->DEMCR 的 TRCENA 位要置 1,否则 CYCCNT 一个数都不动。这个坑我们踩了半小时,一度以为是芯片不支持。它读一次只要两条指令、不到 10ns,对 21ms 的过程来说是免费的。
但验收报告我们用的是 GPIO:PB0 在 DMA 半满中断入口拉高,PB1 在结果入队时拉低,逻辑分析仪 12MS/s 采 30 分钟,8640 个脉冲全部存下来,事后一条条看。翻转本身 40ns,占 63.8ms 的 0.06%,可以忽略,但它把「从哪到哪」这件事变成了示波器上的两个边沿——不再有解释空间。
分工是清楚的:DWT 做日常回归,改一版代码跑一次,快,不用接线;GPIO 加分析仪出验收报告,慢,但每一帧都能回放给客户看。
05内存:三个数,别只报一个
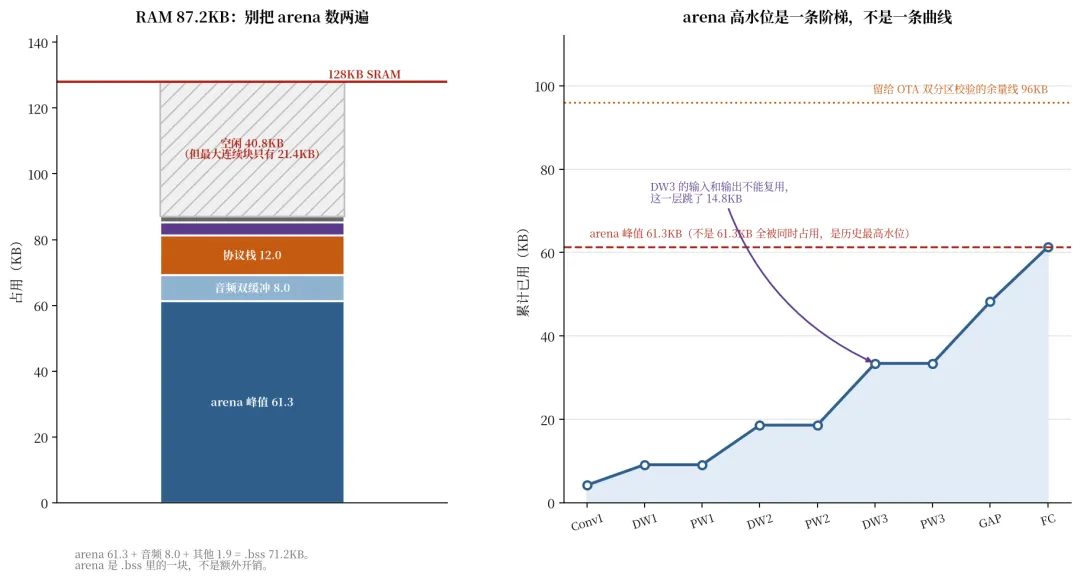
▲ 图 3左:128KB 的分配账,空闲 40.8KB 但最大连续块只有 21.4KB;右:arena 高水位是一条阶梯
内存是最容易「报对了但说错了」的一维。
第一个数,arena 峰值 61.3KB。它是一条高水位线,不是同时占用——图 3 右边那条阶梯,DW3 那一层一下跳了 14.8KB,因为深度卷积的输入和输出不能复用同一块。TFLM 的 arena_used_bytes() 返回的就是这个高水位,很多人拿它当「模型大小」报出去,其实模型在 Flash 里只有 118KB,这两个数压根不是一回事。
第二个数,.bss 71.2KB = arena 61.3 + 音频双缓冲 8.0 + 其他全局 1.9。arena 是 .bss 里的一块,不是额外开销。把 61.3 和 71.2 相加报成 132.5KB 的,我在评审会上见过不止一次。
第三个数,整个 RAM 87.2KB(再加协议栈 12.0 和栈 4.0),占 128KB 的 68.1%。
但客户问「还能不能加一路传感器」的时候,这三个数一个都答不了。要答的是最大连续空闲块:我们的链接脚本把 arena 放在 0x20000000 起始,协议栈和几个控制块插在中间,结果总量还剩 40.8KB,最大连续块只有 21.4KB。一路 I2S 麦克风加双缓冲要 8KB + 6KB,塞得进;一路 QVGA 灰度图要 32KB,塞不进。
总量还剩 40KB,和最多能要 21KB,是两句完全不同的话。
栈那 4KB 也别凭感觉。我们是启动时把栈区填满 0xA5A5A5A5,跑 24 小时加最坏中断嵌套(4G 收包 + DMA + 定时器三个同时来),事后扫描到未被改写的字节数:用了 1.8KB,余量 55%。这个数每加一个中断服务函数都要重测一次,因为它变得比你想的快。
06功耗:先把账算对,再去买源表
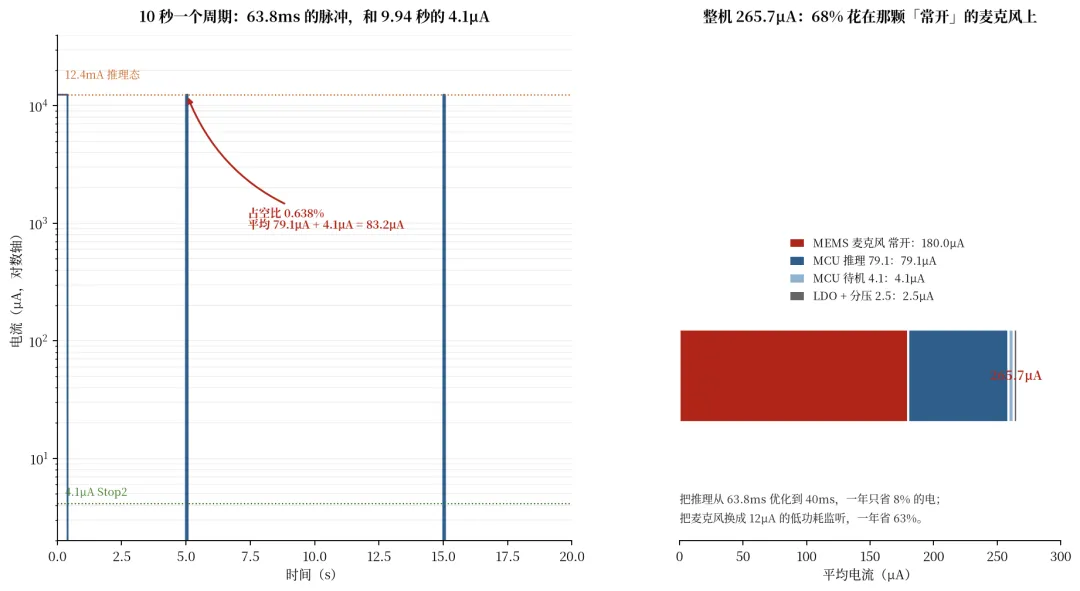
▲ 图 4上:10 秒周期的电流波形(对数轴),63.8ms 的脉冲藏在 9.94 秒的寂静里;下:整机 265.7μA 的构成
平均电流的算法很朴素:I_avg = I_active × t_active / T + I_sleep × (1 - t_active/T)。代入我们的数:12.4mA × 63.8ms / 10s = 79.1μA,加上待机 4.1μA,83.2μA。
这个数我们报了一个季度,直到客户拿整机功耗仪一测:265.7μA。差 3.2 倍。
差在那颗常开的 MEMS 麦克风上,180μA。它不在 MCU 的账上,但在电池的账上。图 4 下半张就是整机的真相:麦克风 68%、MCU 推理 30%、待机 1.5%、LDO 与分压 1%。
状态 | 电流 | 占时间比例 | 说明 |
推理(纯内核) | 12.4mA | 0.214% | 80MHz 全速,Flash 预取开 |
特征提取(FFT+Mel) | 11.8mA | 0.424% | CMSIS-DSP q15,49 帧 |
后处理 + 入队 | 9.6mA | 0.004% | 可以忽略 |
Stop2 + RTC 待机 | 4.1μA | 99.36% | SRAM 保持,时钟关闭 |
MEMS 麦克风(常开) | 180μA | 100% | 不在 MCU 账上,在电池账上 |
这张表直接改了我们后面的优化顺序。原计划花两周把推理从 63.8ms 优化到 40ms,一年省 8% 的电;改成先用 PDM 麦克风加低功耗声音检测(12μA 一级唤醒,检测到人声才开主麦克风),一年省 63%。同样是两周,一个 8%,一个 63%。
测量本身的坑还有两个。一是万用表串在 LDO 输入测不出来:63.8ms 的脉冲要求采样率至少 1kS/s,手持表的采样和分流电阻的 burden voltage 会把脉冲削平,读出来接近平均值,你以为测到了,其实只测到了一个被平滑过的数。二是调试器连着 SWD 的时候,DBGMCU 会让内核在低功耗模式下保持时钟,待机测出来 400μA。拔掉调试器、重新上电、等 3 秒,才是 4.1μA。
07可复现:把「现场」搬进实验室
三次复测,三个数:92.8%、71.2ms、87.2KB。要让人信,得让人能原样重来一遍。
我们的做法是做一个 replay 固件分支:麦克风输入从 I2S 切到 SD 卡上的 WAV 流,其余代码一行不改;2400 条 WAV 按固定顺序回放,一条 1 秒,40 分钟跑完一轮。同一份 .bin,除了输入源,别的全都一样——这句话是整个评测的地基。如果 replay 版本和量产版本编译出的机器码不同,那你测的就不是同一个东西,前面所有数字都得作废。
每份报告都带一张记录表,少一项,这个数就不可复现。
项目 | 记什么 | 为什么 |
固件 | git commit + .bin 的 SHA-256 | replay 分支必须与量产同源 |
模型 | .tflite 的 SHA-256 | 换一版量化,时延差 5% |
测试集 | 2400 条 WAV 的清单哈希 | 换几条样本,精度能差 1 个点 |
环境 | 温度 ±1°C、VDDA ±1%、屏蔽箱 | 60°C 时 P99 多 2.1ms |
仪器 | 源表/分析仪型号 + 序列号 | 不同量程的 μA 档差 3% |
温度那三点(-20°C / 25°C / 60°C)我们各测 500 次。结论是 60°C 时 P99 从 71.2 涨到 73.3ms,来源是 LDO 输出漂移和麦克风灵敏度变化,不是 Flash 的等待周期——L476 的 Flash 在 80MHz 下固定 2 个 wait state,不随温度变。这个结论只有做了温循才敢写,也只有在报告里写清楚「为什么不是 Flash」,客户才不会在第二年拿同样的问题再问你一遍。
08一张能贴进报告的表
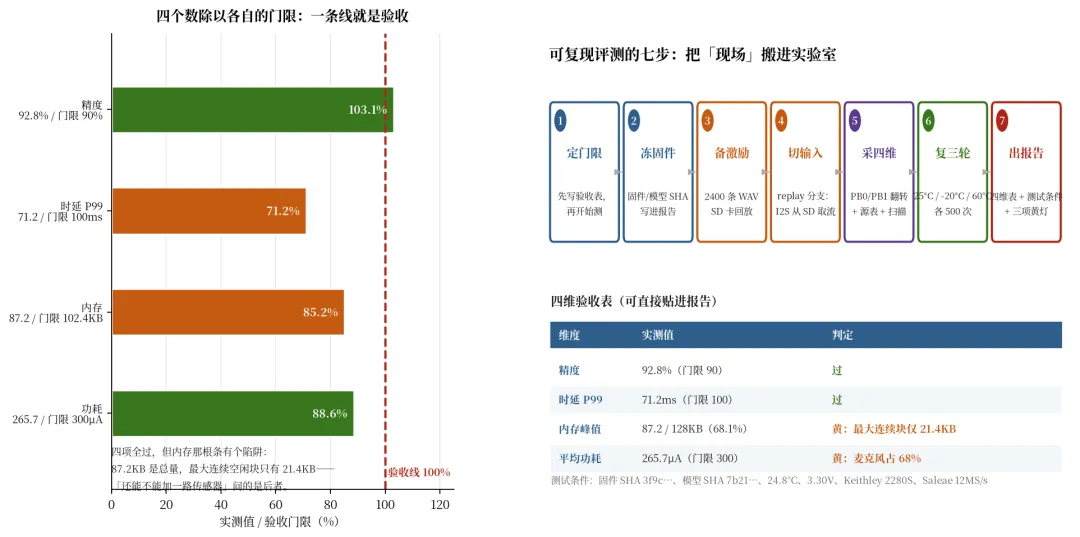
▲ 图 5左:四个数除以各自的门限,100% 就是验收线;右:七步流程与四维验收表
图 5 左边是四个数除以各自的门限。这条 100% 的线就是验收线,越过就是过,没越过就是没过,没有第三种解释。
精度 103%、时延 71%、内存 85%、功耗 89%——四项全过。但报告里我们标了三个黄灯,其中最关键的一个写在图 5 左下角:内存那根 85% 是按 87.2KB 总量算的,最大连续块只有 21.4KB。总量过线,不等于结构上还有空间。
图 5 右边那七步,是我们现在的固定流程。第 1 步「定门限」排在「开始测」之前——这一条改起来最难,因为工程师的本能是先测、测完再想这个数好不好看。顺序一反,人就会不自觉地挑一个好看的条件,而且挑的时候自己不知道。
第 7 步里有一项叫「三项黄灯」。一份全是绿灯的评测报告,客户不会信;一份写着「这里有余量但结构受限、这里过线但大头在别人账上、这里全过但只在 25°C 下成立」的报告,客户会拿去给他们的老板看。可信度不来自数字漂亮,来自你知道自己的数字在哪里会失效。
09四个「不是造假」的假数字
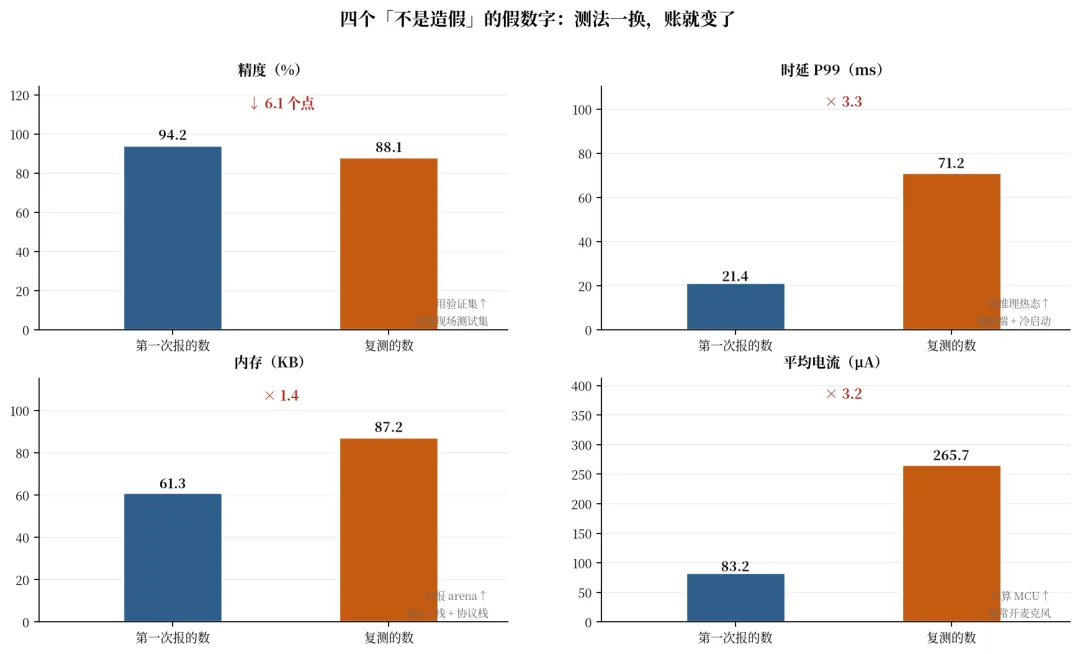
▲ 图 6四组数,没有一组是编的:都是同一个模型,换了测法
图 6 四组数,没有一组是编的,全是我们自己先报出去的。
精度 94.2 是拿验证集算的——验证集和训练集同源,同一批录音切分,说话人模型都见过。换到另一批设备、另一个季节的现场测试集,88.1。
时延 21.4 是纯推理热态——不含特征提取的 42ms,不含首帧的冷启动。内存 61.3 是 arena——不含 .bss 其余部分、栈、协议栈。电流 83.2 是只算 MCU——不含那颗 180μA 的常开麦克风。
四个数的共同点:都是「在自己最熟悉的条件下测的」。这不是职业道德问题,是视角问题——你天天待在那个环境里,就会默认它就是全部。实验室的输入永远是干净的、温度永远是 25°C、电源永远是 3.30V、调试器永远插着。
防的办法很土:验收表的第一列不写指标,写「测的是哪一段」。写不出来,就是还没想清楚;写得出来,后面填数只是体力活。
四个数里没有一个是假的,只是每个都在你最熟悉的条件下测的。
10下一篇:80MHz 到头了怎么办
这张四维表交上去之后,客户的第四个问题不是「能不能更准」,是「能不能同时跑三路」。
三路振动加一路声音加一路电流,采样率加起来 96kS/s,光特征提取就吃掉 80MHz 的 60%。到这一步不是量化能救的,是算力不够——你可以把模型压到 40KB,但压不掉 FFT 的乘法次数。
下一篇讲从 MCU 到 MPU 的那一级:STM32MP2、RK3566、Jetson Orin Nano 各自的定位,什么时候该从 Cortex-M 换到 Cortex-A,换过去要付什么代价——启动时间从 200ms 变成 8 秒、功耗从 mA 变成 W、实时性从「确定」变成「大概」,以及为什么大多数项目其实不该换。
下一篇:从 MCU 到 MPU——算力不够的时候,是该往上走一级,还是把问题拆小。
评测回答的是「现在行不行」,选型回答的是「以后行不行」。而后者,往往在你签完第一份验收报告的第二年,才来问你。
