AI 不用看攻略,直接上手玩游戏
- 更新时间 2026-11-03 05:14:00
以往玩游戏,AI 最多为我们输出通关思路、玩法攻略。
如今米哈游崩坏 AI 团队联合清华大学等机构,推出 GameScaling,让 AI 看着游戏画面,直接操控键鼠完成游戏操作,并且完成开源。
它并非 AI 绘图模型,也不是通关攻略工具。
而是一套可以感知屏幕画面,自主输出键鼠指令的游戏智能体。
一、面向游戏场景的视觉操作智能体
先说清楚GameScaling到底是什么。
简单讲,这是个专门学玩游戏的AI模型。它基于Qwen3.5视觉语言模型继续训练,参数规模覆盖了0.8B、2B、9B到27B四个档位。
和传统游戏脚本最大的区别在哪?传统脚本是开发者把每一步操作写死——走到坐标(100,200),按一下F键,然后播放一段动画。
GameScaling不玩这套。
它的工作方式,跟你我打游戏一模一样:
看一眼画面→判断局势→决定操作→输出键鼠指令→看结果→继续决策。
它不靠预设脚本,而是像真人一样边看边打。每次先规划0.2秒的动作,做完再看画面重新决策。
核心研究方向是让AI在持续变化的环境里自主行动。
二、200毫秒的决策,比你的反应还快?
这个项目有个技术细节,特别有意思,我得单独拎出来说。
GameScaling每次生成未来约 200毫秒 的动作,拆成6个约33毫秒的片段。
什么概念?你眨一次眼大概要300-400毫秒。它200毫秒内就完成了一轮“观察→决策→操作”的闭环。
比如玩射击游戏,AI可能在200毫秒里这么分配:
前66毫秒:按住W往前冲 中间66毫秒:鼠标微调,锁定目标 最后68毫秒:左键开火
当然,上面只是为了方便理解举的例子,实际输出还包括键盘状态、鼠标移动轨迹等一堆信息。
但这里有个关键误区要澄清:200毫秒是生成的动作时长,不是AI的推理时间。 也就是说,模型生成这段操作可能花了更久,但它生成的动作本身只覆盖200毫秒。
这种短时间、多轮次的决策方式,已经非常接近人类玩家“边看边调”的操作节奏了。你打团战时手忙脚乱的那几秒,AI正在以200毫秒为单位,一轮一轮地“思考人生”。
三、米哈游图什么?真不只是让你挂机
如果仅仅把这个开源项目当成游戏挂机脚本,就低估它的研究意义。
这个项目背后,有着三层更宏大的研究目标。
第一层:游戏自动化测试。
游戏开发最头疼的是什么?反复测试。一个角色能不能正常做任务?某个关卡会不会卡死?某些操作组合会不会触发bug?
传统做法是QA团队写脚本,或者人工一遍遍跑。但视觉操作模型给了新思路:让AI像真实玩家一样去探索、去试错。未来开发者可能让AI自己玩几百局,然后吐出一份“哪里卡了、哪里不合理”的报告。
第二层:跨游戏泛化能力。
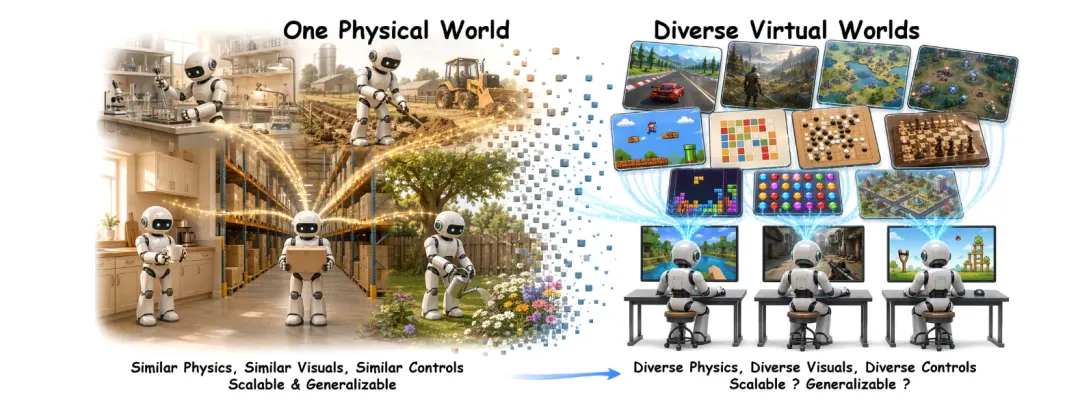
GameScaling的训练覆盖了80款游戏。这意味着研究者不满足于让AI精通某一款,而是想从大量不同游戏中提炼出通用的视觉理解和操作能力。
当然,现阶段它还做不到“通吃”。训练数据主要集中在3D游戏上,换到2D或2.5D游戏,泛化能力就明显拉胯。但这方向是对的。
第三层,探索通用 AI 智能体的实现路径。
说白了,玩游戏需要的那些能力:视觉理解、目标规划、连续决策、操作执行、实时反馈,这些放到游戏外,全是通用技能。
今天的AI能帮你写代码、总结文档。但未来的AI,得能真正操作软件、完成任务、在复杂环境里自主解决问题。游戏,就是那个成本可控、能反复训练的实验场。
AI在游戏里学会开坦克,到了战场上——哦不,到了工业场景里,它就会开挖掘机、操作机械臂。
四、它现在到底什么水平?能帮我上分吗?
直接说结论:能玩,而且有一定任务执行能力,但离“下载就能通关”还远。
官方测试主要在《我的世界》和ViZDoom上。9B规模的模型,在Minecraft MCU任务里,当最大决策步数从600提到3000时,成功率从50.9%涨到了69.3%。
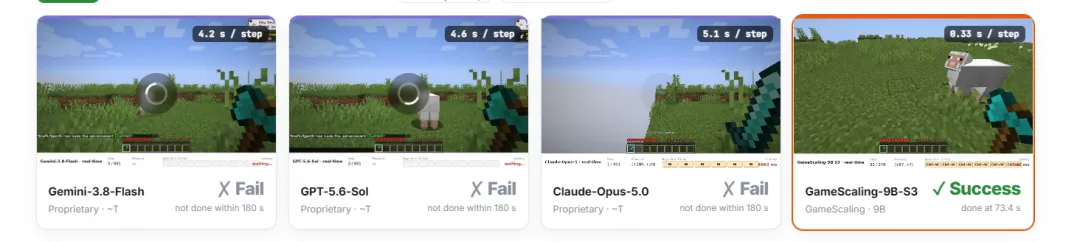
这说明什么?说明模型确实在通过更多交互步骤来“思考”复杂任务,而不是瞎按键盘。
但局限也很明显:
训练偏3D,换2D/2.5D就水土不服 推理延迟还不理想,实时性有待提升 面对陌生游戏,稳定性堪忧
所以现阶段,它更适合被看作一个研究级游戏智能体,而不是成品外挂。
目前开放的模型规格:
对开发者来说,这意味着你终于可以研究和改造一个专门用于游戏操作的视觉语言模型了,不用从零开始。
但别高兴太早。开源≠开箱即用。想让它操作你自己的游戏,还得搞定画面获取、动作执行、推理环境这些工程问题。而且官方目前没放训练数据和训练代码。
项目地址:
GitHub:https://github.com/THUSI-Lab/GameScaling 官方页面:https://gamescaling.github.io/
最后
过去几年,我们习惯了让AI回答问题。
不会写代码,问AI。不会做表,问AI。游戏打不过,问AI。
但GameScaling代表的,是另一条路——AI不再只是告诉你“该怎么做”,而是直接说“我来”。
这条路还很长。但方向已经明确了。
#GameScaling# 米哈游 AI#AI 游戏智能体 #大模型# 清华开源 #视觉语言模型 #AI 自主操作 #游戏 AI# 通用人工智能 #游戏自动化测试
