通用机器学习原子间势(uMLIP)的排行榜,几乎都按同一个逻辑打分:把模型预测的形成能与某个 DFT 数据库对比,误差越小排名越高——默认那个数据库就是「真值」。问题在于,独立的高通量 DFT 数据库彼此之间并不完全一致;而一个模型误差低,也可能只是因为它的训练数据与参考库共享同一套元素能量约定,属于记账优势,而非势能面更准。
杨百翰大学(BYU)Gus L. W. Hart 与美国能源部堪萨斯城国家安全园区的 Jacob N. Pursley 近日发表一项基准研究:把 14 个 uMLIP 放在 145 万个有序金属间化合物 上评测,参考库选用所有模型都没训练过的 AFLOW,并且把每一项误差都与「DFT 对 DFT」的分歧做对照。结论是:三个看似确凿的模型失败,在正确的对照实验下缩小乃至消失。
这套基准有三个刻意的设计。其一,参考库是 AFLOW——14 个模型的训练语料(MPtrj、OMat24、Alexandria 等)都不包含它,因此测的是「迁移」而非「回忆」;对每个模型而言,测试集中 52%–98% 的合金结构都是陌生的。其二,测试化学空间是有序金属间化合物,一个被主流排行榜(偏向氧化物与 ICSD 条目)系统性低估的区域。其三,所有结构与能量都从 AFLOW 的弛豫构型出发重新弛豫,几何、能量、漂移同口径测量。
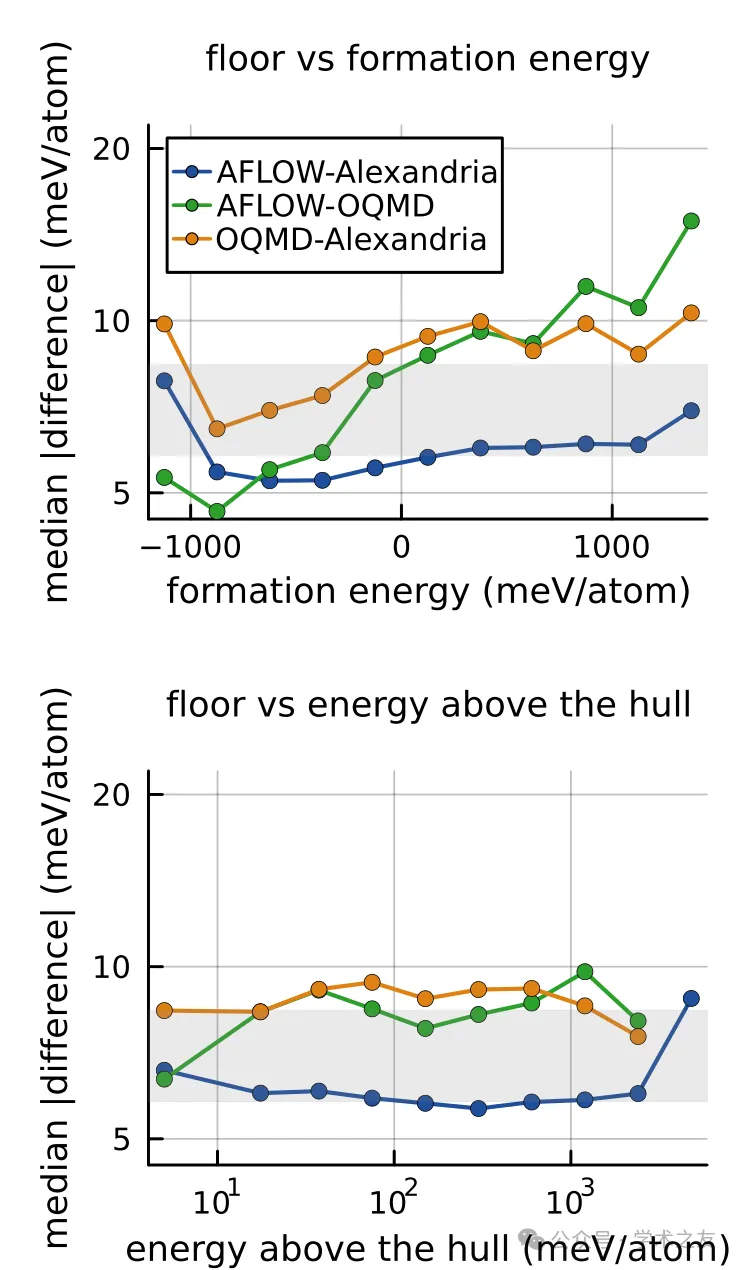
更关键的是底线校准。作者先不问模型误差多大,而是先问 两个独立的 DFT 数据库彼此差多少:在 27,427 个三方共有的同晶体结构上,AFLOW 与 Alexandria 的中位分歧为 5.8 meV/atom,AFLOW 与 OQMD 为 8.4 meV/atom。但分歧分布是重尾的——少数结构差得离谱——按与模型误差相同的截尾均值口径,底线抬升到 16–30 meV/atom。这个底线、而不是零,才是模型误差的现实目标。顺带一提,唯一对能量做事后修正的 Materials Project 与 AFLOW 的中位分歧达 18.0 meV/atom,明显游离于 raw-PBE 库之外。
图 1|DFT-vs-DFT 底线:三对独立数据库(AFLOW–Alexandria、AFLOW–OQMD、OQMD–Alexandria)在同晶体结构上的形成能分歧随形成能(上)与离 Hull 距离(下)的变化,灰带为中位底线。底线在整个能量范围内保持 5–10 meV/atom,不随离 Hull 变远而劣化。
图源:arXiv:2610.30641,Fig. 1
一个模型与某数据库的一致程度,不可能比两个数据库彼此的一致程度更精细——排行榜的分辨率天然有上限。
亮点 1|换算同一把尺后,领先者的「领先」大部分消失了
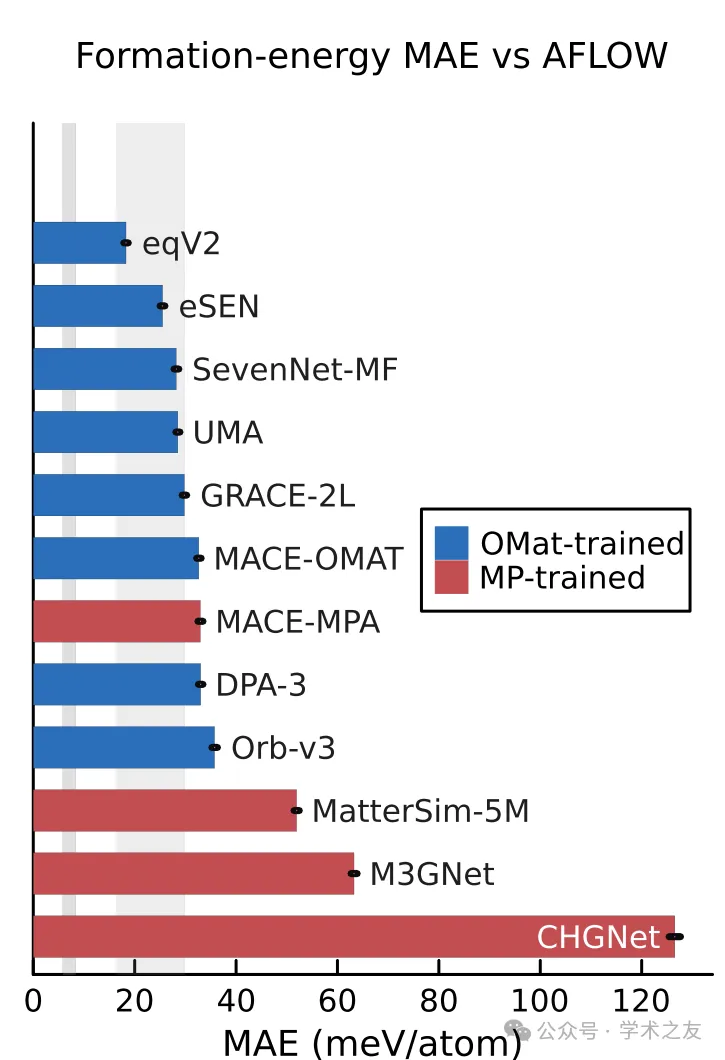
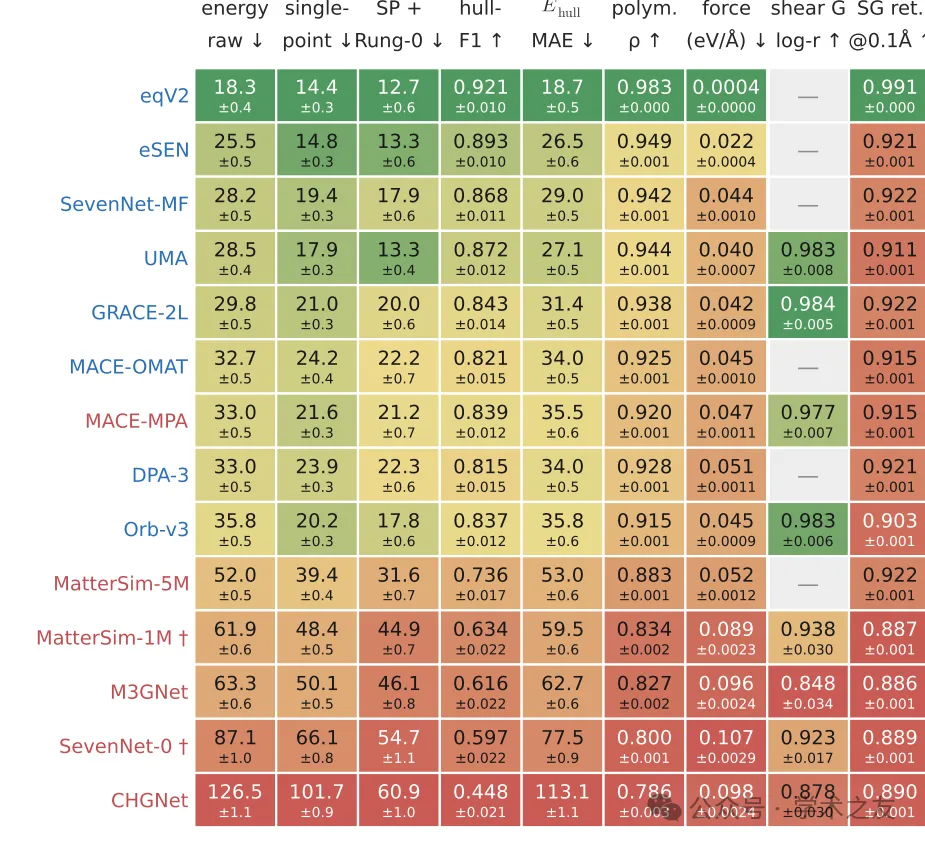
按常规口径(弛豫后形成能对 AFLOW 的截尾 MAE),eqV2 以 18.3 meV/atom 领跑,eSEN 次之(25.5),OMat 代模型密集分布在 28–36,MP 代明显落后(MatterSim-5M 52,M3GNet 63,CHGNet 127)。置信区间不超过 ±2 meV/atom,差距在统计上确凿。
图 2|12 个头部 uMLIP 对 AFLOW 的形成能 MAE 排行榜(含 95% 置信区间),蓝色为 OMat 代、红色为 MP 代;两条灰带分别是中位底线(6–8)与截尾均值底线(16–30 meV/atom)。
图源:arXiv:2610.30641,Fig. 2
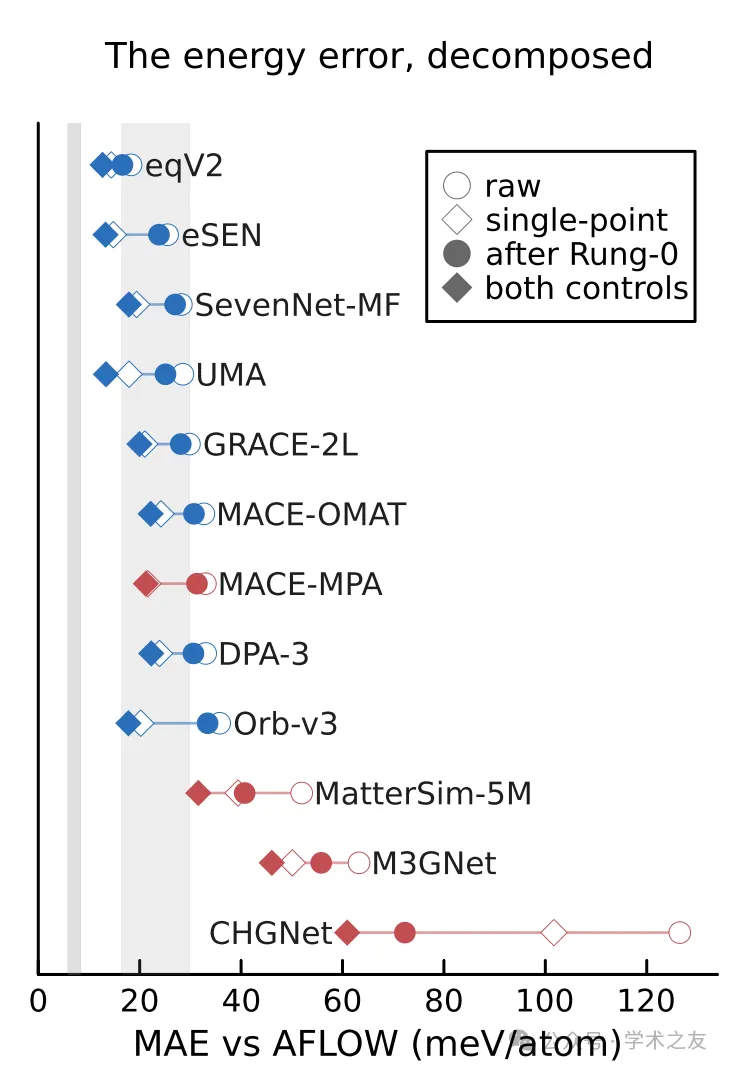
但这个排名混进了两样与势能面无关的东西。第一样是弛豫漂移:eqV2 的力来自独立的直接力输出头,几乎不把结构推离 DFT 极小点,其余 13 个模型则要「吸收」弛豫带来的能量变化。作者用单点控制(直接在 AFLOW 几何上取能量、不再弛豫)拉平这一不对称——所有模型改善 4–25 meV/atom,而 eqV2 对 eSEN 的领先从 7 缩到 0.4 meV/atom,仅为截尾底线的约 3%。
第二样是元素参考约定。作者提出 Rung-0 诊断:每个元素只拟合一个能量常数,把模型重新对齐到 AFLOW 的参考系——不动任何网络权重,且在 70% 化学体系上拟合、30% 上评分。对九个模型它只抹去 1.2–3.4 meV/atom;但对三个没用过 Alexandria/OMat24 的模型抹去 7–54 meV/atom,CHGNet 从 127 降到 72——其表观误差的两成五是逐元素偏移,而非结构相关误差。两个控制同时施加后,前三名(eqV2、eSEN、UMA)挤在 0.7 meV/atom 之内,这种间距在底线面前没有物理意义。
图 3|逐模型的能量误差分解:空心圆为原始(弛豫后)误差,空心菱形为单点控制,实心圆为 Rung-0 重参考后,实心菱形为两个控制同时施加。
图源:arXiv:2610.30641,Fig. 3
剪切模量:怪模型之前,先看参考用了什么哈密顿量
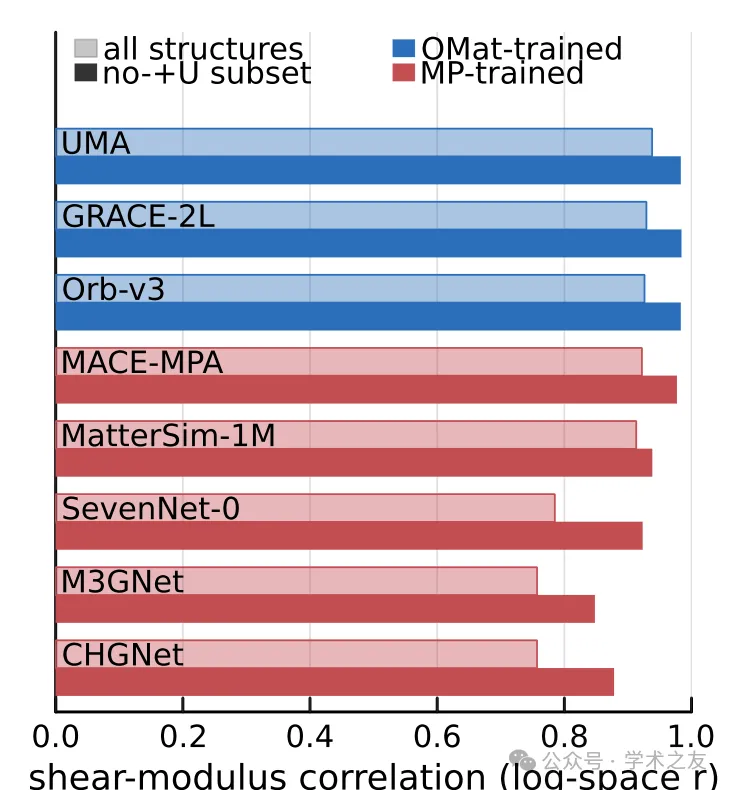
约 3,500 个结构的弹性张量对比中,体积模量与 AFLOW 吻合良好(对数空间 r = 0.91–0.99),剪切模量却差(r 低至 0.76),像是模型系统性偏软。但分层后发现:AFLOW 对含 28 种(后)过渡金属的化合物施加 Hubbard +U,这类结构占弹性子集的 78%,而模型的训练数据大多不加 +U。剔除 +U 结构后,剪切相关性恢复到 0.85–0.98(MACE-MPA 0.92→0.98)。哈密顿量不匹配可以伪装成模型失败——不过最老一代模型 0.48–0.73 倍的常数因子偏软,在对照后依然成立。
图 4|预测剪切模量与 AFLOW 的对数空间相关性:浅色条为全部结构,深色条为剔除 AFLOW 的 +U 结构后。蓝为 OMat 代,红为 MP 代。
图源:arXiv:2610.30641,Fig. 6
15,278 个「坏点」:多数坏的是参考,不是模型
作者反向提问:哪些结构上八个模型高度一致、而 AFLOW 独自偏离 0.3 eV/atom 以上?共识测试找到 15,278 个这样的分歧点;先做逐元素偏移修正后剩 10,861 个(被洗掉的 4,419 个中 91% 含磁性 3d 元素)。再请第三数据库仲裁:Alexandria 持有其中 3,794 个同晶体结构,83% 站在模型一边(它与模型共识的中位分歧 13 meV/atom,与 AFLOW 则达 412);OQMD 仲裁的 322 个中 93% 站模型。最终确认的真模型错误只有 643 个,且高度集中于 4d/5d 难熔金属(占 68%)——这是留给下一代训练数据的真实靶点。
另一方向同样成立:模型自己的「坏参考」会污染所有含该元素的化合物。MACE-MPA 把一个金刚石相 Fe 原胞放低到 0.94 eV/atom 以下,DPA-3 的 bcc-Gd、eSEN 的 Cs 亦然;筛查并剔除这些病态单质结构后,MACE-MPA 的原始 MAE 从 48.2 降到 33.0,eSEN 38.6→25.5,UMA 35.0→28.5。
亮点 3|泛化是真泛化,记忆优势小于 1 meV/atom
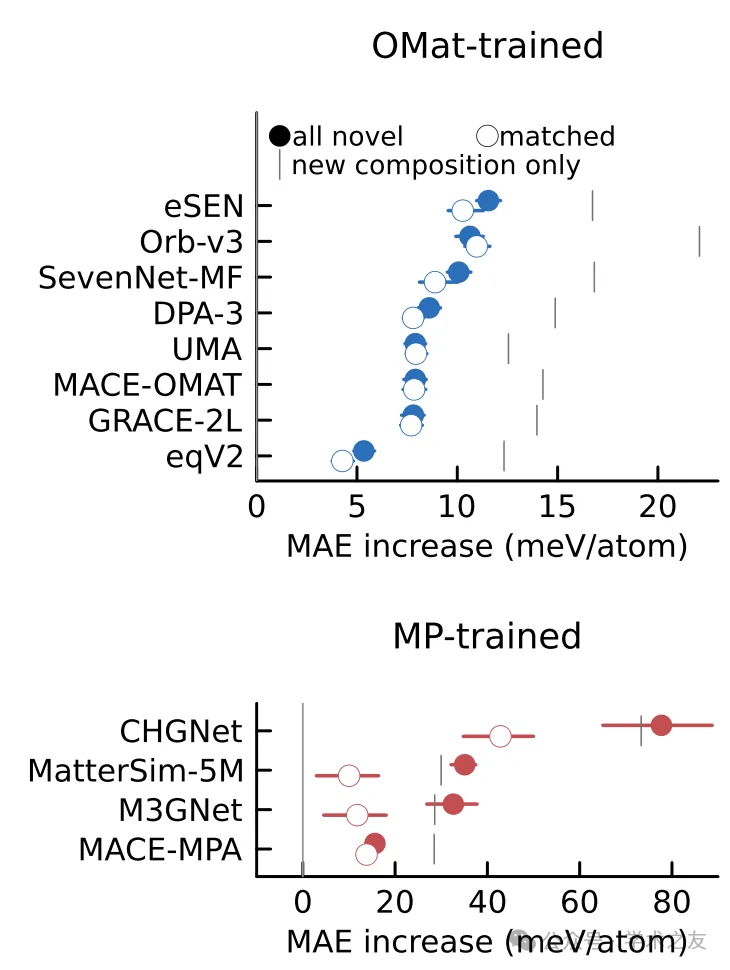
排行榜领先究竟是泛化还是背题?作者用结构匹配逐个标记「训练中见过 / 没见过」。OMat 代模型在陌生结构上的误差只比熟悉结构高 5.3–11.6 meV/atom(eqV2 最少 +5.3),匹配 Hull 距离与元素数后仍余 4.3–11.0;而在离 Hull 100 meV/atom 以内——即材料筛选真正关心的区域——陌生结构仅差 0.5–3 meV/atom。对 Alexandria 独有化合物的直接检验显示,「见过该化合物」带来的优势被限定在 1 meV/atom 以下。大模型赢在泛化,不靠记忆。
图 5|泛化差距:陌生结构相对熟悉结构的 MAE 增量。实心点为全部陌生结构,空心点为按 Hull 距离与元素数匹配后,灰 tick 为「熟悉化学体系中的新组分」。上:OMat 代;下:MP 代(注意横轴刻度不同)。
图源:arXiv:2610.30641,Fig. 7
分层的根因是训练数据而非架构:同一语料训出的模型犯的错误更相似(Spearman ρ 0.61 对 0.40)。反例最能说明问题——MP 代的 MACE-MPA 因训练中含 Alexandria 子集,在各项免参考指标上挤进 OMat 梯队;而 eqV2 与 eSEN 这对「同配方不同架构」的模型,在两个控制后能量差收敛到 0.6 meV/atom。在 OMat24 自己的留出集上测力,领先的也不是 eqV2,而是 UMA(0.055 eV/Å)。
图 6|完整排行榜:14 个模型 × 9 个指标(能量、单点、双控制、Hull-F1、Ehull MAE、多晶型排序 ρ、残余力、剪切模量、对称性保持率),每列独立按绿(优)到红(差)着色,每格附 95% 置信半宽。
图源:arXiv:2610.30641,Fig. 12
这项工作把「表观失败」分成五类——参考约定、参考库自身的错、两个 DFT 程序间不可约的分歧、基准分析自身的假象、以及真正的模型缺陷——并给出逐一排除的对照工具箱(论文 Table 5)。重参考后,最好的模型与 AFLOW 的一致程度已达到甚至略超两个独立 DFT 数据库之间的一致程度:继续在这个尺度上卷排名,测的只是谁更贴近 AFLOW 的计算设置,而非更好的势能面。
作者给下一代评测留下三个低成本习惯:至少用一个模型没训练过的 DFT 参考库;重参考前后的误差都要报,差值界定了约定不匹配能解释多少;与实测的 DFT-vs-DFT 底线同口径比较,免得把 7 meV/atom 的差距误读为实力。所有数据与代码已归档于 Zenodo,scripts/byom/ 可让任何带 ASE 接口的模型在相同协议下入榜重测。
论文信息
标题:How good are universal MLIPs for alloys? A benchmark is only as trustworthy as its controls
作者:Gus L. W. Hart(通讯作者)、Jacob N. Pursley
单位:杨百翰大学物理与天文学系;美国能源部堪萨斯城国家安全园区
预印本:arXiv:2610.30641v1 [cond-mat.mtrl-sci],2026 年 10 月 22 日
数据与代码:Zenodo,DOI: 10.5281/zenodo.21301563
原文链接:https://arxiv.org/abs/2610.30641
— 解读基于论文原文,细节与数据请以原文为准 —