深度实战 / 07
Python、Java、Go 怎么选?
别从语言排行榜开始,先看系统已经有什么、团队能维护什么,以及项目真正卡在哪里。
导读| 结合模型实验、企业业务集成和轻量网关三类场景,比较 Python、Java、Go 的常见取舍,给出决策矩阵与混合语言架构的成本边界。
开篇:一个真实开发现场
讨论后端语言时,很容易变成"Python 开发快""Java 适合企业""Go 性能好"的口号。这些判断都有适用范围,但不能代替项目决策。一个已有成熟 Java 平台的团队,未必应该为了 AI 重新造一套 Python 服务;一个需要快速验证 RAG 效果的团队,也没必要先把所有实验写成 Java。
01|先问项目要解决什么,而不是哪种语言最强
AI 应用后端通常包含几类工作:模型与数据实验、业务规则与系统集成、API 网关与网络服务、异步任务与运行治理。不同模块的主导约束不一样,因此语言选择应从实际工作负载、现有基础设施和团队能力出发。
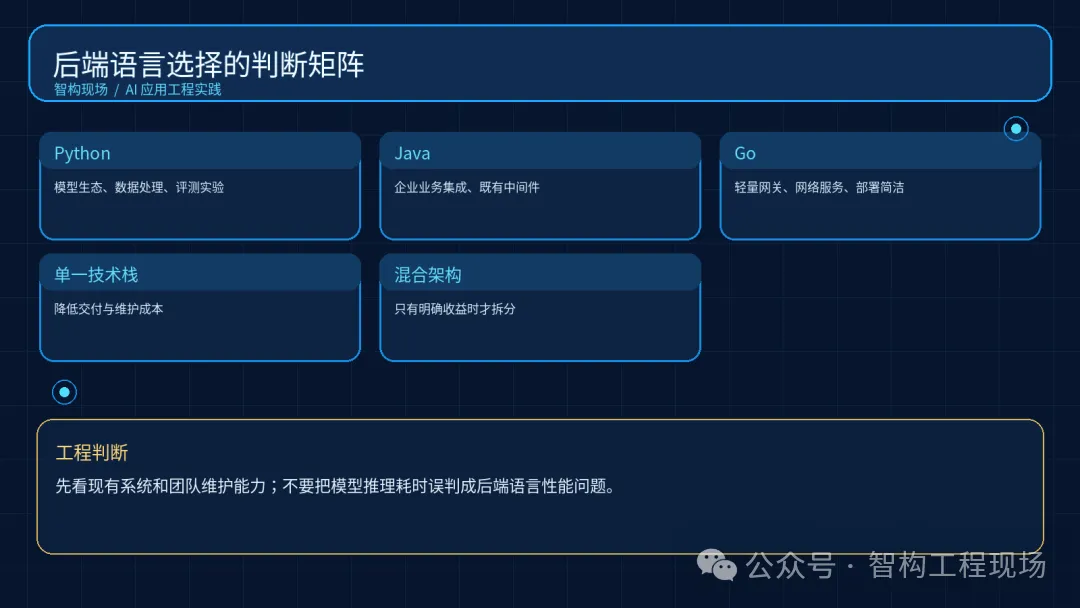
Python 的优势通常体现在模型生态、数据处理、评测工具和快速实验;Java 在已有企业系统、成熟中间件和复杂业务规则场景中容易复用现有资产;Go 常用于轻量网络服务、网关和部署简单的服务。这些是常见倾向,不是绝对边界。
三种语言都可以调用远程模型 API,也都能构建 HTTP 服务。不要把"模型在 Python 生态中"误解成"整个产品必须使用 Python",也不要因为 Go 并发模型简洁,就认为所有模型调用都需要用 Go 重写。
02|把选择写成一张可讨论的矩阵
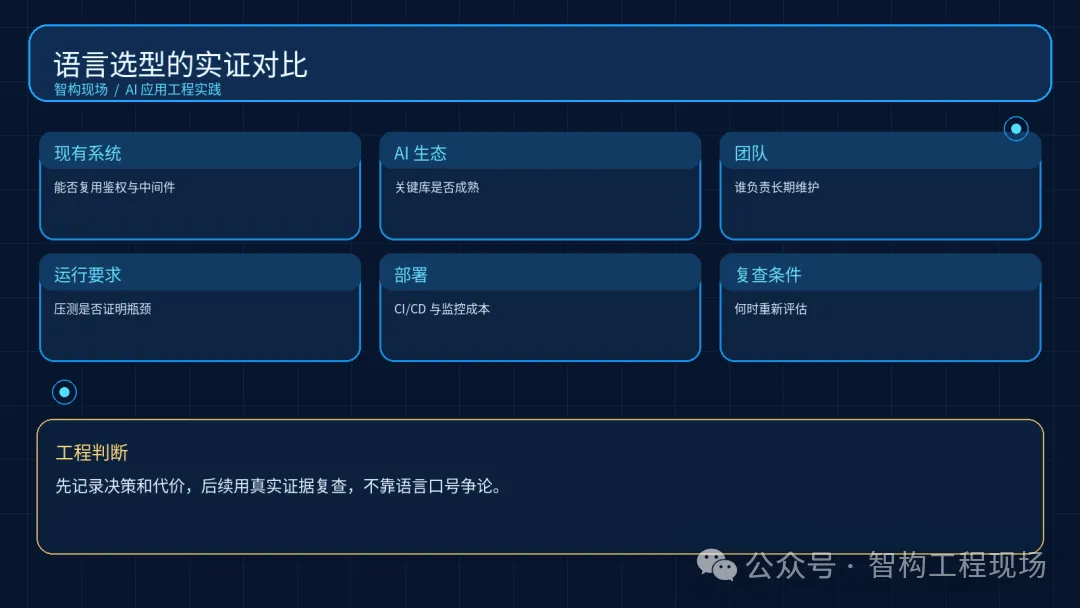
建议团队把评价维度写出来,而不是只投票。至少考虑:现有代码与中间件复用、目标 AI 库支持程度、团队熟悉度、流式协议支持、可观测性、部署方式、性能瓶颈和长期维护成本。
如果系统的大部分复杂度来自检索、模型评测和数据处理,Python 生态可能减少大量胶水工作;如果主要工作是把模型能力嵌进既有订单、权限和工作流系统,继续使用团队熟悉的 Java 可能更经济;如果主要是高并发网络转发和轻量路由,Go 值得作为候选。
语言不是性能结论的替代品。若延迟主要花在等待模型生成,换语言通常不会明显缩短模型推理时间。只有测量证明瓶颈在服务自身的 CPU、内存、调度或网络处理时,才值得考虑重写或拆分。
03|三个常见场景怎么选
场景 A:团队要在两周内验证一个知识库问答原型,需要解析 PDF、尝试不同 Embedding、评估召回和重排。优先考虑 Python,因为相关库和实验工具丰富,能更快完成对照实验。
场景 B:公司已有统一 Java 微服务体系,登录、租户、权限、审计和工单流程都在 Java 服务中。先评估在现有服务里增加模型适配层,或由 Java 调用一个独立模型编排服务。不要为了调用模型而复制整套身份与业务体系。
场景 C:团队要做一个轻量模型路由网关,负责鉴权、配额、请求转发、流式代理和指标采集。Go 可以作为候选,但最终仍要以现有团队经验、依赖生态和压测结果决定。
04|混合语言什么时候值得?
混合语言有价值的前提是模块边界清晰,而且某种语言能带来可测量的收益。例如 Java 负责企业业务和权限,Python 负责独立的检索与评测服务;或者 Go 网关负责流量控制,后端调用不同模型服务。
但每增加一种语言,就增加构建链、依赖管理、运行时、部署配置、告警、链路追踪和人员交接成本。跨语言调用还会引入网络失败、协议版本和序列化问题。因此,混合架构不是"更高级",而是一次需要成本核算的架构选择。
比较稳妥的做法是先在一个熟悉的技术栈里完成端到端闭环,再依据真实瓶颈拆分。不要因为预想未来会有百万并发,就在第一个版本引入多语言微服务。
05|把决策记录下来,避免以后重复争论
项目可以用一页 ADR(Architecture Decision Record)记录选型:背景是什么、备选方案有哪些、为什么选择当前方案、接受了哪些代价、什么证据会促使团队重新评估。这样技术决策可以被复盘,而不是依赖某个人记忆。
如果未来需要换语言,应明确触发条件,例如压测确认某个服务的 CPU 开销已成为主要瓶颈,或某个必需库无法在现有栈中稳定使用。没有可测量的收益时,优先优化架构边界、缓存、批处理和连接复用。
06|用同一组任务对比候选语言
如果团队对 Python、Java、Go 争论不下,可以先选 3 个代表性任务做小型验证:接入一个模型 API、完成一次业务鉴权与审计、跑一组接近真实负载的并发请求。记录实现时间、依赖复杂度、错误处理、流式支持、部署与排障体验,而不只比较一段空循环的基准测试。
对大多数应用来说,端到端延迟里模型推理和网络等待占比可能很高。若测试显示语言运行时并不是主要瓶颈,那么重写后端带来的收益可能远低于改善提示词、减少不必要的模型调用、优化检索和控制输出长度。
选型结论应保留"为什么"和"什么时候重新评估"。比如当前先用 Java 复用业务体系,但把模型访问封装为接口;当检索评测确实需要 Python 专属生态时,再考虑独立的 Python 服务,而不是把整个业务系统迁移过去。
图解|把关键判断落到检查项
轻量 ADR:把选型理由留在仓库里
# docs/adr/0001-backend-language.md## 背景当前项目需要提供模型 API、检索与业务系统集成。## 备选方案- Python:模型生态丰富,团队需要补齐服务工程规范- Java:复用现有业务平台与中间件- Go:适合轻量网络服务,但部分 AI 生态需要通过 API 集成## 决策先使用团队最熟悉、最容易完整交付的方案完成端到端闭环。## 接受的代价记录依赖、部署、性能与人员维护方面的权衡。## 重新评估条件当真实压测或依赖限制证明当前方案成为主要瓶颈时,再重新评估。
代码边界| ADR 不需要复杂模板,关键是记录背景、选项、决定、代价和复查条件。这样后续人员能理解当时的判断,而不只是看到一个语言选择。
排障速查表
现场提醒| 如果端到端耗时主要花在模型生成和网络等待,改后端语言通常不会带来明显收益;先把每一段耗时拆开测。
落地检查清单
结语
最合适的语言不是理论上最强的语言,而是能让团队以可接受的成本,把系统可靠交付并长期维护的语言。