一、先说答案,再将底层逻辑
注:遇到不了解的名词,可以先查阅文章第二段的术语解释表,想了解原理看文章第三段。
1、Embedding 的本质是一段文本在高维空间里的坐标
将文本切完之后,每块文本需要一个向量表示才能进向量库。把文本变成向量的这一步就是 Embedding,它决定了「哪一块会被检索到」。
一个 Embedding 模型接收一段文本(一句话、一个段落、一篇文章),输出一个固定维度的浮点数数组,常见 1024 维或 1536 维。这个数组就是这段文本在高维空间里的坐标,坐标相近 = 语义相近,坐标相远 = 语义相远。
RAG 系统里所有的「检索」都是在比坐标:把用户问题也变成一个坐标,去和库里所有块的坐标比距离,距离最近的那几块被召回来喂给大模型。所以 Embedding 的准确性直接决定了检索的准确性,是整个 RAG 的瓶颈源头之一。
2、比较两个向量用余弦相似度,不是欧氏距离
余弦相似度算的是两个向量夹角的余弦值,取值 [-1, 1],1 表示方向完全相同,0 表示正交无关,-1 表示方向相反。
它只看方向不看长度:一段 10 个 token 的短问题和一段 800 token 的长段落,只要语义讲的是同一件事,余弦值就接近 1。
换成欧氏距离,长度差异会让两段本来语义一致的文本距离被放大,这是 RAG 里最常见的误判来源。绝大多数向量库(Milvus、Qdrant、Weaviate、FAISS)默认用余弦或余弦等价的归一化内积。
3、模型选型的三代演进要讲清
(1)第一代静态词向量(word2vec、GloVe,2013 年前后):每个词只有一个向量,无法区分多义词,句子向量只能靠词向量平均拼凑,词序全丢。
(2)第二代上下文相关(BERT、RoBERTa,2018 年前后):同一个词在不同句子里得到不同向量,多义词解决了,但 BERT 本身不是为句子相似度设计的,直接拿句向量做比较效果不好;后来的 Sentence-BERT 做了改造但推理慢、维度固定。
(3)第三代句级对比学习(SimCSE、Sentence-T5、BGE、text-embedding-3,2021 年至今):用大量语义相近的文本对做对比学习,让相近文本的向量靠近、无关文本的向量远离,向量质量高、推理快、支持更长输入,是当前 RAG 系统的主力。OpenAI 的 text-embedding-3-small/large、智谱的 embedding-3、BAAI 的 BGE-M3,都属于这一代。
4、选型看四个维度,缺一不可
第一语言:模型训练数据要覆盖业务语言,纯中文业务选 BGE 这类中文优化过的模型通常比通用多语言模型效果好。
第二合规与部署方式:敏感数据必须支持私有部署,云 API 把文本发到第三方,合规上就过不了。
第三向量维度:维度越高表达越精细但存储与检索成本线性上升,1024 维通常是性价比甜点。
第四最大输入长度:必须和切块粒度对齐,模型上限 512 token 而切块设了 800,块会被截断丢内容。
5、评估用自有业务集的 Hit@K,不看公开排行榜
Hit@K 的意思是「前 K 条召回结果里是否包含正确的那一条」,取 5 或 10。准备 50~200 个业务问题,每个问题标注好对应的正确 chunk 是哪一条,跑一遍检索算命中率。经验阈值:Hit@5 达到 0.7 以上通常算生产可用,低于 0.7 说明检索质量不过关。
排查顺序是固定的:先看切块(是不是切断了关键信息),再调重叠,最后才考虑换模型。这个顺序反过来会浪费大量时间在模型上而问题其实在切块。
额外提一下:Hit@K和 MRR 的区别:Hit@K 只问“在不在前 K 里”,不问“排第几”。排第 1 和排第 5 对 Hit@5 贡献一样。MRR 会把排名折算成分数,排得越靠前分越高。
面试加分项:
- 能说清 Embedding 的「方向」到底指什么:方向 = 语义的压缩编码,不是某个维度对应某个概念,是整个向量联合起来代表这段文本的语义位置。
- 能说出为什么欧氏距离不适合 RAG:文本长度差异会误导距离,归一化之后两者等价,向量库默认用余弦或归一化内积。
- 能讲出三代的分水岭:word2vec 解决词表示,BERT 解决上下文相关,对比学习解决句级相似度训练——每一代解决的是上一代留下的具体问题。
- 能给出选型四维度并按业务场景排优先级:金融、医疗优先合规(私有部署),跨国业务优先语言(多语言模型),已有索引想压成本看维度(换低维或 Matryoshka 裁剪)。
- 能说出 Hit@K 的测法和排查顺序,并且明确点出「Hit@5 < 0.7 先看切块再看模型」,很多人答反。
避坑:
- 把 Embedding 讲成「理解语义」。模型不理解,它做的是把语义相近的文本映射到相近的坐标,训练目标是「拉近 / 推远」而不是「理解」。
- 只看排行榜选模型。业务词汇分布与公开语料差异大,必须跑在自有数据上。
- 把 Embedding 输入长度上限当切块上限。大多数模型上限 512 token,切块超过会被截断;切块超过 512 时必须换支持长上下文的模型(如 BGE-M3 的 8192)。
二、本篇核心术语表
| |
|---|
| 把文本映射成高维空间里一个固定维度的浮点数数组的过程 |
| Embedding 模型输出的浮点数数组,这段文本的语义坐标 |
| 向量的长度,常见 768、1024、1536、3072,维数越高表达越细但成本越高 |
| 两个向量夹角的余弦值,只看方向不看长度,RAG 比较向量的默认度量 |
| 2013 年 Google 提出的静态词向量,每个词只有一个向量,无法区分多义词 |
| 2018 年 Google 提出的双向编码器,同一词在不同上下文里得到不同向量 |
| 2021 年提出的无监督句向量训练方法,用对比学习得到高质量句向量 |
| BAAI 于 2023 年发布的中文优化 Embedding 模型,RAG 常用 |
| 2019 年对 BERT 的改造,用孪生网络输出句向量,第二代代表作 |
| 训练范式:拉近正例对、推远负例对,第三代 Embedding 的核心方法 |
| 让同一向量可裁剪到低维度使用,OpenAI 在 text-embedding-3 引入 |
| 前 K 条召回结果里是否包含正确答案的检索质量指标 |
| 模型读取与计数的最小单位,一个汉字约折 1~2 个 token |
三、精讲原理
将文本切完之后,每块文本需要一个向量表示才能进库。把文本变成向量的这一步就是 Embedding,它决定了「哪一块会被检索到」。前面做得再讲究,Embedding 算不准,检索照样跑偏。
1、Embedding 的本质:把文本放进语义坐标系
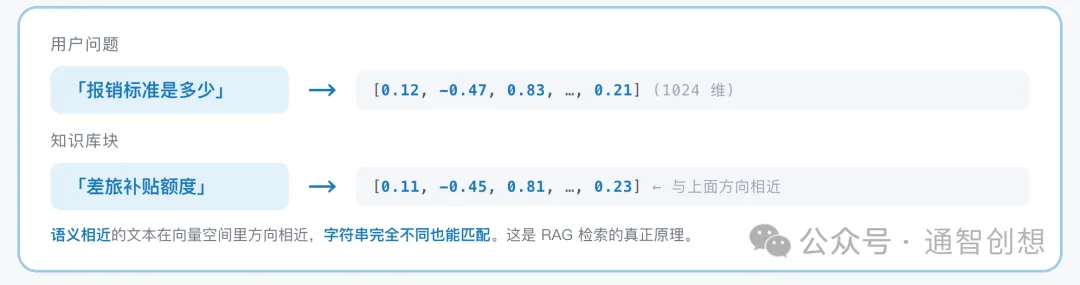
用户问「报销标准是多少」,系统召回来手册里的「差旅补贴额度」这一段。两者一个字都没重合,但 RAG 能找到,靠的就是 Embedding。
Embedding 模型做的事是把一段文本变成一个固定长度的浮点数数组。比如一段文本进去,出来 1024 个浮点数。这 1024 个数就是这段文本在 1024 维空间里的坐标。这个空间不是人定义的,是模型在训练时自己学出来的语义空间:语义相近的文本在空间里离得近,语义相远离得远。所以「报销标准是多少」和「差旅补贴额度」两个字符串看起来完全不同,但经过 Embedding 之后在向量空间里的位置很近,系统据此判断它们语义相近。
怎么做到的?训练目标就是「拉近相近、推远无关」。训练数据里,同一篇文档相邻两段、问答对的两个句子、平行语料的两种语言版本,都作为正例对;随机采样的无关文本对作为负例对。模型通过对比学习(contrastive learning)调整参数,让正例对的向量靠近、负例对的向量远离。训完之后,模型拿到一段从没见过的新文本,也能输出一个语义坐标。
关于向量维度要补一句。维度是向量数组的长度,常见 768、1024、1536、3072。维度越高理论上表达越精细,但存储和检索成本线性上升。OpenAI 的 text-embedding-3 系列引入了 Matryoshka 表示学习:同一个向量可以裁剪到低维度(比如 256、512)使用,裁剪后效果损失很小。这对已经建好的索引想换维度特别有用:不用重跑整库,直接裁就行。
2、为什么比较用余弦而不是欧氏距离
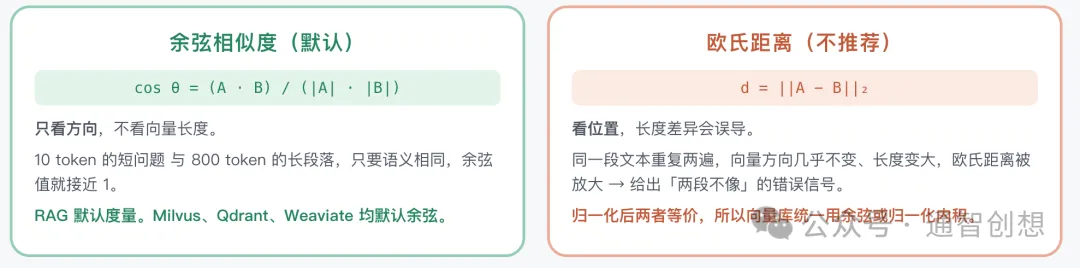
两个向量的相似度有多种度量方式,RAG 里基本只用余弦相似度。原因在于它只看方向不看长度。
余弦相似度算的是两个向量夹角的余弦值,取值 [-1, 1]。1 表示方向完全相同,0 表示正交无关,-1 表示方向相反。它只关心向量指向哪个方向,不关心向量有多长。一段 10 token 的短问题和一段 800 token 的长段落,只要语义讲的是同一件事,两个向量方向接近,余弦值就接近 1。
为什么方向代表语义、长度不代表?因为 Embedding 模型的训练目标是让相近文本的向量方向相近,长度不在训练信号里。同样一段文本,重复两遍拼成长段落,Embedding 后向量方向几乎不变,长度会变化。如果用欧氏距离来比,重复后的段落距离会被放大,给出「这两段不像」的错误信号。
归一化到单位长度之后,余弦相似度和欧氏距离其实是等价的(差一个单调映射)。所以有些向量库选余弦,有些选归一化后的内积(结果等价但计算更快),两者给出的排序一致。面试时被追问「你用什么距离」,答余弦或归一化内积都可以,关键是能说出为什么长度差异会误导欧氏距离。
用 numpy 写一段对照代码,归一化之后三种度量给出完全相同的排序:
import numpy as npdef cosine_sim(a, b): return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))def l2_distance(a, b): return np.linalg.norm(a - b)def inner_product(a, b): return np.dot(a, b)# 归一化之后:余弦 = 内积,欧氏距离 = 单调递减于内积a_norm = a / np.linalg.norm(a)b_norm = b / np.linalg.norm(b)# cosine_sim(a_norm, b_norm) == inner_product(a_norm, b_norm)# l2_distance(a_norm, b_norm) == sqrt(2 - 2 * inner_product(a_norm, b_norm))
3、三代演进:每一代解决上一代留下的具体问题
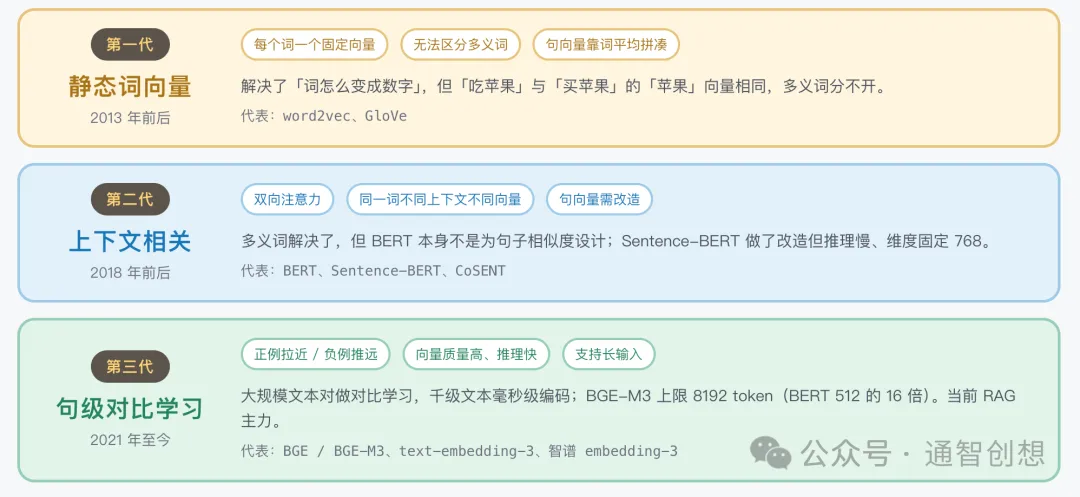
第一代静态词向量。2013 年前后 word2vec 和 GloVe 提出,核心思想是用上下文预测词(或反过来)。每个词得到一个固定向量,相近词的向量相近。这一代解决了「词怎么变成数字」的问题,但有两个硬伤:一个词只有一个向量,多义词分不开(「吃苹果」和「买苹果」里的「苹果」向量相同);句子向量只能靠词向量平均拼凑,词序与修饰关系全丢。它只能做简单的同义词搜索,处理不了「报销标准是多少」和「差旅补贴额度」这种词不重合但语义相近的问题。
第二代上下文相关。2018 年 BERT 提出,通过双向注意力让同一个词在不同句子里得到不同表示,多义词问题解决了。但 BERT 本身是为分类和 NER 这类任务训练的,不是为句子相似度设计,直接拿 [CLS] 向量比较效果不如第一代平均池化。后来的 Sentence-BERT(2019)用孪生网络对 BERT 做了改造,CoSENT(2022)进一步引入排序损失提升效果。但第二代普遍有两个问题:推理慢(每个 token 都要过完整 BERT),句子向量维度固定(768),大规模场景性价比不高。
第三代句级对比学习。2021 年之后 SimCSE、Sentence-T5、BGE、E5 陆续出现,把句子 Embedding 训练带进对比学习时代。做法是用大量文本对(正例拉近、负例推远)直接训练句级向量,向量质量高、推理快(千级文本毫秒级编码)、支持更长输入(BGE-M3 上限 8192 token,是 BERT 512 的 16 倍)。OpenAI 的 text-embedding-3 系列、智谱的 embedding-3 都遵循这一范式。这一代是当前 RAG 系统的主力,前两代基本只在老系统里见到。
三代的分水岭可以这样记:word2vec 解决「词怎么表示」,BERT 解决「上下文相关」,对比学习解决「句级相似度怎么高效训练」。每一代解决的是上一代留下的具体问题,不是简单的版本升级。
4、选型四维度:按业务场景排优先级
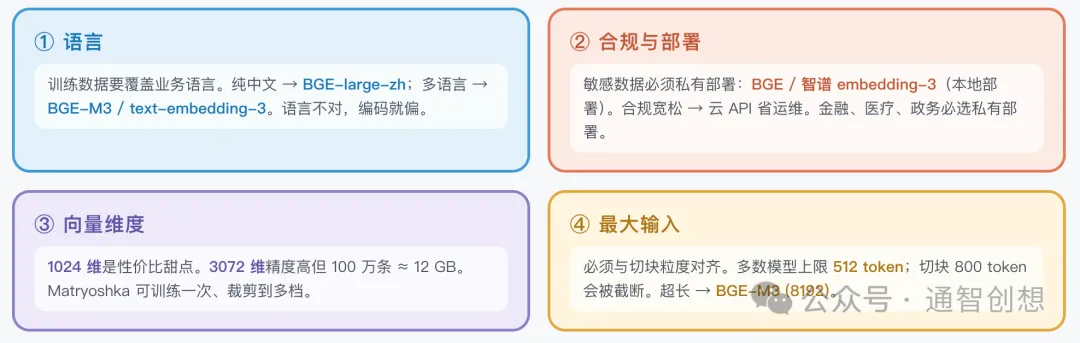
选型不能只看排行榜,要看四个维度。
第一维度是语言。模型的训练数据要覆盖业务语言。纯中文业务选 BGE 这类中文优化过的模型,效果通常比通用多语言模型好。业务同时涉及中英日等多语言,选 BGE-M3 或 OpenAI text-embedding-3 这种多语言模型。语言不对,模型在业务词汇上的语义编码就会偏。
第二维度是合规与部署方式。涉及用户隐私或受监管行业(金融、医疗、政务),必须支持私有部署,不能用走云 API 的方案——云 API 等于把每条文档发到第三方服务器。合规宽松的场景,云 API 能省掉运维与 GPU 成本。国产开源模型(BGE 系列、智谱 embedding-3)都支持私有部署,OpenAI text-embedding-3 只能走 API。
第三维度是向量维度。1024 维通常是性价比甜点:表达够用,存储与 ANN 检索成本可控。3072 维(text-embedding-3-large)适合高精度场景,但要算好库体积(100 万条 3072 维大约占 12 GB)。支持 Matryoshka 的模型可以训练一次、裁剪到多个维度,对「已有索引想换维度」特别友好。老系统从 1536 降到 1024 时,不用重跑整库,裁就行。
第四维度是最大输入长度。这个参数要和切块粒度对齐。大多数模型上限是 512 token,如果你的切块设在 800 token,超过的部分会被直接截断,Embedding 只看到前半段。这种情况要么把切块调小到 512 以内,要么换长上下文模型(BGE-M3 的 8192、text-embedding-3 的 8191)。截断是无感的,模型不会报错,这是最容易被忽略的坑。
5、评估用 Hit@K,并且必须跑在自有业务集上
公开排行榜(MTEB)是模型在公开数据集上的平均表现,业务词汇分布和公开语料差异很大,排行榜第一在业务上未必能用。评估必须用自有业务集。
做法:准备 50~200 个业务问题(不要自己编:优先从真实日志里抽——线上用户问过的、客服转过来的、工单里出现过的),每个问题人工去库里找哪些 chunk 能支撑正确答案,把这些 chunk 的 ID 记下来。注意两点:一个问题可能对应多个正确 chunk(答案分散在几段里),标注要标全;标注时不要看检索结果,否则会不自觉地“认可”检索返回的东西,等于自己给自己放水。
给测试集里的每个问题,跑一遍检索,看检索返回的前 K 条()里有没有正确的 chunk。有就算命中,没有就算未命中。命中率 = 命中问题数 ÷ 总问题数。
K 通常取 5 或 10。 到底是取 5 还是 10, 看下游。下游 Rerank 或 LLM 上下文能容纳 10 条,就看 Hit@10;只能容纳 5 条,就看 Hit@5。K 越大命中率天然越高,所以不同 K 的分数不能直接比。
举个例子:测试集 100 个问题,K 取 5,跑完之后有 76 个问题的 top5 里包含了标注的正确 chunk,那 Hit@5 = 0.76。
经验阈值:Hit@5 达到 0.7 以上通常算生产可用,低于 0.7 要排查。排查顺序是固定的——先看切块:块切太大语义稀释、切太小缺主语,都会让 Embedding 算不准;再看重叠:重叠不足导致边界信息反复被切断;最后才考虑换模型。这个顺序反过来会浪费大量时间在模型上而问题其实在切块。
上线之后还要持续监测。每周跑一次测试集看命中率有没有掉,掉了要复盘最近新增的文档是不是引入了新术语、Embedding 模型是不是该微调或者升级。业务词汇随时间演化,半年前表现最好的模型未必现在还最好。
6、几个常见误解需要澄清
第一个误解:把 Embedding 讲成「理解语义」。模型不理解,它做的事是把语义相近的文本映射到相近的坐标。训练目标是「拉近 / 推远」,不是「读懂」。这个区别在面试时被追问会暴露背概念。
第二个误解:检索 RAG 用 BERT。BERT 属于第二代,它本身不是为句子相似度设计的,拿它的句向量做检索效果不如专用的第三代模型,推理还慢。当前 RAG 召回的主力是 BGE、text-embedding-3 这一代。
第三个误解:Embedding 维度越高越好。维度高了存储和 ANN 索引的成本线性上升,而业务上 1024 维和 3072 维在 Hit@K 上往往只差几个点。除非业务对召回精度要求极严(法律条款、医疗规范),否则 1024 维足够。
第四个误解:公开排行榜第一就是最好的。业务词汇和公开语料差异大,必须在自有数据上跑一遍 Hit@K 才算数。
最后一个边界:Embedding 只管召回,召回之后还要 Rerank 精排(第 11 篇),最后才进 Prompt。召回漏了 Rerank 救不回来,所以 Embedding 这一关不能糊弄;但召回够了不代表最终回答就对,中间还有 Rerank、Prompt 组装、模型生成多个环节。
如果这篇让你能讲清「余弦为什么只看方向」「选型看哪四个维度」,点个赞与「在看」,让这个系列被更多准备面试的朋友看到。