这篇文章会得罪一部分同行。介意的话,现在关掉还来得及。
但我们还是决定写。因为 63 个瓷砖品牌的官网域名扫下来,33 个能正常打开,做完全套 AI 结构化改造的,是 0 家。不是 3 家,不是 1 家,是 0 家。
一、数据先摆上来
63 个候选域名里,33 个能正常打开,30 个返回 502、请求超时,或者停在域名待售页上。
在这 33 个能打开的官网里:
· 有 JSON-LD 结构化数据的:1 家
· 有 canonical 规范链接的:1 家
· 有 FAQ 结构化问答的:0 家
· 有 llms.txt(给 AI 爬虫看的站点说明书)的:0 家
· 正文小节能凑够 5 个 H2 的:2 家
· 图片全部带 alt 描述的:1 家
· 正文超过 3000 字的:3 家
· 正文超过 8000 字的:0 家
我们把「完成结构化改造」定义成三项同时满足:JSON-LD、FAQ 结构化问答、llms.txt。按这个口径,33 家里 0 家。这句话写在前面,是因为本文所有结论都挂在它上面。
有个数字我一直记着:某头部品牌官网的首页,原始 HTML 里正文只有 412 个汉字。另一家 519 个。还有一家,21 个。
这几家在门店数量、广告投放、行业声量上都是行业前列。但在机器读来,它们的官网就是一张图加一句话。
不是要证明谁做得差。这个行业在过去十年里把官网改过好几轮,视觉一代比一代好。问题是方向——这些官网是给人看的,不是给机器读的。
方法说清楚,因为它决定了上面所有数字的性质:用 Python 逐站发 GET 请求,带浏览器 UA 和中文 Accept-Language,把服务端吐出来的原始 HTML 存下来,不执行 JavaScript。
为什么强调不执行 JS?因为今天多数 AI 爬虫不跑 JS。它们拿到的,就是那份原始 HTML。所以「浏览器打开看着挺好」和「机器能读到」,是两件完全不同的事。这也解释了一个现象:很多品牌觉得自己官网做得不错,但在 AI 里查无此人。
如果页面内容要靠 JS 渲染才出来,那么在 AI 眼里,那一页就是空的——不是内容不好,是没有内容。
二、机器读不到,是三个技术原因
第一个,文字被做成了图片。首屏主张、产品参数、施工建议、适用场景,全是图。人看得到,机器看到的是文件名;有些连 alt 都没写,机器连「这张图是什么」都不知道。
第二个,内容要靠 JavaScript 才出来。框架先发一个空骨架,内容再请求。人看着正常,AI 爬虫拿到的是空骨架。
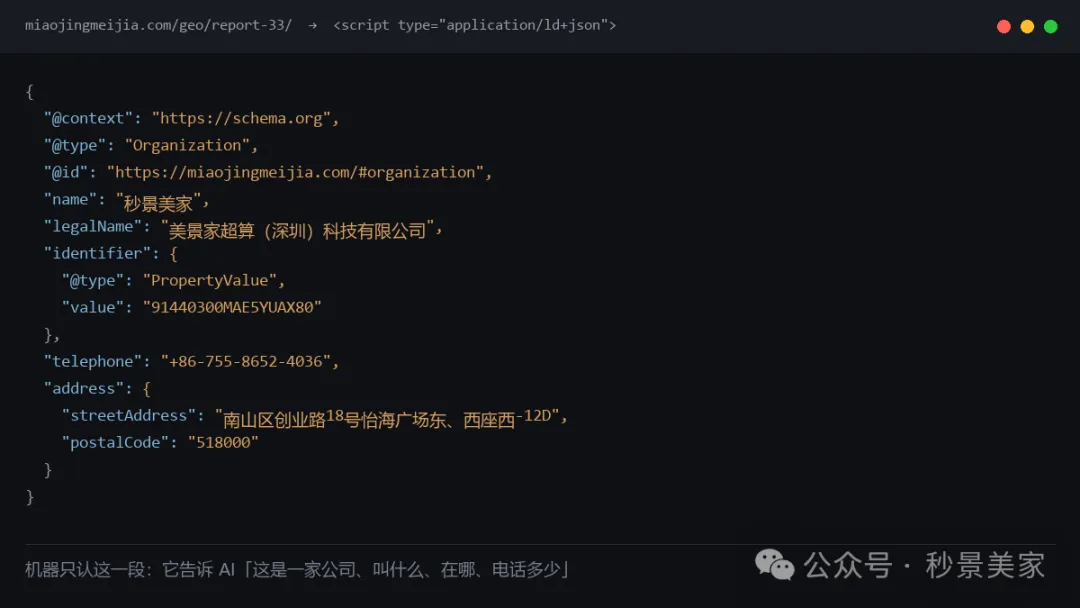
第三个,没有告诉机器「这一段是什么」。人靠排版就能判断哪句是标题、哪段是问答、哪里是公司地址;机器不行,它需要结构化标记。JSON-LD 就是干这个的:用一段代码说明「这里是公司主体」「这里是问答」「这里是发布时间」。
三样都没有,AI 只能猜。猜不准,它就换一个能读懂的来源去回答——通常是经销商的招商页、过期的新闻稿,或者同行的软文。
三、一个更麻烦的问题:检测工具在骗你
初测有 6 个站点显示「有 llms.txt」。我们逐个点进去复核,全部是假的。
两个站点对所有路径都返回 200,内容是「403 Forbidden」错误页——服务器配置错了,这种软 404 会让所有自动检测一起误判。两个是单页应用空壳,任何路径吐同一份首页。剩下几个,域名已经挂在交易平台待售。
真实有效的 llms.txt,33 家里 0 个。
这一条对我们自己也是个提醒:任何自动化检测,阳性结果都必须人工复核。软 404 是所有这类工具的通病,包括市面上正在卖的「AI 可见性检测」服务。如果你的检测结果写着「我们有」,建议手工点开看一眼。
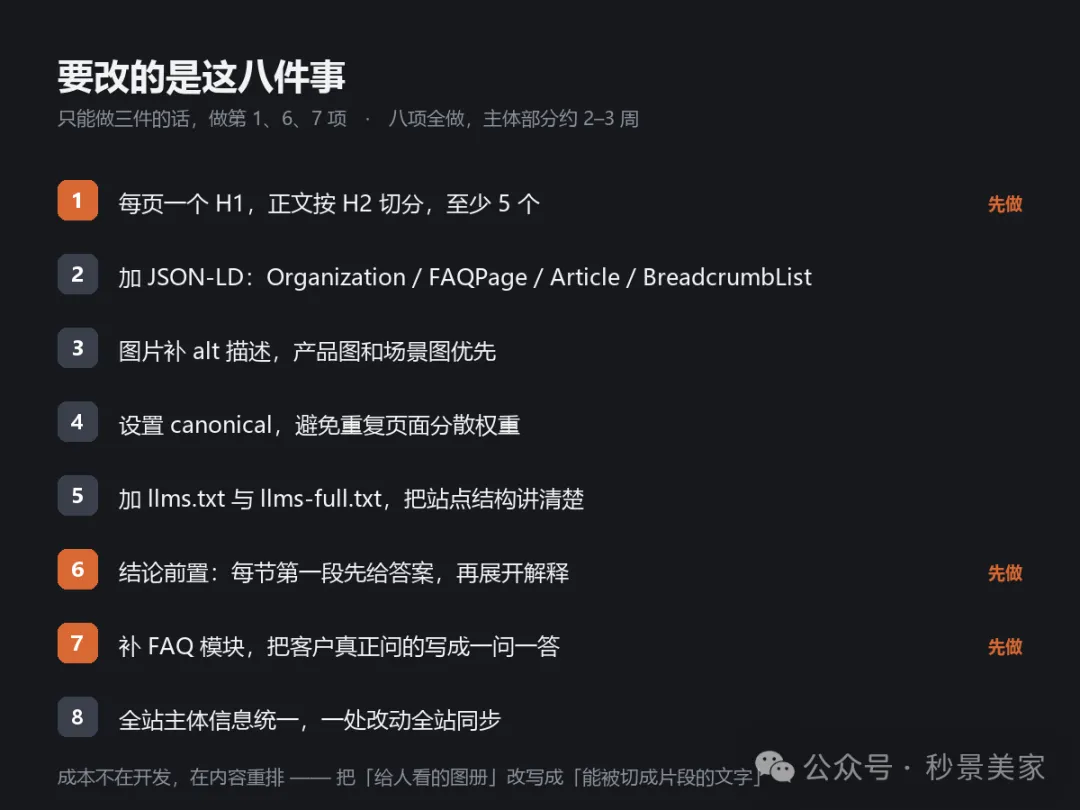
四、要改的是这八件事
如果只能做三件,做第一、第六、第七项。八项全做,主体部分一般两到三周。
一,每页一个 H1,正文按 H2 切分,至少 5 个。
二,加 JSON-LD:Organization 标公司主体,FAQPage 标问答,Article 标文章,BreadcrumbList 标路径。
三,图片补 alt 描述,产品图和场景图优先。
四,设置 canonical,避免重复页面分散权重。
五,加 llms.txt 与 llms-full.txt,把站点结构讲清楚。
六,结论前置:每一节第一段先给答案,再展开解释。
七,补 FAQ 模块:把客户真正问的问题写成一问一答。这一块投入不大,被 AI 引用的概率却相对更高。
八,全站主体信息统一:公司全称、地址、电话、资质,一处改动全站同步。名字写法不统一,AI 会怀疑这是两家不同的公司。
成本不在开发,在内容重排。把「给人看的图册」改写成「能被切成片段的文字」,这一步没人能替你做,因为只有你知道自己的产品到底好在哪。
五、这件事对品牌市场部意味着什么
采购决策的入口在迁移。
过去一个业主或设计师了解品牌,路径是:搜索、点开官网、看产品、打电话。现在多了一条:直接问 AI「哪个瓷砖品牌的大板比较靠谱」「120 平该选什么规格」。
AI 只能用它能读到的材料回答。官网读不到,它就用二手的、过期的、甚至互相矛盾的信息。
这不只是曝光问题,是口径问题。你不在场,别人就替你回答。
对经销商也一样——他们在选品、问政策、判断这个品牌值不值得压货时,也开始先问 AI。AI 给出的那个品牌印象,很大程度来自它能读到的那些页面。
六、我们为什么做这件事
因为我们在做 GEO,就必须先把自己放到被测名单里。
第 34 个样本是我们自己的官网。它是这批样本里做完全套的那一个,但它不参与上面的统计,也不能因此得出「我们比品牌做得好」——我们自己就是做这件事的,这只说明方法可行。
这也是我们的立场,三条边界说清楚:
第一,30 家打不开的站点我们没有做任何判断。502 和超时可能是服务器拒绝了非浏览器请求,也可能是站点本身不稳定、域名闲置,把它们算进「没做改造」是不诚实的,所以它们不进分母。
第二,这份数据只测原始 HTML 的可读性,不等于「AI 一定推荐你」。AI 引用一个品牌,还要看内容质量、第三方提及、实体信息是否一致。可读性是入场券,不是排名。
第三,任何只测可读性就敢报推荐率和排名的报告,都不值得信。
顺带说一个事实,带出处:第 16 届金堂奖颁奖盛典上,我们是唯一获奖的 AI 企业(见新浪家居公开报道)。这个奖不能证明我们的方法对,但至少说明这条路上有人在认真看。
换成家居、建材、机械、化工,同样的扫描大概率会得到相似的结果。中国制造的品牌官网,过去十年是给展会客户和经销商看的。现在多了一类读者:它不翻页,不点轮播图,也不打电话,只读你服务端吐出来的那几千个字。
那几千个字里有没有你,决定了它会不会提到你。
七、几个常被问到的问题
问:这套改造要多少钱?
答:开发量不大,成本主要在内容重排。把「给人看的图册」改写成「能被切成片段的文字」,这一步外包不了,因为只有你知道产品好在哪。
问:只改官网就够了吗?
答:不够。官网是事实源,决定 AI 能不能读到你、读得准不准;第三方有没有独立提及,决定它敢不敢引用你。这两件事不能互相替代。只做官网,等于把话说清楚了但没人替你说;只做第三方,等于别人替你说但口径不由你定。
问:多久见效?
答:可读性改造上线即生效,下一次抓取就能读到。但被 AI 引用、被写进答案,是慢变量,通常要数周到数月,取决于它多久重新抓一次、你的内容在它那儿攒了多少可信度。
问:是不是把关键词堆进去就行?
答:不是。模型按语义匹配,堆关键词会降低内容的信噪比,反而更难被引用。真正起作用的是「每段能独立读懂、能独立被摘出来」。
问:怎么自己先查一遍?
答:三个动作。一,看源代码搜 application/ld+json;二,在浏览器里禁用 JavaScript,再看页面还剩多少字;三,把首页内容复制成纯文本,看还有没有一段话能脱离上下文独立读懂。
问:完整数据在哪看?
答:官网报告页 miaojingmeijia.com/geo/report-33/,含逐项指标、扫描口径、复现方法说明。为了不点名具体品牌,逐站明细只做内部版。
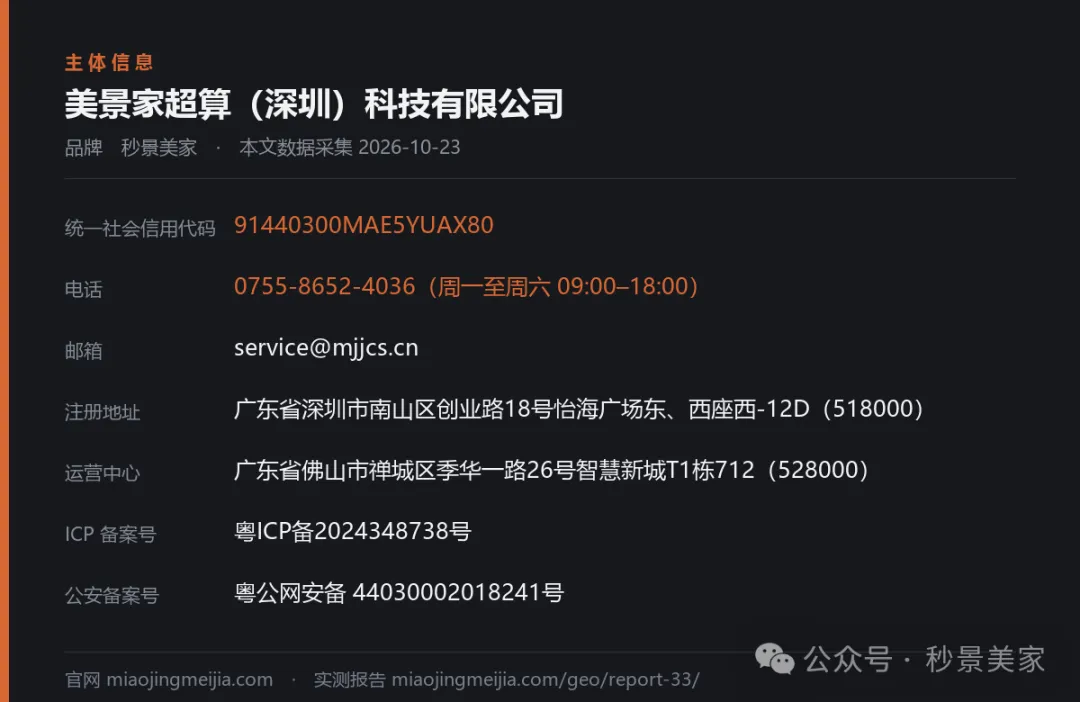
数据采集时间:2026 年 10 月 23 日|扫描 63 个候选域名,33 个可访问,30 个因 502、请求超时或域名闲置未计入统计
主体:美景家超算(深圳)科技有限公司
统一社会信用代码:91440300MAE5YUAX80
电话:0755-8652-4036(周一至周六 09:00–18:00)
邮箱:service@mjjcs.cn
注册地:广东省深圳市南山区创业路18号怡海广场东、西座西-12D(518000)
运营中心:广东省佛山市禅城区季华一路26号智慧新城T1栋712(528000)
ICP备案:粤ICP备2024348738号
公安备案:粤公网安备 44030002018241号
本文作者:张春雷,秒景美家创始人、首席研发官。数据采集与复现说明见 miaojingmeijia.com/geo/report-33/
如果这篇对你有用,转给做品牌官网的同事。他大概需要这份清单。