评测工程LLM裁判占6成,成本如何降
- 更新时间 2026-11-02 02:26:49
评测工程LLM裁判占6成,成本如何降
有个团队做 agent 评测,一个月云账单出来,评委模型(LLM 裁判)的调用费占了评测总成本的六成还多。他们本来以为贵在算力,一拆才发现,是每次跑评测都让裁判把几千条样本逐条重新打分,缓存一点没用,模型还挑了最贵的那个。 根因裁判是把双刃剑,给结论的同时也吞预算,工程化里它是最该被管的一道。 LLM 裁判解决了谁能判开放性答案对错的难题,但它不是免费的。每一次打分都是一次模型调用,样本量一大,成本线性起飞,而且不同裁判模型给的分还不一定一致,今天 GPT 判过明天 Claude 判可能结论不同。所以工程化裁判,要同时管两件事:降本、保一致性。 别把降本和一致性混为一谈,它们手段不同。
降本第一招缓存,最容易被忽视,却是见效最快的,重跑多的场景缓存能砍掉一大半调用,但冷启动还是贵,别指望它解决首次成本。降本第二招小模型替岗,是和一致性直接打架的:小模型便宜但判准降,适合做粗筛门槛,把明显对的明显错的先分出来,难的再交大模型,这叫分层裁判,比全用小模型稳。降本第三招批量打分,是工程实现问题,调用次数少了成本就低,但要处理失败重试。 一致性两招里,版本锁最稳但最死,锁了就享受不到新模型红利;多裁判投票最准但最贵,只在关键结论上用,别全量铺。这两招一个保稳一个保准,按场景选,不是都上。 对照最清楚:缓存和批量是「少调用」,小模型是「调用便宜」,这是降本的三条路;版本锁和投票是「结果可信」,这是一致性的两条路。方向不同,别混着讲。 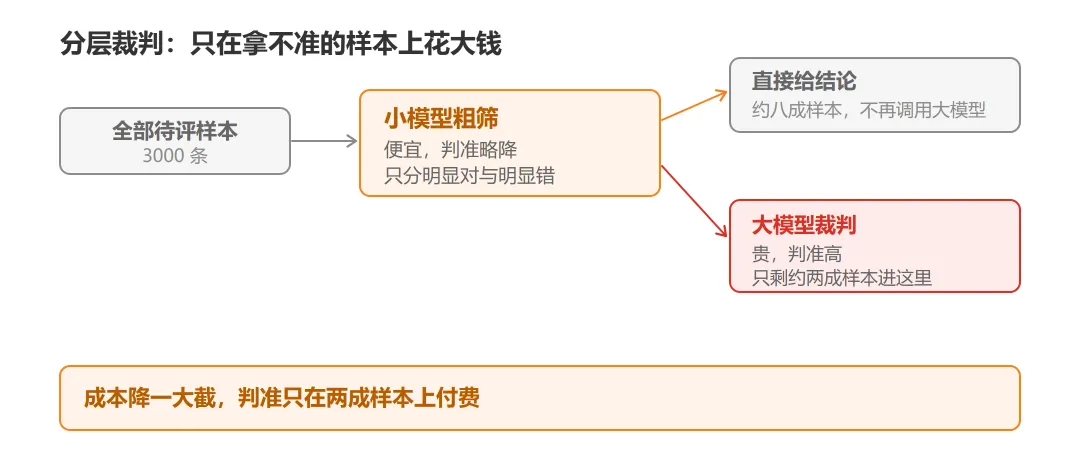
缓存是降本第一招,也是最容易省错的地方。键少放一个字段,省下来的调用费会以错分的代价还回去,而且错得很安静:分数看着照常,只是判的不是这一次的结果。 缓存键至少要含五项,缺哪项都会在某个具体场景里翻车:
五项里最容易漏的是 rubric 版本和前两项 hash,因为它们不像「模型名」那么显眼。可 rubric 一改,同一份答案的对错标准就换了,缓存还留着旧判定,等于用去年的考卷批今年的作文。 还有一条常被忽略:缓存只对确定性打分有效。裁判带推理链、温度不为 0 时,同一输入本来就可能给不同分,缓存等于把第一次的随机结果钉死,反而掩盖了不一致。这类场景要么先把裁判参数固定再缓存,要么干脆不缓存,改用小模型分层承接。 价格这块,三步能算清自己那笔账,别停在感觉贵: 第一步算单条 token。裁判输入是被评样本加 rubric 再加评分要求,通常 1500 到 3000 token;输出是分数加简短理由,200 到 500 token。 第二步乘当期单价。按每百万 token 计,中端模型的输入价是几十元量级,输出价通常是输入的数倍,旗舰型号再高一个量级。单价随厂商和档位变动频繁,按当期公开定价取,别用记忆里的数。 第三步乘条数与频率,条数乘每轮轮次再乘月内轮次。 按一组示意的量级:3000 条样本,单条约 2500 token 输入加 300 token 输出,中端裁判按输入每百万 20 元、输出每百万 80 元估,一轮约 220 元。一周跑 10 轮,月账单近万元。缓存命中七成,账单降到三千元量级,这个收益比换小模型更确定,因为它不改判准。 算这笔账最大的用处,在于它能告诉你降本该从哪招起,省下的钱只是顺带。调用量里重复多,先修缓存键;样本本身不重复,钱只能靠分层和少跑,那就回跑集分层那一层去谈,在裁判这层硬抠只会抠坏判准。 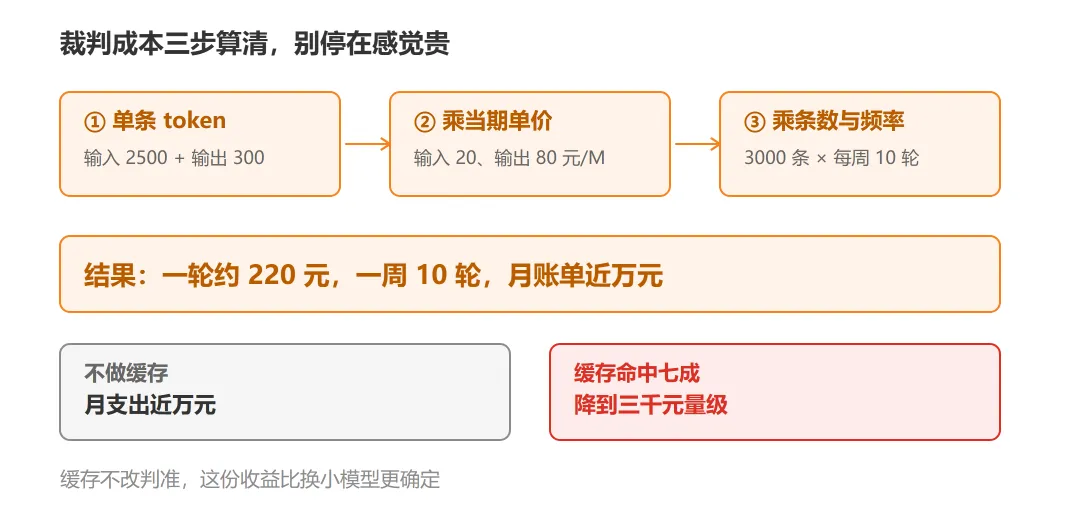
常见错误是一上来就用多裁判投票,成本直接翻倍还解决不了首因(连缓存都没加)。阶段一缓存先上,投入最小回报最大。 先按五项字段把缓存键补齐,再上小模型分层,锁裁判版本,关键结论才上投票。 裁判的准确性,前面已经拆过:位置偏见、自己评自己偏高、长文被截断,解法是换位、交叉、分段。这一关算过了,分数可信。接下来是没人愿意碰的那半问:可信之后还贵不贵、稳不稳。贵到只能一周跑一次,等于退回人工抽检的频率;同一份答案今天判 0.8、明天判 0.6,这条指标本身也就废了。 与既有四件套(评测集、评分卡、裁判、难负)亦可衔接。这一篇专管四件套里的「裁判」:评测集提供被裁判的样本,评分卡的维度是裁判的打分口径,难负集是检验裁判靠不靠谱的试金石。字段映射关系汇总如下表。
核心评测接裁判缓存,并跑一次小模型分层对照。裁判调用量降大于等于 40%;裁判模型版本锁定率 100%;关键结论投票覆盖率按需。 小模型分层会引入判准偏差,本文未给统一分层阈值,需按业务错误代价折算。缓存命中率与键设计强相关,七成是示意值,实际需按自己链路的重复度实测。 裁判是前面所有开放性评测的判官,降本保一致是工程化落地的成本闸门。你那套 LLM 裁判,现在是省着用、结果可信,还是敞开口烧钱还时灵时不灵?
一、裁判是把双刃剑
二、降本三招,一致性两招
三、缓存键少放一个字段,省下的钱会以错分还回去
四、成熟度自查
五、分步落地,兼容现有体系
本文建议
一句话收尾
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
