IPTW 第二节:权重方法怎么选?
- 更新时间 2026-11-02 02:00:05
真正开始分析时,研究者很快会遇到下一个问题:权重该怎么估计?是用最熟悉的 Logistic 回归,还是改用机器学习?如果普通模型平衡不好,是否应该直接寻找能平衡协变量的权重?
Noah Greifer 在Weighting Methods一章中把方法归纳为三大类:参数模型、机器学习模型和优化平衡方法。本篇沿着原文的逻辑,先明确权重分析要解决什么,再用lalonde数据演示常用方法及其比较方式。
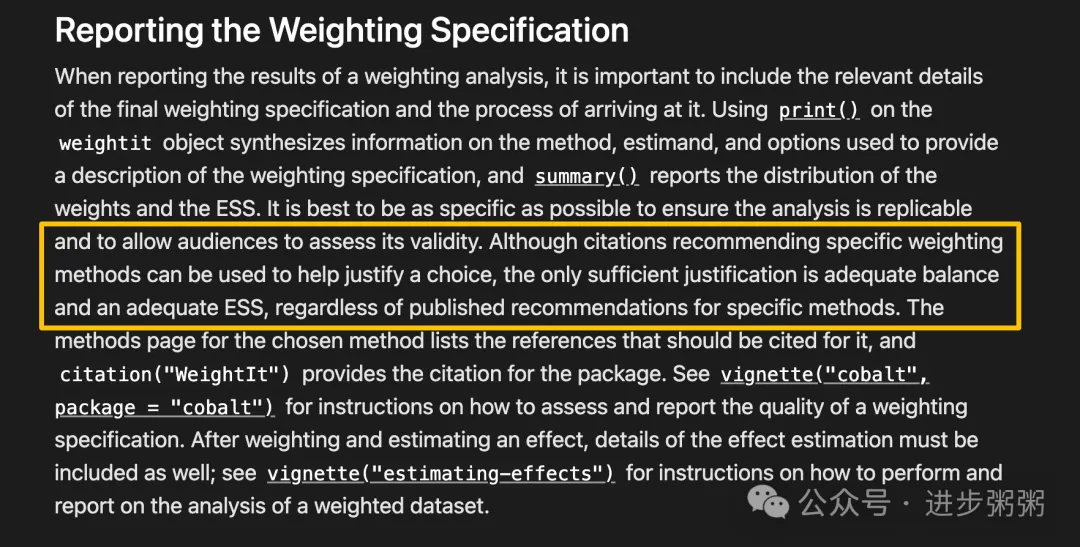
记住结论:没有脱离具体数据的“最佳权重方法”。方法是否合适,最终要看加权后协变量平衡是否充分,以及有效样本量(ESS)是否还能接受。
一、权重分析不是比谁的模型更会预测治疗
权重分析的目标,是让加权后的治疗组和对照组在治疗前混杂因素上尽可能可比。二分类治疗下,倾向评分为:
e(X) = P(A = 1 | X)其中,A是治疗,X是治疗前协变量。以 ATE 为例,接受治疗者的权重是1/e(X),未接受治疗者的权重是1/[1-e(X)]。倾向评分模型只是估计权重的一种途径;模型的预测能力好,不代表加权后一定平衡。
因此,不应把 AUC、准确率或显著性当作权重模型的主要筛选标准。更直接的证据是:权重是否实现了需要的协变量平衡?为此付出的精度代价有多大?
权重通常在不查看结局的前提下估计和筛选,这样可以把“设计阶段”的协变量平衡与“分析阶段”的结局效应估计尽量分开,减少根据结局结果反复挑选模型的风险。
二、平衡性与有效样本量
1. 协变量平衡
平衡描述的是加权后治疗组与对照组的协变量分布接近。二分类治疗常用的诊断包括:
标准化均数差(SMD):比较协变量均值或比例差异;绝对 SMD 小于 0.1 或 0.05 常作为经验参考,但不是适用于所有问题的硬性定律。 方差比:检查连续协变量的离散程度是否相近。 Kolmogorov–Smirnov(KS)统计量:比较连续变量的整体分布,而不只比较均值。
只看均值可能不够:两组均值一样,方差、偏态、尾部或协变量之间的联合分布仍可能不同。必要时还要检查重要连续变量的非线性项、交互项和分布图。
2. 有效样本量(ESS)
权重差异很大时,少数个体可能主导加权结果。ESS 用“相当于多少个等权个体”的方式概括这种精度损失:
ESS = (Σwᵢ)² / Σwᵢ²当权重相等时,ESS 接近实际样本量;当少数人权重特别大时,ESS 会明显下降。因而权重方法的目标不是机械追求“平衡越精确越好”,而是在平衡充分的前提下尽量保留有效样本量。
三、估计量与目标人群
权重方法不只改变个体的权重,也决定结果要推广到哪个目标人群。对二分类治疗,常见估计量(estimand)有:
ATE 权重试图代表完整样本;当某些患者几乎不可能接受另一种治疗时,ATE 权重可能很大。的 estimand 参数设定,默认值为 "ATE"
ATO 则把重点放在两组治疗机会较接近的人群,通常能避免在缺乏重叠的区域进行过度外推。
对于二分类治疗,权重公式为:
分母为个体接受其实际所接受处理的概率。倾斜函数决定了目标人群。例如。不妨带入A=1或A=0看看,就理解了
中可用的估计量及其倾斜函数总结如下:
:::
estimand | |||||
|---|---|---|---|---|---|
"ATE" | |||||
"ATT" | |||||
"ATC" | |||||
"ATO" | |||||
"ATM" | |||||
"ATOS" | |||||
注:若估计为ATO时,现在称为重叠加权估计
五、第一类:参数模型
1. 广义线性模型(GLM)
最常见的起点是 Logistic 回归。模型假设协变量与治疗 log-odds 的关系由所指定的线性项表达;如果重要关系存在非线性或交互而模型没有纳入,估出的倾向评分可能无法充分平衡协变量。
#安装必要包#install.packages(c("MatchIt", "WeightIt", "cobalt"))library(MatchIt)library(WeightIt)library(cobalt)data("lalonde", package = "MatchIt")head(lalonde)# treat = 1:接受培训;treat = 0:未接受培训# re78 是结局,不放入治疗分配/权重模型covariates <- treat ~ age + educ + race + married + nodegree + re74 + re75#变量含义简要说明:`age` 为年龄,`educ` 为受教育年限,`race` 为种族类别,`married` 为婚姻状态,`nodegree` 为是否没有高中学历,`re74` 和 `re75` 分别为 1974、1975 年收入。它们用于描述治疗前特征;`re78` 是治疗后结局,不能作为倾向评分模型中的混杂因素。W_glm_ate <- weightit( covariates, data = lalonde, method = "glm", estimand = "ATE")summary(W_glm_ate)bal.tab(W_glm_ate, un = TRUE, stats = c("m", "v", "ks"))summary()用于查看权重分布和 ESS;bal.tab()比较加权前后的协变量平衡。GLM 快、透明、适合作为基准,但“模型收敛”不等于“协变量已平衡”。
如果担心线性形式不够,可在事先有临床依据时加入合理的非线性项或交互项,例如:
W_glm_flex <- weightit( treat ~ age + I(age^2) + educ + race + married + nodegree + re74 + re75 + age:educ, data = lalonde, method = "glm", estimand = "ATE")不建议无目的地塞入大量项,再以结局显著性决定保留哪些变量。应回到平衡诊断,并考虑样本量和重叠情况。
2. 协变量平衡倾向评分(CBPS)
CBPS 将倾向评分估计与协变量平衡结合起来。它仍属于参数模型思路,但估计过程不只追求拟合治疗分配,也利用平衡条件来约束模型。
W_cbps <- weightit( covariates, data = lalonde, method = "cbps", estimand = "ATE")summary(W_cbps)bal.tab(W_cbps, un = TRUE, stats = c("m", "v", "ks"))CBPS 可以作为 Logistic 回归的一个候选,尤其当普通模型的均值平衡不够理想时。但平衡目标是针对模型中指定的协变量项;若还关心方差、非线性或交互,需要明确加入并检查。
3. 逆概率倾斜(IPT)
逆概率倾斜通过改变参数模型的估计方式来实现指定协变量均值的平衡。WeightIt中可用method = "ipt":
install.packages("rootSolve")W_ipt_att <- weightit( covariates, data = lalonde, method = "ipt", estimand = "ATT")summary(W_ipt_att)bal.tab(W_ipt_att, un = TRUE, stats = c("m", "v", "ks"))这里选 ATT 是为了演示“目标人群由研究问题决定”,并非因为 ATT 必然优于 ATE。IPT 可用于多个经典 estimand,并以所指定的均值平衡为重点;具体可用范围及算法限制应以所用WeightIt版本的帮助文档为准。
六、第二类:机器学习倾向评分
当协变量较多,或治疗分配可能包含较难预先指定的非线性和交互时,可以考虑更灵活的模型。但机器学习的预测灵活性并不保证权重平衡;仍需以平衡和 ESS 评估结果。
1. 广义提升模型(GBM)
GBM 通过许多弱学习器组合拟合复杂关系。WeightIt可用method = "gbm",并可通过criterion指定基于平衡的调参目标:
install.packages("gbm")set.seed(2026)W_gbm <- weightit( covariates, data = lalonde, method = "gbm", estimand = "ATE", criterion = "smd.mean")summary(W_gbm)bal.tab(W_gbm, un = TRUE, stats = c("m", "v", "ks"))GBM 有机会捕捉非线性和交互,但耗时较长,需要调参,也可能得到极端权重。不同软件版本的可用参数和默认设置可能变化,正式分析应查看?method_gbm并报告实际设定。
2. SuperLearner
SuperLearner 将多个候选模型的预测组合起来,适合在有充分样本量且对治疗模型形式存在不确定时考虑。它需要安装并配置候选学习器库;由于流程与所选学习器有关,先展示调用框架:
install.packages("SuperLearner")# SL.library 需要按本机已安装的 SuperLearner 学习器填写# 例如先查看:SuperLearner::listWrappers()W_super <- weightit( covariates, data = lalonde, method = "super", estimand = "ATE", SL.library = c("SL.glm"))上面SL.library = c("SL.glm")只是最小调用示意,并没有发挥集成多个候选算法的优势。真实分析中需预先确定候选库、保证其可运行,并检查模型预测、平衡和权重极端程度。交叉验证预测误差不是最终的因果设计诊断。
3. 贝叶斯加性回归树 BART
BART 以树模型叠加拟合复杂关系,通常不需要像 GBM 那样进行同类的调参搜索,但计算和结果具有随机性,应设置随机种子并检查权重:
install.packages("dbarts")set.seed(2026)W_bart <- weightit( covariates, data = lalonde, method = "bart", estimand = "ATE")summary(W_bart)bal.tab(W_bart, un = TRUE, stats = c("m", "v", "ks"))机器学习方法适合拓展候选模型,不是“自动免诊断”的捷径。小样本、严重缺乏重叠或训练不稳定时,灵活模型也不能凭空创造可比患者。
七、第三类:优化平衡方法
前两类先拟合治疗模型,再把预测概率转换成权重;优化平衡方法则直接求一组权重,使指定的协变量特征达到平衡,同时控制权重的离散程度。
1. 熵平衡(Entropy Balancing)
熵平衡在满足平衡约束的前提下,寻找尽量接近基准权重的一组权重。它常作为均值不平衡时的候选。以下以 ATT 为例,使未治疗者加权后与治疗者的协变量均值相匹配:
W_ebal_att <- weightit( covariates, data = lalonde, method = "ebal", estimand = "ATT")summary(W_ebal_att)bal.tab(W_ebal_att, un = TRUE, stats = c("m", "v", "ks"))熵平衡可实现模型中指定项的精确均值平衡;若要平衡连续变量的方差、非线性项或交互,可按研究需要增加矩或模型项。约束越多,权重可能越分散,ESS 也可能下降。精确均值平衡不等于整个联合分布都完全相同。
2. 稳定平衡权重(Stable Balancing Weights)
稳定平衡权重把权重精度纳入优化:在协变量均值差异不超过容许范围的条件下,尽量减少权重离散,常用于“平衡已经不错,但 ESS 太低”的场景。
install.packages("optweight")W_opt <- weightit( covariates, data = lalonde, method = "optweight", estimand = "ATE", tols = 0.05)summary(W_opt)bal.tab(W_opt, un = TRUE, stats = c("m", "v", "ks"))这里tols = 0.05是一个演示性的均值平衡容许值,不是普遍适用的规定阈值。
3. 能量平衡(Energy Balancing)
能量平衡以加权协变量联合分布之间的距离为目标,侧重整体分布,而不是只盯住预先指定的均值。它可用于非线性或交互结构难以预先明确的情形。
install.packages("osqp")W_energy <- weightit( covariates, data = lalonde, method = "energy", estimand = "ATE")summary(W_energy)bal.tab(W_energy, un = TRUE, stats = c("m", "v", "ks"))八、横向比较:每种方法解决什么、又要付出什么?
下表是方法特征的概括,不是基于当前lalonde数据运行出的结果排序。表中的“平衡保证”只针对方法及其设定所指定的特征,不代表所有协变量分布自动平衡。
lalonde示例中的调用 | |||||
|---|---|---|---|---|---|
method = "glm" | |||||
method = "cbps" | |||||
method = "ipt" | |||||
method = "gbm" | |||||
method = "super" | |||||
method = "bart" | |||||
method = "ebal" | |||||
method = "optweight" | |||||
method = "energy" |
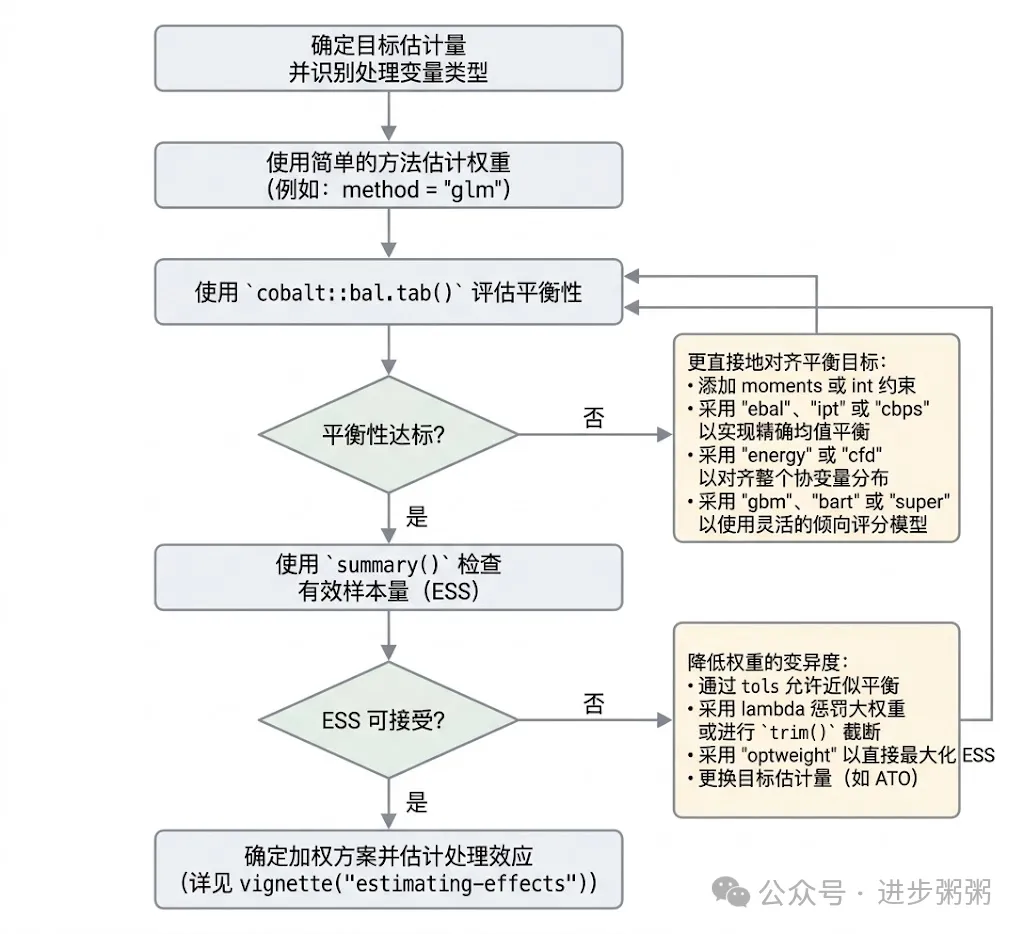
九、权重方法选择的实用流程
这里放入原文作者推荐的流程,为了便于阅读我将其翻译为了中文:
小结
权重方法大致有三条路线:参数模型通过治疗模型估计倾向评分,机器学习用更灵活的模型拟合治疗概率,优化方法则直接针对协变量平衡求解权重。
最稳妥的做法不是预设某个方法必胜,而是先确定目标人群,以简单模型作基准,再根据平衡和 ESS 比较合理的候选方法,并在查看结局之前确定分析方案。
教程地址:https://ngreifer.github.io/WeightIt/articles/weighting-methods.html#a-workflow-for-selecting-a-method
