「这些基准的保质期,说实话不算高。」
这句话是第十二讲的灵魂。讲师用 GPQA 举例:博士专家裸考 65%,非专家给 30 分钟加 Google 也只有 34%,而当时(约 2023)的 GPT-4 是 39%——可讲到这一刻,GPQA 已经被刷到 94% 了 。
模型越强,基准反而越像一场猫鼠游戏:你刚把题出难,模型(连同它的训练数据)就追上来;你开始怀疑这题是不是早就混进了训练集。这一讲要回答一个看似简单、其实没有终局的问题:怎么判断一个模型「好不好」?
先补地基:这一讲高频出现的八个词,各用一句人话讲清。
| |
|---|
| 模型给一段测试文本打的概率,取倒数再开方;越低代表它越「自信且答对」 |
| 让模型两两对打,用胜率反推每个模型一个分数,分高者常赢 |
| |
| |
| 不只看「说了什么」,看「做成了什么」(跑通代码、交上 PR) |
| |
| |
| |
后面不再逐个解释,直接用语。
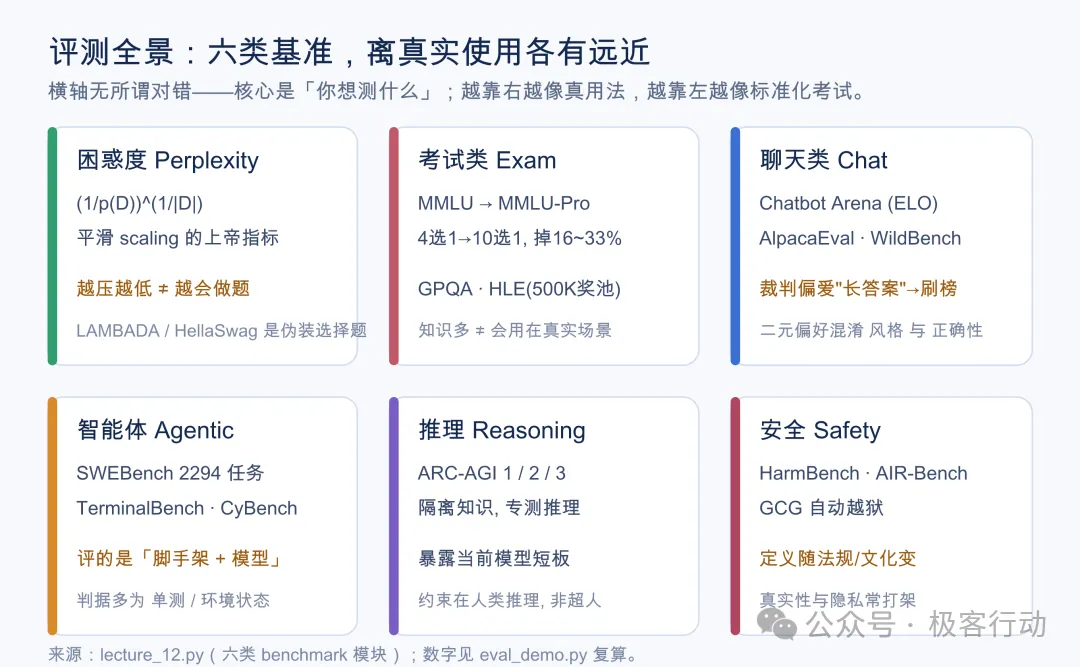
困惑度:平滑 scaling 的「上帝指标」
语言模型本质是个概率分布 p(x),给整段 token 序列打分。困惑度定义为 (1/p(D))^(1/|D|)——它衡量 p 有没有给测试集 D 高概率。
预训练阶段你在训练集上压低困惑度;传统做法是在测试集上再测一次。这是早期语言建模研究的经典范式(Penn Treebank、WikiText-103、One Billion Word)。GPT-2 第一次把预训练模型直接零样本丢到这些「分布外」数据集上,小数据集(PTB)因迁移反而好看,大数据集(1BW)则不行。
但困惑度有两个老毛病:
第一,它惩罚每一个 token 的预测,而很多 token(比如 founded)跟任务根本无关。解法是测「条件困惑度」——只看 p(response | prompt)^(1/|response|),把提示词部分刨掉。
第二,它低不等于「会做题」。好消息是,不少基准其实是披着选择题外衣的困惑度:LAMBADA 考完形填空,HellaSwag 考句子续写对错,本质都是比谁给「正确那段」的概率更高。
诚实边界:困惑度依旧是模型开发里最爱用的平滑信号(scaling law 友好),但它只是「信仰多于科学」——真分布 t 与模型 p 若相等,确实能解所有任务,可这条路上还有多远,没人说得清。本机无 GPU,本文不跑 perplexity 实测,只复述胶片口径。
考试类:越难越好,但越像考试
考试是人类用了几百年的评法:科目难度可控、答案无歧义、好打分。
MMLU 是代表:57 个学科(数学、美国史、法律、伦理)的 4 选 1。讲师点破——它名字叫「大规模多任务语言理解」,其实考的是知识,不是语言理解。
MMLU-Pro 把它升级:4 选 1 扩成 10 选 1、剔除噪声题、改用思维链,结果各模型准确率整体掉了 16%~33%——还没饱和,信息量更大。
GPQA 更狠:61 位 Upwork 上的博士出题,每题经过专家校验和修订,再让非专家带 Google 试做筛选(DIAMOND 集)。数字反差极大:博士专家 65%、非专家加 30 分钟 Google 仅 34%、讲课时点的 GPT-4 是 39% [25:05][25:28][25:33]。注意——专家 65% 在考试里也不是好成绩,但比「能 Google 的普通人」高出一截,说明题真的难且「Google-Proof」。可就在这节课里,GPQA 已经被刷到 94% [25:45]。
HLE(人类最后一场考试)把门槛再拉高:2500 题、50 万美元奖池悬赏出题人、用前沿 LLM 多轮过滤。趋势很清楚:模型越强越饱和,就出更难的题;可这类题不捕捉真实用法——真实问题多半开放、没有标准答案。
聊天类:ELO 天梯与裁判偏置
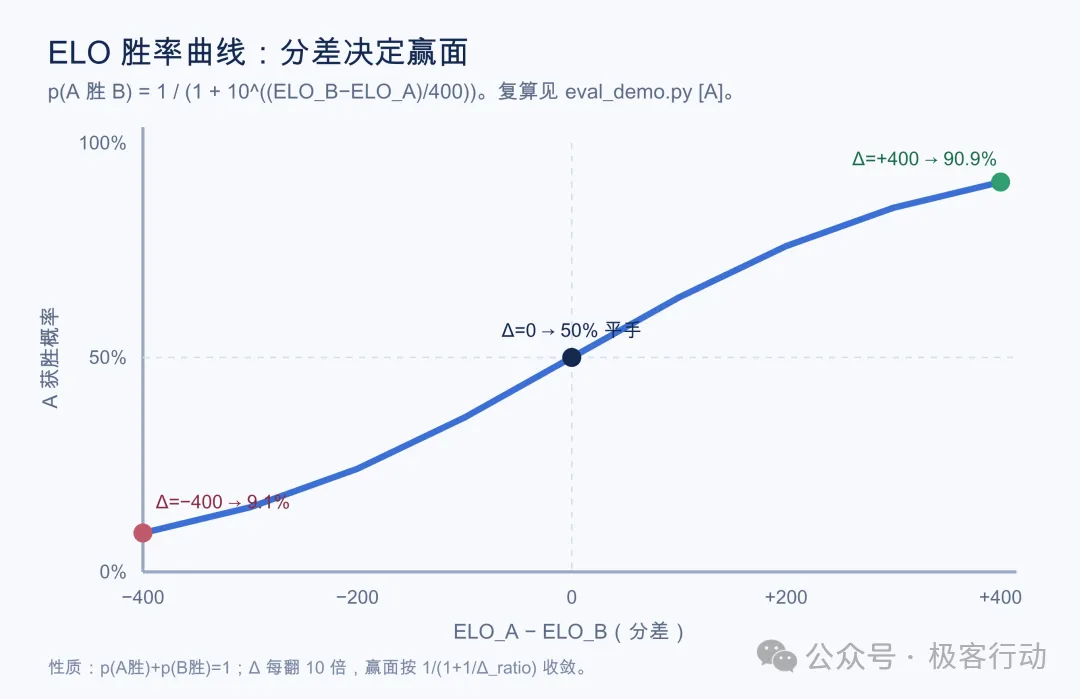
大多数人不会拿 4 选 1 考 AI 助手。怎么评一个开放式回答?Chatbot Arena 的招数是:真人在网上随机出题,匿名拿到两个模型的回复,凭喜好打分。用这些成对比较拟合出每个模型的 ELO 分。
胜率模型是这节课最值得复算的硬公式(lecture_12.py 字面给出):
p(A 胜 B) = 1 / (1 + 10^((ELO_B − ELO_A) / 400))
用 eval_demo.py [A] 直接复算,几个关键点对得上:
- Δ = +400 → 90.9%(即 10/11)
- 反过来,给定胜率 w,分差 Δ = 400 · log10(w / (1−w)),往返自洽
ELO 的好处是真人 prompt 来自真实使用(来刷题的人有动力真用),而且不用给所有模型喂同一道题——这点对真人裁判尤其重要 [37:45]。
但坑也不少:二元偏好把「风格」和「正确」混为一谈;真人裁判自己往往也不知道答案,怎么判对错?还存在谄媚偏置——更顺耳的答案被高估。AlpacaEval 早期用 GPT-4 当裁判,发现 LLM 裁判偏爱长答案,直接催生刷榜;2.0 版用回归去偏,和 Arena 人类打分相关性很高。
智能体评测:你评的是「脚手架 + 模型」
前面评模型「说了什么」,智能体评「做了什么」——比如调用工具跑代码、在一段时间里迭代。
SWEBench 给代码库加 issue 描述,让模型交一个 PR,判据是单元测试是否通过,共 2294 个任务跨 12 个 Python 仓库。TerminalBench 在真实终端环境里考 229 个任务;CyBench 用 40 个 CTF 夺旗题,以「首次解出时间」衡量难度;MLEBench 搬来 75 个 Kaggle 竞赛。
讲师强调一个常被忽略的点:Agent = 语言模型 + 脚手架(显式待办清单、子代理分层委派、持久记忆、极致上下文工程)。所以评一个智能体,约等于在评「脚手架 + 模型」两件事——模型再强,脚手架拉胯也出不了活。
安全与污染:评测本身也要被评
安全这边,HarmBench 基于 510 条违法或违规有害行为;AIR-Bench 按监管框架与厂商政策切成 314 个风险类、5694 条 prompt;GCG 攻击能自动优化 prompt 绕过安全护栏,还能从开源 Llama 迁移到闭源 GPT-4。但「安全」的定义本身随法规、文化、国别浮动,没有普世答案;不少风险(幻觉、谄媚、助长犯罪、削弱批判思维)形态各异。
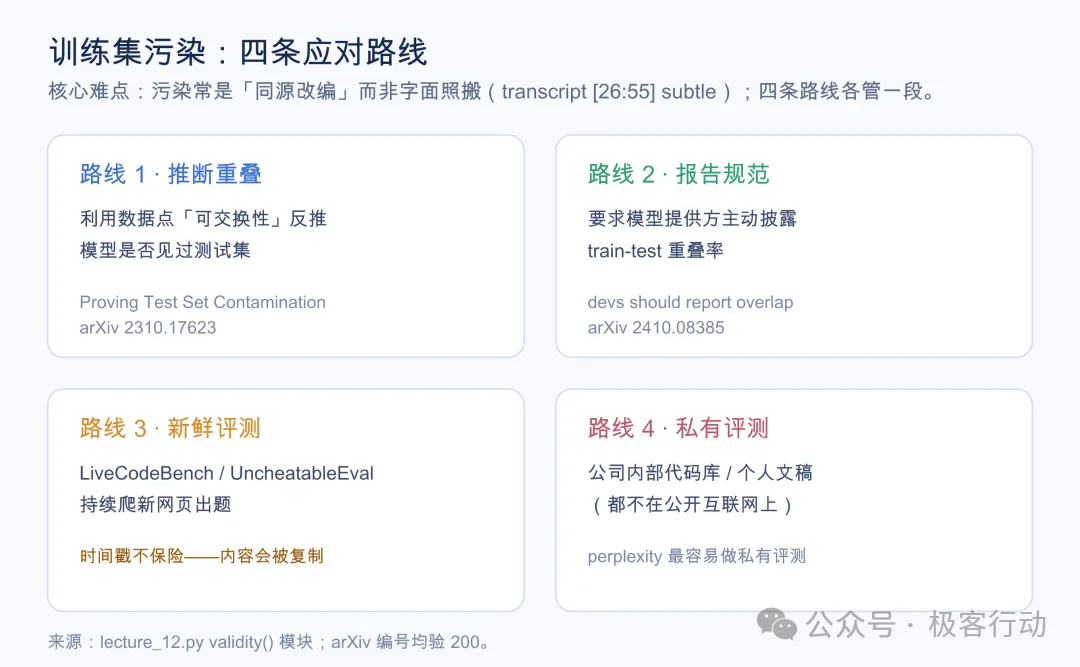
更隐蔽的是污染。机器学习第一课就讲别在测试集上训练,可今天模型在「整个互联网」上训,你根本不知道测试题在不在里面。讲师提醒:污染常常不是「字面抄了测试集」,而是「题目能从别的来源派生、而那些来源被训过」[26:55],比误训微妙得多。
应对有四条路线(见下图):
- 推断重叠——利用数据点的「可交换性」反推模型是否见过测试集(arXiv 2310.17623)
- 报告规范——要求模型提供方主动披露 train-test 重叠率(arXiv 2410.08385)
- 新鲜评测——LiveCodeBench / UncheatableEval 持续爬新网页;但时间戳也不保险,内容会被复制
- 私有评测——用公司内代码库或个人文稿(都不上网),其中困惑度最容易做私有评测
诚实边界:三种口径怎么用
这一讲的材料分三层,写的时候我严格区分了:
胶片口径(lecture_12.py 列明的六类基准与 ELO 公式)是骨架,可信度最高。
口述口径(课堂字幕里带时间戳的原话)是血肉:GPQA 三组人数字 [25:05][25:28][25:33]、MMLU-Pro 掉分 16%~33%、基准「保质期不长」[25:54]、ELO 之美 [37:45]、污染是 subtle 的过程 [26:55]、收口句「没有唯一评测」[77:37]。这些都能回放定位。
外部对账:本课涉及的 19 篇 arXiv 我全部用 abs 页 title 核对过 200(MMLU 2009.03300、MMLU-Pro 2406.01574、GPQA 2311.12022、HLE 2501.14249、Chatbot Arena 2403.04132、AlpacaEval 2.0 2404.04475、WildBench 2406.04770、SWEBench 2310.06770、TerminalBench 2601.11868、CyBench 2408.08926、MLEBench 2410.07095、HarmBench 2402.04249、AIR-Bench 2407.17436、GCG 2307.15043、GDPVal 2510.04374、MedHELM 2505.23802、Clio 2412.13678、污染 2310.17623 / 2410.08385)。GPQA 的 65%/34%/39% 属口述数字,按规则标注、未做独立交叉验证;「现在 94%」是课堂当时的读数,随月份会变,引用时请注意时效。
讲师的原话收口最该记住:没有唯一评测(no one true evaluation)[77:37]。你想测用户采购决策、研究者测原始能力、还是测收益与危害,答案不同;难度、真实度、有效性三者常常要取舍,选哪个妥协,取决于你的目标。
白话 → 行话 速查表
| |
|---|
| |
| |
| |
| train-test contamination 污染 |
| |
| |
| |
可复算脚本与一手来源
CS336/eval_demo.py(纯标准库,零依赖)复算了本课三个锚点:[A] ELO 胜率公式与反解、[C] GPQA 三组人数字、[D] MMLU-Pro 掉分区间。直接 python3 CS336/eval_demo.py 跑通。
素材真源:CS336 官方 lecture_12.py(六模块:perplexity / exam / chat / agentic / reasoning / safety)。基准论文链接见上文外部对账清单,均验证可访问。
关注「极客行动」,一起探索新知,把想法变成行动。觉得有用,欢迎收藏,也分享给需要的朋友。