AI 榜单换了算法,开源模型与榜首的差距从 3 分变成 12 分。这篇讲清改了什么,以及你以后怎么读分。
—— 奔向北极星
10 月 27 日,独立评测机构 Artificial Analysis 把自家最看家的那个榜单换了算法。第二天 Google 发布 Gemini 4 Carbon 并登顶,开源模型和第一名的差距,从 3 分变成 12 分。
先说清楚这个榜单是什么。Artificial Analysis 是一家不卖模型的第三方,自己出题、自己跑分,把结果攒成一个总分,叫智能指数。很多人挑模型看的第一个数就是它。
这次改的不只是题目,还有规则。官方公告里写明,六成的分数现在建立在私有测试集或者不公布的答案上,这是头一回。私有测试集就是不对外公开、也没法提前练的考题。
六成的分数来自不公开的考题,这一改让排名整片换了位置。
下面把改了什么、为什么值得当回事、你该怎么重新读分,一条条拆开讲。
改版是 10 月 27 日发布的,官方叫 Intelligence Index v5,也就是第五版。按公告的说法,这是今年 1 月发布第四版以来最大的一次升级。
这次改版最狠的一刀,是六成的分数不再用公开考题。
为什么这么改,官方给的理由很直接:防止 benchmaxxing。这个词说的是对着已经知道的考题反复练,分数涨了,本事没涨。题不公开,这条路就走不通了。
新版一共九项评测,分成四组,每组占四分之一:知识工作、写代码、做科研、通用能力。四组平分,意味着任何一组偏科都藏不住。
四组底下的明细也给了。知识工作这块,AA-Briefcase 占 15%,AutomationBench-AA 和 GDP.pdf 各占 5%;写代码这块,FrontierCode 2.0 占 15%,Terminal-Bench 4.0 占 10%;做科研这块,Terminal-Bench-Science 占 15%,CritPt v2 的难题子集占 10%;通用这块,AA-Omniscience v1.1 占 15%,其中准确率 10%、不胡说 5%,HLE-Diamond 占 10%。
里面有两项是新加的。一项叫 FrontierCode 2.0,是 Cognition 出的编码题,132 个任务全部取自真实开源仓库,评分标准是维护者会不会合并这个改动;每个任务跑三次取平均,任一次卡在阻塞检查上就记 0 分。另一项叫 Terminal-Bench-Science,70 个科研任务在终端里做,专家出题并审题,所有测试全过才算通过。
还有三项是旧题升级。HLE-Diamond 取代了原来那套叫 Humanity's Last Exam 的题,是 1000 道精炼题,推理题和知识题各占一半。AA-Omniscience v1.1 把考烂了的题和公开的题删掉,补了新题,还修订了一批有歧义和出错的题。CritPt v2 只取 40 道难题:原始的 70 道研究级物理题里,把发布时七个前沿模型五次全都解出来的那 30 道去掉了。
同时下架了三项:GDPval-AA v2.1、SciCode 和 AA-LCR v1.1。改版当天排在榜首的是 Claude Opus 5.5,58 分;第二天 Google 发布 Gemini 4 Carbon,以 59 分把它挤到了第二。
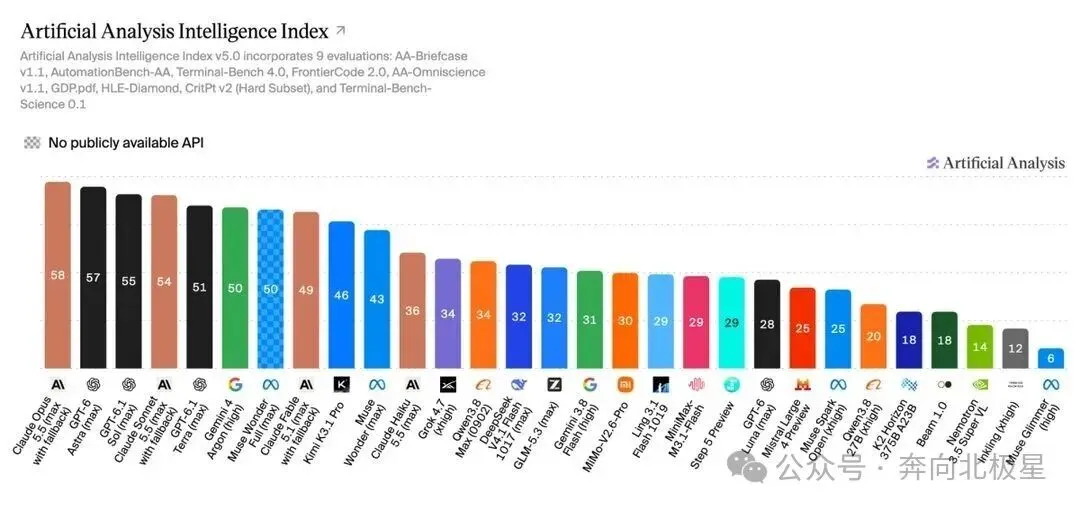 智能指数 v5 的完整榜单,改版当天放出的这一版榜首是 58 分,末尾已经掉到个位数
第一层影响是排名洗牌。据 The Decoder 报道,Kimi K3.1 Pro 从原来的第 4 名掉到第 9 名,排在它前面的八个全是闭源模型;Grok 4.7 掉了 12 分。
前三名咬得也很紧:Gemini 4 Carbon 59 分,Claude Opus 5.5 58 分,GPT-6 Astra 57 分。一分之差放到九项评测里,往往只是某一项多过了几道题,读不出谁碾压谁。
开放权重模型与榜首的差距,官方口径是从 3 分拉大到 12 分。
这里要补一句口径。公告里那个 12 分,是改版当天按 58 分的榜首算出来的;第二天 Gemini 4 Carbon 以 59 分上位,同样的算法下差值就变成了 13 分。数字会跟着榜首动,别把它当成谁退步了多少。
第二层影响更扎心:已经放出权重的开源模型里,最高分是 DeepSeek V4.1 Flash 1017 和 GLM-5.3,都是 32 分。这个分数低于 Claude Haiku 5.5 的 36 分,而 Haiku 是同一个厂商里的小模型。想靠下载权重自建一套最强能力的,眼下做不到。
差距最宽的地方也写得很明白。HLE-Diamond 上,Kimi K3.1 Pro 是 37%,Claude Opus 5.5 是 68%;Terminal-Bench-Science 上,Kimi 是 34%,GPT-6 Astra 是 63%。差的是硬题。
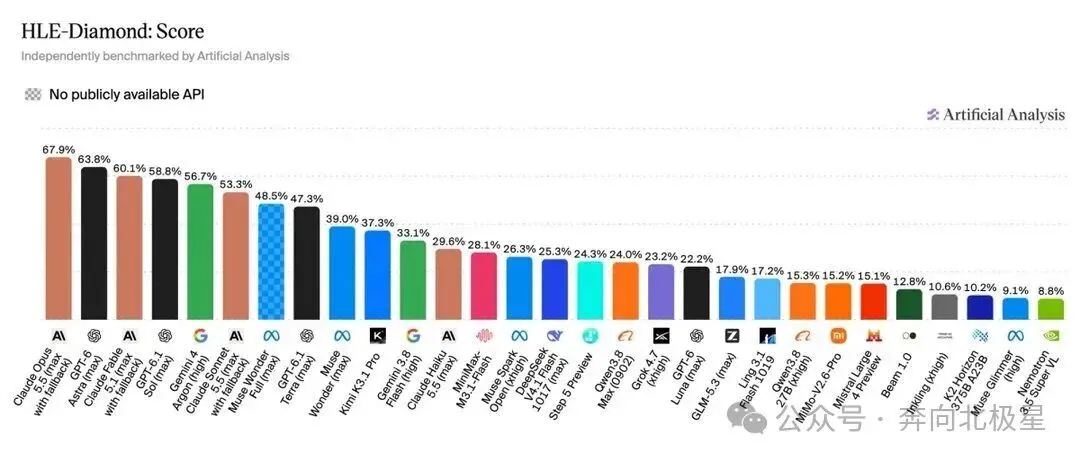 HLE-Diamond 这一项的分数榜,榜首 68%,Kimi K3.1 Pro 是 37%
第三层影响是这九项评测没有一个模型全包。改版当天的公告里点了名:Claude Opus 5.5 领先三项,另外五个模型分掉其余六项,Kimi K3.1 Pro 在 Terminal-Bench 4.0 上第一(67%),Gemini 4 Argon 在 AutomationBench-AA 上第一(78%),Muse Wonder Full 在 GDP.pdf 上第一(33%)。第二天上位的 Carbon 也没能通吃:它在九项里的四项排第一,写代码和知识工作这两块仍然不是它领跑。
先说短期,三到六个月。厂商跟着换玩法是必然的:以前可以对着公开题练,现在题不公开,能练的只剩通用本事。换句话说,榜单分数往上涨的速度会变慢,涨一分比过去难。
另一个短期变化会落在厂商自己身上。题不公开之后,各家更倾向于公布自己的内部评测,第三方榜和厂商自测的分歧会变多。看分数之前先看是谁出的题,这个习惯现在就该养起来。
开源阵营的压力会更具体。差距被量出来之后,能不能补上,拼的是真金白银的训练基础设施。AI 研究者 Nathan Lambert 在 The Decoder 的报道里给的判断是,刷榜只是原因之一,很多提升本来就发生在和考题长得很像的强化学习环境里;而要在多个领域同时跟上,需要很重的强化学习基础设施,不是每个实验室都掏得起。
给你一个可以证伪的观察点:等下一版指数出来,如果私有题的比例继续加、而开源与榜首的差距继续扩大到 15 分以上,那基本可以认定这是能力差距;如果差距反而收回到 5 分以内,说明这一回主要是评测口径的变化。两种结果都可能出现,看数就行。
再说中期,一年这个尺度。榜单会分成两类:一类像 Intelligence Index,回答现在谁好用;另一类是同一天发布的 Progress Index v1,用项目反应理论把 2022 年 11 月以来的模型放到同一把尺子上,专门用来比不同年代的进步。项目反应理论可以理解成一种换算办法,让不同卷子的分数能放在同一条线上比。
看懂这两把尺子的分工,比记住谁排第几更有用。
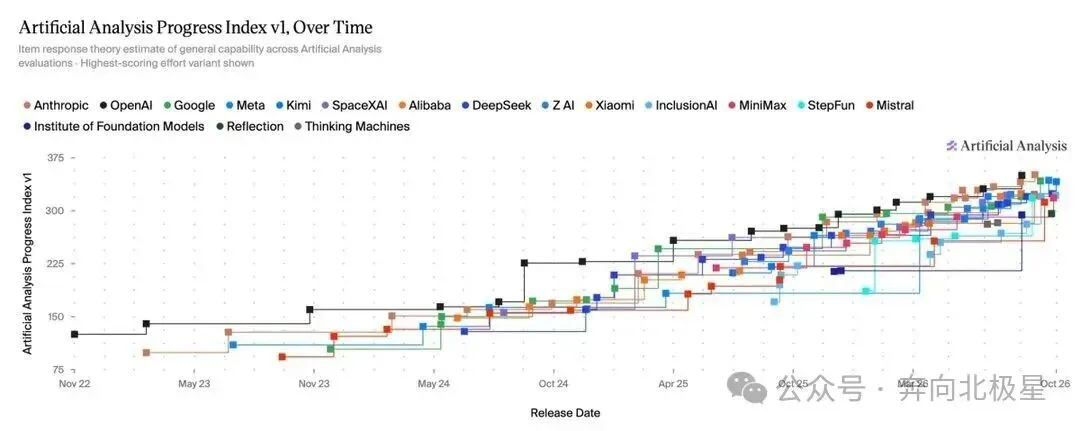 Progress Index v1 的曲线,横轴从 2022 年 11 月一直排到 2026 年 10 月
中期还有一件事会跟着变,就是企业采购时的问法。过去问哪个模型分最高,接下来更该问哪一个档位、做某一类任务的成本是多少。官方这次把每任务成本、输出 token 都摊开了,等于把采购单的写法也改了一遍。
第二个观察点:看开源阵营下一次交卷时,有没有模型能在 HLE-Diamond 和 Terminal-Bench-Science 这两项上追到 50% 以上。这两科是官方点名差距最宽的,也是最难靠刷榜补上的。
必做第一条:把你手上的模型按四组能力重新看一遍,别只盯总分。四组各占四分之一,一个天天让 AI 写材料的人和一个天天让它改代码的人,该看的那一栏根本不是同一栏。总分高的那个,未必在你那一栏也高。
必做第二条:先调思考档位,再考虑换模型。思考档位就是让它想多久,想得越久越费钱。公告给的数很实在:Claude Opus 5.5 低档 35 分、满档 58 分,中间差 23 分,而成本差 10 倍,每个任务 0.98 美元对 10.04 美元。
先调档位再换模型,这是这回最省钱的一条。
建议第一条:算账改成按每个任务的成本算,别只比每百万 token 的单价。公告说,排在前十的模型里,每个任务的成本差了 13 倍以上:GPT-6.1 Terra 最便宜,0.96 美元;Claude Fable 5.1 最贵,13.04 美元。而 GPT-6.1 Sol 的分数只比 Claude Opus 5.5 少不到 4 分,成本大约只有它的八分之一。新榜首 Carbon 便宜一些,每个任务 7.76 美元,比 Opus 5.5 少两成左右,但仍比 GPT-6 Astra 贵一些。
建议第二条:预算往上调一档。新版题目更重,每个任务的输出 token 中位数从 3.5 万涨到 5.9 万,涨了三分之二。token 就是计费的小单位。智能体类的评测只占 55% 的权重,却吃掉中位约九成的输出 token,其中 Terminal-Bench-Science 一项就占了三分之一左右。
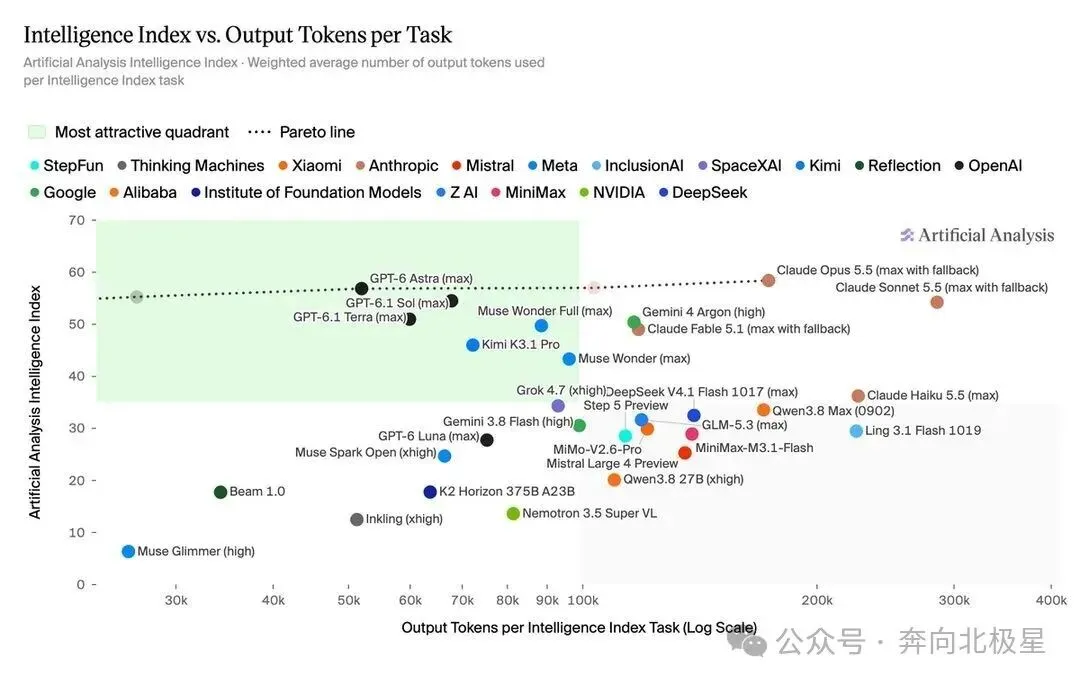 智能指数与每个任务输出 token 数的关系,横轴按对数刻度排布
可选第一条:如果你在等开源模型做私有化部署,先把预期压一压。已经放出权重的模型里最高 32 分,比同一家厂商的小模型 Claude Haiku 5.5 的 36 分还低,只有榜首的一半出头。真要自己部署,眼下得接受能力打折。
可选第二条:想知道这两年到底进步了多少,去看同日发布的 Progress Index 而不是这份榜单。它的用途就是跨时间比较,官方也说了,比当下谁最强仍然要看 Intelligence Index。
还有一条可做的:挑你最常做的那一类活儿,选二十条出来,在两三个档位上各跑一遍,记下效果和花费。榜单给的是别人的平均分,这二十条给你的是自己的数。
开源一夜落后这个说法太满了。官方原话是差距从 3 分扩大到 12 分,那是按当时的榜首算出来的差值,不是谁退步了 12 分。这两件事差别很大。
另外,这 12 分是在同一个指数内部比的,不能拿去跟别家机构的分数做加减。各家出的题不一样,分数就不是同一把尺子。
私有考题是有代价的。The Decoder 指出,题目不公开之后,外面的人再也发现不了题出错了。这不是假设:Artificial Analysis 这次恰恰在 AA-Omniscience v1.1 里修订了一批有歧义和出错的题,等于自己给自己挑了错。
题不公开能防作弊,同时也就没人能替它挑错。
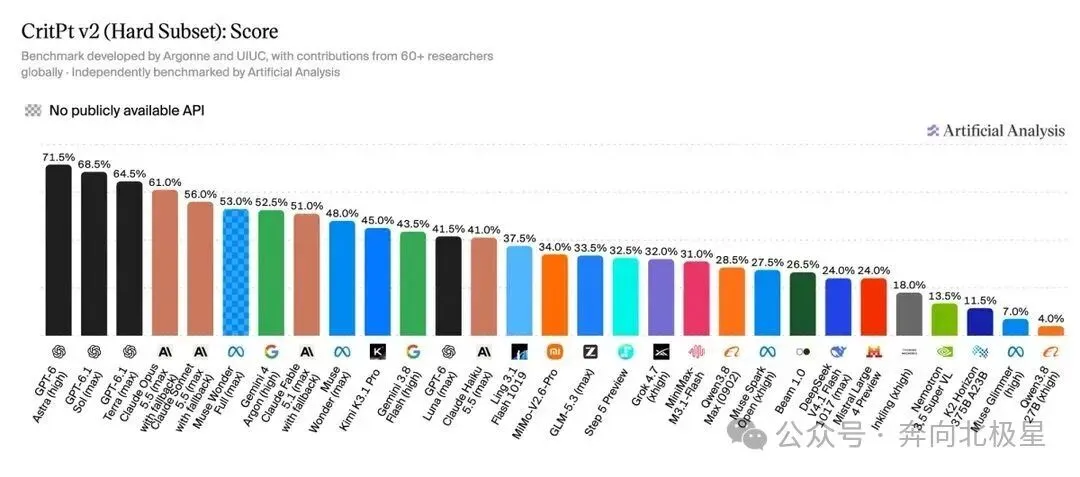 CritPt v2 难题子集这一项的分数,用的是 40 道不公开的研究级物理题
还有一个词容易被用错。开放权重说的是能不能下载,不等于随便用;这份榜单比的是能力分,不是授权条款。真要把权重拿去部署,许可里写了什么还得自己看一遍。
所以排名下滑不等于这个团队不行了。要在好几个领域同时跟上,靠的是很重的基础设施,不是每个团队都掏得起。
榜首那个模型你暂时还用不上。Gemini 4 Carbon 这次以 59 分排在第一,但 Google 的说法是先通过 Fairwind Program 给可信的网络安全防御方,不是全面开放。冲着榜首去换工具,现在换不到。
还有一条最容易被忽略:这九项评测是别人出的卷子,跟你的场景不会完全重合。
盯 Kimi K3.1 Pro 的权重什么时候放。它是榜单上分数最高的开放权重模型,46 分,但公告里明说权重还没放出。放出来之后能不能守住第 9 名,是个硬指标。
盯下一版指数。这一回新增了哪两项、升级了哪三项、下架了哪三项,官方都写明了;下一次还会不会继续往私有题上挪,决定了这个榜还能不能被外部检验。
盯 HLE-Diamond 和 Terminal-Bench-Science 这两个数。差距最宽的两科就在这里,开源阵营下一次交卷先报这两个。
还有一个时间点:Google 说过 Carbon 会先给网络安全防御方用,还给了五折的首发价、没说什么时候结束。等它真正全面开放,榜首这个位置才跟你手上的活儿有关系。
把榜单当参考,把自家数据当结论。
回头看,这次改版真正的变化不在名次,而在尺子本身:六成的分数建立在不再公开的考题上,四组能力平分权重,成本和思考档位这一次被摆到了和分数差不多的位置上。
上榜的那些数会一直变,读分的办法不会变。
换模型之前,先拿自己的活儿跑一遍。
本文基于公开报道整理,以官方与原始信源为准,不构成投资或法律建议。
下期选题投票来了,你最想让我们写一篇哪个?一,怎么给自家业务挑模型;二,开源模型本地部署到底要多少硬件;三,AI 账单怎么算才不被吓到;四,思考档位该怎么选。评论区告诉我,票数高的先写。
奔向北极星
每天分享 1 个普通人也能学会的 AI 小技巧
如果今天这篇对你有点用,顺手点个收藏,也欢迎转给同样在摸索的朋友。
我是 KREE,我们下篇见。