2026年全球AI大模型排行榜中,综合能力最强的模型主要集中在 Claude 和 GPT-6 系列。由于各大评测体系(如 LMSYS Arena、SWE-bench、SuperCLUE 等)以及模型版本的快速迭代,不同维度下的排名会有所差异。以下为您梳理 2026 年 7 月至 9 月期间的全球主流 AI 大模型梯队榜单:
🌍 全球综合大模型(文本与多模态)梯队
1. T0 顶尖梯队(综合最强)
根据 2026 年 9 月的最新评测,以下模型进入了最高的 T0 梯队:
Claude Opus 5.5 :最新发布的模型,综合表现极佳,运行成本相比上一代降低约 40%。
Claude Fable 5.1 系列 :长文本、复杂推理与智能体任务表现突出,百万级上下文窗口,在复杂研究问题拆解、科学推理等方面属于天花板级别。
GPT-6 Astra :2026 年 9 月发布的旗舰模型。
GPT-6 Sol :偏向高性能日常工作和代码编写(Coding),输入价格低至 2 美元/百万 Token。
2. T1 强力梯队
Muse Spark 1.3 、 Grok 4.7 (强化 Coding 与长时间 Agent 任务)、 MiMo-V2.6-Pro (国产小米开源)、 Kimi K3 (中国月之暗面,登顶前端开发榜全球第一)。
通义千问 Qwen 系列 (如 Qwen3.8 Max、Qwen3.5-Max,中文理解与超长上下文能力领先)。
Gemini 3.1 Pro / Gemini 3.8 Flash :原生多模态标杆,视频、图像理解与多模态文档处理能力强。
DeepSeek V4 / DeepSeek-R1 :开源性价比之王,中文表现强劲。
🎨 全球 AI 图像生成模型排行榜
2026全球最强十大AI大模型
1. GPT-5.2
定位:深度推理之王。
优势:
极致推理:在数学、物理、逻辑谜题及复杂代码架构设计上仍保持全球第一,尤其是其“Thinking”模式,能处理极度复杂的链式推理任务。
缺点:
成本高昂:API调用价格昂贵,不适合大规模低成本应用。
2.Gemini 3 Pro (Google)
定位:原生多模态霸主,长上下文王者。
优势:
超长上下文:支持数百万Token的上下文窗口,能一次性处理整本书、长达数小时的视频或大型代码库。
多模态融合:真正的“原生”多模态,对图像、音频、视频的理解能力远超其他模型,能直接分析视频中的细微动作和语音语调。
谷歌生态:与Google Workspace、Search深度集成,实时信息检索能力极强。
缺点:
幻觉问题:在处理极度冷门的知识时,偶尔会出现“自信地胡说八道”的情况。
3. Claude Opus 4.5 (Anthropic)
定位:程序员用了都说好
优势:
代码能力:在代码生成、调试、重构及全栈开发任务中表现极佳,被许多开发者评为“最好用的编程伙伴”。
自然语言:文笔最接近人类,语气自然,擅长长篇写作、润色和角色扮演,几乎没有“机器味”。
缺点:
知识截止:相比GPT和Gemini,其联网搜索和实时信息获取能力稍弱(依赖外部工具)。
多模态略逊:虽然视觉能力很强,但在视频理解和复杂图表分析上略逊于Gemini 3。
4. Qwen3(阿里巴巴)
定位:国产最强,性价比之王。
优势:
综合性能:在2026年实现了重大突破,综合评分对标GPT-5和Claude Opus,尤其在数学和逻辑推理上表现惊人。
中文理解:对中文语境、文化梗、古诗词的理解远超国外模型。
缺点:
国际生态:在海外工具的集成度(如直接操作Google Docs等)不如本土模型方便。
多语言微调:虽然支持多语言,但在小语种(如非洲、南美方言)的表现上不如Google。
5. DeepSeek-V4
定位:推理黑马,超高性价比。
优势:
MoE架构效率:采用先进的混合专家模型架构,以极低的参数量激活实现了顶级性能,推理速度极快。
代码与数学:在特定垂直领域(特别是算法竞赛级数学题和复杂代码生成)经常霸榜,甚至超越GPT-5。
价格屠夫:API价格极低,是初创公司和大规模应用的首选。
6. Grok-3 (xAI / 马斯克)
定位:实时资讯专家。
核心优势:
实时数据:直接接入X (Twitter) 实时数据流,对突发新闻、股市动态、舆情分析的反应速度全球第一。
缺点:
稳定性:由于追求实时和自由,输出内容的准确性和严谨性偶尔波动较大。
适用场景:不太适合严肃的学术写作或高度合规的企业环境。
7. Kimi 2.0 (月之暗面)
定位:长文档处理专家,国内办公利器。
核心优势:
长文本记忆:在中文长文档(如法律合同、财报、小说)的摘要、检索和分析上表现卓越,无损记忆能力极强。
用户体验:界面友好,国内访问速度快,无需特殊网络环境。
缺点:
多模态短板:在视频理解和复杂图像生成方面相对较弱。
国际化:主要聚焦中文市场,英文及其他语言能力一般。
8. Llama 4 (Meta)
定位:开源世界的基石,私有化部署首选。
核心优势:
开源免费:提供最强大的开源权重,允许企业在本地服务器完全私有化部署,数据绝对安全。
社区生态:拥有全球最大的开发者社区,衍生模型(Fine-tuned models)极其丰富,针对医疗、法律等垂直领域有无数优化版本。
灵活性:可裁剪性强,能从手机端运行到超算中心。
缺点:
上手门槛:需要较强的技术团队进行部署、维护和微调。
原生能力:基础版本的推理和多模态能力略逊于闭源的顶尖模型(需依赖社区微调才能达到巅峰)。
9. Command R+ 2026 (Cohere)
定位:企业级RAG(检索增强生成)专家,多语言商务助手。
核心优势:
RAG优化:专为连接企业数据库设计,引用来源极其精准,极少产生幻觉,非常适合客服、知识库问答。
缺点:
创意不足:在创意写作和开放式对话中表现较为刻板,“商务味”太重。
10. GLM-4.5 (智谱AI)
定位:全能型国产模型,Agent(智能体)能力强。
核心优势:
智能体协作:在自主规划任务、使用浏览器、操作软件等Agent任务上表现突出。
双语平衡:中英文能力非常均衡,且在学术文献理解上有深厚积累(源自清华系背景)。
端云协同:推出了强大的端侧模型,能在手机本地流畅运行复杂任务。
缺点:
峰值性能:在最顶尖的奥数难题或超复杂代码架构上,与GPT-5/Claude Opus仍有微小差距。
总结:AI大模型就像是一个个有特点的人,各自有自己擅长的领域,普通的编程、图像、休闲他们都可以满足,但是更专业的就需要根据自己的需求使用对应的AI模型。
————————————————
版权声明:本文为CSDN博主「蒙娜丽莎的喉结」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
原文链接:
https://blog.csdn.net/qq_65521225/article/details/158697184
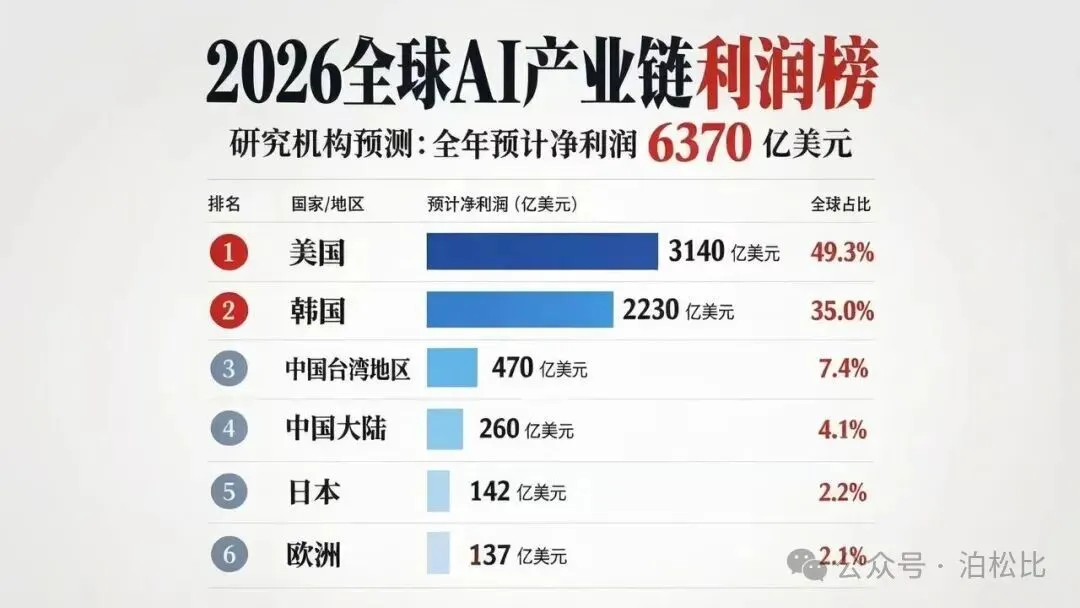
根据资产管理机构Altimeter的拆解的数据,2026年全球AI产业净利润预计达6370亿美元,这是什么概念——6370亿美元已逼近全球石油天然气行业的全年利润总量,更是超过了汽车、制药、零售电商等传统支柱产业。
蛋糕虽然规模很大, 但是分割的方式竟然呈现出一种极为矛盾、完全相反的状态。
半壁江山归美国:英伟达一家吃掉三分之一
美国AI产业链总净利润达三千一百四十亿美元, 独占了49.3%的全球份额。
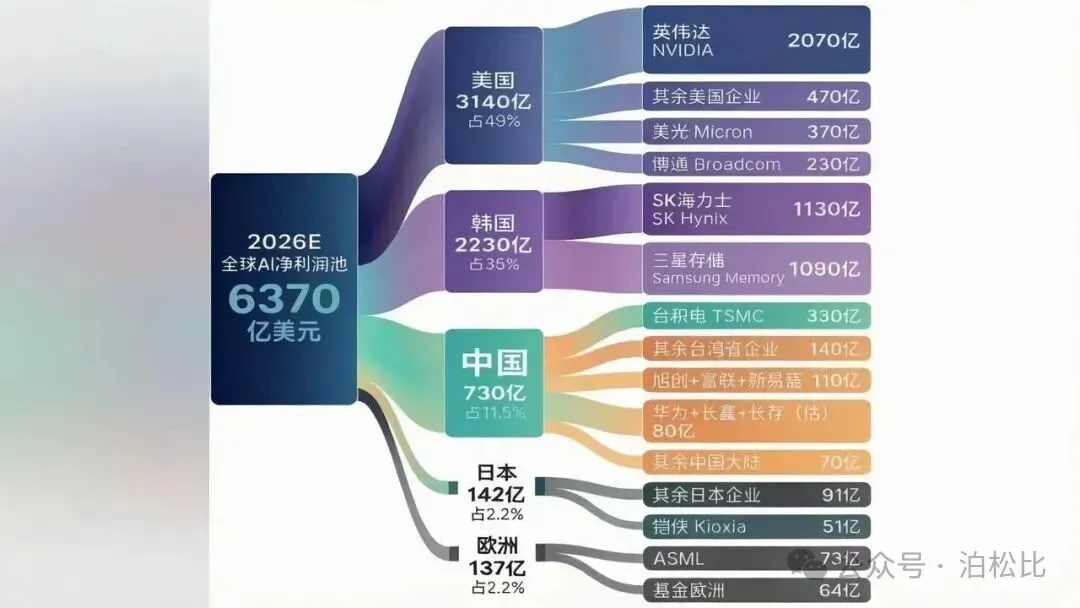
其中, 英伟达遥遥领先于其他所有竞争者, 一家公司贡献了二千零七十亿美元的利润, 这相当于全球人工智能总利润的三分之一。
从GPU、HBM到先进封装与互联芯片, 美国牢牢卡住了算力链最肥的环节, 坐收“卖铲人”的暴利。
韩国凭存储“躺赢”:两家巨头撑起35%
韩国拿下了35%的份额, 利润两千两百三十亿美元, SK海力士(1130亿)与三星存储(1090亿)两家几乎平分秋色。韩国成为一轮人工智能周期里最让人意外的赢家 。
中国两岸合计11.5%:代工与光模块撑起增量
中国台湾地区, 以四百七十亿美元的贡献金额以及7.4%的占比, 在排名上稳居第三的宝座。
中国大陆260亿美元, 占总体的4.1%, 从大陆企业进行业务分布的具体情况可以看出, 这些企业的业务主要集中在光模块、服务器代工业务以及国产化的存储产品方面。
韩国的 35% 同样来自上游的核心卡位。 三星与 SK 海力士垄断了 HBM 高带宽内存市场,这是 AI 算力的核心耗材。 没有 HBM,再高端的 GPU 也跑不动大模型,稀缺性带来了超高的利润率。
SK 海力士今年一季度营业利润率达到 72%,创下半导体行业的历史纪录。 这种级别的暴利,靠的是技术壁垒带来的定价权,不是靠规模或者勤奋。 韩国恰好踩中了存储这一个核心节点,吃尽了 AI 爆发的红利。
再看中国的 4.1%,构成就完全不一样了。 主要来自光模块、PCB 电路板、服务器整机组装这些中游制造环节。 这些环节技术门槛相对低,竞争充分,利润率自然薄很多。
我们赚的是制造环节的辛苦钱,不是核心技术的溢价钱。 很多人拿长鑫的利润举例,说前三季度就赚了一千三百多亿,远超这个比例。 但这里有个很关键的统计口径差异,很多人没注意到。
长鑫的利润大部分来自通用 DRAM 市场,并非全部是 AI 相关业务。 目前国产 HBM 还在技术突破和量产爬坡阶段,还没到大规模收割利润的时候。 把所有存储利润都算进 AI 赛道,本身就是对数据的误读。
日本142亿美元, 占比为2.2%, 欧洲地区137亿美元的体量, 占比达到2.1%。
点击阅读原文,了解更多!