阅读路线
今天更新 56 篇具身智能新论文,覆盖动态操作与鲁棒评测、世界模型与在线适配、具身智能体与导航、灵巧接触与运动控制等方向。为了方便快速浏览,本期按阅读优先级分成三档。
1 篇深读2 篇跟进53 篇扫读
先读LIBERO-Dynamic,检查推理延迟与动态执行的评测口径;再看RAX如何积累可复用技能,以及T2-z如何适配隐藏环境因素。其余论文按阅读优先级排列,可结合自己的感知、控制和评测需求快速浏览。
先看这一篇
1模型在思考,目标还在移动
LIBERO-Dynamic: Benchmarking Robotic Manipulation in Dynamic Environments
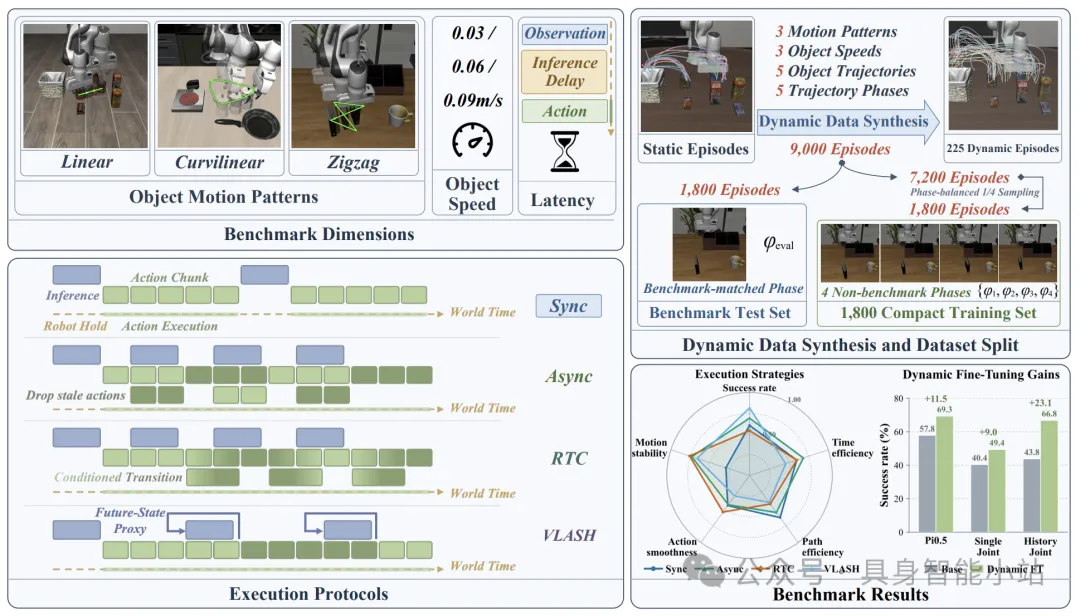
一句话判断:模型在静态桌面上成功,不代表能抓住移动中的目标。LIBERO-Dynamic把物体运动、实测推理延迟和动作队列放进同一评测:机器人思考时,物理世界继续运行。它让部署中的等待与反馈问题可重复测量,也提醒读者不能只凭离线成功率选择策略。
你可以带走的两点
• 把延迟放回物理时间。基准覆盖全部40项LIBERO任务,每个模型—执行配置使用相同的1,800个回合;三类轨迹、三档速度与标定延迟共同定义测试条件。选模型时应同时报告成功率、动作时域和执行方式。
• 更频繁重规划,先保证队列不断粮。同一π₀.₅检查点在实测最佳动作时域下,异步和同步成功率分别为48.4%与43.1%;这是各自有限扫描中的最佳点。缩短时域若耗尽动作队列,反而会降低成功率。
方法亮点:新增价值是把目标运动、推理耗时与动作执行连续性放在同一可控协议中,而非仅给场景增加动态物体。结论限定于规定轨迹和标定延迟;复杂随机运动、时延抖动与更广泛真机任务仍待验证。
论文:https://arxiv.org/pdf/2610.24579
代码:https://github.com/renshaojie233/LIBERO-Dynamic
项目页:https://renshaojie233.github.io/LIBERO-Dynamic/
另外 2 篇值得跟进
2把在线探索经验编译成机器人技能
Scaling Online Exploration for Robot Agents
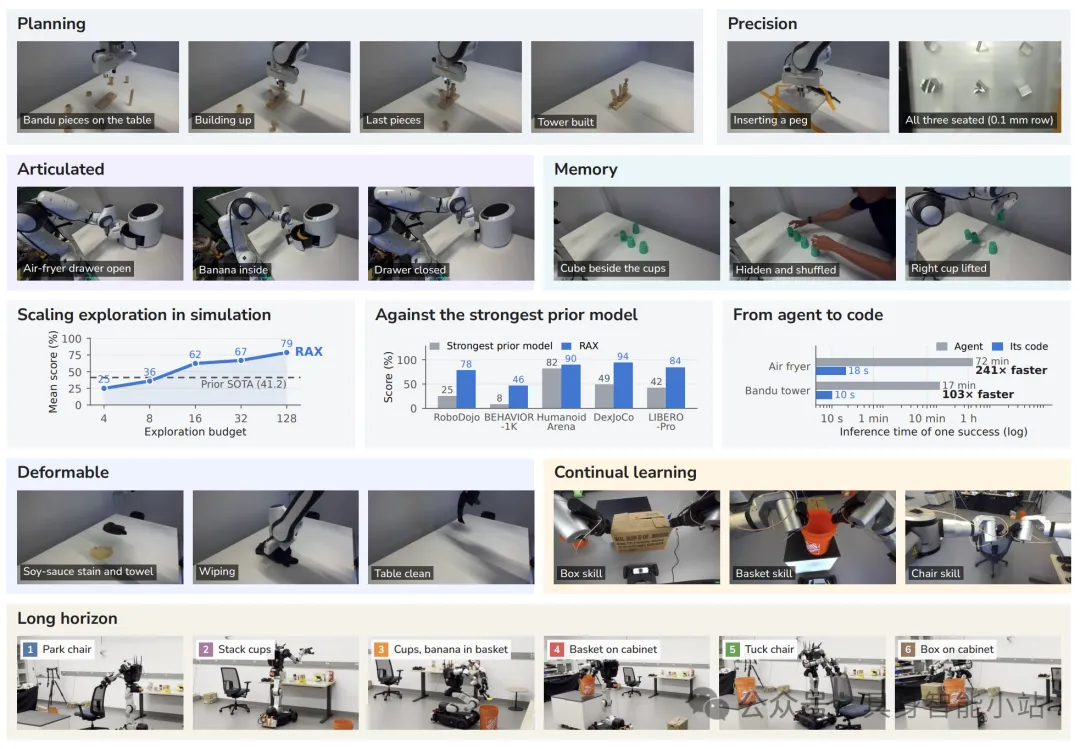
看点:新机器人常要重新采集示范。RAX让编码智能体通过在线探索,把感知、规划和执行检查写成可复用程序;多形态实验展示减少示范依赖的路径,但仍需要机器人接口与真实试错。
结果:经验可以存成程序。先在限定探索预算内编写、验证技能,再冻结代码测试新场景;阅读结果时要区分探索期成本和成品程序的推理成本。
论文:https://arxiv.org/pdf/2610.22496
代码:https://github.com/robot-agent-exploration/rax
项目页:https://robot-agent-exploration.com/
3换了摩擦与质量,先适配环境潜变量
T2-z: Test-Time Optimization of Environment Latents for Robotic World Models
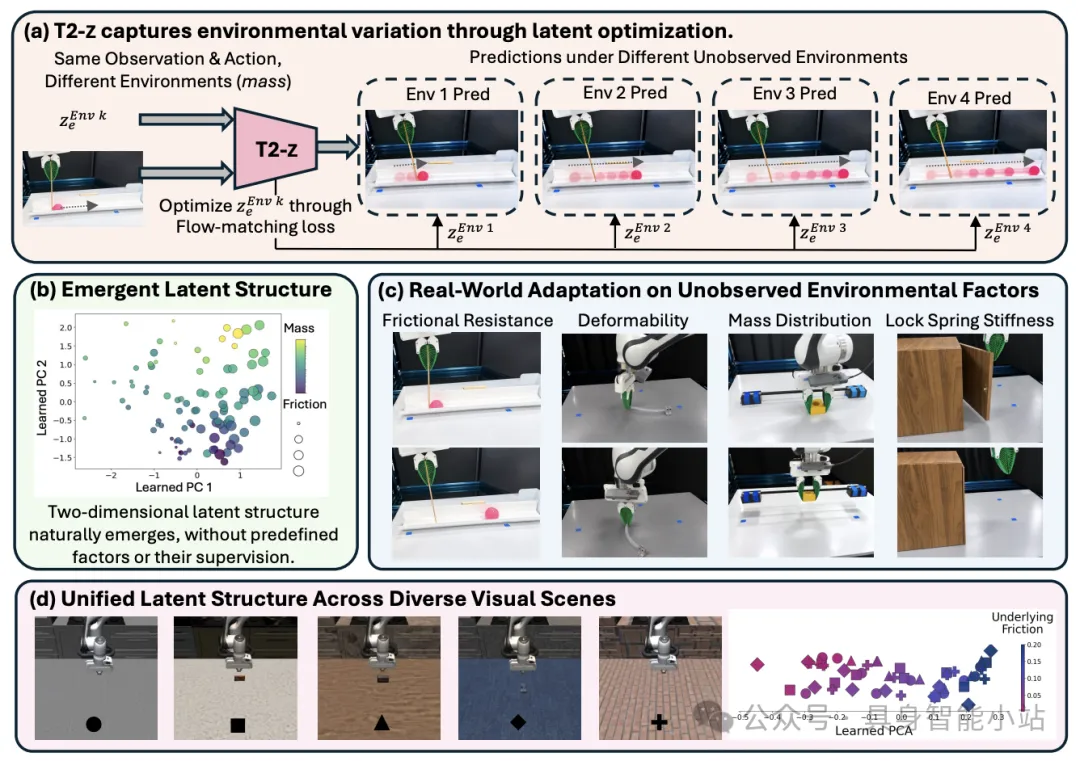
看点:外观相同的物体,摩擦和质量不同也会产生不同结果。T2-z让世界模型通过少量交互调整环境潜变量,测试时保持主模型冻结,为隐藏环境变化提供轻量适配路径。
结果:适配对象是环境潜变量。训练时交替更新世界模型与潜变量;到新环境后,用一个或多个交互轨迹优化新潜变量,不需要知道隐藏因素的名称或真值。
论文:https://arxiv.org/pdf/2610.22364
代码:https://github.com/T2-z-latent-optimization/T2-z
项目页:https://t2-z-latent-optimization.github.io/
53 篇一眼扫完
下面每篇只保留一个判断,适合先收藏,之后按自己的研究方向回看。
04静态高分之外,测试执行中受扰
LIBERO-Pro2.0: A Benchmark for Evaluating the Robustness of Embodied Foundation Models
LIBERO-Pro2.0把静态变化和运行中干预纳入统一评测,覆盖环境、观测、动作及语言等维度;多类策略普遍退化,提示训练和验收都应检查扰动恢复。
论文:https://arxiv.org/pdf/2610.24587
资源:https://github.com/LIBERO-Pro-Team/LIBERO-Pro2.0
项目页:https://racingemperor.github.io/LIBERO-Pro2.0/
05目标图像好看,不代表机器人做得对
Goal Images Are Control Targets: Spatially-Grounded Goal-Image Synthesis for Robotic Manipulation
SGE-Goal先定位初始与最终编辑区域,再生成目标图像;固定下游策略比较发现,选对物体和终态比画面美感更关键,闭环证据目前来自仿真。
论文:https://arxiv.org/pdf/2610.24885
代码:https://github.com/Riddhi-Chatterjee/SGE-Goal
项目页:https://riddhi-chatterjee.github.io/SGE-Goal/
06压缩重复去噪的动作专家
MambaAct: Efficient Mamba Action Experts for Flow-Matching Vision-Language-Action Models
MambaAct保留视觉语言骨干,以紧凑Mamba专家和上下文压缩生成动作;多种子仿真与真机显示延迟收益,去噪部分的加速不应等同整机控制加速。
论文:https://arxiv.org/pdf/2610.22951
代码:https://github.com/giakhuyendihoc/MambaAct
07把价值历史当作任务进度记忆
Value as Memory: Online Value-Guided Post-training for General Robot Policies
VaM缓存近期价值预测来缓解部分可观测,并将离线训练接到在线强化学习;真实长任务支持适应收益,价值记忆增益与在线更新增益需分别比较。
论文:https://arxiv.org/pdf/2610.22368
代码:https://github.com/Virlus/vam
项目页:https://virlus.github.io/vam/
08从互联网视频学习局部导航
ScaleNav: Scalable Internet Video Pretraining for Language-Conditioned Local Navigation
ScaleNav先从第一视角视频学习目标导向的视觉变化,再用仿真动作对齐导航策略;有四足真机验证,但研究范围是初始画面可见目标的局部导航。
论文:https://arxiv.org/pdf/2610.25690
代码:https://github.com/MachEmbodied/ScaleNav
项目页:https://zju3dv.github.io/ScaleNav/
09双手灵巧能力,分轴测而非只看均分
BiDex-100: A Comprehensive Benchmark for Bimanual Dexterous Manipulation Across 100+ Simulation Tasks
BiDex-100用双臂多指手任务分别测记忆、长程、指令、少示范和泛化,并配对域内外布局;统一评测多种VLA,结果仍属于刚体仿真范围。
论文:https://arxiv.org/pdf/2610.25459
代码:https://github.com/robbyant-research/BiDex-100
项目页:https://robbyant-research.github.io/BiDex-100/
10视觉计划要有用,也要走得到
Dream What I Can: Sparse Visual Planning for Long-Horizon Robot Manipulation
DreamCan从无动作视频中选择兼顾可达性和进度的稀疏子目标,再交给低层策略执行;仿真与双臂实验证明分层价值,生成画面仍需执行能力支撑。
论文:https://arxiv.org/pdf/2610.24981
代码:https://github.com/HeegerGao/DreamCan
项目页:https://dreamcan.github.io/
11短视频训练,减轻长滚动漂移
Fréchet Forcing: Training Long-Horizon Streaming World Models from Short Clips
Fréchet Forcing用真实短片段的统计约束自生成历史,无需额外教师或长视频;两类视频世界模型实验显示漂移减轻,但不等于长期物理一致性。
论文:https://arxiv.org/pdf/2610.25666
代码:https://github.com/zhao-yian/Frechet_Forcing
项目页:https://zhao-yian.github.io/Frechet_Forcing
12不看也能装配,但要先接触到工件
Blind Precise Assembly: Proprioceptive Sim-to-Real Peg-in-Hole for Diverse Parts
仅用关节位置、速度和动作历史学习精密装配,插销策略从仿真迁移真机;突出本体感知的接触价值,但策略从已接触工件开始,属于最后一段局部技能。
论文:https://arxiv.org/pdf/2610.23849
代码:https://github.com/younghyopark/mjfit
项目页:https://younghyopark.me/blind-proprioceptive-assembly/
13每只机械臂一个VLA,显式交换协作信息
VLA-Fabric: Learning Interaction for Composable Multi-Arm VLA Agents
VLA-Fabric保留各臂独立感知和动作输出,在模型内部学习跨策略通信;两种架构及三、四臂任务验证协作,强调通信机制需要随骨干重新实现。
论文:https://arxiv.org/pdf/2610.23018
代码:https://github.com/NEBULIS-Lab/VLA-Fabric
项目页:https://nebulis-lab.com/VLA-Fabric/
14GPU批量计算,也要降低单批延迟
CusADi2: Latency-Optimized Batch Computation of Robot Kinematics, Jacobians, and Hessians on the GPU
CusADi2在批次内部继续并行计算运动学及其导数,面向在线规划的低延迟需求;覆盖多种机器人和控制示例,优势随批量大小与计算图结构变化。
论文:https://arxiv.org/pdf/2610.25476
代码:https://github.com/johnviljoen/cusadi2
15规划器公平比较,先共用碰撞后端
PrismPlan: A Shared GPU Substrate for Motion Planning Across Paradigms
PrismPlan把采样、搜索和优化接到同一GPU运动学与碰撞计算底座;统一预算下比较多种规划器,结果揭示维度和问题类型会改变算法取舍。
论文:https://arxiv.org/pdf/2610.23884
代码:https://github.com/XiaoyubotMotionTeam/PrismPlan
16把日常接触技能做成可复现任务
ContactBench 1.0: A Benchmark for Everyday Contact-Rich Robotic Manipulation
ContactBench 1.0用可打印物体与可调阻力仿真覆盖日常接触技能;六项实测任务中,加入触觉未带来明显提升,提示传感器与策略利用能力需分别评估。
论文:https://arxiv.org/pdf/2610.24512
项目页:https://jingyi-xiang.github.io/contactbench/
17修好技能之间的交接,再复用整套程序
Learning to Compose: Recursive Self-Improvement of Shared Executable Stacks for Zero-Shot Long-Horizon Robot Manipulation
Recursia根据失败轨迹修复共享工具、技能契约和验证器,再冻结程序栈测试新组合;仿真与真机支持组合迁移,源端诊断仍依赖可获得的状态证据。
论文:https://arxiv.org/pdf/2610.24464
代码:https://github.com/cocacola-lab/Recursia
项目页:https://cocacola-lab.github.io/Recursia-website/
18把失败经验写成工具,再冻结测试
HexaShell: A Thin Harness for Exploring the Limits of VLM Agents as Robot Coding Agents
HexaShell让编码智能体从RGB观测诊断失败并迭代工具,随后冻结代码评测新布局;仿真显示可复用程序的价值,紧配合插入等接触执行仍明显受限。
论文:https://arxiv.org/pdf/2610.23479
代码:https://github.com/HexaFuture/HexaShell
19语言规划与世界动作模型共享任务进度
LAW: Unifying Language, Action, and World Modeling for Agentic Physical Intelligence
LAW用语义子任务连接规划、动作打分和异步完成判断,并维护时序记忆;双臂仿真及长任务真机验证闭环收益,复现需计入标注和多组件训练成本。
论文:https://arxiv.org/pdf/2610.23334
代码:https://github.com/hey-cjj/LAW
项目页:https://hey-cjj.github.io/LAW-project/
20具身基准高分,离实际部署还有多远
Has GPT-6-Astra Achieved Embodied Intelligence?
报告在上下文示范和扩展步数下测通用模型,并比较控制框架与真机表现;提示基准能力需连同耗时、示范成本及失败恢复衡量,不能直接等同实用具身智能。
论文:https://arxiv.org/pdf/2610.22471
代码:https://github.com/OpenSenseNova/SenseNova-RoboRSI
项目页:https://www.sensenova.ai/has-gpt-6-astra-achieved-embodied-intelligence
21用机械臂自身的深度感知绕开遮挡
ESCAPE: Egocentric Sensing for Collision Avoidance and Policy Execution
ESCAPE聚合分布式近场深度,以流匹配生成避障轨迹,仿真训练后迁移真机;适合检查外部相机依赖,当前实验主要是单臂静态杂乱环境到达。
论文:https://arxiv.org/pdf/2610.23943
代码:https://github.com/weiqingshen/ESCAPE
项目页:https://escape-policy.github.io/
22深度不可靠时,动作别把坐标当真值
Noise-Invariant Spatial Encoding for 3D Manipulation Policies under Depth Corruption
NISE结合跨视角监督和带位置不确定性的注意力,应对缺失深度与错误表面;仿真及透明、反光物体真机验证,但多视角共同错误仍难消除。
论文:https://arxiv.org/pdf/2610.24674
项目页:https://nise-robotics.github.io/
23从运动规划反馈学出隐藏前提
REAP: Learning General Rearrangement Heuristics from Motion-Planner Feedback
REAP让关系图网络学习哪些符号动作在几何上可行,再指导搜索减少规划调用;仿真验证物体数和布局泛化,仍假设符号状态已知且动作空间离散。
论文:https://arxiv.org/pdf/2610.23973
代码:https://github.com/elicited-preconditions/reap
项目页:https://elicited-preconditions.github.io
24物体靠近或分散,抓取策略分别处理
MoDex: Towards Universal Multi-Object Dexterous Grasping
MoDex学习参考轨迹的残差,按物体距离选择一次抓取或顺序交互;未见物体及真机迁移展示潜力,目前主要验证双物体,现实表现仍落后于仿真。
论文:https://arxiv.org/pdf/2610.23888
代码:https://github.com/Aurora-Xiong/MoDex
25盲转保定球,触觉要和硬件一起对齐
No Eyes, No Problem: What Does Touch Contribute to Blind Baoding Ball Manipulation?
用本体感知和二值触觉控制灵巧手转球,通过耦合建模、触觉校准与随机化迁移真机;重复试验支持触觉价值,最长单次纪录不能替代平均表现。
论文:https://arxiv.org/pdf/2610.23438
代码:https://github.com/elle-miller/roto/tree/s2r
项目页:https://noeyesnoproblem.github.io/
26不改模型权重,按时机纠正动作
SteerAct: Unlocking Action Models through Few-Shot Temporal Steering
SteerAct从成功与失败轨迹筛选稀疏特征,再按时序模式决定干预方向和强度;仿真与真机支持少样本适配,但需要访问模型隐状态和预训练编码器。
论文:https://arxiv.org/pdf/2610.25632
代码:https://github.com/kaichen-z/SteerAct
项目页:https://steeract.github.io/
27给人形机器人增加一条可协同的手臂
Humanoid SRL: Augmenting Humanoids with Supernumerary Limbs for Coordinated Loco-Manipulation
Humanoid SRL研究额外机械臂如何扩大支撑和操作空间,用轨迹优化指导强化学习全身协调;两种安装配置有硬件验证,自主视觉执行覆盖选定任务。
论文:https://arxiv.org/pdf/2610.25628
项目页:https://humanoid-srl.github.io/
28人形动作跟踪,也要回到世界坐标目标
BeJEPA: A Goal-Conditioned Humanoid Behavior World Model via Unsupervised RL
BeJEPA联合学习一步物理预测与长期行为表示,把姿态、位置和朝向纳入同一目标;仿真跟踪与G1扰动恢复展示价值,无需进行长串想象滚动。
论文:https://arxiv.org/pdf/2610.23127
项目页:https://ylyem9x.github.io/BeJEPA-project/
29让编码智能体设计可检索的空间记忆
Spatial Memory by Agents, for Agents
在固定预算内迭代记忆构建与检索代码,冻结后面向未见历史回答多类问题;跨任务比较展示设计潜力,但定位证据、完整计数和物理终点核验仍会失败。
论文:https://arxiv.org/pdf/2610.22736
项目页:https://ba-fa-3344.github.io/
30分清负载与人手推力,再调整阻抗
Multimodal Interaction Estimation for Contact-Aware Adaptive Impedance Control
融合力历史与三维点云识别交互类型,再选择负载补偿或柔顺响应;单臂、模仿策略和双臂实验验证适配,负载与推力同时出现时会延后补偿。
论文:https://arxiv.org/pdf/2610.24235
项目页:https://contact-aware-adaptive-impedance.github.io
31预测越野运动时,查询车将到达的地形
Structured Perception Representations for Off-road Dynamics Learning
SpatialBEV随预测状态查询局部鸟瞰特征,让动力学模型显式利用地形结构;跨季节数据和高速实车验证,但更好的离线预测不总能直接转成闭环收益。
论文:https://arxiv.org/pdf/2610.22900
代码:https://github.com/castacks/spatial-bev-dynamics
项目页:https://theairlab.org/spatial-bev-dynamics/
32在已有动作附近探索,减少在线试错
Sample-Efficient Reinforcement Learning for Policy Improvement via Flow-Reversed Action Anchors
AnchorQ把参考行为反向映射成潜动作锚点,再局部采样并按价值细化;仿真与真机比较固定交互预算,收益依赖参考动作覆盖和评论器判断准确度。
论文:https://arxiv.org/pdf/2610.22852
项目页:https://anchorq-rl.com/
33慢速想路线,快速跟上最新观测
HAVANA: A Hierarchical Video-Action Model for Vision-Language Navigation
HAVANA把语言条件潜计划与反应式局部轨迹分开,异步运行以减少重复预测;导航基准及不同形态实机展示效果,推理阶段无需生成未来视频。
论文:https://arxiv.org/pdf/2610.24122
代码:https://github.com/Anastasiawd/HAVANA
34显微重建先拍清楚,再生成三维
MicroSplat: Towards Automating 3D Small-Scale Reconstruction
MicroSplat用机械臂搭载消费级显微镜,自动规划视点、焦点堆叠与分割后重建高斯场;真实和合成实验显示主动获取清晰图像的价值,流程仍较耗时。
论文:https://arxiv.org/pdf/2610.23899
项目页:https://microsplat.github.io/
35不直接合并权重,而是按任务生成技能
NestedVLA: Learning to Consolidate and Generate Skills for Vision-Language-Action Models
NestedVLA用超网络生成动作专家参数,并单独保存压缩的视觉语言残差;三个仿真基准支持减少技能冲突与存储,尚不能视为任意新技能的零样本组合。
论文:https://arxiv.org/pdf/2610.23271
代码:https://github.com/WanyuGroup/NeurIPS2026-NestedVLA
36路径规划同时考虑平移与旋转难度
Shape-Aware Neural Time Fields for Rigid-Body Motion and Manipulation Planning
Shape-NTFields学习形状相关到达时间场,再结合采样规划穿过障碍;二维、三维和真实闭环推动验证重规划效率,训练仍按形状与环境配置进行。
论文:https://arxiv.org/pdf/2610.22762
代码:https://github.com/Ymz2006/Shape-NTFields
37让教师真正接管失败后的恢复
TILDE: Teacher-in-the-Loop Distillation from Embodied Foundation Models
TILDE同时学习示范、学生访问状态和教师恢复轨迹,用奖励模型触发接管;三项真机任务展示蒸馏收益,避免只在成功示范分布上模仿教师。
论文:https://arxiv.org/pdf/2610.25376
项目页:https://hku-sail.github.io/TILDE/
38双腕世界模型,要让两只手看到同一场景
UMI-WM: Interactive World Modeling for Bimanual Manipulation from Wrist Cameras
UMI-WM分别注入左右手动作,再用共享信息令牌协调双腕画面;以逆动力学评估动作跟随,蒸馏减少生成步骤,但视频逼真和动作可靠仍需分开看。
论文:https://arxiv.org/pdf/2610.23913
项目页:https://www.lv-lab.org/umi-wm/
39世界模型预测位姿,保持刚体形状
ORD-WM: Learning Object-Centric Rigid Dynamics for 3D World Modeling in Robotic Manipulation
ORD-WM把物体形状编码为几何潜表示,再解析施加预测的刚体运动;仿真与真实闭环推动展示几何保持,目前不覆盖铰接物体、柔性形变和复杂高速动力学。
论文:https://arxiv.org/pdf/2610.23156
项目页:https://hitsz-wyy.github.io/ORD-WM/
40哪里跑酷失败,就生成针对性训练地形
FCTS: Failure-Guided Curriculum Tree Search Over Generated Terrain for Legged Parkour
FCTS用失败位置、终止原因和局部几何驱动地形生成,再搜索课程路径;重建场景留出测试和真机课程展示泛化,尚非真实灾害现场的全面验证。
论文:https://arxiv.org/pdf/2610.22619
项目页:https://narayananpp.github.io/fcts/
41完成任务之外,还要符合使用者偏好
LIBERO-PeRM: Benchmarking Personalized Robotic Manipulation
LIBERO-PeRM分别评估任务完成与偏好满足,测试少示范学习、泛化、组合和冲突;仿真显示微调可学到偏好,但隐含、变化中的真实用户偏好尚未覆盖。
论文:https://arxiv.org/pdf/2610.22372
项目页:https://libero-perm.github.io/
42成功率变高,不能证明记忆真的被使用
Beyond Success Rate: Interventional Evaluation of Memory in Vision–Language–Action Systems
IMEP在检索接口替换事实、保留事实或施加微小数值扰动,分开判断决策与执行;ChainBench补充历史依赖任务,强调用事实特异性证据验证记忆作用。
论文:https://arxiv.org/pdf/2610.23372
项目页:https://anonymous.4open.science/r/IMEP-ChainBench-DC83/
43大场景重建,同时约束几何与显存
SpaRV: Sparse Radiance Voxels for Scalable Geometrically Consistent LiDAR-Visual Mapping and Rendering
SpaRV让激光深度和图像共同监督稀疏辐射体素,交替校正相机参数,并用分层子图控制显存;校园级重建验证规模,离轨几何也纳入评估。
论文:https://arxiv.org/pdf/2610.25665
资源:https://github.com/hku-mars/SpaRV
44给VLA补空间知识,避免表示坍缩
Relational Spatial Alignment for Vision-Language-Action Models
RIGID对齐特征之间的空间关系,而非逐点强迫匹配三维教师;仿真、空间推理与真机测试支持保留表达能力,收益仍受教师质量和微调数据限制。
论文:https://arxiv.org/pdf/2610.24705
项目页:https://qm-ipalab.github.io/RIGID
45把软物体和机器人的变化一起预测
DefFlow: Goal-Conditioned Deformable Object Manipulation using 3D Point Flows
DefFlow联合预测目标条件下的机器人与物体三维点流,用来学习抓取、释放和再抓取;绳索、颗粒、布料仿真及真机展示,目标输入仍需可用点云。
论文:https://arxiv.org/pdf/2610.22827
项目页:https://def-flow.github.io
46从人手交互学习接触如何变化
ACTS: Learning Visuo-Tactile World Models from Human Physical Interaction
ACTS把传感器运动与法向力变化作为共享动作,联合预测视觉和触觉;人类数据训练后出现机器人触觉迁移,但视觉迁移并不稳定,尚非闭环控制结论。
论文:https://arxiv.org/pdf/2610.24285
项目页:https://acts-anon.github.io/
47小模型导航,把感知证据交给结构处理
Structure over Reasoning: Unified Zero-Shot Navigation with a Small Vision-Language Model
把小VLM的方向判断累积到语义地图,再用图搜索和停止门控决定行动;统一预算仿真对照支持结构化设计,最强粗粒度基线差异的区间仍包含零。
论文:https://arxiv.org/pdf/2610.25130
项目页:https://anonymous.4open.science/r/structure-over-reasoning-PAGE
48速度指令之外,还能独立选择步态风格
Weakly Supervised Discovery of Motion Styles for Compositional Robot Control
CODES从运动记录中发现风格,再让控制器组合风格与独立速度指令;跨仿真器和四足真机展示迁移,风格保真与指令跟踪之间仍存在取舍。
论文:https://arxiv.org/pdf/2610.24008
项目页:https://www.proroklab.org/compositional-motion-styles/
49吸盘与平行夹爪,按任务阶段接力
Embodiment-Aware Planning for Heterogeneous Bimanual Manipulation
从单次人类示范给出的物体轨迹出发,联合规划双臂分工、抓取兼容和交接;真实异构末端实验验证互补性,但仍依赖物体模型与既定轨迹。
论文:https://arxiv.org/pdf/2610.23551
项目页:https://sukhvansh2004.github.io/Bimanual-Manipulation/
50四足机器人用脚完成魔方长序列
Solving a Giant Rubik’s Cube with a Quadruped Robot
用机载RGB-D恢复魔方位姿与颜色,再把解法转成翻转、固定和转层技能;真机完成连续求解,展示多步精细足部操作,证据规模仍较小。
论文:https://arxiv.org/pdf/2610.24610
项目页:https://leggedrobotics.github.io/rubik-skills/
51遥操作触觉更易懂,不等于完成更快
Evaluating Lightweight Contact Feedback in Dual-Operator Collaborative Humanoid Teleoperation
XRT为双人双人形协作提供指尖振动与声音接触提示;配对实验中振动更受认可,但完成时间和失败率未检出条件差异,练习效应不可忽视。
论文:https://arxiv.org/pdf/2610.24257
项目页:https://xrt-teleop.github.io
52用周期误差模型改善工业臂关节精度
Transmission Error Compensation for Industrial Robots Using Fourier Series
通过激光跟踪测量辨识速度相关傅里叶模型,再修正关节指令补偿传动误差;工业臂实验验证轴级改善,但负载、温度和整体运动学校准仍需另行处理。
论文:https://arxiv.org/pdf/2610.23882
项目页:https://doi.org/10.18419/DARUS-5760
53不测齿轮箱内部,也能估计润滑温度
Lubricant Temperature Observer for Gearboxes in Industrial Robots
用两状态热模型结合壳体温度观测器,估计工业机器人齿轮箱润滑温度;台架测量验证方法,为热误差补偿提供输入,静置时的润滑脂行为仍难建模。
论文:https://arxiv.org/pdf/2610.23881
项目页:https://doi.org/10.18419/DARUS-5015
54预测候选动作结果,再选择执行
LY-GWM-RoboCasa-Human300: Prediction-Guided Action Selection with a Graph Dynamics Model
LY-GWM给策略生成的候选动作预测未来图状态,再用奖励打分筛选;报告局部评测的有限改善,历史基线与官方复评来自不同口径,不能直接混比。
论文:https://arxiv.org/pdf/2610.23274
资源:https://github.com/SEIN-LYGWM/LY-GWM-RoboCasa-Human300-eval
55低成本采草莓,先解决细果梗接近与接触
Pedicel-Targeted Strawberry Harvesting via Imitation Learning on a Low-Cost Teleoperated Robotic Arm
用遥操作示范训练ACT,在边缘设备上复现接近、对齐和果梗接触动作;这是低成本农业操作的初步流程,论文尚未可靠完成果梗脱离,不能当作完整采收成果。
论文:https://arxiv.org/pdf/2610.22765
代码:https://github.com/nitin-dominic/autonomous_strawberry_pedicel_harvesting
56多加机器人,不一定让协作绘图更快
Task Structure and Scalability in Multi-Robot Authoring
把图画表示成笔画图,比较整块分配与块内拆分的多机器人执行;仿真显示收益取决于图结构和路由,速度提升并不随机器人数线性增长。
论文:https://arxiv.org/pdf/2610.22670
项目页:https://sites.google.com/view/multirobotauthoring/home
关注本号,持续跟进具身智能开源论文前沿动态。
整理不易,欢迎点赞、转发,留言交流。