11 种细胞分割方法,跑 15 套空间转录组数据、5 个平台、12 种组织。综合分最高的是 SAM,可它在 15 套数据里一次冠军都没拿到;拿冠军最多的是 BIDCell(6 次)和 Baysor(5 次)。把覆盖度算进分数,排名又换一遍。同一块小鼠脑换平台,星形胶质细胞的标记在 Stereo-seq 上找得回、在 MERFISH 上找不回——选错分割和选错平台,效果相当于把下游结论改一遍。为什么需要它
空间转录组跑完,第一件必须定的事是:这些转录本算给哪个细胞。这一步叫细胞分割,它决定后面所有的细胞类型注释、差异表达、细胞通讯。麻烦在于它没有标准答案——细胞挨得紧、边界糊,转录本又会在固定和透化时扩散到邻近区域,分错一点,整块组织的细胞组成就偏了。
工具已经有一大堆,路数却完全不同。图像派(Watershed、Cellpose、SAM 系列)只看形态,快,但碰上密集组织或边界不清就没办法;转录本派(Baysor、SCS、BIDCell)把表达分布一起纳入建模,慢、要调参,效果依赖参考数据。两边都说自己好,用户手上却没有依据。
过去的评测也不够用。多数只用图像数据比,没把转录本语境算进去;指标偏技术——分割出多少个细胞、覆盖多少转录本——跟「这个结果能不能支撑生物学结论」隔了一层。再加上没有跨平台的对照,没人说得清差异到底来自方法还是来自平台。
这篇要做的是把方法放进同一条管线、用同一套带生物学含义的指标、在多个平台和组织上比一遍,并回答一个更实际的问题:换方法、换平台,下游结论会不会跟着变。
方法是什么
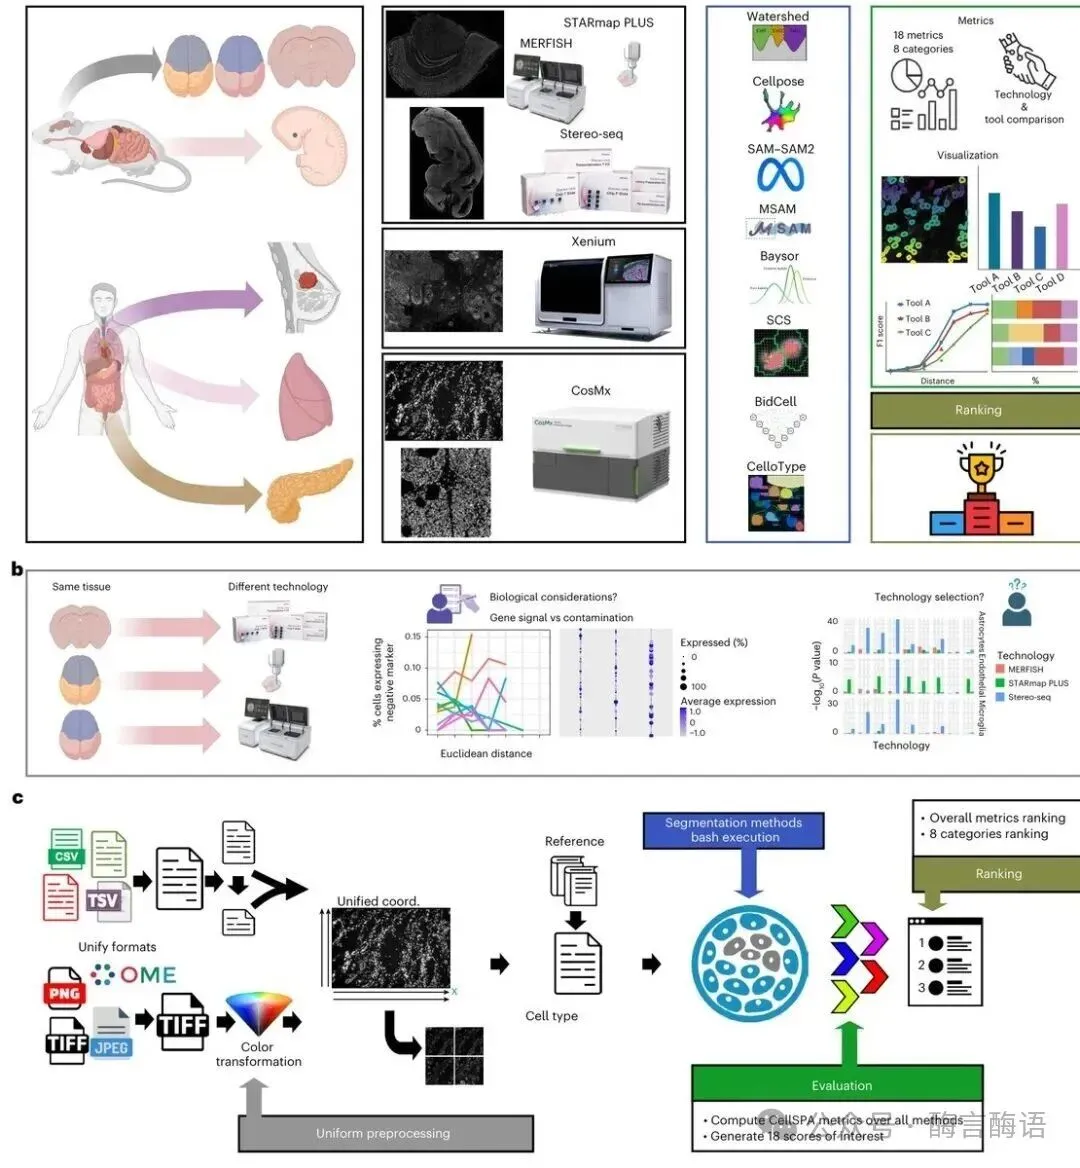
这套评测把 11 种方法放在同一条管线上跑:Watershed 是传统图像分割,Cellpose、SAM、SAM2、mSAM、Mask R-CNN、Swin-S 是纯图像的深度学习模型,BIDCell、SCS、Baysor 则把转录本一起纳入建模,CelloType 介于两者之间。数据来自 5 个平台——Stereo-seq、Xenium、CosMx、STARmap PLUS、MERFISH,覆盖 15 套数据集、12 种组织、2 个物种,细胞数从卵巢癌的约 700 个到前列腺癌的 80 多万个。
统一处理是这套评测最费工的部分。原文用一条 Nextflow 管线把格式、坐标、颜色全部对齐,再把图像和转录本切成 patch 分别分割、拼回原坐标,最后按最小转录本数和基因数过滤掉低质量细胞。参考真值来自 scRNA-seq 注释映射到空间数据,指标用 CellSPA 那一套:15 项,归成 8 类——总体特征、细胞级 QC、基因级 QC、形态、细胞组成相似性、表达纯度、空间多样性、UMAP silhouette。所有分数归一化到 0 到 1,另外再算一个按分割覆盖度校正的综合分。
这套设计的关键在于它同时做了两件事:横向比方法,纵向比平台。三项跨平台对照用的是同一块小鼠脑组织,分别在 Stereo-seq、STARmap PLUS、MERFISH 上做,只保留三种可靠注释的细胞(星形胶质、内皮、小胶质),这样方法差异和平台差异才分得开。
图:原文 Fig.1。a 是方法、平台、组织与物种的覆盖范围;b 是跨平台对照的设计,同一块脑组织换三种技术;c 是统一管线——格式统一、坐标对齐、切 patch、分割、拼回、算 15 项指标再排名。
主要优点
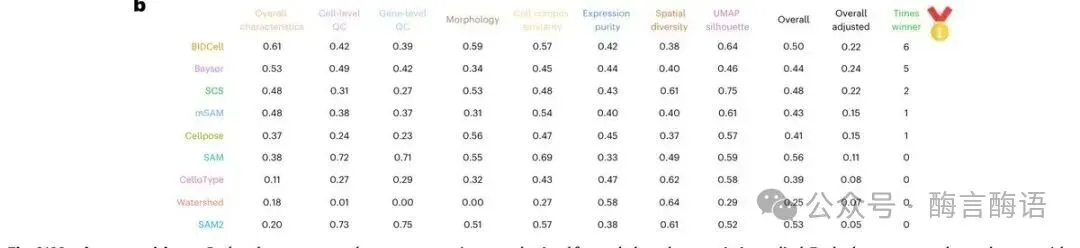
最值得看的是排名不稳。按综合分,SAM 领先,SAM2、BIDCell、SCS 跟在后面,Watershed 垫底。但换成「数据集冠军次数」,SAM 是 0,SAM2 也是 0;BIDCell 拿了 6 次,Baysor 5 次,SCS 2 次,mSAM 和 Cellpose 各 1 次。也就是说综合分最高的方法,在任何一个具体数据集上都不是最优解。
把覆盖度折进分数,排名再翻一次。SAM 的领先消失,BIDCell 和 Baysor 顶上来——它们的共同点是分割出的细胞多、而且质量没有明显滑坡。这件事对实际选择很要命:你要的是「每个细胞都测得准」还是「尽量多的细胞被测到」,答案不同,工具就该不同。
分类别看,各家的强项几乎不重叠。SAM2 在细胞级 QC 拿 0.73、基因级 QC 0.75,是全表最高,但它的分割覆盖度低,综合下来不占优;BIDCell 在总体特征上是 0.61;SCS 的空间多样性 0.61、UMAP silhouette 0.75 都是第一;Cellpose 的形态学 0.69 最高,可转录本层面偏弱。Watershed 和 CelloType 几乎在所有类别上都靠后。
平台带来的差异不比方法小。同一块小鼠脑,Stereo-seq 能把星形胶质细胞的标记基因找回来,MERFISH 找不回,还把表达撒到了不该有的细胞类型上;换成小胶质标记 Ctss,结论反过来。内皮标记则是 STARmap PLUS 最好。
污染还能量化。用负标记去测——内皮细胞里查星形胶质的 Igfbp5、小胶质里查内皮的 Flt1——某些条件下高达 10% 到 15% 的细胞带着不属于自己的转录本。分方法看,mSAM、CelloType、Baysor 的污染更低。配体-受体推断也跟着变:STARmap PLUS 和 Stereo-seq 给出的互作在空间上更收敛,MERFISH 明显更散。
图:原文 Fig.3b。看两列就够——Overall 是综合分,Times winner 是数据集冠军次数;SAM 综合分最高但冠军 0 次,BIDCell 与 Baysor 分别 6 次和 5 次。最右的 Overall adjusted 是按覆盖度校正后的综合分。
主要局限
参考不是真值。细胞类型注释和指标基准都来自 scRNA-seq 映射,参考本身有误差,所谓「准确」是相对这套参考而言,论文没有独立的分割金标准掩膜。
指标之间不独立,权重是人为的。15 项指标彼此相关,归成 8 类时用等权聚合,作者自己也说没有定义最优指标子集。换一套权重,排名还会变——这篇给的是「多口径都看一遍」的方法,不是一个绝对榜单。
patch 切分会截断跨界细胞,拼回来时无法完全复原,这对大细胞或边界不清的组织影响更大,而论文没有单独量化这部分误差。
基因集敏感性只做了一个数据集。黑色素瘤皮肤上比较 1,000 个高变基因与全基因集,结论是 BIDCell 稳、SCS 和 Baysor 有小幅变化;作者明确写了这只是初步敏感性分析,不能当普遍结论。
覆盖面有限。11 种方法、5 个平台、12 种组织,近两年基于基础模型的分割工具没有被纳入。运行时间和显存只在补充表里,没有进主排名,而转录本感知的方法普遍更慢——这个现实成本在榜单上看不到。
还有一个技术细节:正文与图 3b 的总体分存在小幅出入,按覆盖度校正的综合分在不同段落给出的数值也不完全一致。所以这篇适合用来判断「谁在哪一类强」,不适合抄一个分数去比较。
适用场景
如果图像质量好、细胞边界清楚、细胞类型在形态上就能分开,选 SAM 或 mSAM,转录本保真度高;mSAM 在污染控制上还更稳。
如果细胞形态高度一致、主要关心组织内的空间异质性和表达结构,选 SCS,它在空间多样性和 silhouette 上是第一。
如果要跨多种组织做一批数据、需要方法不掉链子,BIDCell 更稳,它的冠军次数最多,总体特征也最高。
如果目标是尽量多拿到细胞、能容忍边界略粗,看覆盖度校正后的分数,BIDCell 和 Baysor 都在前列,Baysor 的污染也低。
比选方法更早要定的是平台。MERFISH 信号强但背景和错分多,STARmap PLUS 与 Stereo-seq 的细胞类型特异性更干净;如果你的组织里有难分割的细胞类型,Stereo-seq 的可靠性会下降。同一批样本换平台,比同一平台上换分割方法,对下游结论的影响往往更大。
最后一条实操建议:在一个数据集上锁定分割方法后,别在后续样本里换。这篇最实在的结论是分割选择会改变细胞类型比例、污染水平和配体-受体推断——换方法等于换结论,跨样本比较时这一点比追求单次最优更要注意。