AI 教学
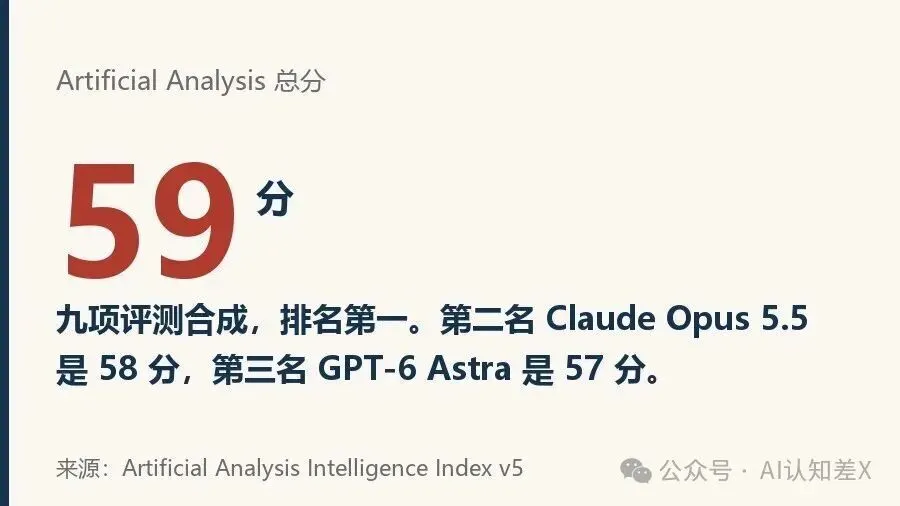
Google 刚发的 Gemini 4 Carbon,在一个榜上拿了第一。
59 分。比 Claude Opus 5.5 高 1 分。
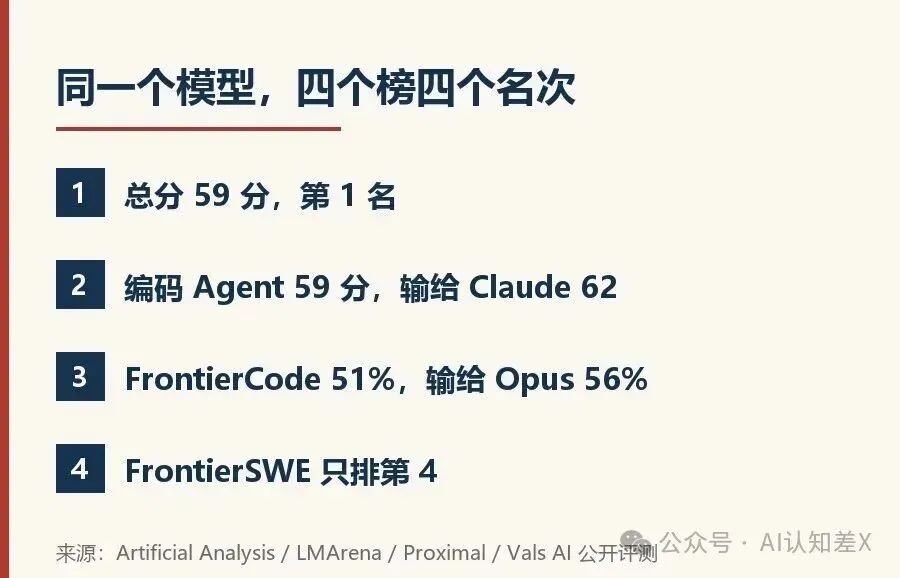
同一个模型,换一个榜,排第四。
61.2%。
Astra 65.5,Opus 62.3,连 Sonnet 的 61.9 都压过它。
模型没变。
变的是那道题。
读完你能拿走三样:· 一张「该看哪一栏」的对照表· 三个问题,照着问就能避开假第一· 一条判断线:总分什么时候能信
九项评测合成一个总分,叫 Intelligence Index。
Carbon 在九项里领先四项:HLE-Diamond、TB-Science、AA-Omniscience、AutomationBench。
它没领先的那几项,正好是写代码。
写代码叫 Coding Agent Index。
Carbon 是 59。Claude Code 配 Opus 5.5 是 62。
换到 FrontierCode,Carbon 51%,Opus 56%。
再换到 FrontierSWE,它连 Sonnet 都没跑过。
四个榜,四个名次。
它没有变差。
是你测的东西变了。
01 · 先看分项,别看总分
总分回答的是「这个模型强不强」。
你问的是「它能不能把我这件事干好」。
这不是同一个问题。
榜上有分项就点进去。
要写代码看 coding。要读合同看 legal research。
Carbon 在 Finance 和 Legal Research 两个分项都是第一。
真干这两件事,它强。
打开 Artificial Analysis 的模型页,把总分那一栏划掉,只看分项。找到跟你活儿对应的那一项,记下前两名。别的都不用记。
02 · 问清那个分是在什么工具里测的
Carbon 那个 59 分,是在 Google 自家的 Antigravity CLI 里测出来的。
当天有个开发者 Yuchenj_UW 在 X 上写道:「coding 的结果是在 Antigravity CLI 里测的,其他工具没测。」
同一个模型,换个工具套着跑,结果能差好几分。
你平时用 Cursor。
用 Claude Code。
用网页版。
本来就是三个成绩。
榜单只测了其中一个。
看到「某模型编码榜第一」,往下翻两句,找它用的什么工具。写的是厂商自家的命令行,你就当参考;写的是你正在用的那个,这个分才算你的。
03 · 把幻觉率当一票否决
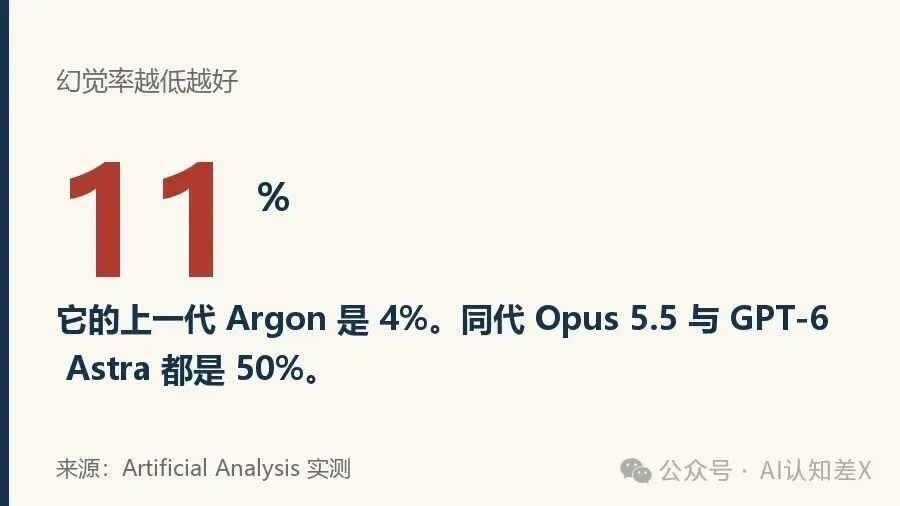
Carbon 的幻觉率是 11%。
上一代 Argon 是 4%。
越新,反而编得更多。
Opus 5.5 和 Astra 都是 50%。
11 和 50 差四倍多。
总分只差 1 分。
幻觉率差四倍。
哪个更该看,不用我说。
要它查资料、报数字、引原文,先看这一栏。
别急着兴奋:榜只测了它自己选的题
评测者 nrehiew_ 说了句更扎心的。
「这些分差,主要反映各家后训练时选择练什么,不是谁更聪明。」
翻成大白话。
Google 把力气花在科学和网络安全上。
Anthropic 花在代码上。
榜单只是把这个选择照了出来。
所以一个模型在你这件事上排第几,没有榜能告诉你。
你的题不在它那九项里。
唯一可信的测法,是自己跑。
你自己的三个真实任务,各跑两遍。
可以存一下
这周做三件事。
一,把你想让 AI 替你做的那件事写下来,一句话。
二,去榜单找跟这句话对应的那一栏,只看那一栏。
三,同一件事用两个模型各跑一遍,记下哪个你改得更少。
改得少的那个,就是你的第一。
榜单告诉你它平均有多强。
你的活能不能干,得你自己跑一遍。
配图说明:四张插图均为本文自制信息图,数据取自 Artificial Analysis、LMArena、Vals AI 等机构的公开评测结果,图内已标注来源。
风险提示:文中分数为第三方机构在特定测试集上的公开结果,会随模型版本变动,不构成对任何模型的性能承诺。同一模型在不同工具、不同提示词下表现可能有明显差异,请以你自己的实际任务为准。