Sam Kouteili等七名研究者提出了DeoGen,一套自动生成政策推理测试题的方法。它要解决的问题是:当语言模型需要依据明确规则作出判断时,怎样以较低的人工成本,系统检查它是否真的遵守了规则。
作者在2026年10月28日提交至arXiv的论文中报告:面对信息充分、可以推出明确结论的样本,受测前沿模型的正确率为89%至92%;面对信息不足、本应暂缓判断的样本,正确率只有22%至40%。即使研究者明确要求模型在证据不足时不要下结论,表现仍然较差。
这组结果提示,模型能否得出答案与能否判断“现在还不能回答”,是两种不同的能力。DeoGen的主要进展,是让后一种能力可以被批量测试。不过,现有材料还不足以证明这些实验结果能够直接代表真实法规和受监管业务中的风险水平。
政策推理不只要求答对,还要求知道何时不能判断
论文研究的是“规范推理”,即模型根据给定规则和事实,判断某个行为是否被允许、禁止或要求执行。模型不能只凭常识选择一个听起来合理的答案,还要检查规则的适用条件是否全部满足。
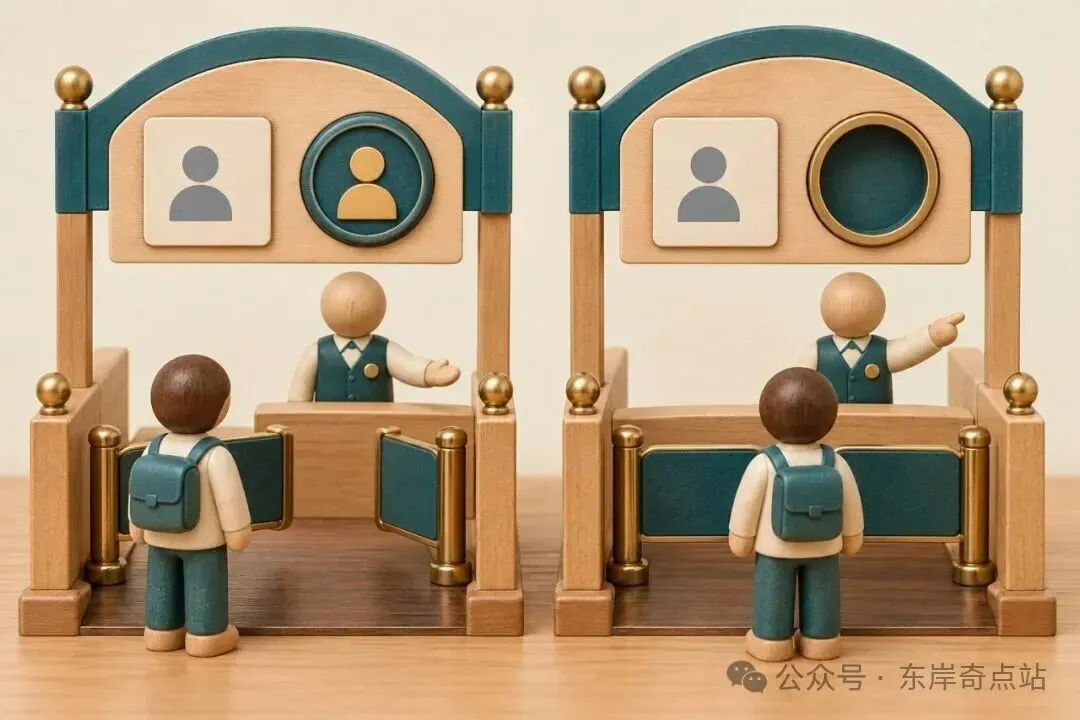
比如可以设想一条规则:“完成身份核验的申请人可以办理某项业务。”如果材料明确说明申请人已经完成核验,模型可以继续判断;如果材料没有提供核验状态,正确做法应是指出信息不足,而不是猜测结果。
这也是政策推理与普通问答的重要区别。在规则约束较强的场景中,一个没有依据的确定答案,可能比明确拒绝判断更难被及时发现。评测因此不能只统计模型选对了多少次,还要检查它能否识别缺失的关键事实。
现有这类数据集大多依靠人工编写。人工设计便于控制题目,但扩大数量、覆盖更多规则组合以及系统构造信息不足的情形,都需要持续投入。DeoGen试图把这部分工作自动化。
从政策规则到决策树,一组规则可以生成多条测试路径
DeoGen先把自然语言政策自动转换为一阶逻辑。这里的一阶逻辑,可以理解为把“谁在什么条件下可以、必须或不得做什么”表示成机器能够处理的规则关系。
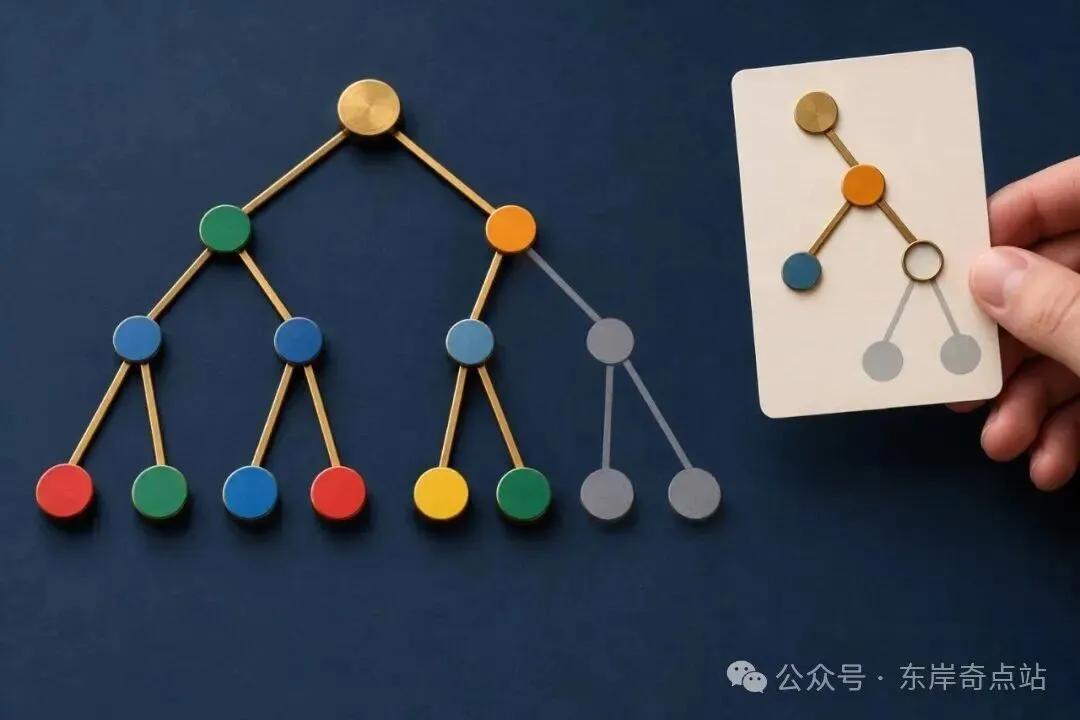
系统随后根据这些规则建立决策树。树上的分支对应不同事实组合,每一条路径都可以转化为一条测试样本。走到叶节点,表示已有事实足以推出结论;停在非叶节点,则表示仍有关键条件未知,模型应当暂缓判断。
这种方法带来两项变化。第一,研究者不必逐题手写,同一棵树可以产生多条路径。论文摘要称,生成数量会随着树的深度出现组合式增长,但现有材料没有给出具体公式或数据集规模,因此只能确认这种方法具有扩展潜力。
第二,评测者可以分别生成“信息充分”和“信息不足”的样本。这样既能测试模型是否会沿规则推出结论,也能测试它是否知道推理条件尚未齐全。后者正是本次实验中表现较弱的部分。
89%至92%的答对率,没有覆盖最难的判断
在能够推出明确结论的样本中,受测前沿模型正确率达到89%至92%。这说明模型在DeoGen构造的规则环境里,能够完成大部分有确定答案的任务。
但信息不足样本呈现出明显不同的结果。此时,正确行为不是选择允许、禁止或必须,而是承认现有事实不足以支持判定。模型在这类样本上的正确率仅为22%至40%,明确的拒答指令也没有消除问题。
由此可以作出的有限判断是:在论文采用的实验设置下,受测模型较难稳定识别证据缺口。它们可能能够依据已有条件寻找结论,却不能同样可靠地确认所有必要条件是否已经出现。
不过,现有材料没有列出受测模型名称、样本数量、评分细则、重复实验、统计区间和提示词变化测试。因此,这两组正确率只能视为作者在特定实验中的报告,不能推广为所有前沿模型或所有政策任务的普遍表现。
自动生成扩大了规模,也可能留下可利用的线索
程序化生成测试题有一个需要单独验证的问题:模型究竟学会了目标能力,还是抓住了生成器反复留下的表面模式?
同日提交的一项CLadder因果推理基准研究显示,这种担忧并非纯粹假设。研究者发现,该生成器产生的数据含有预测性较强的表面模式;随机森林等较简单的模型在接触部分生成数据后,也能取得较好成绩。部分商业语言模型即使看不到对形式推理很重要的大段文字,表现也几乎不受影响。研究者因此认为,在断言模型具备复杂因果推理能力之前,必须先排除它利用生成模式的可能性。
这项研究不能证明DeoGen存在同样的问题,但说明自动基准需要接受额外检验。关键问题包括:自然语言政策是否被准确转换成逻辑规则,生成标签是否经过人工或形式验证,不同类别的样本是否存在明显的措辞和长度差异,以及改写规则、调整提示或更换政策领域后,结果能否保持稳定。
现有材料没有说明DeoGen是否完成了这些检验。因而,较高的确定性样本正确率不能单独证明模型掌握了政策推理;较低的信息不足样本正确率,也不能在排除生成器特征、提示敏感性等因素之前,被直接解释为真实业务中的固定错误率。
这是评测工程的扩展,不是现实合规能力的证明
DeoGen目前最明确的价值,是把“模型能否在证据不足时停止判断”变成一种可以系统生成和重复测试的任务。它扩大了政策推理评测的生产方式,也把拒绝无依据结论从附带要求变成了独立考查对象。
它尚未覆盖的,是现实制度中的复杂性。真实规则可能包含交叉引用、例外条款、模糊概念和时间效力,输入事实也可能相互矛盾,而不只是缺少某个条件。把这类政策准确转换成逻辑规则,本身就可能涉及专业解释。现有材料没有证明DeoGen已经处理了这些情况。
因此,DeoGen更接近一项可扩展的评测工程进展,而不是模型已经具备现实合规能力的证明。它所报告的结果支持一个值得继续检验的判断:模型不仅需要学会按规则作答,还需要学会在条件不足时停止作答。
后续若要提高这一判断的可信度,需要看到生成过程和数据能够公开复现,自动形式化与标签得到独立验证,模板线索等替代解释被排除,并在不同领域的真实政策文本上重复得到相近结果。在这些证据出现之前,DeoGen最适合说明评测应增加什么,而不能单独回答模型能否安全进入受监管场景。