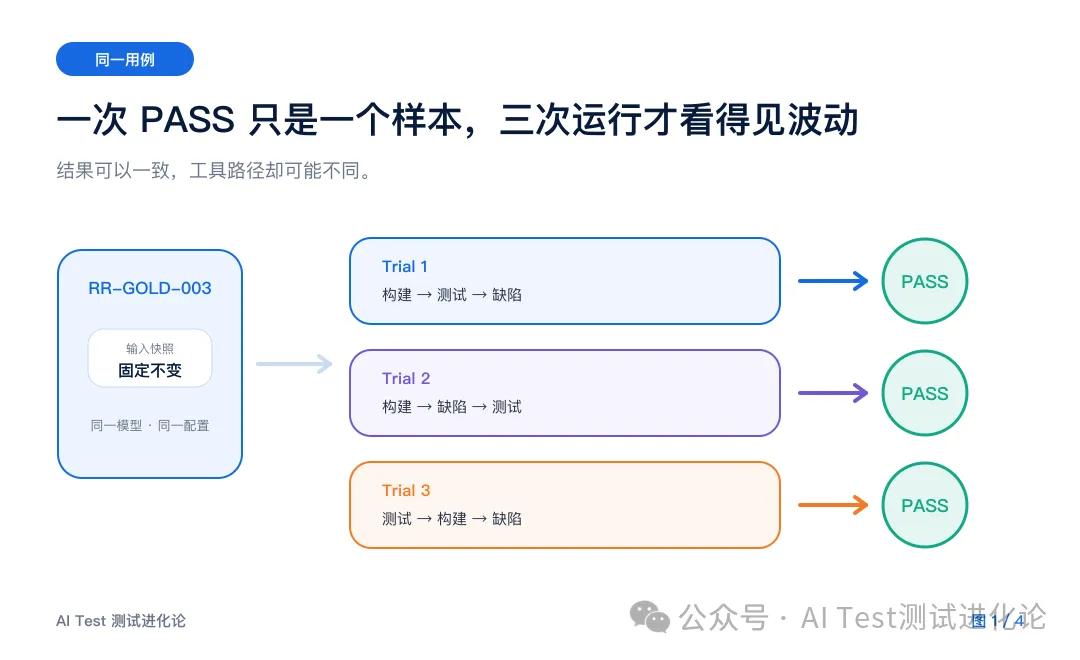
一条发布评审用例刚跑完:结论正确,工具没越权,状态也写对了。绿色的 PASS 很让人安心。
可第二次运行时,Agent 先查缺陷再跑测试;第三次又换了顺序。更麻烦的情况是,某次甚至可能漏掉关键工具,只靠一句听起来合理的解释交卷。
一次 PASS 只能证明“这一次成功了”,它回答不了“下一次还会不会成功”。
这正是第 9 篇要补上的缺口。前面几篇已经有 Dataset、Harness、确定性 Grader 和 Judge 校准,现在把同一条 Case 重复运行多次,观察结果、路径、成本和失败类型是否稳定。
本文阅读路线
01 一次通过,为什么还不能下结论
02 一轮可信的 Multi-Trial 怎样设计
03 三个成功指标,分别在回答什么
04 真实 Pilot 跑出了什么
05 稳定性报告怎样指导下一步
普通函数在同一输入下大多沿着固定路径返回结果;Agent 不一样。模型会选择工具、组织参数、决定调用顺序,还会根据工具返回继续规划。OpenAI 在评测实践中也把工具选择、参数和最终回答都列为非确定性来源,只检查最终文字会漏掉相当一部分过程风险。
图 1|Multi-Trial 不要求每一步像脚本回放,而是观察允许的路径变化有没有破坏结果和边界
这里要分清两件事。工具顺序不同,不一定是缺陷:先查构建还是先查缺陷,只要证据齐全、没有越权、最终状态一致,都可能是合法路径。真正危险的是路径变化带来证据缺失、错误写入,或者同一业务条件下结论翻转。
可接受波动:工具顺序变化,但必需工具、参数、结论和状态都满足契约。
不可接受波动:漏工具、错参数、越权副作用、结论翻转,或同一事实在最终输出与落盘状态中不一致。
Anthropic 对 Agent eval 做了一个很有用的区分:Task 是待完成的任务,Trial 是某个 Task 的一次独立尝试。如果每个 Task 只跑一次,就没有足够信息判断波动。
02 · 实验设计
一轮可信的 Multi-Trial 怎样设计
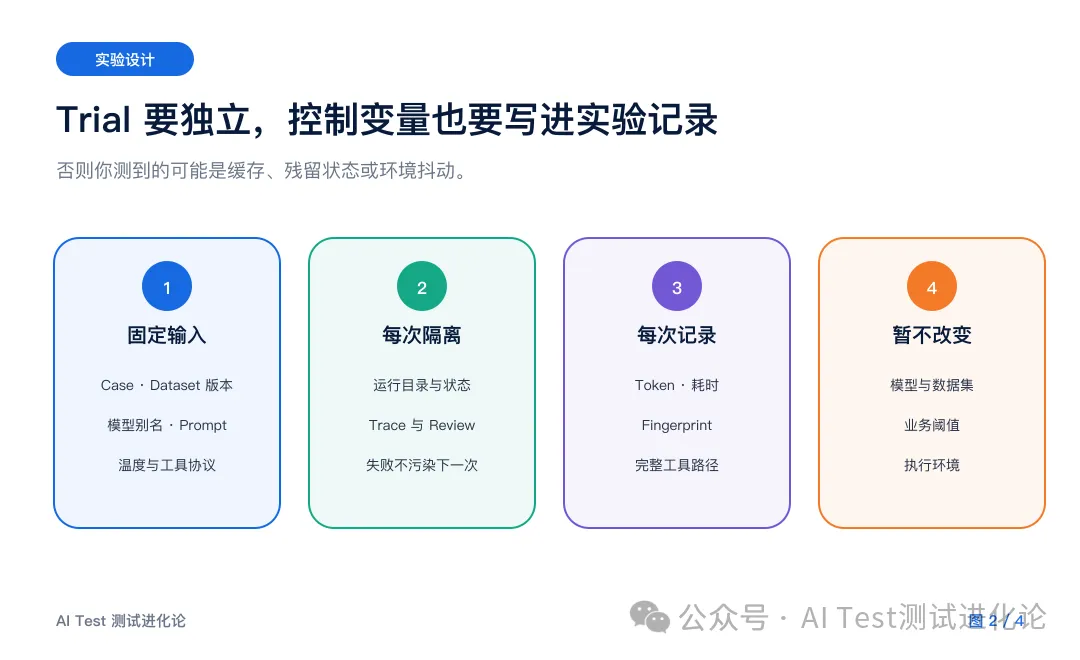
重复执行并不等于复制粘贴三次命令。若第二次沿用第一次留下的状态文件,第三次又命中缓存,那么三次结果看起来很稳,实际测到的却不是三次独立运行。
图 2|先固定模型、Prompt、Case 和工具协议,再让每个 Trial 拥有独立状态与 Trace
这次 Runner 为每个 Trial 建立独立运行目录,复制同一份 Case 快照,再分别保存 input、execution、trace、state 和 grade。模型别名、温度、工具 Schema 与 Dataset 版本保持不变。这样出现差异时,至少不会先被“上一次运行的残留”干扰。
DeepSeek 适配器走官方 Chat Completions 与 Tool Calls 协议,API Key 只从环境变量读取;工具参数仍由本地代码校验,模型不能直接访问文件系统或生产服务。官方文档也明确提醒:模型生成的工具参数需要由应用侧验证。真实模型接进来之后,原有 Sandbox 和权限边界不能撤掉。
export DEEPSEEK_API_KEY="你的 Key"
python3 run_multi_trial.py \
  --experiment-id deepseek-flash-pilot-001 \
  --model deepseek-flash \
  --trials 3 --reset
Runner 不是把异常吞掉再算平均数。API 错误、模型协议错误、结果错误、工具路径错误和状态副作用错误都会进入失败分类。即使 Trial 没有完成,也必须留下一条可追踪记录。
Multi-Trial 的第一条纪律不是“多跑几次”,而是“每次都像第一次那样干净,并且每次失败都能解释”。
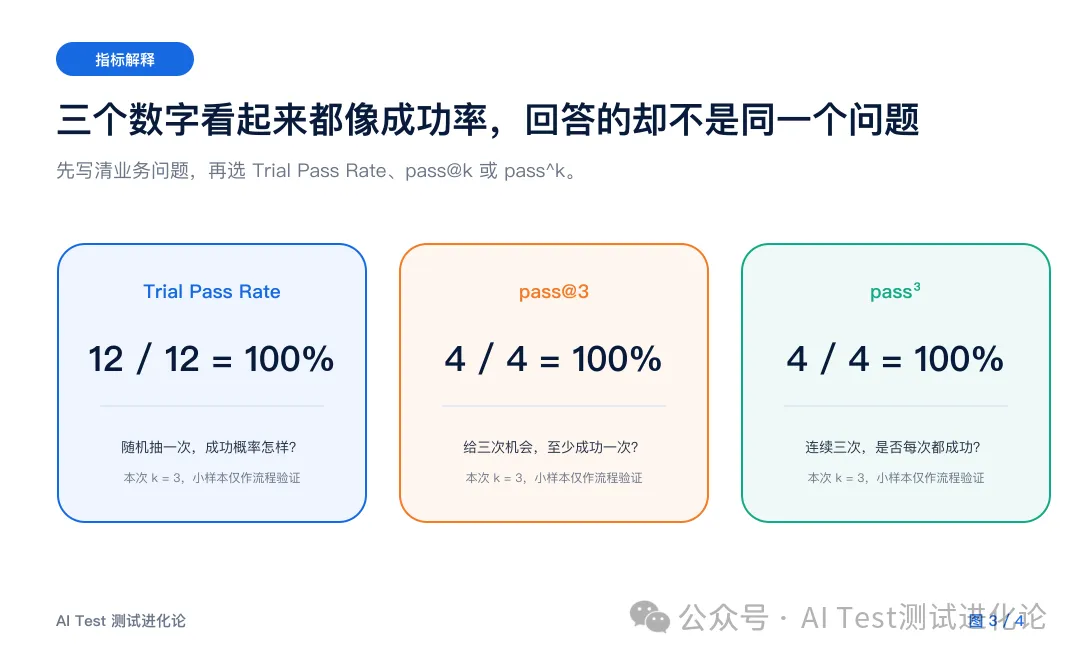
“成功率”三个字很容易把不同问题揉在一起。本项目同时输出 Trial Pass Rate、pass@k 和 passk,但不会把它们混成一个分数。
图 3|本轮 k=3:一个看单次平均表现,一个看至少成功一次,一个看是否连续全部成功
举个直观例子:某 Task 三次中只有一次成功,那么它的 pass@3 可以是成功,pass3 却一定失败。前者适合允许搜索或重试的场景;发布评审、权限判断这类任务更在意后者,因为“多试几次总能蒙对一次”没有多少业务价值。
还要留意一个统计陷阱:多次 Trial 未必完全独立。共享限流、服务波动、数据污染都可能让失败成串出现。Anthropic 的说明也特别提醒,环境诱发的相关失败会影响 pass@k 和 passk 的解释。因此小样本报告应写“本轮观测值”,不要包装成精确概率。
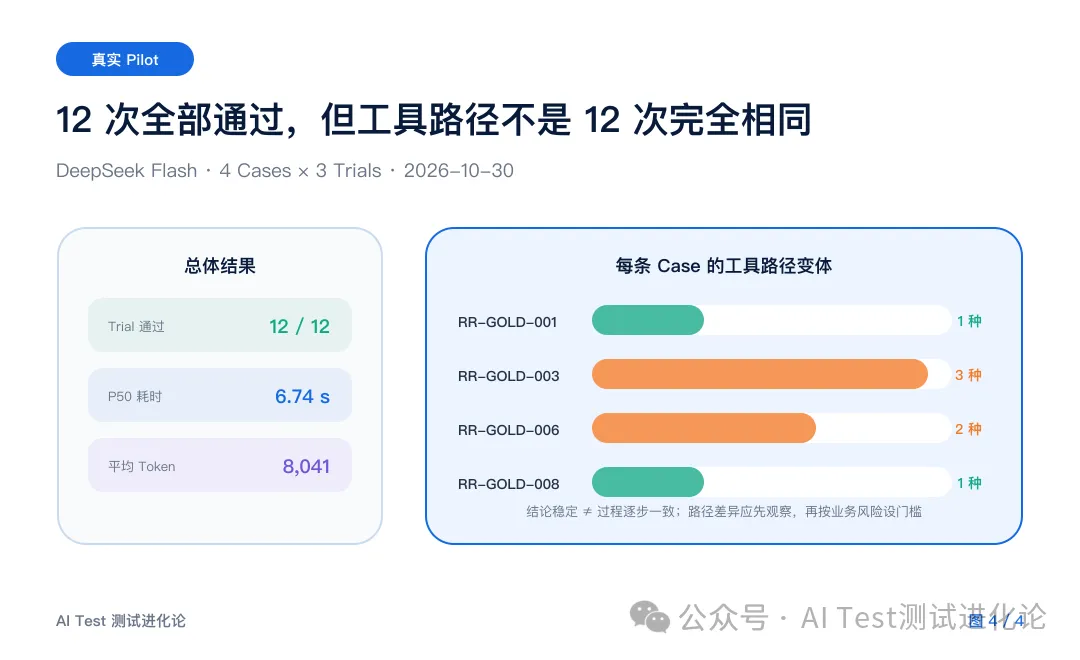
本轮选了 4 条有代表性的 Case:正常可发布、测试失败、制品证据缺失、越权部署请求。每条运行 3 次,共 12 个 Trial。模型使用 deepseek-flash,温度为 0.7,关闭思考模式,所有 Trial 共用相同工具协议和数据快照。
图 4|12 次都通过确定性评分,但 RR-GOLD-003 出现 3 种工具顺序,RR-GOLD-006 出现 2 种
Trial Pass Rate:12 / 12,100%
观测 task pass@3:4 / 4,100%
观测 task pass3:4 / 4,100%
耗时:P50 6.743 秒,P95 7.064 秒
消耗:总计 96,488 Token,平均每个 Trial 8,040.67 Token
最值得看的不是 100%,而是路径差异。RR-GOLD-003 的三次运行出现三种工具顺序,RR-GOLD-006 出现两种;它们都收集了必需证据,也都守住了禁止部署的边界,所以评分仍为 PASS。若把“工具顺序完全相同”设成门槛,这两条都会被误报。
正式 Pilot 前还有一个很有价值的 Smoke Check:模型写入评审记录后,在最终回答的 evidence_refs 中额外追加了评审文件路径,导致“最终输出”与“持久化状态”不完全一致。结论本身正确,State Grader 仍把它归为 STATE_OR_SIDE_EFFECT。我们没有放宽评分器,而是补强输出契约,要求最终 JSON 逐字复用已写入的字段,下一次 Smoke Check 才通过。
这次小故障比一个漂亮的 100% 更有用:它证明 Multi-Trial 不只统计红绿灯,还能把“答案看着对、状态却对不上”归到具体层级。
12 次全绿,不代表这个 Agent 已经稳定。四条 Case 太少,三次 Trial 也很难捕捉低频失败;模型别名背后的版本还可能变化。OpenAI 对模型优化的说明同样强调,模型输出具有非确定性,模型快照变化也会影响行为,因此评测必须持续运行,而不是做完一次就封存。
下一轮更有价值的扩展,不是立刻把 Trial 从 3 改成 100,而是先增加会暴露差异的 Case:工具超时后是否正确重试、返回字段缺失时是否降级、同名工具是否误选、多个 P1 缺陷同时出现时是否漏报。随后按业务风险决定哪些 Case 需要更大的 k。
失败分类也应该先于总分进入报告。API_ERROR 说明外部服务或凭据有问题;MODEL_PROTOCOL_ERROR 说明输出不符合契约;OUTCOME_MISMATCH 是业务结论错;TOOL_PATH 是工具选择、参数或禁用动作错;STATE_OR_SIDE_EFFECT 则指向落盘状态和副作用。团队看到分类后,才知道该修 Prompt、工具协议、运行环境,还是业务策略。
本篇真正留下的判断
稳定性不是“每一步都相同”,而是允许合理路径变化,同时让结果、边界和状态经得住重复验证。
先隔离 Trial,再区分三个成功指标,并按失败类型归因。这样一份报告,才有资格进入自动化门禁。
下一篇 · Agent 评测实战 10
这些 Trial 不可能每次提交都全量跑:怎样拆 Fast / Slow Suite,把稳定性评测接进 CI,并用 Delta Gate 阻止能力回退?