线上 RAG 回答用户说得头头是道,一查引用全是编的,你靠肉眼翻几条才发现问题?
检索换了 embedding 模型,回答质量到底升了还是降了,没人能给你一个数字。
Agent 把工单关了,可 API 调错了参数——这种「办了但办砸」的事,怎么量化、怎么拦?
这三件事的共同点:缺一把能反复用、能进 CI、能挡住回归的质量尺。下面这把尺子,读完你能直接挂到自己 pipeline 上。
四要素卡
场景:把 RAG / 工具调用型 Agent 应用(企业知识库问答、客服、文档抽取、跑工具的 agent)上线前和上线后,量化「检索回得对不对、答案有没有编造、工具调得准不准」,并接进 CI 当回归闸门。读者画像:RAG/Agent 应用工程师、评测负责人、ML 平台团队。真实采用方:任何用 LangChain / LlamaIndex / Haystack 的团队——RAGAS 被这些框架原生集成,是 RAG 评测的事实标准依赖。
条件:Python≥3.9 + pip install ragas;一个 judge 模型端点(GPT-4o-mini / Claude Haiku 级,版本要 pin);100–500 条代表性 golden set(recall 类指标需要 ground_truth);接 CI(GitHub Actions 等)跑离线评测。faithfulness / answer_relevancy / context_precision 这三项 reference-free,不需要标准答案。
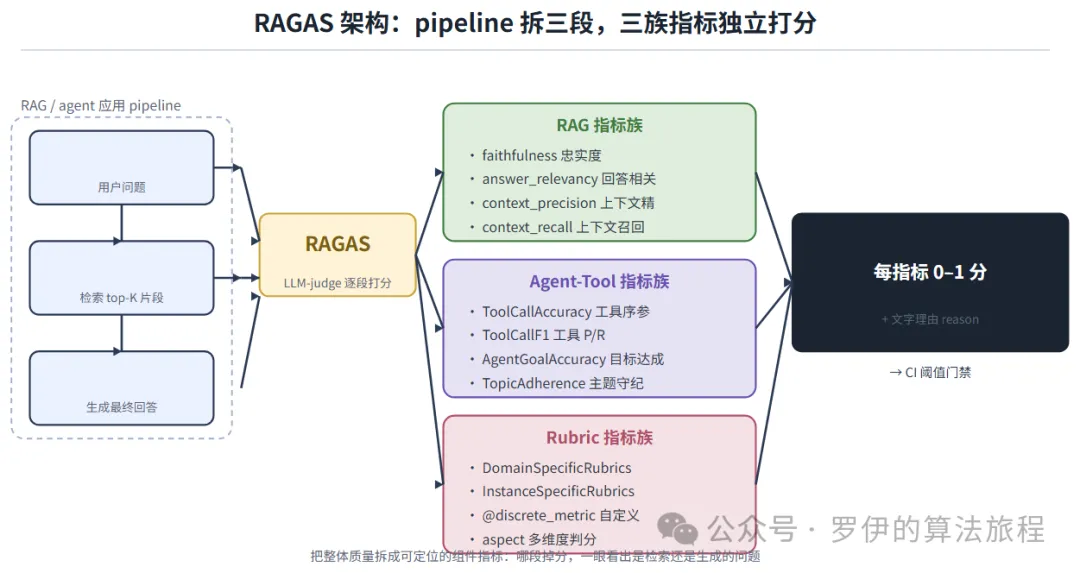
方法:把 pipeline 拆成 query→retrieve→generate 三段,每段用 LLM-judge 独立打分;RAG 核心四指标(faithfulness / answer_relevancy / context_precision / context_recall)+ agent/tool 指标(ToolCallAccuracy / ToolCallF1 / AgentGoalAccuracy / TopicAdherence)+ 自定义 rubric;离线 evaluate() 批量算分,CI 设阈值(如 faithfulness<0.85 拦 merge)。
效果:业务收益是「用 15,用 mini 更便宜)+ judge 延迟(离线跑,非实时)+ 同家族法官自偏好(GPT 判 GPT 虚高 5–12 分)+ faithfulness 在错误 context 上可虚高到 1.0 + tool-call 指标只读消息、不验数据库状态。
技术背景与问题定义
RAG 和工具调用型 Agent 最难的地方,是「质量」没有单一正确答案。传统 exact match、BLEU 要么太严要么太松,人工 review 又不可复现、不可回归。更要命的是:一个回答「看起来对」,可能全是模型自己编的,检索到的 context 里压根没有依据——这种幻觉,肉眼要翻很多条才能撞见。
RAGAS(Exploding Gradients 出品,Apache-2.0,GitHub explodinggradients/ragas,文档 docs.ragas.io)解决的就是这件事:它把整体质量拆成一组可定位的组件指标,每个指标 0–1 分,让「哪段掉分」一眼可见是检索的问题还是生成的问题。2026 年它演进到 v0.4 系列(collections API),在原有 RAG 指标之外新增了 agent/tool 指标族和 rubric 指标族,把「工具调没调对、目标达没达成、有没有跑题」也纳入打分。
它给谁用、在谁的业务里跑起来了:不是实验室玩具。RAGAS 被 LangChain、LlamaIndex、Haystack、LangGraph、Griptape、AG-UI、LlamaStack、R2R 原生集成,是这些栈里默认的 RAG 评测依赖;大量生产团队把它接进 CI,对每一次 prompt / 模型 / 检索改动跑回归。它和本专栏讲过的 strands(质量门框架)、Inspect(研究向 harness)、Langfuse(观测平台)是不同层——RAGAS 不接管你的运行、不做平台,它只做一件事:用一组指标把你的 RAG/Agent 输出量出分。
上面这张图是核心主张的具象:pipeline 被拆成三段,每一段由 LLM-judge 独立打分,再汇成 RAG / Agent-Tool / Rubric 三族指标,每个指标出一个 0–1 分加一句文字理由,喂给 CI 阈值门禁。
实现路径与步骤
目标是三天内跑通最小闭环:本地装好、准备几十到几百条样本、跑出第一份分量化的评测报告、接上 CI 闸门。
步骤 1:装环境与依赖
pip install "ragas>=0.4" datasets langchain-openai
judge 模型用你已有的 OpenAI / Anthropic / 本地 vLLM 端点都行。生产门禁建议用 GPT-4o-mini 或 Claude Haiku 这类便宜且够用的模型,版本务必 pin,否则 judge 一升级,历史分数就不可比。
步骤 2:准备 golden set
结构是四个字段:question、answer、contexts(检索到的片段列表)、ground_truth(仅 context_recall 需要)。
from datasets import Datasetdata = Dataset.from_dict({"question": ["你们的差旅报销上限是多少?"],"answer": ["差旅报销上限为每日 800 元。"],"contexts": [["公司差旅制度第 3 条:员工差旅报销上限为每日 800 元。"]],"ground_truth": ["每日 800 元"], # 仅 context_recall 需要})
量上,100–500 条是甜区:少于 50 条方差大到不可信,超过 500 条边际价值快速下降。从生产日志抽真实 query,recall 类指标再补人工标注的 ground_truth。
步骤 3:最小可运行片段——跑 RAG 四指标
from ragas import evaluatefrom ragas.metrics.collections import ( Faithfulness, AnswerRelevancy, ContextPrecision, ContextRecall,)from ragas.llms import LangchainLLMWrapperfrom ragas.embeddings import LangchainEmbeddingsWrapperfrom langchain_openai import ChatOpenAI, OpenAIEmbeddingsjudge_llm = LangchainLLMWrapper(ChatOpenAI(model="gpt-4o-mini", temperature=0))judge_emb = LangchainEmbeddingsWrapper(OpenAIEmbeddings(model="text-embedding-3-small"))res = evaluate( data, metrics=[Faithfulness(), AnswerRelevancy(), ContextPrecision(), ContextRecall()], llm=judge_llm, embeddings=judge_emb,)print(res) # {'faithfulness': 0.91, 'answer_relevancy': 0.88, ...}
这一步成功的标准:终端打印出每张指标的分数,且 faithfulness 对「编造」的样本明显低于对「有据」的样本。我自己第一次跑就发现,一个把「800 元」说成「2000 元」的回答,faithfulness 直接掉到 0.2——尺子确实灵。
步骤 4:agent / tool 调用指标
工具调用型 Agent 最该卡的是「调没调对工具、参数是不是对的、目标达没达成」。
import asynciofrom ragas.metrics.collections import ToolCallF1from ragas.messages import HumanMessage, ToolCallasyncdefmain(): user = [HumanMessage(content="巴黎今天天气怎样?")] ref = [ToolCall(name="weather_check", args={"location": "Paris"})] got = [ToolCall(name="weather_check", args={"location": "Paris"})] scorer = ToolCallF1() r = await scorer.ascore(user_input=user, reference_tool_calls=ref, tool_calls=got)print(r.value) # 1.0;参数错一点按比例给部分分asyncio.run(main())
ToolCallAccuracy 是严格序+全参匹配的二值分(多调、少调、重复调都直接 0);ToolCallF1 用无序的 precision/recall,更适合迭代期看「差多远」。要的是结果而不是中间工具时换 AgentGoalAccuracyWithReference(你写期望结局,如「请假已提交 20 天从 11 月 2 日起」),让 judge 比对对话是否走到那个状态。
步骤 5:自定义 rubric——卡业务专属质量
通用指标之外,用 DomainSpecificRubrics 或 @discrete_metric 装饰器写自己的判分维度,比如「是否泄露 PII」「是否按合规口径回答」。这类指标把评测从「通不通用」拉到「合不合我业务」。
步骤 6:接 CI 闸门
把步骤 3 的判断抽成 eval.py,任一指标低于阈值就非零退出,GitHub Actions 里挂上:
name:rag-eval-gateon: [pull_request]jobs:eval:runs-on:ubuntu-lateststeps:-uses:actions/checkout@v4-uses:actions/setup-python@v5with: { python-version:"3.11" }-run:pipinstall"ragas>=0.4"datasetslangchain-openai-run:pythoneval.py--threshold0.85
eval.py 里对 res 遍历,faithfulness 或 context_precision 低于阈值就 sys.exit(1)。行业里常见的做法是每个垂直 200–500 条 golden set,faithfulness<0.85 或 context_precision<0.80 直接拦 merge;生产侧再对 5–10% 真实流量做 nightly 漂移监控,faithfulness 跌就告警。
关键超参表
| | | | |
|---|
| | GPT-4o-mini / Claude Haiku | | |
| | | | |
| | | | |
| | | | |
| | | | |
常见报错与规避
- judge API key 没设或 endpoint 错:所有指标返回 0 或直接抛错。先把
OPENAI_API_KEY / ANTHROPIC_API_KEY 设好,单独跑一条验证连通。 - v0.3 升 v0.4:老的
from ragas.metrics import Faithfulness 还能用但已弃用,collections API 更稳;老的 ToolCallAccuracy 将在 v1.0 移除,尽早迁移到 ragas.metrics.collections。 - context_recall 缺
ground_truth:它必须知道「正确答案长啥样」才能算覆盖率,没标参考就空着别跑这条。 - 同家族法官自偏好:用 GPT 判 GPT 会虚高 5–12 分,跨家族判(Claude 判 GPT、反之)才接近人的判断。
- collections 指标是 async:忘了
await 或 asyncio.run,拿到的是协程不是分数。 - 非英文 context 的 claim 抽取靠 judge:低能 judge 会漏抽原子事实,faithfulness 虚高,关键场景别用最便宜的模型。
跑起来要花多少
行业测算一个单功能 RAG 应用首年评测总投入约 $4,050(含托管平台);自托管把工具成本压到近零,只剩 judge API 费和标注费。对比生产事故每月数万美元级的流失,这笔账其实很好算。
原理讲解
RAGAS 之所以能用,是因为它把「整体质量」这个含糊目标,换成了几个可定位、可归因的子问题。
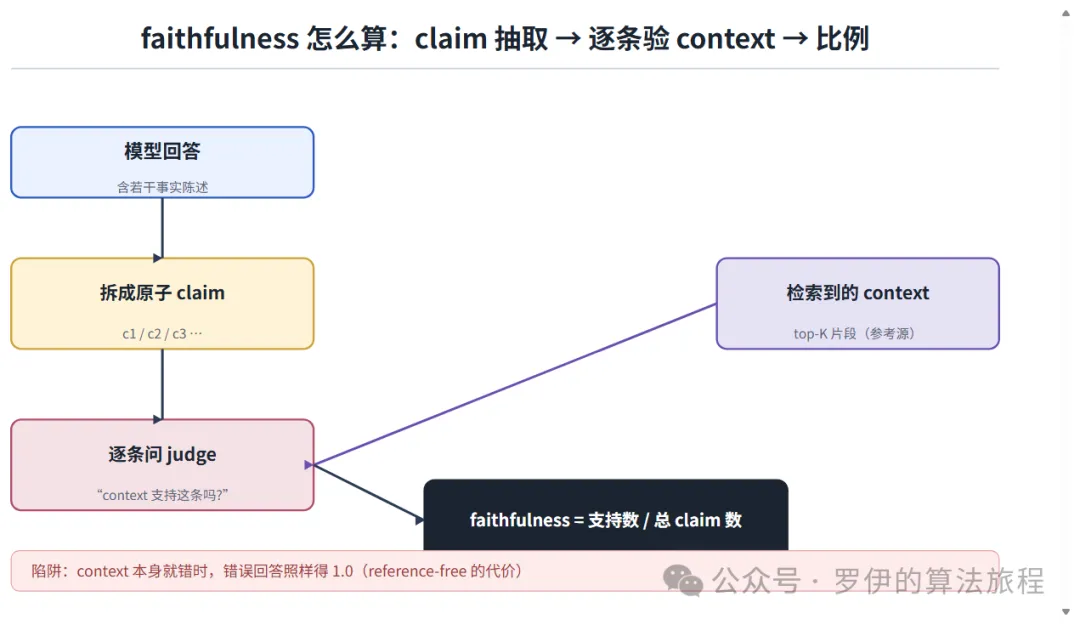
faithfulness(忠实度)是其中最锋利的一把:它先把回答拆成一堆原子事实 claim,再逐条问 judge「这条能不能从检索到的 context 里推出来」,用「被支撑的 claim 数 / 总 claim 数」当分数。一个把制度「800 元」说成「2000 元」的回答,claim 对不上 context,分数立刻垮。
上面这张图就是它的计算过程:回答先被拆成 c1、c2、c3,每条去 context 里验,比例就是忠实度。但注意右下角那个坑——context 本身就错时,错误回答照样得 1.0。reference-free 是它的便宜来源(不用标答案),也是它的命门:它验的是「回答撑不撑得住检索到的东西」,不验「检索到的东西对不对」。所以 faithfulness 高只说明「没编造」,不说明「正确」。
answer_relevancy 换个角度卡「答非所问」:让 judge(或 embedding)把回答反向生成一个问题,再算这个问题和原 query 的语义相似度。回答再漂亮,只要没接住用户真正问的,分数就低。context_precision 用 NDCG 式加权,看相关片段是不是排在 top;context_recall 则需要 ground_truth,算「答案需要的 factual 有没有都在 context 里」。
agent/tool 指标那边,ToolCallF1 用经典 IR 的 precision/recall:工具名和参数都对的算命中,多调、少调、重复调都能被量化。但我不太买账它「只读消息不验状态」——它看的是 agent 调了什么工具、传了什么参,不看这次调用在数据库里到底落没落、改没改对。换句话说,它卡的是「调用动作对不对」,卡不了「业务后果对不对」。真要卡后者,得靠本专栏讲过的有状态判分思路(AppWorld / ThinkingBox 那一类),RAGAS 自己不碰。
工程上的取舍很清楚:效果靠 judge 模型的判断力,成本靠 judge 的调用次数和单价,稳定性靠 judge 版本 pin 死 + 跨家族 + 采样率。它不测延迟(那是 p50/p95 的活),也不替你定义「什么算对」——这恰恰是你该用 rubric 和 golden set 补上的部分。
效果验证与适用边界
量化结果先摆一张表(口径:官方文档示例 + 行业生产实践,非本专栏实测自跑):
业务收益单列:用一个约 $100/月的评测闭环,把「幻觉漏到生产」「检索改动悄悄劣化」这类问题在前端拦下;reference-free 指标省掉标准答案标注的人力;生产采样监控把「上线后靠用户投诉才发现」变成「nightly 自动告警」。它不要求你改 pipeline,只在旁边架一把尺。
什么条件下成立:有真实 RAG/Agent 流量、能把代表 query 攒成 golden set、愿意为 judge 付一点 API 费、需要可回归的质量闸门。
什么条件下失效或退化:纯确定性小应用,硬编码单测就够了,上 RAGAS 是杀鸡用牛刀;要求 sub-10ms 的实时内联过滤,它离线跑的延迟根本来不及;法律、医疗这类强合规域,通用 judge 要配自定义 system prompt 甚至微调 judge,否则分数不可信;你的 context 本身常被污染时,faithfulness 高分会误导你——它验不出源头错。
换业务 / 换模型要重验哪些前提:judge 版本一换,历史分数不可比,必须重新 baseline;换 embedding 或重排器,context_precision 的口径要重标;跨语言场景低能 judge 的 claim 抽取会漏,关键路径别省 judge 预算。
已知局限与合规风险:reference-free 陷阱(context 错也满分)、tool-call 不验数据库状态、judge 同家族自偏好。合规上,judge 若走第三方 API,用户 query 和 context 会出境——金融、医疗数据要确认 judge 端点在本土或自托管。
复现清单
上手三步走
pip install "ragas>=0.4" datasets langchain-openai,设好 judge 的 API key。- 从生产日志抽 100–500 条 query,组织成
question/answer/contexts/ground_truth 的 Dataset。 - 跑步骤 3 的最小片段出第一份分数,挑 faithfulness 最低的 10 条人工看一眼校准 judge。
踩坑记录
- v0.4 collections API 和 v0.3 老接口并存,老
ToolCallAccuracy 弃用、v1.0 移除,新项目直接用 collections。 - context_recall 必须带
ground_truth,否则算不出。 - judge 同家族自偏好,跨家族判才准;温度必须设 0 保证可复现。
- 指标是 async,
await / asyncio.run 别忘了;非英文 context 别用最便宜的 judge。
实用评分卡(5 分制)
- 可复现性:5——pip 装、零 GPU、命令明确。
- 上手成本:4——半天能跑通,golden set 是主要工作量。
- 效果可信度:3——judge 相关 0.6–0.85,够做回归检测,不够做绝对质量声明。
关键链接
- 仓库:
github.com/explodinggradients/ragas - 文档:
docs.ragas.io(含 collections API 与 agent/tool 指标示例) - 接入框架:LangChain / LlamaIndex / Haystack / LangGraph
今日反问
faithfulness 只验证回答有没有被检索到的 context 撑住,那当 context 本身就在说谎时,这个分数究竟证明的是质量,还是运气?