一、80% 的系统提示被删掉,编码评测没有可测退化
这不是经验之谈,是 Anthropic 对自己产品做的一次减法实验。
2026 年 10 月 29 日,Addy Osmani 在 X 上发了一篇长文,标题一句话:你可能在过度提示 Claude。29.4 万浏览,主页简介现在写的是 Claude Code @anthropicai。
We removed over 80% of the Claude Code system prompt for our newest models. —— 我们为新模型删掉了 Claude Code 系统提示的 80% 以上。
这句话出自 Thariq,前 Claude Code 团队成员,2026 年 7 月 24 日。三个月后 Anthropic 应用 AI 团队的 Diane Sarkis 在另一篇里复述同一事实,并补了一句限定:这 80% 里包含与渐进披露 skills 和工具相关的裁剪。Thariq 归因于"新模型更强",Diane 把一部分归因于"架构改成按需加载",两个原因都存在,同一句 80% 被它们共同引用。
删的是约束,不是知识;而且这一刀砍下去,测量不到损失。 边界:编码评测,不是通用能力。
二、删掉的不是废话,是六条曾经救过命的规则
Thariq 那篇把失效的旧规则列成六组。
第一组最能说明问题。旧提示里写着「默认不写注释,绝不写多段 docstring,一行封顶」,因为当年不加这条,注释确实会错。新提示只剩一句:写代码要像周围的代码,匹配它的注释密度、命名和惯用法。
第二组更反直觉。过去工具调用的第一原则是"给例子",现在发现 例子反而把模型的探索空间框死了。替代方案是设计参数本身:把待办工具的状态做成 pending / in_progress / completed 三值枚举,模型看一眼就会用,不必三行示例。第三组是架构层面:审查与验证的指引从系统提示搬进可被选择性调用的 skill,工具改成"延迟加载",模型先搜一次才拿到完整定义,工具再多也不占常驻上下文。
三、为什么现在能删:三个能力变化
六条规则不是被推翻的,是被能力追上后失效的。
- 跑得久。 Opus 5.5 在长链路上比 Opus 5 强得多,早期测试者让它连跑几小时编码任务。跑得久重启就贵,官方因此建议"中途想到什么就追加消息"。
- 关不掉思考。 官方原话是 you cannot turn off thinking on Opus 5.5, and Fable 5.1。既然每次都思考、且由模型自己决定想多久,那句"仔细想想"就是空转。
- 入口变多。 CLAUDE.md 过去同时当记忆、规范与说明书,现在有自动记忆、artifacts 和 skills,不必再扛三份职责。
还有一个被忽略的动因:指令之间在打架。Thariq 说读内部对话记录时,一条请求里同时出现「按需保留文档」和「不要加注释」,系统提示、skill 与用户请求三方互相冲突。模型能猜出意图,但每次都得先花力气调和。删掉一半指令,省下的不只是 token,是模型的注意力。
四、一句话任务的写法:目标、判据、停止条件
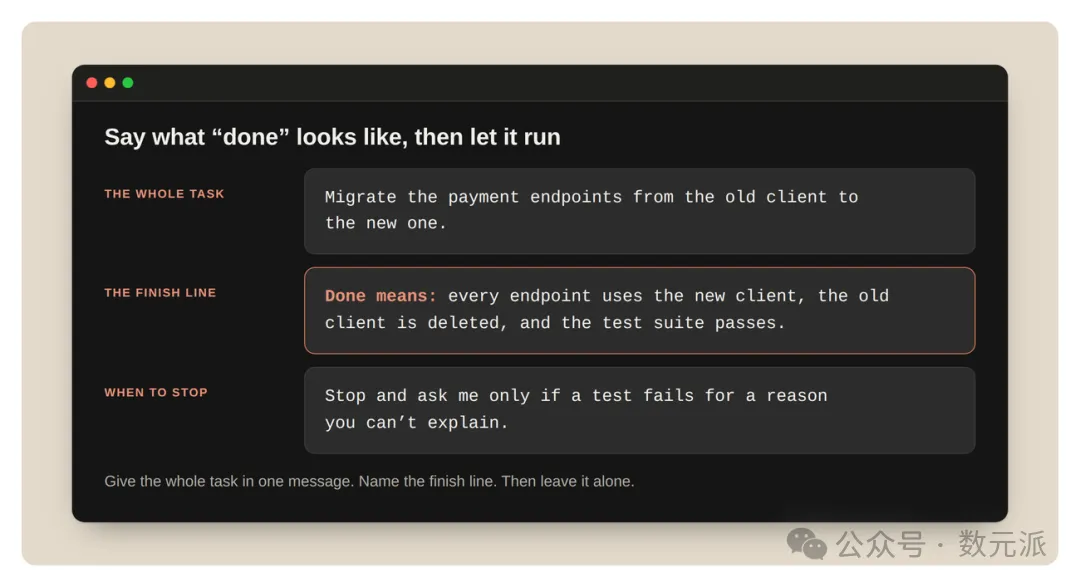
图 1:官方给出的单条提示模板——整个任务、完成判据、何时停下问人。
Addy 的做法只有一条:把整个任务塞进一条消息,说清"做完"长什么样,然后放手。
- 目标:一句话说清要改什么,不写步骤。官方示例是「把支付端点从旧客户端迁到新客户端」。
- 判据:写成可执行的完成条件——每个端点都用新客户端、旧客户端删掉、测试套件通过。
- 停止条件
隐含前提是 判据必须是模型自己能跑的东西。pass/fail 的测试、一个要达到的数字、一份它能读回来的报告,三者任一都行。只有"做得好看点"这类判据,模型没法自查,长任务必然退化成反复问你。起手档位官方建议 /effort medium。"think step by step"删掉后,官方测试里回复开始更快,质量没有明显下降。
五、"它会自己停"和"它停得太早"是同一件事
Addy 在 X 里写的是「Claude 认为做完时会自己停」。同一位作者 9 月 22 日在 claude.dev 的博客写的是另一面:Opus 5.5 有时会停下来汇报,而不是继续做。
三种假停止跑过长任务的人都见过:只报下一步,点名"接下来该做 X"然后等你点头;征求同意;列一串并不阻塞工作的选项。两种说法不矛盾但会误导——真实情况是模型有"停下来"的倾向,你需要在 CLAUDE.md 里同时写清什么时候不停。
封面那张图就是这个写法:左边"继续",右边"停下问我",并排放进 CLAUDE.md。官方另提醒一句:规则让你少被打断,也就意味着风险的把关要留在别处——破坏性命令的权限提示不要关。
六、subagent 越多不一定越聪明:单 agent 加 skills 快约 2 倍
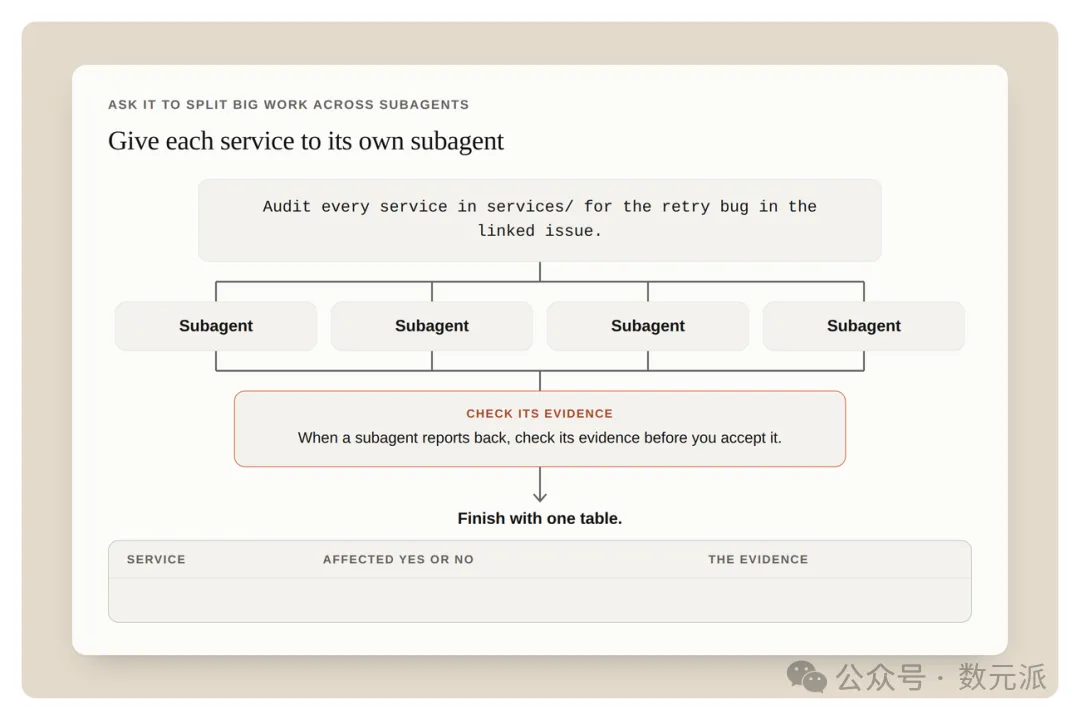
图 2:官方示例——每个服务一个 subagent,回报后先查证据,最后合成一张表。
Anthropic 应用 AI 团队 10 月 22 日的文章给了个更有意思的结论:多个企业部署的对比中,单个 agent 加 skills 在质量上经常胜过 subagent 架构,且每任务的成本与延迟更低。一家客户把多 agent 编排换成单 agent 循环,运行快约 2 倍。该保留 subagent 的只有三种情况:
- 单 agent 选不准工具,或系统提示里已有冲突指令
Addy 的补充更直接:subagent 能并行、能给第二意见,但默认不会让事情变聪明;小任务上它同时放大成本和延迟。工具定义超过 30 到 50 个,选择就开始退化。
还有一个值得抄的失败案例:折叠 subagent 之后延迟降了,但流程断了——主 agent 自己答了配送日期,没再去问运输专家。这个错在两次运行里只出现一次,所以迁移时每个任务至少要跑两遍。
七、最危险的一处:把审批交给分类器,人类只拦住 13.6%
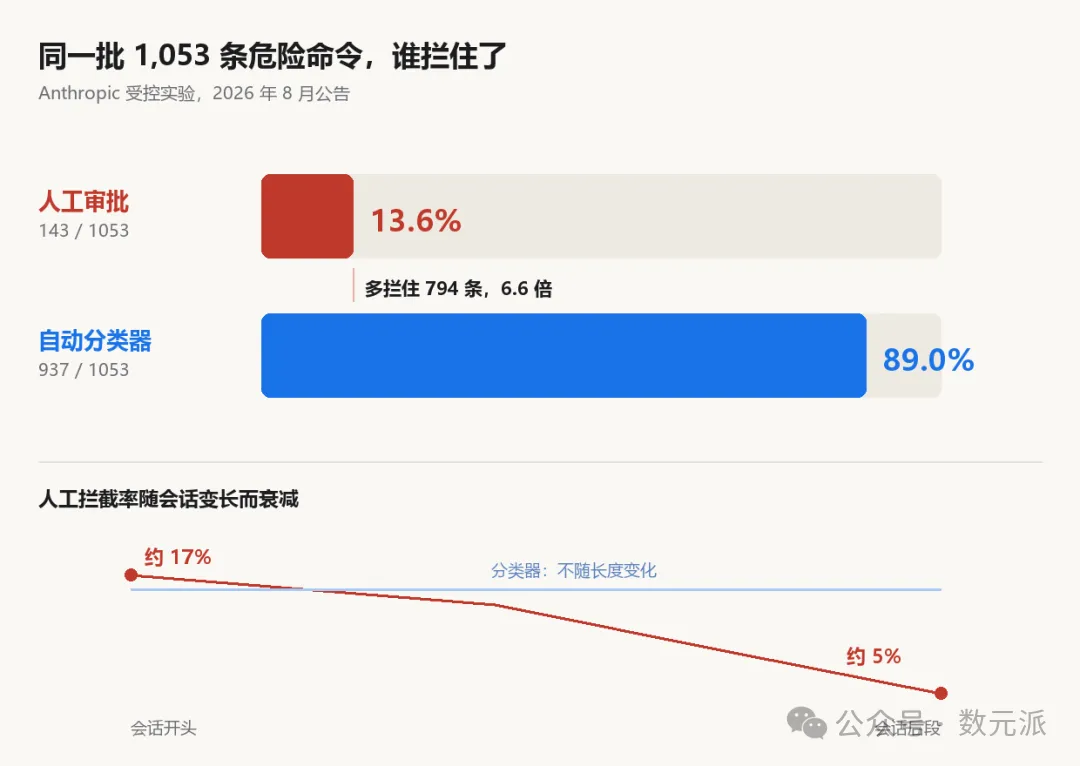
图 3:同一批 1,053 条危险命令的拦截结果。数据来自 Anthropic 2026 年 8 月的 auto mode 公告。
Addy 那句话写得很克制:自动模式不是安全保证,但盲目批准每个弹窗也不是。官方公告里的数字把这句话量化了。
Anthropic 做过一次受控实验,1,053 名测试者面对同一批危险命令。人工审查只拦下 13.6%(143 条),分类器拦下 89.0%(937 条),多拦 794 条。而且人工拦截率随会话变长而衰减,从约 17% 掉到约 5%,分类器不随长度变化。真实流量的方向一致:手动审批的会话里,用户没明确要求的有害操作占 6.3%,auto mode 是 2.4%。
- 放行
- 硬拒绝
- 回退:连续 3 次被拦,或单会话累计 20 次被拦,退回手动审批。
这组数字解释了为什么"我在旁边盯着"不构成护栏。盯到第三十轮,你就是那个 5%。 于是流程改成分类器前置拦截、人只处理被标出来的部分。
八、审查没有消失,只是前移了:90% 代码、回滚降四成
Addy 是 10 月 15 日那篇 Claude Code 代码审查文章的第一作者,里面有一组自家团队的账。
- Claude 写了 Claude Code 约 90% 的代码
- 日均落地变更从 5 月的约 2,500 涨到 9 月的 30,000 以上
- 收到实质性审查评论的内部 PR 从 16% 升到 54%
审查拆成七层,人在第五层。风险分级按变更而非作者:文档、文案这类低风险改动,自动审查与安全检查通过后不需要人类批准;普通变更加一人;计费、自动更新器、CI 工作流永远两人。还有一个收敛问题:曾有一个 CLI PR 一夜之间跑了50 多轮审查与修复。对反复被标记的代码做 git blame,发现 约 59% 是审查者首轮就存在的旧代码——新引入的缺陷只占 41%,剩下都是它在翻旧账,对策是三轮上限、首轮之后只复审新 diff。两条底线:代理的批准永远不算人类批准;批准只对特定 commit 有效。
九、怎么判断自己还在为旧模型写提示
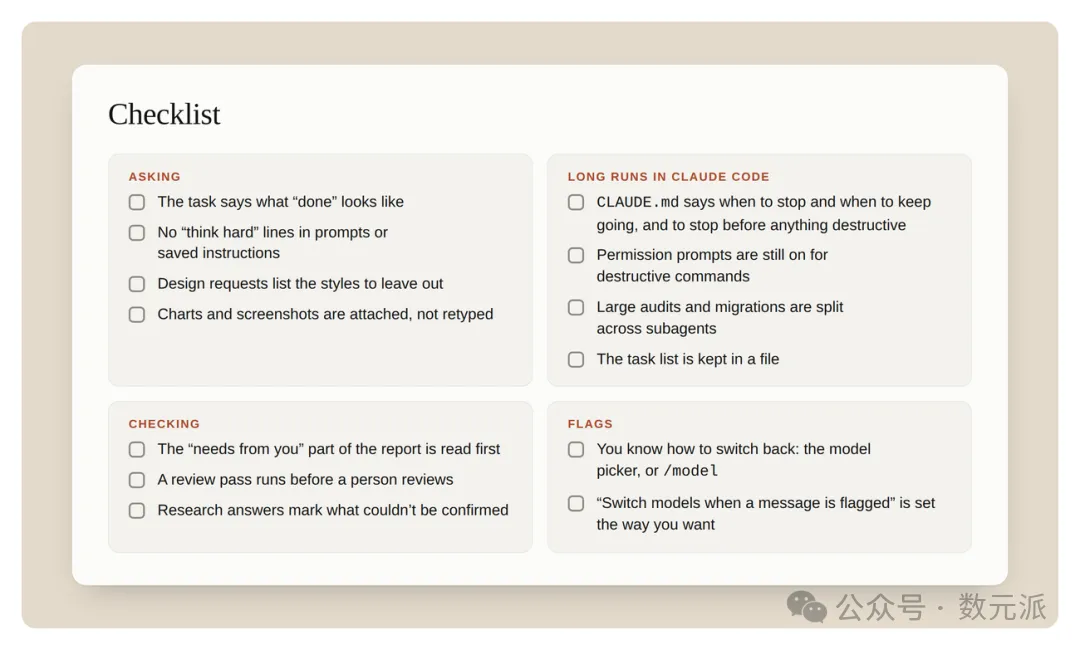
图 4:官方清单——提问方式、长任务、检查结果、被拦截后的处置。
有一个现成工具能替你做这件事。/doctor prompt-audit 扫描你的 CLAUDE.md、skills 与配置,找出过时或互相冲突的指令并以 diff 给出建议,需 v2.1.283 以上;不带子命令的 /doctor 查的是安装、设置、扩展与 CLAUDE.md 的问题,顺手把常驻指引迁进按需加载的 skill。自己动手就三步:删一批,只把模型确实漏掉的加回来,再看评测有没有动。
口径要摆清楚:
四条结论:
- 该删的是规则,不是背景。 判断力能替代的部分(注释写多少、要不要拆文件)可以删;只有团队知道的东西(仓库的坑、验证方式)必须留,且应做成 skill 按需加载。
- 写提示的重点从"约束"移到"判据"。 一句可执行的完成条件,比二十行"注意事项"更有用。
- 架构选择要跟着能力走。 单 agent 加 skills 在多个企业部署里赢过 subagent,前提是上下文能用渐进披露管住;管不住,才需要拆。
- AI 写代码的比例越高,人类审批的边际价值越低。 13.6% 这个数不是让人放弃审查,而是说明审查应该前移到判据和自动检查上。
Addy 放在文末的最后一句话,是全篇唯一带时间尺度的建议:每隔几个月审计一次自己的工作方式,确认你不是在为旧模型的工作方式做构建。
参考链接
- Addy Osmani:You're probably overprompting Claude(X Article,2026-10-29):https://x.com/addyosmani/status/2115688494865465370
- Thariq:The new rules of context engineering for Claude 5 models(2026-07-24):https://x.com/trq212/status/2080710971228918066
- Addy Osmani:Getting the most out of Opus 5.5(claude.dev,2026-09-22):https://claude.dev/blog/getting-the-most-out-of-opus-5-5/
- Diane Sarkis:When to fold subagents into your main agent loop(2026-10-22):https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- Auto mode is now the default in Claude Code(2026-08-07):https://claude.com/resources/articles/auto-mode-default-in-claude-code
- Addy Osmani 等:How the Claude Code team does code review(2026-10-15):https://claude.dev/blog/solving-code-review-at-anthropic/
- Claude Code 命令文档(/doctor):https://code.claude.com/docs/en/commands