论文链接:https://arxiv.org/pdf/2608.29607
代码链接:https://github.com/zrchen03/SnapBench
【港科广-腾讯 CCF 犀牛鸟基金项目成果】移动端“拍一张图 + 问一句”(Snap-and-Ask)已成为多模态检索的高频形态,但真实输入中图像模糊、裁剪、水印与问句错字、粗放表达往往并存,干净数据上的准确率难以代表线上表现。本文解读论文 SnapBench: Benchmarking Snap-and-Ask Multimodal Retrieval for Mobile Interactions:该工作以「实体中心化查询 + 同类别难负例图库 + clean-corrupted 配对对比 + 基于原语的图文双侧受控噪声」四大要素,构建首个面向移动端的配对鲁棒性评测基准;对多个主流模型的系统评测揭示出图像噪声断崖效应、粗文本拖拽与图文联合噪声超加性三大失败模式。据此提出的免训练自适应模态融合策略 RCGAF,在干净、文本干扰、图像干扰三类条件下均稳定提升 Recall@1,表明瓶颈不在用户文本质量,而在固定融合机制无法判断何时应更信任文本。
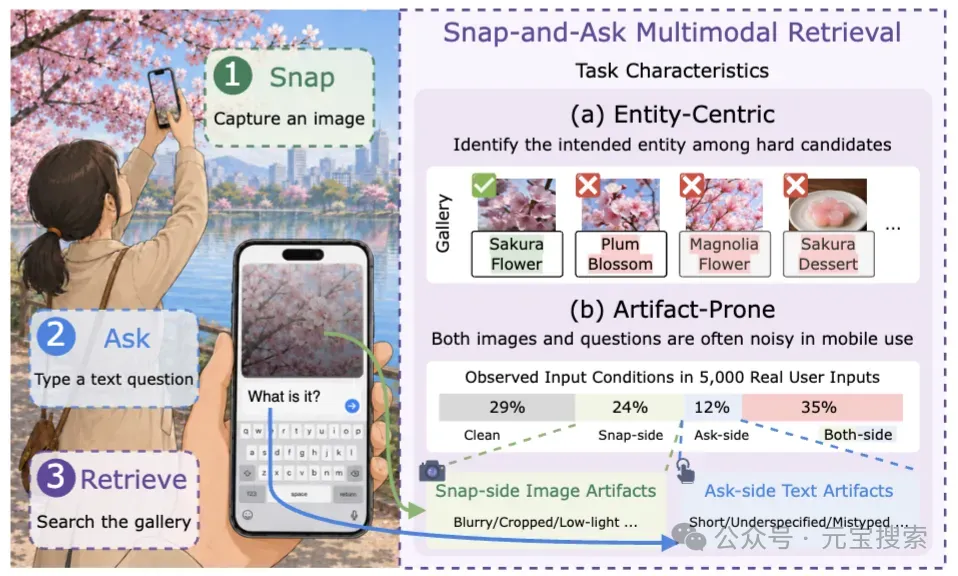
图 1:移动端 Snap-and-Ask 检索场景示意。用户拍一张照片并输入一个问题,系统从图库中检索出目标实体。真实用户输入中,相当大比例存在图像或文字侧的噪声(Snap 侧 + Ask 侧 + 两侧均有)。
· 在公园拍一朵花,输入「这是什么花?」
· 拍一件路边看中的衣服,输入「这是什么风格?」
· 扫一眼餐厅菜单,拍下来问「这道菜是什么?」
这就是 Snap-and-Ask:用手机拍一张图(Snap)+ 输入一个短问题(Ask)→ 系统从图库里找出对应实体。
用户要找的是某个具体实体(樱花 vs 木兰花 vs 梅花),而不是一个宽泛类别手机照片经常模糊/裁剪/逆光;问句经常简短/拼写错误/表意模糊我们对大批真实用户上传进行了分析,发现:仅有少数输入是干净的图像 + 清晰的问题,相当大比例的输入存在不同程度的图像侧或文字侧噪声。
干净标注,无噪声;查询是规范的图片描述,不是手机用户问句面向分类设计,无配套检索图库和 GT 标注,不能直接用于衡量噪声对检索性能的影响移动端多模态检索的可靠性,不能只靠干净数据准确率来衡量——必须用配对的、可控的真实噪声条件来单独评测鲁棒性。
· ① SnapBench benchmark:首个面向移动端 snap-and-ask 检索场景的配对鲁棒性评测基准,结合了「实体中心化查询 + 同类别难负例图库 + 配对 clean-corrupted 对比 + 基于原语的图文双侧受控噪声」四大设计要素;
· ② 三大系统性失败模式:对多个主流多模态检索模型的系统评测,揭示了图像噪声敏感性(断崖效应)、文字信号低利用/粗文本拖拽(coarse-text drag)、图文联合噪声超加性三个反直觉问题;
· ③ RCGAF 自适应融合:一种无需训练的轻量自适应融合策略,基于每个 query 的检索分数分布动态估计模态可靠性并调整融合权重,在干净图、噪声图、图文联合噪声三种条件下均有稳定收益。
SnapBench 的设计原则只有一条:干净和噪声输入之间,除了观测到的噪声条件不同,其他一切保持不变。
这种配对设计让每个性能下降都可以被精确归因:性能退化 = 纯粹由当前噪声条件引起的退化,而不是因为换了一批不同的候选或目标。
对业务的直接价值:这套配对评测框架可以直接平移到内部测试集建设中。比如对同一批商品查询,分别构建「干净图 + 精准问句」和「低光图 + 模糊问句」两套版本,就能精确量化线上噪声对检索效果的实际影响,为模型迭代提供有针对性的优化方向。
03核心思想二:同类别难负例图库,让评测真正考察实体识别snap-and-ask 场景的本质是实体级别的区分,而不是类别级别的匹配。
传统图文检索 benchmark 的图库通常包含大量跨类别的图片,模型只需要「找到同类别的图片」就能得高分,这在移动端场景里是不够的——用户拍一朵樱花,要的是「这个具体品种的花」,而不是「随便一朵花」。
SnapBench 的图库设计专门针对这一点:每个查询的图库里,正例和同类别难负例都包含在内。
查询:用户拍了一朵樱花,问「这是什么花?」
图库:
✅ 樱花(正例)
❌ 木兰花(同类别难负例——也是花,但不是目标实体)
❌ 梅花(同类别难负例)
❌ 桃花(同类别难负例)
· 模型必须真正理解实体,只做类别匹配是不够的;
· 图库只含正例和难负例,不含大量容易区分的跨类别图片,评测难度更贴近真实业务;
· 四维人工标注(视觉相似度 / 实体相关性 / 描述准确度 / 查询意图匹配度)保证了标注质量。
业务意义:如果内部评测集里图库太「稀」(缺少同类别难负例),测出来的准确率会虚高。SnapBench 的图库构建思路,值得参考用于内部测试集的改造——尤其是以图搜商品、以图识物等实体区分场景。
如果说配对设计解决了「怎么评」的问题,那原语分类法解决的是「评什么」的问题。
以前的鲁棒性 benchmark 是经验性地堆砌各种变换:模糊、旋转、JPEG 压缩、亮度调整……一大堆,但这些操作之间的关系是什么、覆盖是否完整、哪些属于同一类机制,都没有系统性的回答。
我们从一个更本质的问题出发:一张手机照片上的噪声,从视觉证据损坏机制的角度来看,能做的事情有哪几类? 答案推导出四个图像侧原语(Image-side Primitives):
这四个原语不是随机选的,而是从「损坏机制」角度的系统性推导:
· DEGRADE 和 TRANSFORM 都保留了目标实体,区别在于「质量」vs「几何」;
· REMOVE 和 ADD 则从正反两面破坏实体的可见性:一个是移除,一个是遮盖。
每个原语下面实例化了若干具体操作,每个操作设轻度 / 中度 / 重度三个强度等级,覆盖数十个图像侧评测条件。
· 字符级:漏字 / 错字 / 替换;
· 词语级:词语重复 / 词序颠倒;
· 句子级:追加闲聊 / 整句退化。
为什么这种分类法重要? 不同原语对应不同的失败机制——REMOVE 直接抹除了视觉证据,模型几乎无从恢复;DEGRADE 保留了证据但降低了信号质量,模型还有救。在业务测试集建设时,知道「我们的场景主要属于哪类原语」,就能做到有的放矢,而不是漫无目的地压各种噪声。
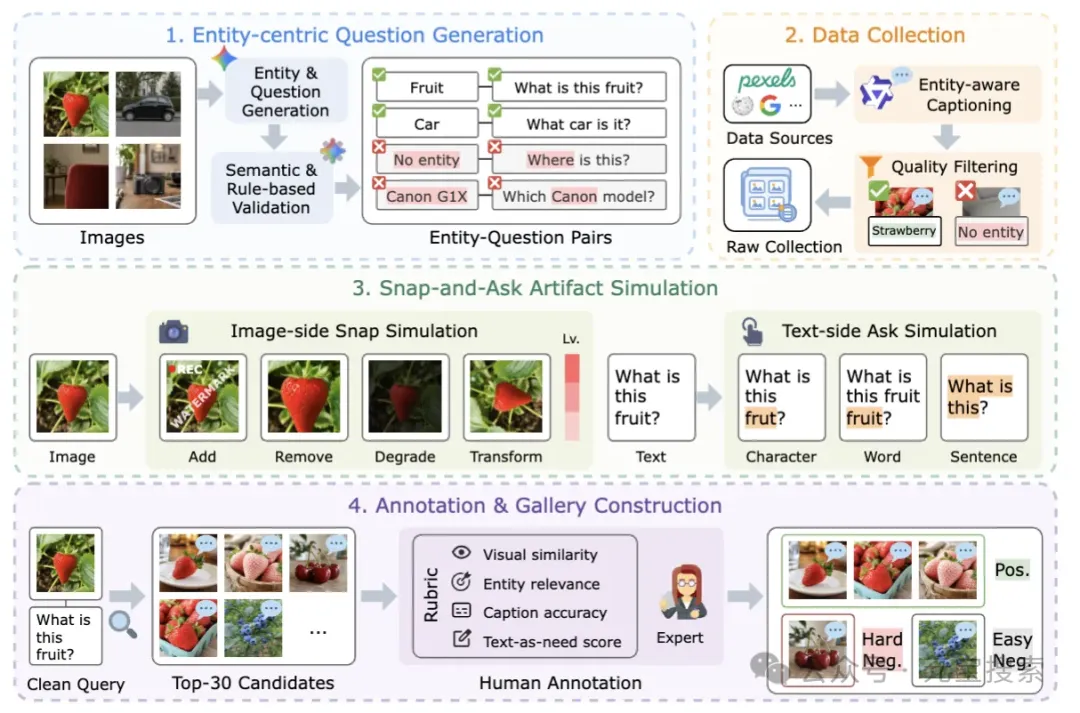
图 2:SnapBench 四阶段构建流程。包括实体中心化问句生成、图库采集、Snap-and-Ask 噪声模拟、人工标注与图库筛选。
SnapBench 包含大量查询与图库条目,覆盖数十个受控噪声条件,经过严格的人工标注质检,整体质量有保障。构建流程分为四个阶段:
· Stage 1:实体中心化问句生成。 从私有图像池出发,对每张图自动生成粗粒度实体问句(「这是什么花?」「这是什么类型的建筑?」),再经过语义 + 规则双重校验,确保每个查询都以一个可识别的实体为核心,过滤掉指向品牌名、人名、地名等容易引发隐私或泄露问题的问句;
· Stage 2:图库采集。 从同一图像池采集图库,使用专用模型为每张图生成实体描述,经过质量过滤,最终形成一个包含同类别难负例的图库——用户必须找到正确实体,而不只是找到正确类别;
· Stage 3:Snap-and-Ask 噪声模拟。 噪声只施加在查询侧,图库保持不变——配对设计的核心原则在这里落地。图像侧按四类原语(ADD / REMOVE / DEGRADE / TRANSFORM)实例化操作,每类设轻度 / 中度 / 重度三个强度等级;文字侧覆盖字符 / 词 / 句子三个粒度,涵盖打字错误、词序混乱、问句退化等真实场景;
· Stage 4:人工标注与图库筛选。 每个查询从图库预检索 Top-30 候选,人工专家按视觉相似度、实体相关性、描述准确度、查询意图匹配度四维度打分,筛选出正例和难负例构成最终图库。
对业务的启发:这套四阶段构建流程,本质上是一套移动端场景下「检索测试集」的通用方法论——从实体中心化筛题、到引入受控噪声、再到多维度人工审核,可以参考这套流程为自己的业务构建针对性的鲁棒性测试集,而不只是依赖干净数据准确率来衡量系统质量。
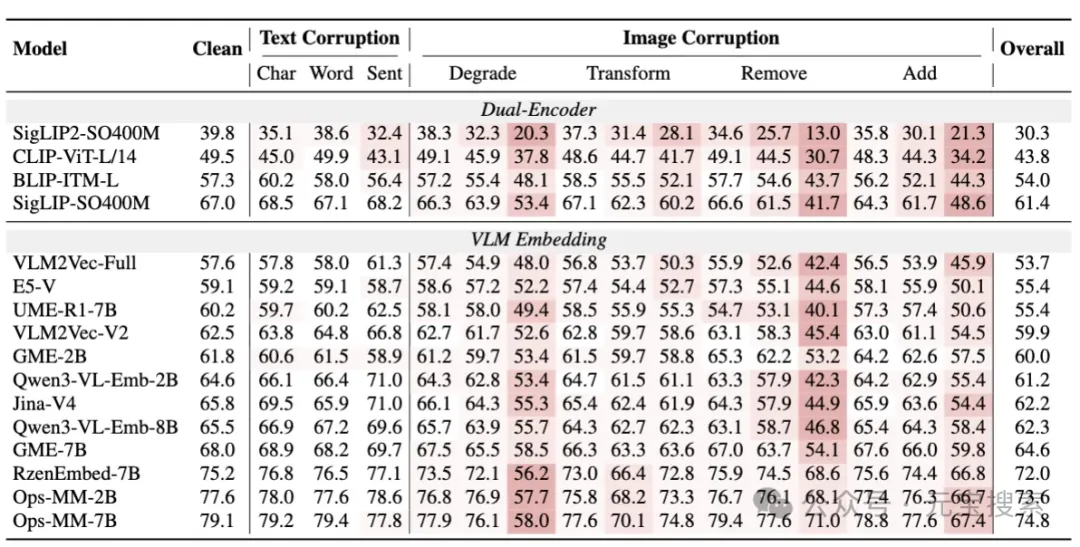
图 3:主结果表。Text 列为各字符/词/句子级文字干扰下的 Recall@1,Image 列为四类图像干扰在三个强度等级下的 Recall@1。颜色越深表示从干净分数退化越严重。
我们评测了多个主流多模态检索模型(涵盖双塔编码器与 VLM 嵌入模型两类),发现了三个系统性失败模式。
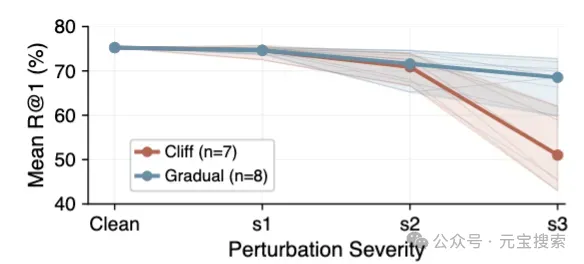
图 4:图像侧干扰强度响应曲线。红线(Cliff 组)代表随强度急剧崩塌的干扰类型;蓝线(Gradual 组)代表平稳下降的类型。
图像噪声影响最显著,且存在明显的断崖效应:模型能扛住轻度干扰,一旦噪声足以遮蔽或移除目标实体,排名急剧崩塌。轻度干扰几乎无影响,重度干扰下性能大幅下滑,且两个等级之间的差距远超线性关系。
四类操作中,REMOVE(裁剪/降采样)危害最大——直接切掉了目标实体,模型无从识别。水印、低光、马赛克等属于断崖型:轻度几乎无影响,重度直接崩溃。
业务含义:干净数据上排名高的模型,在重度图像噪声下可能急剧下滑,且两者之间没有稳定的相关性——不能用干净准确率代替鲁棒性评测。
反直觉的发现:文字被打错字、词序打乱之后,图文联合检索效果几乎没有变化。
但这不代表模型真的鲁棒——而是文字信号根本就没被有效利用。
在 snap-and-ask 场景里,用户的问句往往是粗粒度的意图表达:「这是什么花?」「这是什么品牌的鞋?」这类问句无法区分具体实体,只提供了类别信息。在包含同类别难负例的图库里,把这样的问句纳入检索,会让所有同类候选得分集体提升,反而稀释了本来很准的视觉排名。
我们把这种现象称为 coarse-text drag(粗文本拖拽):
视觉排名很准(目标 = 樱花)
↓ 加入问句「What flower is this?」
↓ 所有花卉类图片得分集体提升
↓ 樱花相对优势被稀释
↓ 图文联合排名 < 纯图像排名
更进一步验证:在绝大多数模型上,I→I(纯图像搜索)的 R@1 高于 IT→IT(图文联合搜索)——加了文字反而变差了。
业务含义:手机用户的问句并不是「多余的信号」,而是被固定融合权重过度使用了。问题不在于「文字有害」,而在于「融合策略无法感知当前这个问句是否真的有区分度」。
失败模式三:图文联合干扰「超加性」——最难预测的失效图像噪声让 R@1 下降 dI,文字噪声让 R@1 下降 dT,两者同时出现时下降的是 dI + dT 吗?
这意味着:分别做图像鲁棒性和文字鲁棒性测试,无法预测两者同时出现时的真实表现。真实用户往往同时贡献噪声图像和嘈杂问句,单模态压测不足以覆盖这种场景。
业务含义:鲁棒性评测必须包含图文联合噪声条件。这也是 SnapBench 的核心贡献之一——提供了系统化的联合噪声评测框架。
三个失败模式共同指向同一个根因:固定融合权重无法感知每个 query 的模态信号质量:
· 图像清晰时,视觉信号可信,应该多信图像;
· 图像模糊/被裁剪时,视觉信号不可信,应该降低图像权重;
· 问句是粗粒度类别描述时,文字没有区分度,应该少信文字;
· 问句比较精确时,文字能够帮助排名,应该更多利用文字。
固定融合无法感知这种逐查询的信号质量变化,导致了上述三种失败模式。
针对这一问题,我们提出了一套自适应模态融合策略,能够基于每个 query 自身的检索分布动态估计各模态的信号可靠性,并据此调整融合权重,无需额外训练,可直接接在现有检索模型之上使用。
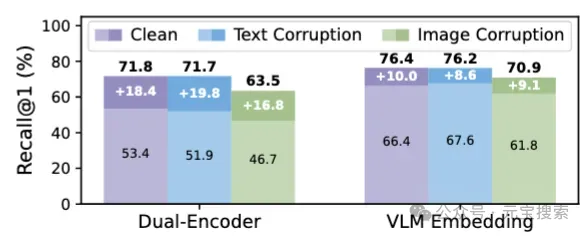
图 5:自适应融合策略在 SnapBench 上的效果(平均 Recall@1)。较深的区域表示相比固定融合的提升幅度。左侧为双塔编码器,右侧为 VLM 嵌入模型。
自适应融合在干净输入、文字干扰、图像干扰三种条件下均带来稳定且显著的收益,双塔编码器和 VLM 嵌入模型两类架构均有明显改善。
这个结果同时验证了一个结论:用户文字本身并没有问题,问题是固定融合不知道什么时候该信它、什么时候该减少它的权重。自适应融合让文字在它真正有区分度的时候发挥作用,在它只是粗粒度类别提示时自动降权。
在所有参评模型中,干净数据表现领先的模型在鲁棒性上不一定同样领先——在部分模型上,干净准确率与鲁棒性的排名存在明显错位:
· 部分模型干净数据排名靠前,但在重度图像干扰下骤降,鲁棒性明显弱于排名接近的其他模型;
· 部分模型在图文联合干扰时的超加性效应尤为突出,说明两个信号同时劣化时特别脆弱;
· 相对而言,融合策略更稳健的模型在联合干扰场景下表现更为稳定。
核心结论:干净准确率和鲁棒性必须分开评测,不能互相代替。
09工程落地视角:SnapBench 对业务有什么价值对于任何做手机端「以图搜物」或「拍照提问」的业务,SnapBench 提供了一套可直接复用的鲁棒性评测框架:
· 覆盖数十个受控噪声条件,系统化覆盖移动端真实噪声分布;
· 配对设计保证每个指标下降都可以被归因到具体的噪声类型;
· 提供了图文联合噪声下的「最难场景」评测,帮助发现线上系统的真实瓶颈。
在实际业务评测时,可以用 SnapBench 的噪声分类框架来指导内部测试集构建:比如专门压测「低光拍摄」「截图带浮层」「问题只输入类别词」等高频真实场景。
手机拍照找货是最典型的 snap-and-ask 场景。用户拍下路上看中的一件衣服、一双鞋或一个包,输入一个简单问题,系统要从海量商品库里找出对应商品。
· 图像质量差:环境光不稳定、角度刁钻、局部遮挡;
· 问句粗放:用户只说「这双鞋是什么牌子?」,无法区分相似款式;
· 同类候选多:同色系、同风格、不同款式的商品是标准难负例。
SnapBench 的三大失败模式在这个场景都有直接对应:
· 图像干扰(断崖效应)对应「拍照质量差导致检索失败」;
· coarse-text drag 对应「问句只有类别词,联合检索不如纯图像」;
· 超加性效应对应「图质差 + 问句模糊同时出现时的双重打击」。
自适应融合策略在干净数据上也有大幅提升,说明即便没有噪声,当前固定融合策略也在很多情况下过度依赖文字侧——这在手机拍照找货场景中是一个普遍痛点。
内容平台上的识图功能,用户上传的图片天然包含大量噪声:手机截图带 UI 元素、二次压缩的图片、光线不佳的拍摄,以及有时候只是随手截了一小片局部。
SnapBench 的 ADD(水印/UI 浮层)和 REMOVE(裁剪/降采样)条件与这类业务场景高度对应。评测结果表明,这两类干扰在重度时具有断崖效应,是最应该针对性优化的场景。文字侧,内容平台的用户问句往往更口语化、更粗放(「这个是什么?」「求同款」),coarse-text drag 问题在这类平台上尤为突出,适合引入自适应融合策略来降低粗问句对视觉排名的干扰。
手机 AI 助手的拍照提问功能(如「拍一拍」「看一看」),用户对答案准确率的期望很高,但输入质量往往参差不齐。
SnapBench 的评测框架能够帮助这类产品回答一个关键问题:系统在哪些噪声条件下是稳健的、哪些条件下是脆弱的? 这个问题的答案决定了产品需要在哪些场景下给用户加入「图像质量提示」或「问题补全引导」等保护机制。
对于需要在多个检索模型之间做选型的团队,SnapBench 提供了一个重要的评测维度:不能只看干净数据准确率,还要看鲁棒性表现。
实验结果表明,干净数据排名和鲁棒性排名之间存在明显错位(某些模型干净高但鲁棒差,某些模型干净一般但噪声下更稳定)。结合业务的真实噪声分布,选择「在业务关键噪声条件下更稳健」的模型,比单纯追求干净数据指标更有实际价值。
自适应融合策略作为 training-free 的轻量方案,为更复杂的融合策略研究提供了基线参照:
· 在图像干扰严重时,自适应融合收益更大;
· 当干扰完全移除了目标实体时,自适应融合也无法完全挽救(因为信号本身已不存在)。
这些规律为后续研究指明了方向:融合策略的上限取决于视觉信号的可用性,改善底层视觉表示的抗噪能力比优化融合策略更根本。
编辑:夏乔林
感谢阅读,欢迎关注元宝搜索团队,一起探索多模态前沿
如文章对您有帮助,欢迎点赞、在看、转发三连
您的支持是我们的动力
THANKS FOR READING
