当前位置:首页>排行榜>司南榜单|大模型官方评测榜单更新,Kimi K3.1 Pro 位列全量评测基准榜第二

司南榜单|大模型官方评测榜单更新,Kimi K3.1 Pro 位列全量评测基准榜第二

  • 更新时间 2026-10-30 20:49:18
司南榜单|大模型官方评测榜单更新,Kimi K3.1 Pro 位列全量评测基准榜第二

Kimi K3.1 Pro 于 2026 年 10 月 24 日发布,是 K3.1 系列的首个模型,月之暗面官方将其定位为 Kimi 当前最强的 3T 级参数开源权重模型。

官方资料介绍显示,该模型支持最高 100 万 token 上下文窗口与原生视觉理解,并在编程、3D 创作、金融研究及长程 Agent 任务上表现突出。

基于司南官方大模型评测榜单 V3.0 评测方案,司南对Kimi K3.1 Pro 开展了系统性评测,并在当前大模型官方评测榜单上,对 Kimi K3.1 Pro 的评测结果进行更新。

榜单链接:

https://rank.opencompass.org.cn/leaderboard/llm

  评测结果  

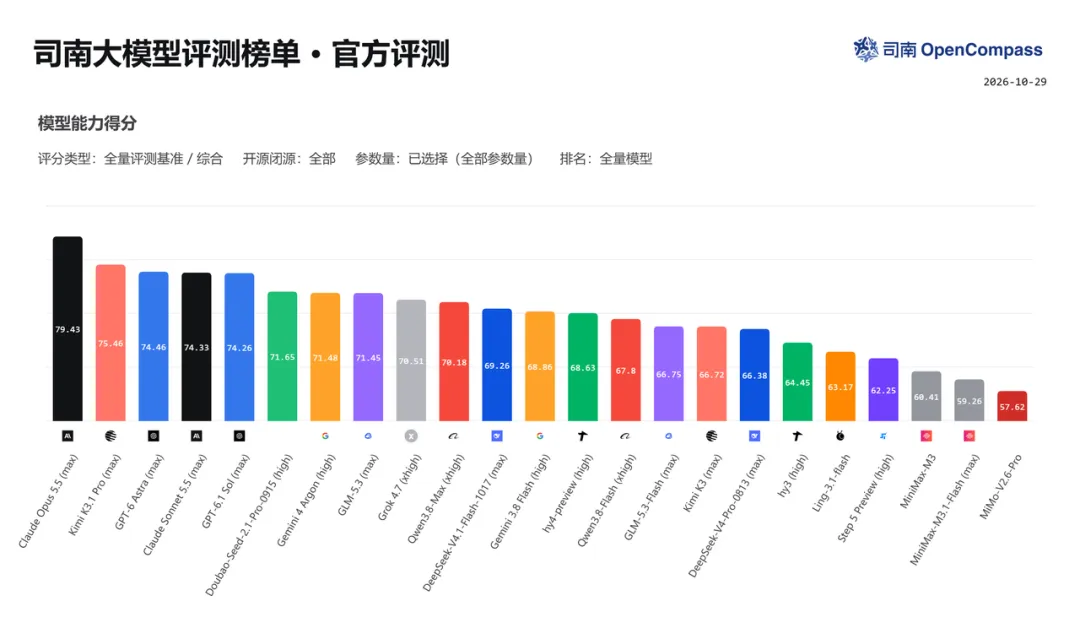
在司南大模型官方评测榜单纳入的 23 个模型中,Kimi K3.1 Pro 以75.46 分 位居全量评测基准榜第二,以78.47位居仅文本评测基准榜第一。

从能力表现看,Kimi K3.1 Pro 的优势主要集中在推理、任务规划与工具使用、数据分析及深度研究等维度;知识能力表现相对偏弱,为主要短板。多模态评测表现不及纯文本评测下的水平。

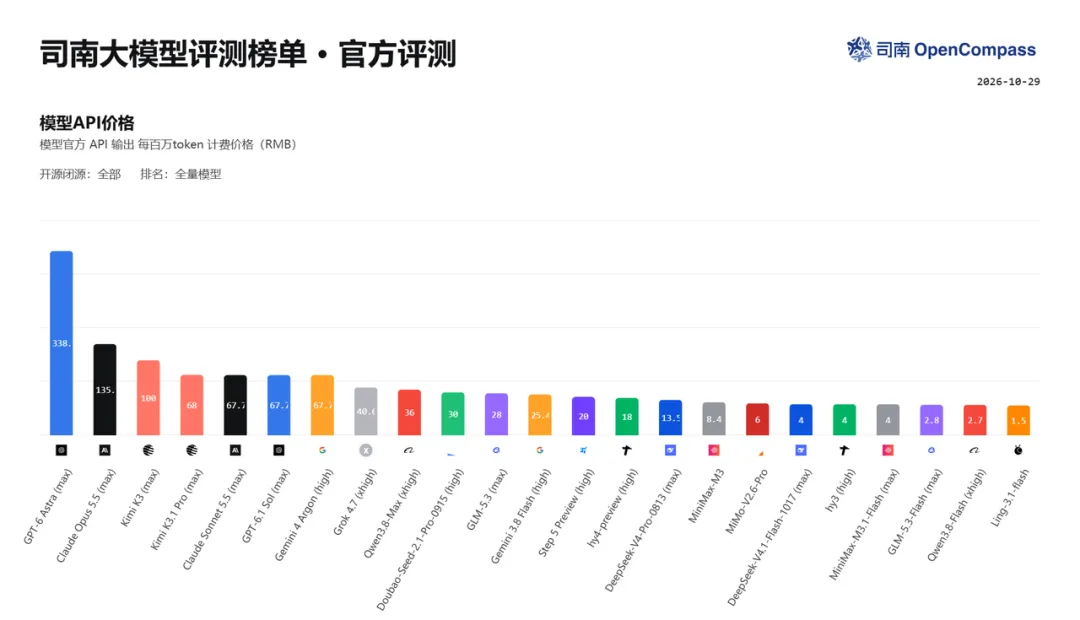
此外,该模型推理速度处于榜单后段;在使用成本上,其 API 定价在参评模型中处于较高区间。

01

Kimi K3.1 Pro 能力维度得分

Kimi K3.1 Pro 在仅文本评测基准榜领先 Claude Opus 5.5 0.22 分,位居第一;在全量评测基准榜落后 Opus 3.97 分,领先第三名 GPT-6 Astra 1.00 分, 位居第二。

维度

仅文本评测基准得分

仅文本评测基准榜排名

全量评测基准得分

全量评测基准榜排名

综合

78.47

第 1

79.43

第 2

知识

72

并列第 5

69.33

并列第 8

抽象

80

并列第 2

76.67

第 6

推理

87.5

第 1

85

并列第 2

交互

75.86

第 2

75

并列第 1

安全

82.93

第 3

74.24

并列第 6

智能体

72.53

第 1

72.53

第 1

左右滑动查看更多

大模型官方评测榜单 Kimi K3.1 Pro 能力评测结果

其中,推理与智能体是最突出的两项能力。交互能力表现也位于前列,在当前全量评测基准榜单排名中,Kimi K3.1 Pro的在交互维度得分最高,得分与Claude Opus 5.5、Gemini 4 Argon 并列第一。

知识能力是 Kimi K3.1 Pro 的相对弱项:在全量评测基准榜中,其知识维度得分位列第 8,较排名第一的 Claude Opus 5.5落后 12 分。

排名

模型

综合

知识

抽象

推理

交互

安全

智能体

1

Claude Opus 5.5

79.43

81.33

78.33

86.44

75

83.33

72.12

2

Kimi K3.1 Pro

75.46

69.33

76.67

85

75

74.24

72.53

3

GPT-6 Astra

74.46

73.33

80

80

65.91

78.79

68.72

4

Claude Sonnet 5.5

74.33

75.68

80

81.36

72.09

75.76

61.1

5

GPT-6.1 Sol

74.26

77.33

83.33

75

70.73

71.43

67.71

左右滑动查看更多

大模型官方评测榜单 全量评测基准综合排名前5模型

排名

模型

综合

知识

抽象

推理

交互

安全

智能体

1

Kimi K3.1 Pro

78.47

72

80

87.5

75.86

82.93

72.53

2

Claude Opus 5.5

78.25

80

75

84.62

72.41

85.37

72.12

3

Claude Sonnet 5.5

75.56

76

80

79.49

71.43

85.37

61.1

4

GPT-6.1 Sol

75.19

78

85

77.5

69.23

73.68

67.71

5

GPT-6 Astra

74.3

72

80

82.5

62.07

80.49

68.72

左右滑动查看更多

大模型官方评测榜单 仅文本评测基准排名前5模型

Kimi K3.1 Pro 在文本推理与智能体任务上表现突出,支撑其在仅文本评测基准榜单登顶;Claude Opus 5.5 在知识、安全维度上表现更均衡,因此在全量评测基准的综合得分保持领先。

02

模型推理速度、价格与 Token 消耗

指标

Kimi K3.1 Pro

当前参评23 

模型中的排名

推理速率

37 Token/s

越快越靠前,排名第22

Token消耗

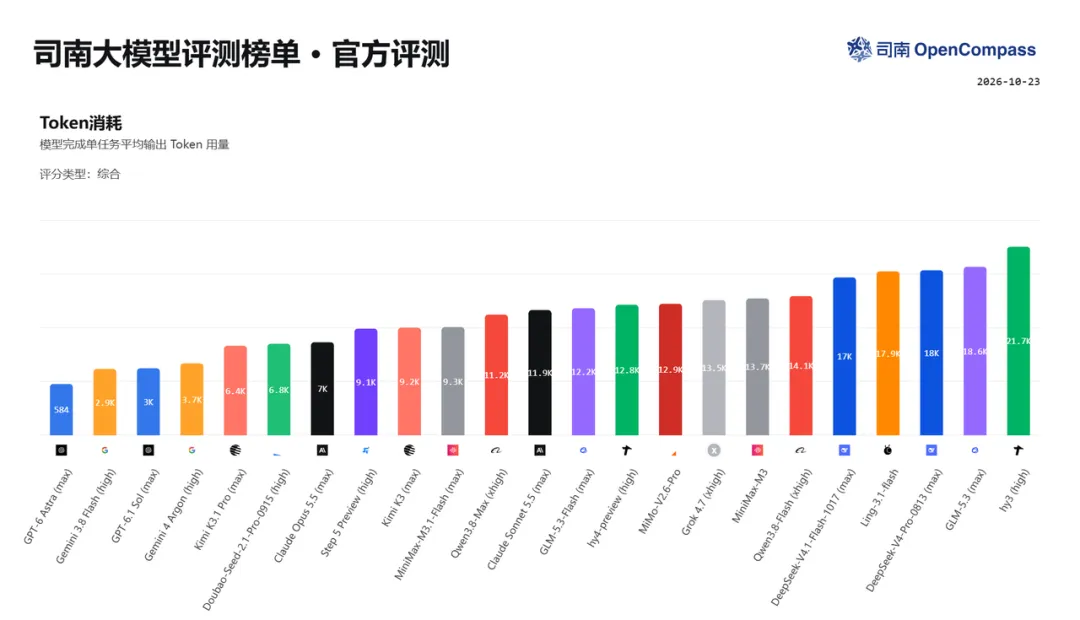
6,441.52 Token/任务

从少到多,排名第 5

模型API价格

68 元 /百万输出Token

从低到高,排名第 20,即第 4 贵

大模型官方评测榜单 Kimi K3.1 Pro 推理速率、Token消耗及模型API价格

模型

推理速率Token/s

Token消耗 Token/任务

模型API价格元 /百万输出Token

Kimi K3.1 Pro

37

6,441.52

68

Claude Opus 5.5

118

7,001.27

135.4

GPT-6 Astra

54

584.34

338.5

Claude Sonnet 5.5

135.08

11,923.05

67.7

GPT-6.1 Sol

52

2,982.78

67.7

左右滑动查看更多

全量评测基准榜综合排名前5模型 推理速率、Token消耗及模型API价格

汇率计算:1 USD = 6.77 RMB

推理速度表现偏弱。Kimi K3.1 Pro 推理速率约为 Claude Opus 5.5 的三分之一。在交互频繁、要求快速响应的场景中,较高的能力得分未必能抵消等待时间带来的影响。

价格在头部模型中相对具有优势,但仍属较高价位。 Kimi K3.1 Pro每百万输出token价格约为Claude Opus 5.5 的一半、GPT-6 Astra 的五分之一,与 Claude Sonnet 5.5、GPT-6.1 Sol 接近;在全部 23 个参评模型中,价格仍排第四高。

Token 消耗处于榜单较低水平,在排名前五模型中居中。 Kimi K3.1 Pro的完成单任务平均输出 Token 用量低于Claude Opus 5.5、Claude Sonnet 5.5,高于 GPT-6.1 Sol、GPT-6 Astra。

03

模型优势能力

推理:批判性思考突出,推理表现较好

Kimi K3.1 Pro 在全量评测基准下的推理维度得分为 85 分,并列榜单排名第二,距离排名第一的 Claude Opus 5.5 相差1.44分。在批判性思考过程子维度中,得分 93.33,排名第一。数理推理水平与 Claude Opus 5.5 持平。

空间与物理推理仍有提升空间。Kimi K3.1 Pro 的全量得分为73.33 分,低于 Claude Opus 5.5 的 85.71 分和 Claude Sonnet 5.5 的 78.57 分。

Kimi K3.1 Pro 的推理优势主要体现在数理关系处理和批判性判断上。

模型

推理平均分

逻辑推理

数量推理

空间与物理推理

批判性思考过程

Kimi K3.1 Pro

85

86.67

86.67

73.33

93.33

Claude Opus 5.5

86.44

93.33

86.67

85.71

80

GPT-6 Astra

80

86.67

80

73.33

80

Claude Sonnet 5.5

81.36

86.67

73.33

78.57

86.67

GPT-6.1 Sol

75

86.67

80

60

73.33

左右滑动查看更多

全量评测基准榜综合排名前5模型推理能力得分

智能体:任务规划、工具使用和研究分析较强

Kimi K3.1 Pro 在全量评测基准下的智能体得分为 72.53 分,略高于 Claude Opus 5.5 的 72.12 分。

Kimi K3.1 Pro 在任务理解规划与工具调用上领先 Claude Opus 5.5 模型3.70 分,在数据分析与深度研究上领先 Claude Opus 5.5 模型 5.32 分。这两项子维度较高得分表明模型在拆解目标、组织步骤、调用工具和整合信息的任务上具备较好的能力。

代码与终端执行则相对较弱,Kimi K3.1 Pro 在此子维度得分52.23 分,在前五模型中排第四,比Claude Opus 5.5低 7.80 分。模型在智能体总分领先并不意味着模型在代码执行、终端操作等方向全面领先。

模型

智能体平均分

任务理解规划与工具调用

代码与终端执行

数据分析与深度研究

Kimi K3.1 Pro

72.53

94.7

52.23

70.66

Claude Opus 5.5

72.12

91

60.03

65.34

GPT-6 Astra

68.72

90.37

54.54

61.26

GPT-6.1 Sol

67.71

88.85

53.74

60.55

Claude Sonnet 5.5

61.1

78.9

48.49

55.92

左右滑动查看更多

全量评测基准榜综合排名前5模型智能体能力得分

04

模型适用场景

综合本次评测结果,Kimi K3.1 Pro 整体表现处于参评模型第一梯队,通用能力基础较为完备。

其优势集中在推理、任务规划与工具使用、数据分析及深度研究方面,适用以下场景:

  • 复杂问题求解:数学与逻辑问题、条件分析、论证核验、方案比较、跨文档核对与多步推理。

  • 多步规划与工具协作:目标拆解、多步骤任务规划、工具选择与组合调用、根据反馈调整后续操作。

  • 数据分析与资料研究:围绕问题收集材料、组织分析并形成报告。

司南官方评测榜单采用动态更新机制。司南将持续关注国内外大模型发布动态,对主动选取的模型及模型厂商申请评测的模型开展评测,并在评测完成后及时更新榜单结果。

榜单页面将同步展示最近更新时间及最新上榜模型信息,便于用户持续跟踪最新模型能力表现与评测结果。

司南将通过构建公正、客观的 AI 评测体系,持续为模型研发、技术选型与产业应用提供可信赖的评测参考,促进人工智能技术发展与持续创新。
OpenCompass

欢迎关注「司南评测体系」公众号

长按识别二维码

添加「司南小助手」

长按识别二维码

加入「司南社区交流群」

随机文章