上个月有个团队救火,说模型分数一周涨了五个点,全员庆功。结果复盘发现,是有人手改了评测集,把几条难样本删了,分数自然虚高。更糟的是没人记得到底改了哪几条,旧版本也找不回,想回滚都没地方退。
这事儿的根因就一句:评测集没当代码管。模型权重过重,评测集轻飘,结论是建立在会变的地基上。
一、评测集是工程化的第一道闸门
模型分数本身没有意义,有意义的是和上一版比,在固定评测集上变好了还是变差了,测出来的结论才是地基。评测集一变,分数就失去可比性,所有回归判断都成了悬空。得把它当代码管,是工程化的第一道闸门。
二、版本化的四个动作
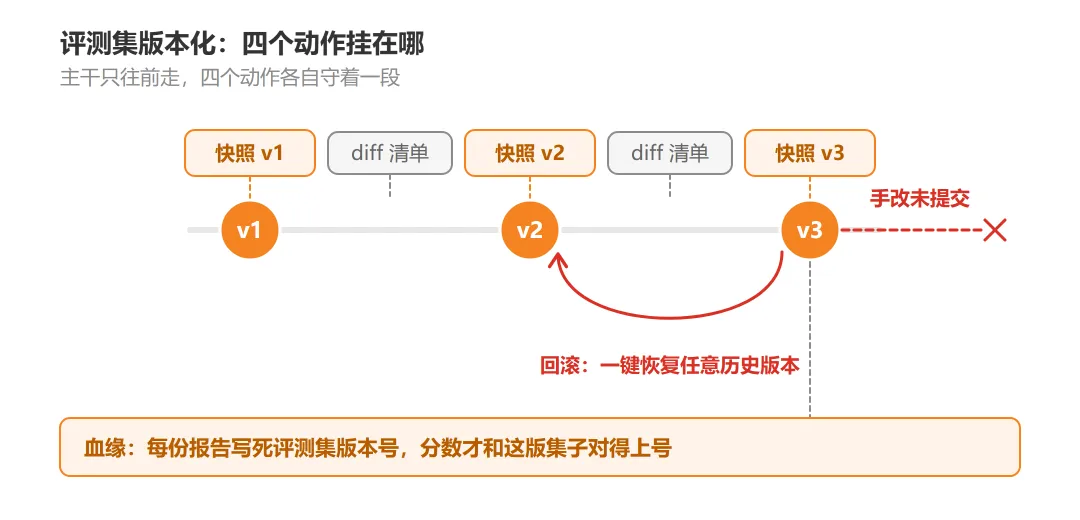
很多人以为版本化就是存个副本,那是备份不是版本化。真正有用的版本化是四个动作连起来的:
每个动作都自带一种偷懒方式,单做快照不做 diff,事后照样说不清。
先说快照,它最容易被误用成覆盖保存,但版本化的核心是「旧版不可删」,覆盖保存等于把地基抽走。
diff 是快照的搭档,没有 diff 的快照只是一堆说不出区别的副本,回滚时你不知道退到哪版是对的。
回滚看着简单,实则最依赖前两步:快照留了、diff 记了,回滚才退得回去;照上面那个团队的下场,想退才发现地已经被自己铲了。
血缘是收口,把「这次分数」和「这版评测集」绑死,报告里不写版本号,分数就是悬空的。
这四个动作里,diff 最常被省。但恰恰是它,能在「分数虚高」第一时间告诉你测试集子被人动过,比回滚更靠前一步拦住事故。
三、成熟度自查
常见错误是一上来就冲阶段四做平台,结果连阶段一的 Git 提交都没养成习惯,平台里塞的仍是会变的本地文件。阶段二把 diff 习惯立起来,回滚事故能少一大半。
四、落地实践
先把集子迁进 Git(哪怕先只做快照),再强制每次改动附 diff 清单,接自动化回滚,最后把版本号写进每份报告。
测试集这件事,前面已经讲到「怎么造」:真实日志采一批、专家标一批、合成反推一批、工单改造一批、公开基准借来交叉验证、难负专门补漏,六类怎么配比也有结论。造好之后是一片空白。造的时候很认真,改的时候没人记账,等到某天分数掉了,回头连上周跑的是哪版集子都答不上来。这里补的就是这本账。
与既有四件套(评测集、评分卡、裁判、难负)亦可衔接。管的就是四件套里的「评测集」本身:评分卡跟着版本走,裁判的判据也该版本化,难负的构造记录更要留痕。
- S(具体):把 1 个核心评测集迁入 Git,建立 tag 与 diff 清单规范。
- M(可衡量):每次改动 100% 附变更说明;报告里评测集版本号填写率 100%。
- A(可达成):复用现有集子文件,只加 Git 与提交规范。
- R(相关):评测集是前面所有评测方法论的共同地基,版本化是工程化落地第一步。
- T(有时限):首个核心链路下次评测前完成迁移;之后所有改动走版本流程。
一句话收尾
你那份评测集,现在是改了能退、分数能比,还是一变全乱、全凭印象?
大评测集(百万级)全量 Git 存储成本高,本文未展开 LFS 或分片方案,需按规模另行设计。