我先自报家门
我是leo,互联网干了十年,装过的AI工具两百多个,留下天天用的不到二十个。今天主推一条硬核消息,写给蹲开源模型的那批人。
国内团队DiffuSpace昨天放出Clover-35B-A3B-Preview,三叶草系列第一个版本。总参数350亿、激活30亿的MoE扩散语言模型,Apache许可,权重挂在HuggingFace和ModelScope上,SGLang和llama.cpp都能跑。
先说这是个啥
现在的语言模型基本都是自回归的,一个字一个字往外蹦,前面定了后面才能写。扩散路线反着来:先出个模糊的全局草稿,多轮迭代逐步变清晰,像画画先起形再细化。港大NLP实验室的Dream 7B证明过小尺寸能打,累计下载270万次;Clover要回答的是放大到350亿还行不行。答案是行,而且它支持思考模式,通用能力也没偏科,逻辑推理和长文本理解的评测成绩达到或超过同尺寸的自回归模型。
它好在哪?我列三个
第一,编程和工具调用是真强,六项Agent评测一项没丢。官方博客的数:全部同场最高分,SWE-bench Verified 73.6,Terminal-Bench 2.1拿51.7,比同为35B-A3B的MiniCPM-V 4.7高出28分和15.7分,这个差距在基准测试里不算小了。
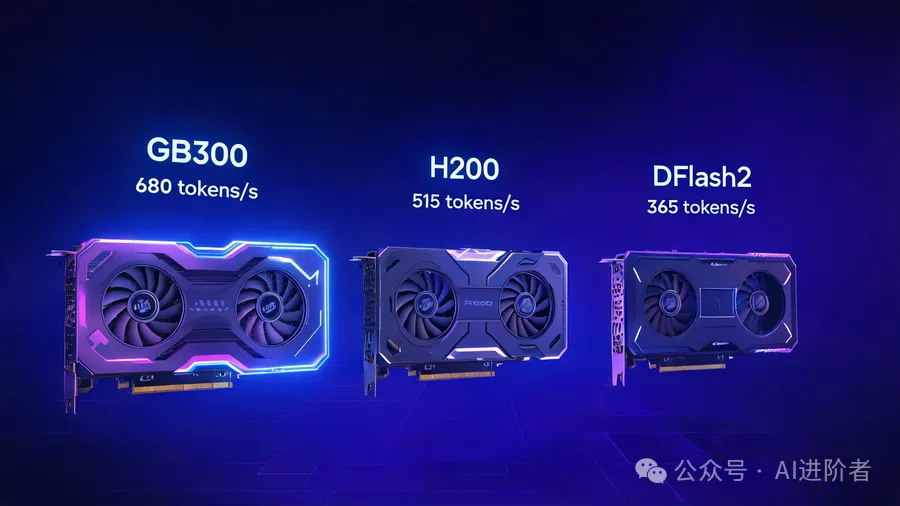
第二,快,快在刀刃上。单张GB300显卡,Agent场景实测680 tokens/s;H200上515,对照组DFlash2只有365。还有个49项网页任务的对拼,Clover执行耗时中位数1.52秒,Gemini3.6 Flash要8.86秒。
第三,端侧塞得下,这点对个人玩家最实在。INT4量化之后在16GB显存的RTX 5070 Ti上跑通,MATH-500出字速度101.8 tokens/s,对照组才48.5,快了一倍还多。以前35B级模型想本地跑,显存门槛直接把大部分人拦在门外,现在一张中端卡就够。
leo多说两句
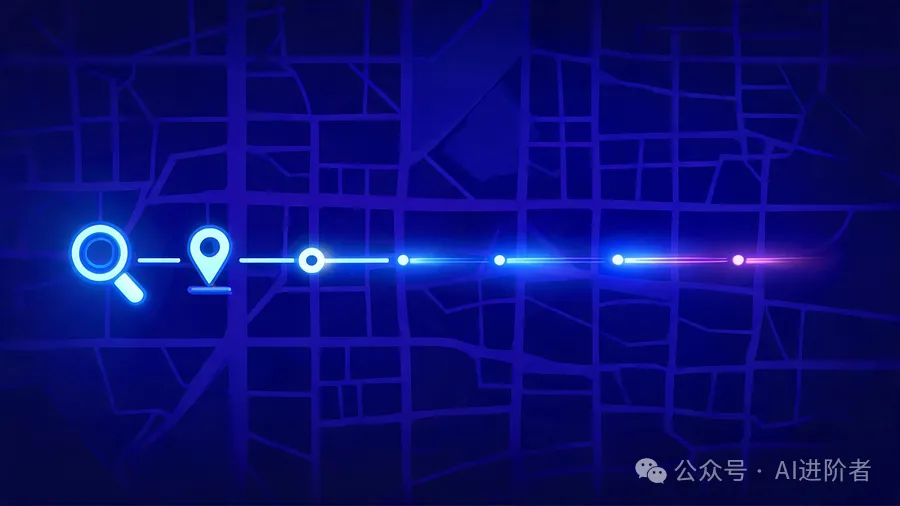
很多人觉得聊天模型卷速度没用,快半秒能省几个钱。这笔账在agent场景是另一个算法:智能体干活是几十步连着走的,每一步的延迟都会往下一步累加,链条越长账越吓人。官方找门店的demo很说明问题——地图搜索不带位置信号,Clover识别出结果跑偏,逐步改写检索、卡住了还知道重置重填,用28步、169.9秒完成;Qwen3.6 Flash用满30步、578.3秒,还停在347公里外的门店,任务没过。差距不在聪明不聪明,在反馈回路转得快不快。我的判断:接下来一年,扩散模型会先在编程和agent场景啃下一块地盘,通用聊天反倒最后变天。蹲开源的这批人值得把权重拉下来跑跑看,端侧跑通的那天,本地agent就不再是PPT了。
leo的用法清单,五条
1. 想先白嫖的,去chat.diffuspace.ai申请在线体验,审核制,早排队早拿到,别等热度上来再挤。
2. 显卡16GB以上的,直接去HuggingFace下INT4量化版,llama.cpp加载就能跑,一张中端卡的事。
3. 测它就测多步agent任务,让它连续完成几个有依赖关系的操作,单轮问答体现不出扩散架构的差别。
4. SGLang跑不通先翻GitHub的issue区,新模型头一周的坑基本都堆在那里,别自己硬磕。
5. 别急着替换主力模型,拿你手上最熟的那个任务并排跑一遍,看出字速度差距再下结论。
收个尾
扩散模型从画图卷到写代码,这次是真拿分数说话的。我是leo,关注我,每天5个AI新工具,都用得上。
相关阅读
1. Gemini4Carbon首发2美元,输出价直接砍半
2. 跑分榜60%权重换成隐藏题
3. Hi3D开源可商用,一张图生成3D模型
4. 128GB统一内存,MBP把大模型装回家了