以前我有个习惯:让 AI 干活之前,先把能找到的资料全贴进去,三十页文档、两个月的聊天记录、一堆参考稿,生怕它少看了什么。
结果经常是:回答绕来绕去,该用的那一条没用上,不该用的旧说法倒被引得头头是道。
后来我才慢慢想明白一件事:喂资料不是比谁喂得多,是让它在做这件事的时候,手边只有这件事需要的东西。
下面是我现在的做法,按「怎么喂」拆成四种,再按场景选。
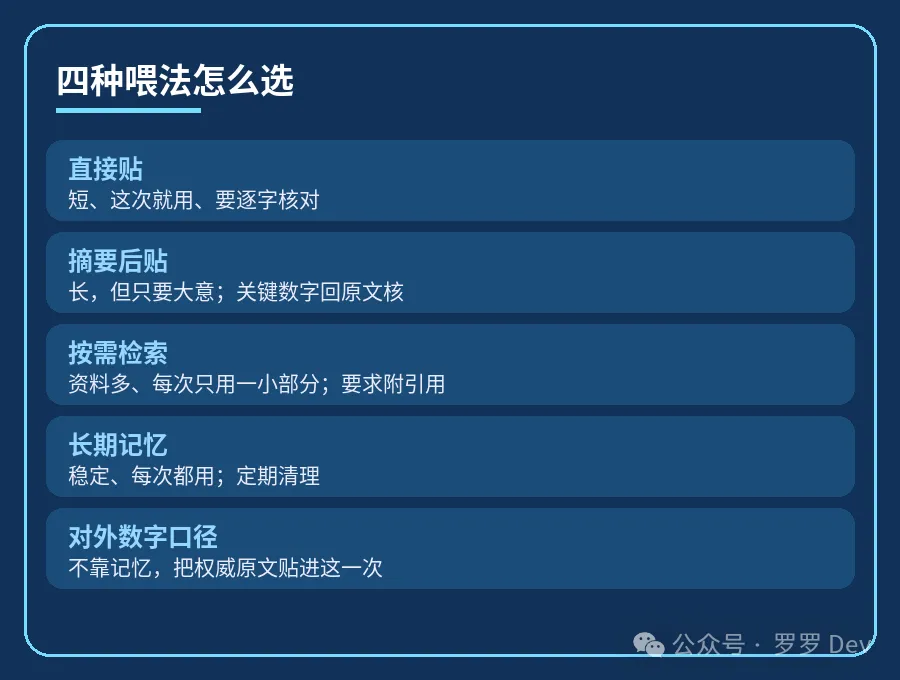
四种喂法怎么选
主线:先问三个问题,再决定怎么喂
动手之前,我只问自己三句:
资料有多大? 一页纸和一百页,不是一回事。
资料多久变一次? 今天的会议记录,和三年不变的写作规范,处理方式完全不同。
这件事错了代价多大? 随手润色一句话,和对外发出去的数字口径,容错度天差地别。
三个问题答完,大致就知道该用哪一种。
第一种:直接贴
把原文整段贴进对话。
适合:资料短(一两页以内)、这次就要用、要逐字引用或核对的。比如:一份合同的某一条、一封要回复的邮件、一段要改的稿子。
好处是信息零损失,它看到的就是原文。代价是占地方,贴多了,后面的内容容易被挤到边上,它的注意力也会被分散。
我的规矩:需要它逐字对着原文干活,才直接贴;贴之前,先把无关的段落删掉。
第二种:摘要后贴
先让 AI 或我自己把资料压成一页要点,再把要点贴进去。
适合:资料较长,但这次只需要「大意」和「关键事实」。比如:一份三十页的调研报告,今天只是要写一段背景介绍。
好处是省地方、重点集中。风险是摘要本身会丢信息,甚至在压缩的过程中把意思悄悄改了。
所以摘要后我会做两件事:关键数字和结论,对着原文核一遍;摘要里保留「这条出自哪一页」,以后要查原文,不用重翻。
第三种:按需检索
资料放在外面,需要时只取相关的那几段给它。
适合:资料多、而且每次只用到一小部分。比如:一堆历史文档、产品说明、自己的笔记库。
两种常见做法:自己手动搜到相关段落再贴,或者用带「知识库/检索」功能的工具,让它先搜再答。
这种方式最怕的是搜不准:取回来的不是你要的那段,它却会很自信地基于错的段落作答。所以我会要求它「答案后面附上引用的原文片段」,一眼就能看出取对没有。
第四种:长期记忆
让工具记住你的偏好、背景、固定的做事规则,不用每次重说。
适合:长期不变、每次都要用的东西。比如:我的写作口吻、禁用的词、常用格式、我所在的行业背景。
好处是省事。风险有两个:记住的东西会过期,而它不会主动提醒你;记错了,你也不一定发现。
所以我对记忆的态度是:只放稳定的、对错一眼能看出来的内容;会变的、涉及数字和事实的,不放记忆里,放在这一次的资料里。 每隔一阵,我会翻一遍它记了什么,把过期的清掉。
四种喂法,按场景对照着选
改一段稿子、回一封邮件 → 直接贴。短,要逐字对着干。
读完一份长报告,写一段背景 → 摘要后贴,关键数字回原文核。
从一堆旧文档里找某个说法的依据 → 按需检索,并要求附引用原文。
每次都要用的写作规则、口吻 → 长期记忆,定期清理。
对外发的数字、口径 → 不靠记忆,把权威来源直接贴进这一次的对话里,让它照着原文写。
探索一个新话题,还不知道要什么 → 先别喂太多,先让它提问,问清方向再补资料。
记一句:越是会变、越是错不起的,越要放在「这一次」的资料里;越稳定、越是每次都用的,才值得放进记忆。
什么时候别塞全量
你自己还没想清楚要什么。 这时塞再多资料,得到的只是更长的、同样模糊的回答。先说清目标,再给资料。
资料里有互相矛盾的版本。 新旧两版口径一起塞进去,它不一定会选对的那一版。要么删掉旧的,要么明确告诉它「以哪份为准」。
任务只用得到其中一小段。 为了「保险」塞全量,等于把答案淹在里面。宁可少贴,让它说「信息不够」,也别让它在噪音里瞎猜。
资料里有敏感内容。 密码、客户隐私、内部未公开的数字,能不贴就不贴,要用的话,先脱敏,再用公司允许的工具。
你想让它「全部都记住」。 一次对话里喂的东西,不等于它都会用上。重要的约束,放在开头和结尾各说一次,比塞十份资料管用。
我现在的默认动作
先问三句:多大、多久变、错了代价多大。
短的直接贴,长的先压,多的按需取,稳定的才进记忆;用不上的,一律不塞。
AI 不是越喂越聪明,是越喂得准,越好用。上下文也一样,能力不在多,在对得上这件事。
你给 AI 喂资料的时候,是习惯全贴,还是会先删一删?评论区聊聊。
