面试官:AI的评测指标有哪些? 被问蒙了. 背下来 这 6大 Agent 基线指标 + RAG 4大基线指标 ,定义、公式、原理 系统拆解 ,吊打面试官
- 更新时间 2026-10-30 10:28:28
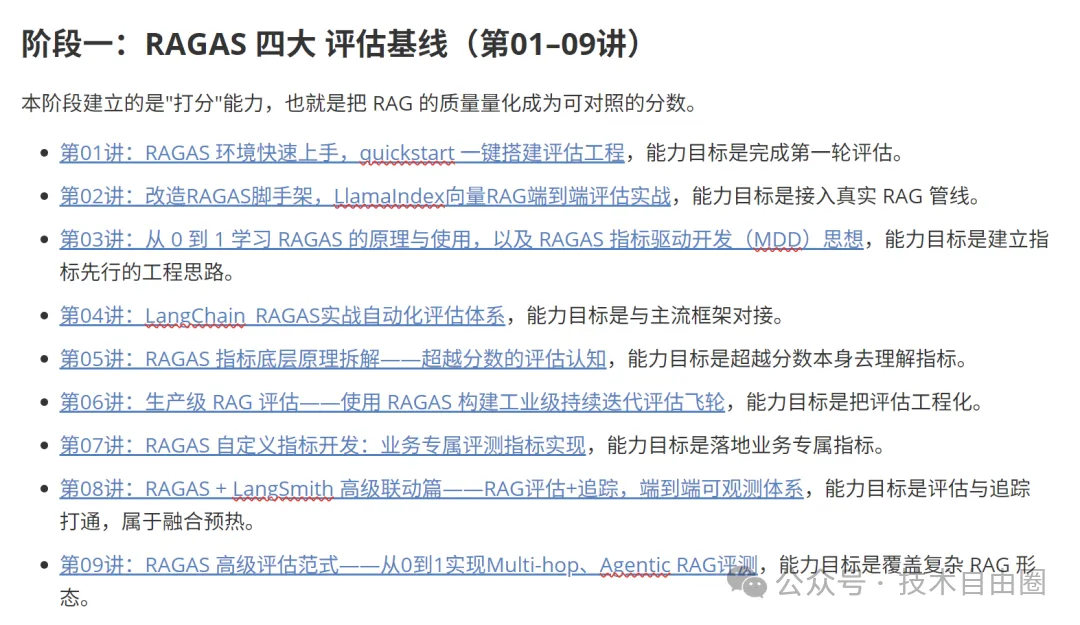
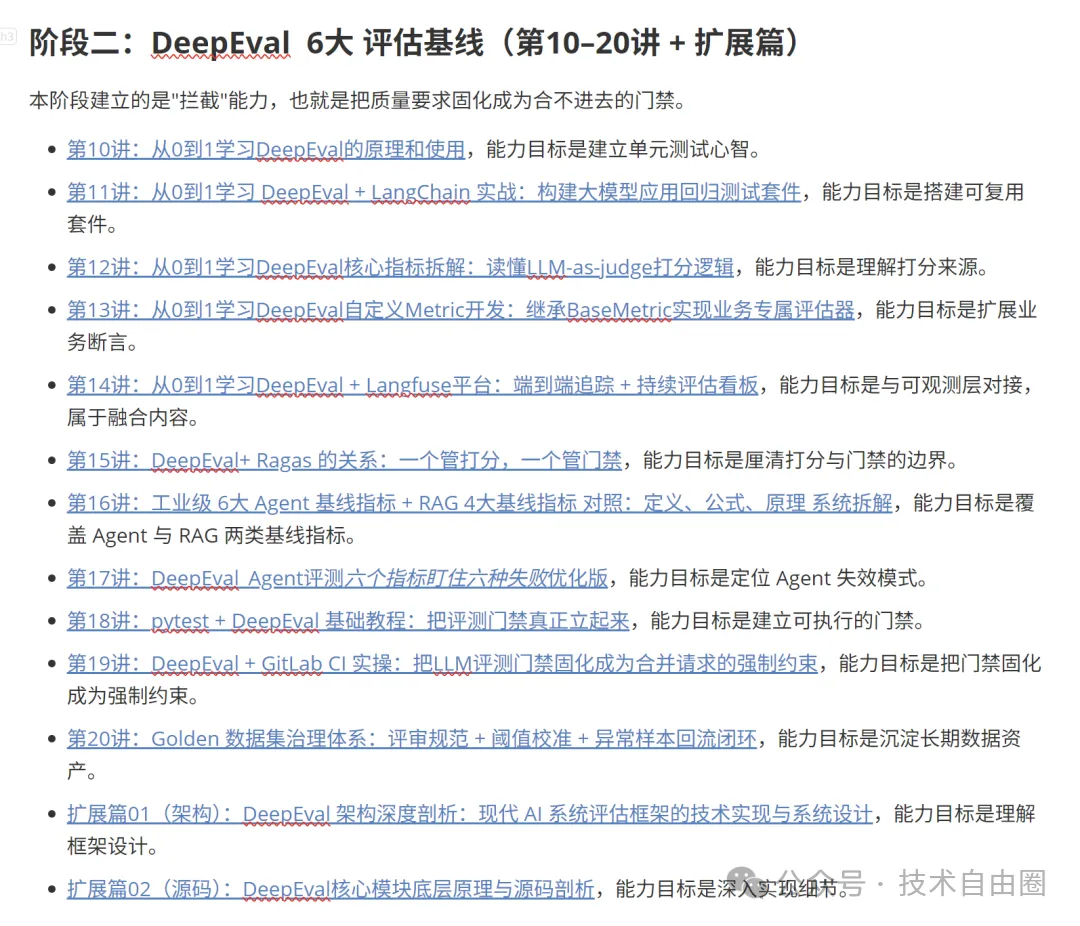
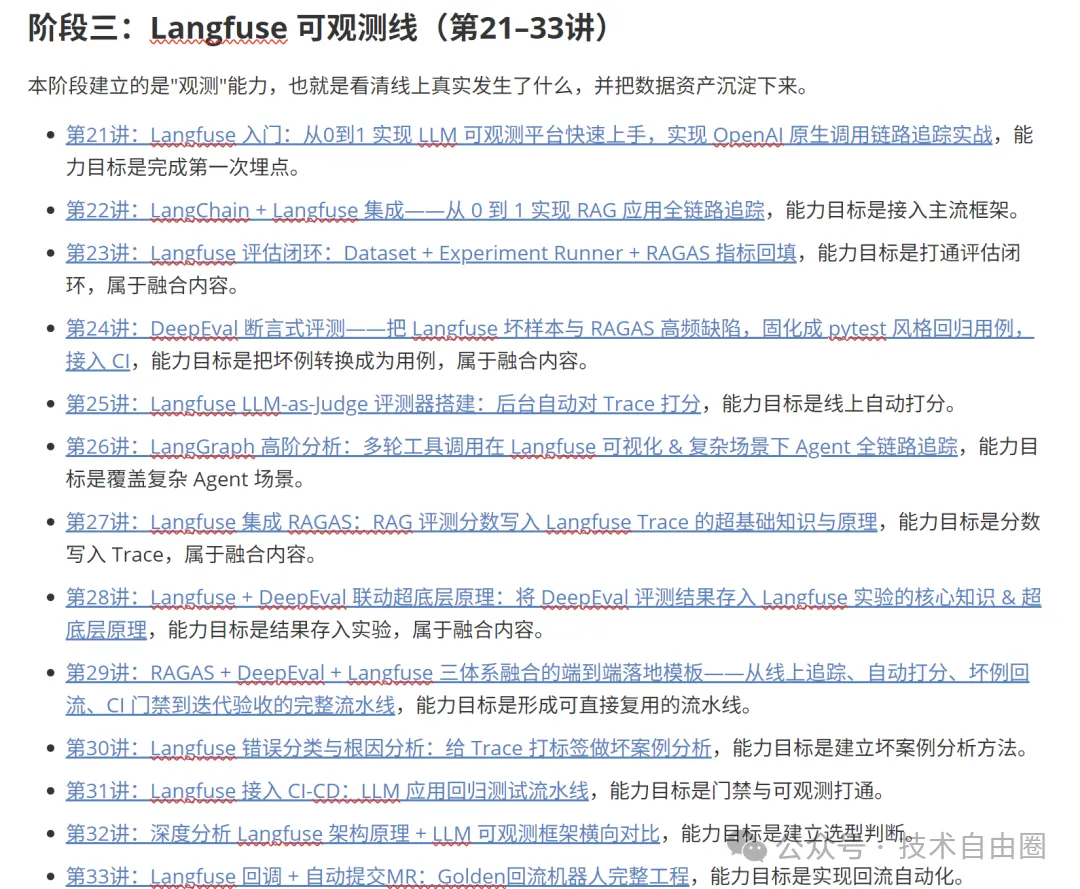
面试官:AI的评测指标有哪些? 被问蒙了. 背下来 这 6大 Agent 基线指标 + RAG 4大基线指标 ,定义、公式、原理 系统拆解 ,吊打面试官在45岁老架构师 尼恩的读者交流群(50+)中,最近有小伙伴拿到了一线互联网企业如得物、阿里、滴滴、极兔、有赞、希音、百度、网易、美团、蚂蚁、得物的面试资格,遇到很多很重要的相关面试题: 比如,前几天,一个 面大厂挂了的小伙伴, 遇到了 这个 面试题: 伙伴没有系统的去梳理和总结, 面试官不满意,面试挂了。 赶紧来找尼恩复盘。 在这里,尼恩给大家做一下系统化、体系化的梳理,写了一个 《尼恩团队 AI 评测 三剑客 学习圣经 30讲 》,使得大家内力猛增,可以充分展示一下大家雄厚的 “技术肌肉”,让面试官爱到 “不能自已、口水直流”,然后实现”offer直提”。 当然,这道面试题,以及参考答案,也会收入咱们的 《尼恩Java面试宝典PDF》V175版本,供后面的小伙伴参考,提升大家的 3高 架构、设计、开发水平。 Agent 评测指标这两年,正在从大家各自手写一套打分提示词的状态,慢慢收敛到具备行业共识的基线体系里面。 目前工业级 6大 Agent 基线指标 是 PlanQuality、PlanAdherence、ToolCorrectness、ArgumentCorrectness、TaskCompletion、StepEfficiency 这六个指标。 这也是 《尼恩团队 AI 评测 三剑客 学习圣经 30讲 》 结合 DeepEval 落地场景里进行详细介绍的 核心指标,也是 使用范围比较广的一套 基线指标。 
6大 Agent 基线指标, 并不是框架开发者凭空定义出来的,而是把 Snowflake 那篇 Agent GPA 论文里面 Goal-Plan-Action 的对齐思想,再做工程层面收敛之后得到的产物。 6大 Agent 基线指标, 叠加工具调用评测方向里面已经沉淀成熟的各类指标,非常 工业级。 本文,尼恩会把这六个指标的定位、计算公式、底层原理逐一梳理清楚,后面单独拿出一个完整章节,和 RAG 基线指标做正面的对照辨析,把它们表面看着相似、内核却完全不一样这件事讲透彻。 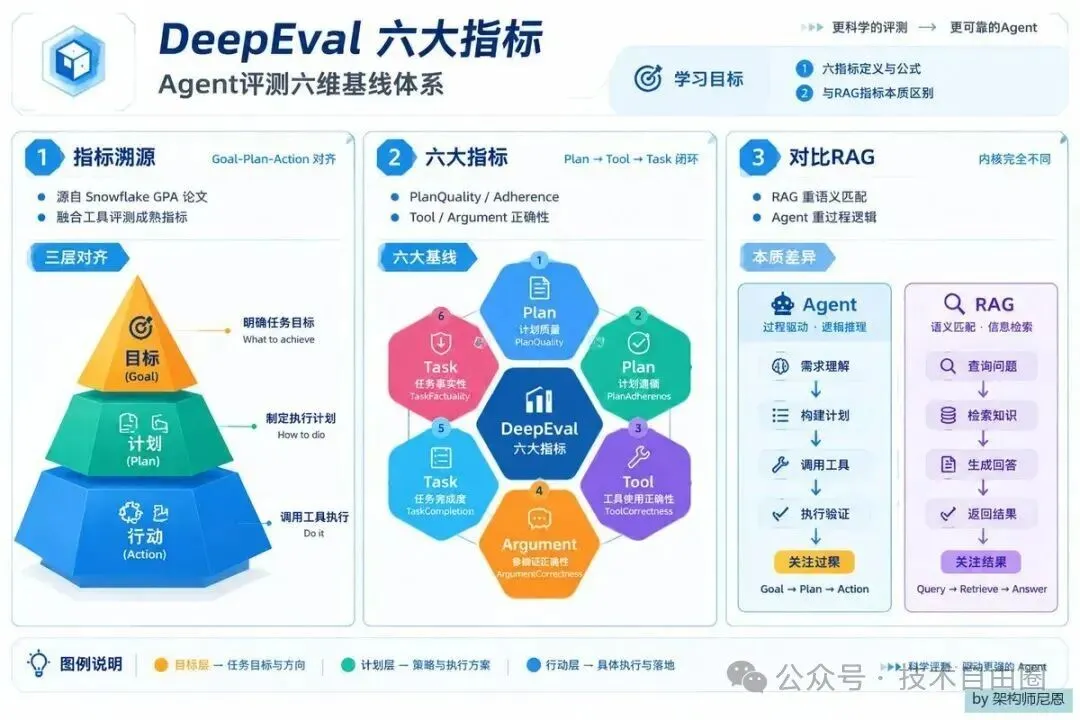
先来看一个基础的问题,普通大模型评测里面已经有相关性、忠实度、幻觉率这类指标,我们为什么还要单独给 Agent 打造一套评测基线? 说白了,两者会暴露出来的失败模式,本身就是不一样的。常规的 LLM 应用走的是线性管线,输入进来、检索、生成、输出,整条链路走向固定,最终输出的质量,很大程度上就能够代表整个系统的质量。 Agent 不一样,它是一套处在动态循环里面、遵循「想 → 做 → 成」逻辑的自治系统。 同一条用户请求,两次运行下来,它所走过的执行路径完全有可能不一样。 故障有可能出在规划环节,也有可能出现在工具选择环节、参数生成环节,或是执行效率环节,而且很多这类故障,在最终输出文本上面几乎不会留下任何可识别的痕迹。 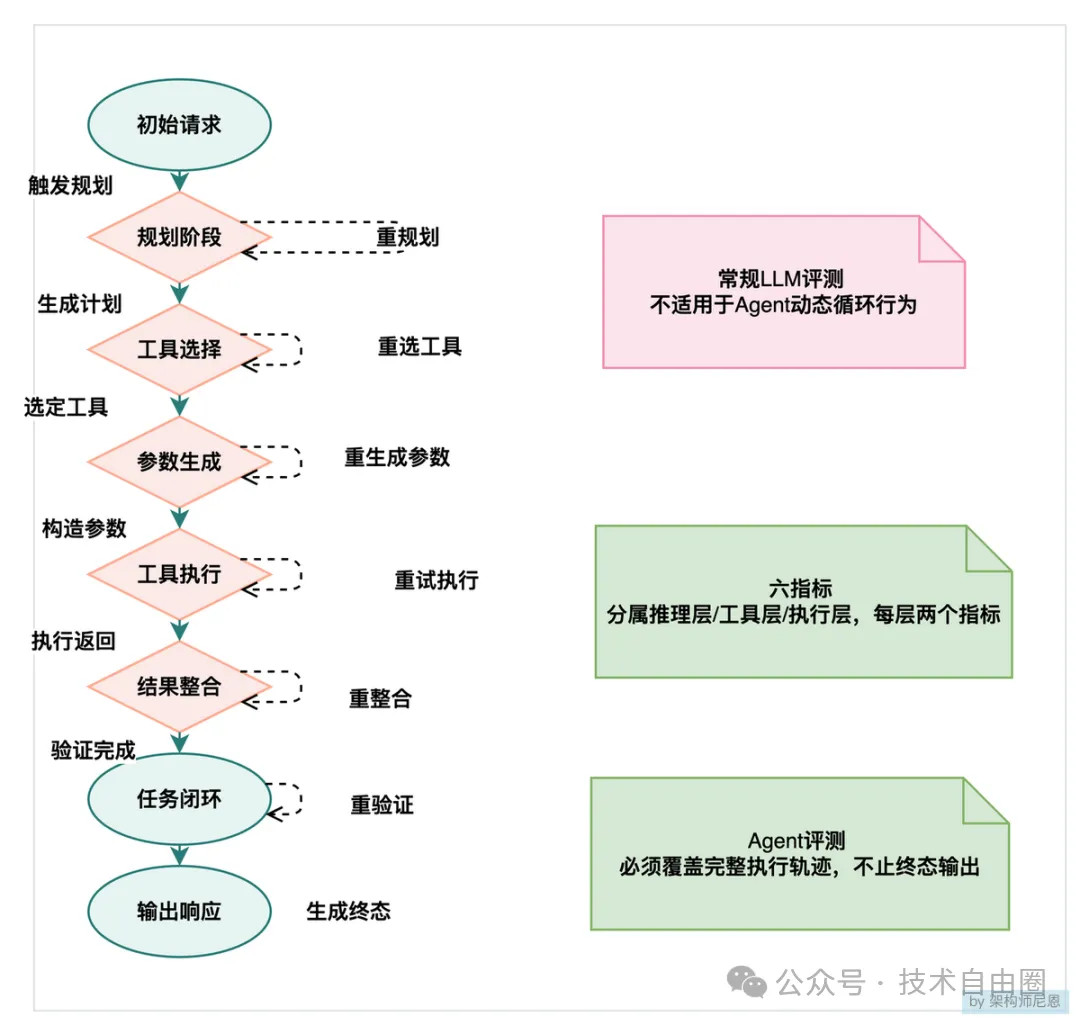
所以 Agent 需要一套沿着完整执行轨迹去打分的指标,而不是仅仅盯着最后那一句回答做评估。 这套六指标的设计逻辑,刚好对应 Agent 三层运行结构:推理层也就是规划环节 + 工具层也就是工具调用环节 + 执行层也就是任务闭环环节。 每一层分配两个指标,各自盯住一类典型的失败模式,这也是业内常说六个指标盯住六种失败的来由。 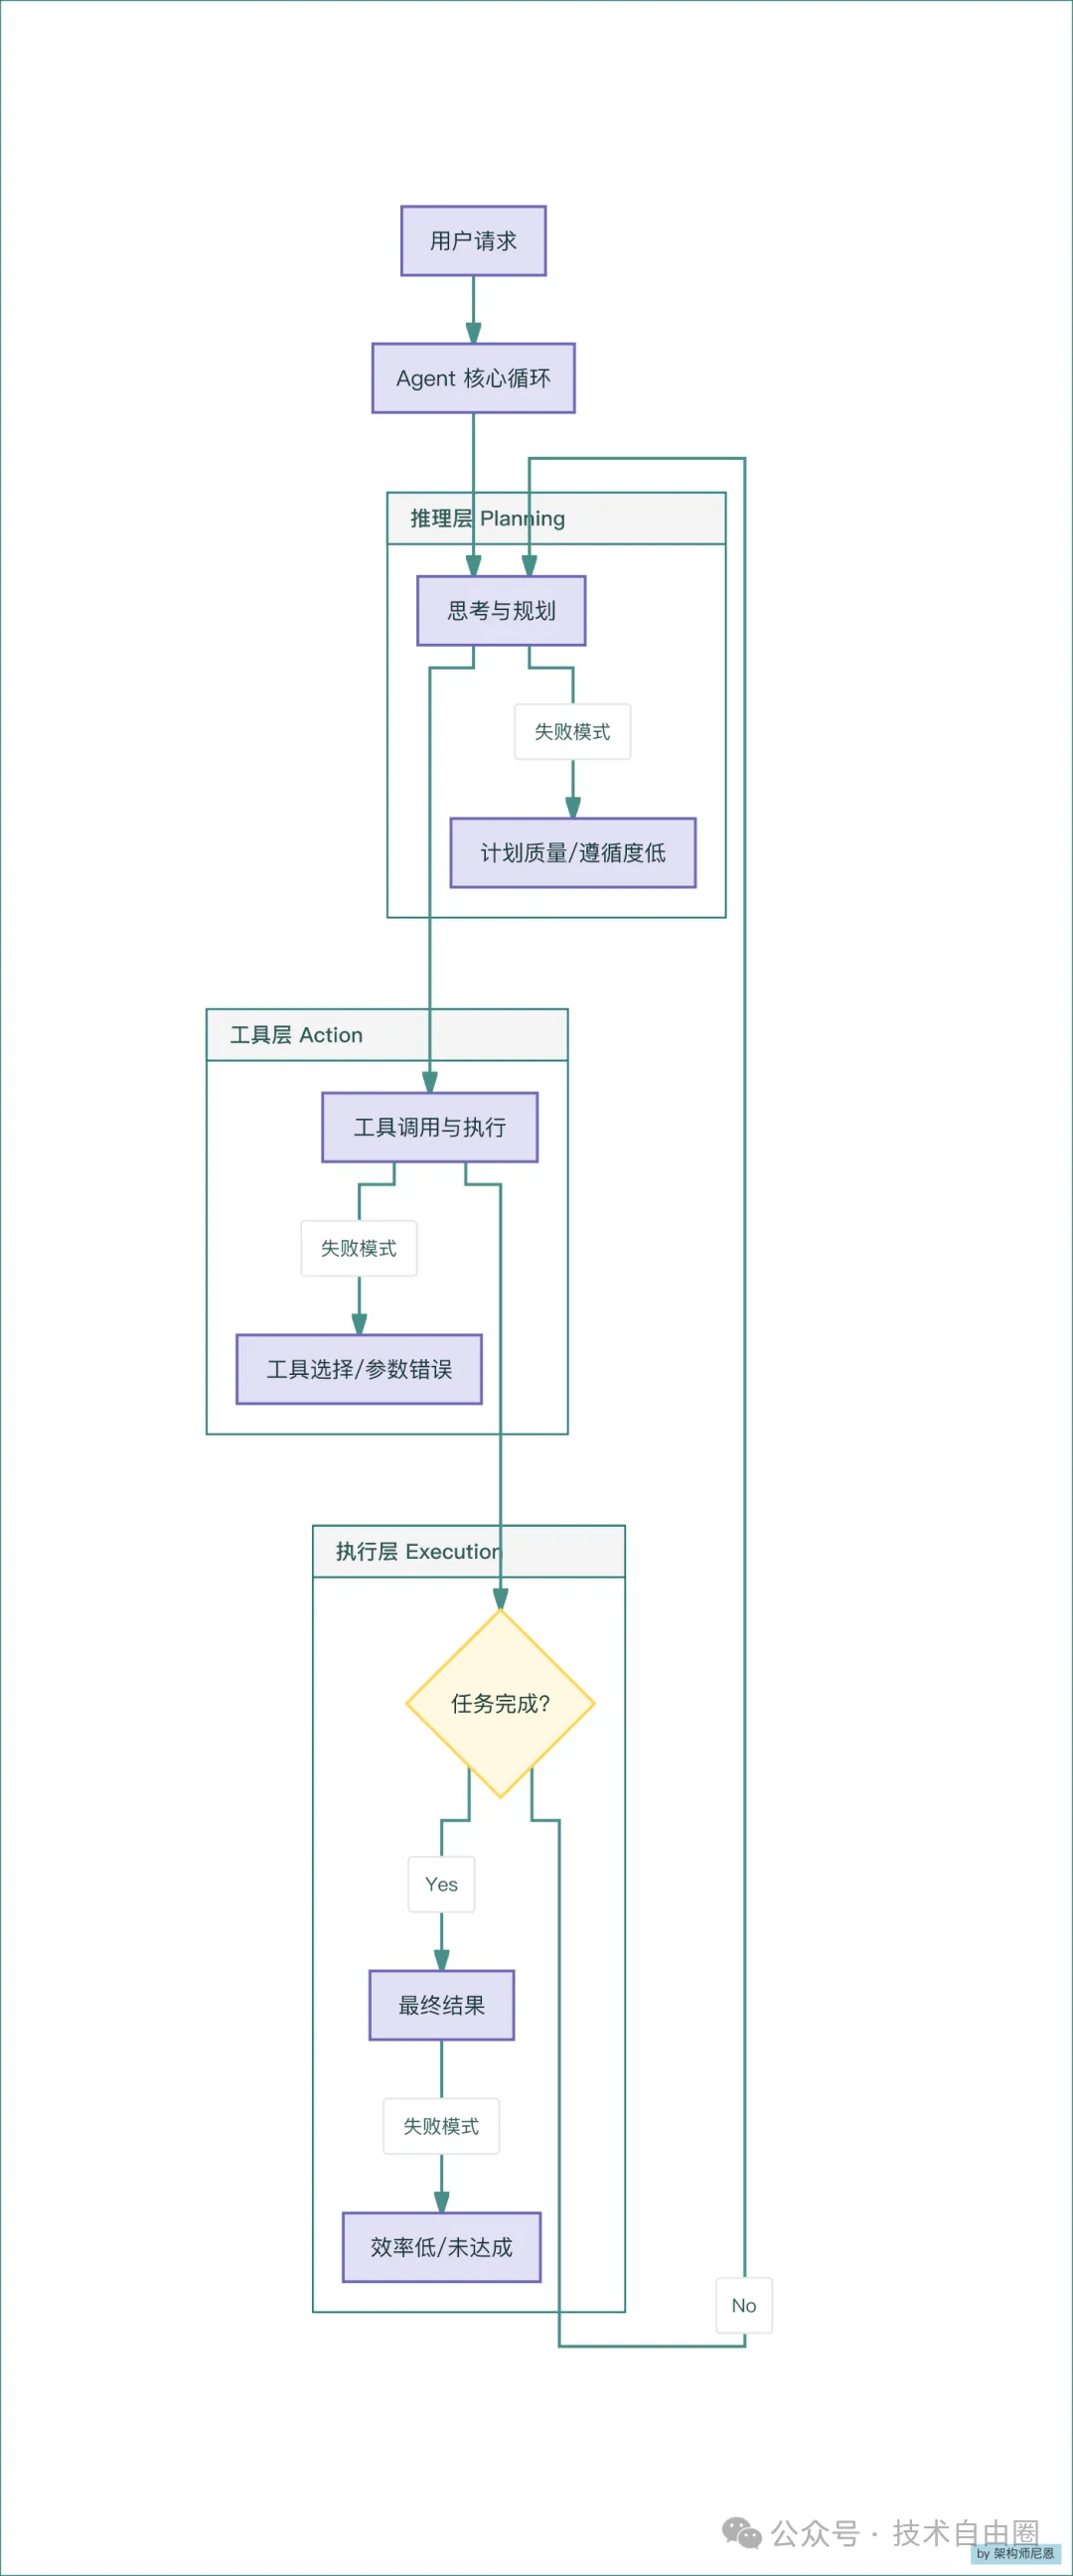
理解这套指标的前提,是先分清两类评测范围。 轨迹级(trajectory)指标,会把整条有序完整的 trace 当成一个整体来打分, PlanQuality、PlanAdherence、TaskCompletion、StepEfficiency 这四个都属于这一类,它们可以读取到完整的计划内容、每一轮大模型决策记录、每一次工具调用和工具返回结果。 组件级(component-level)指标,只会评估产生决策动作的那单个 LLM span,ToolCorrectness 和 ArgumentCorrectness 就归属这一类,它们通过 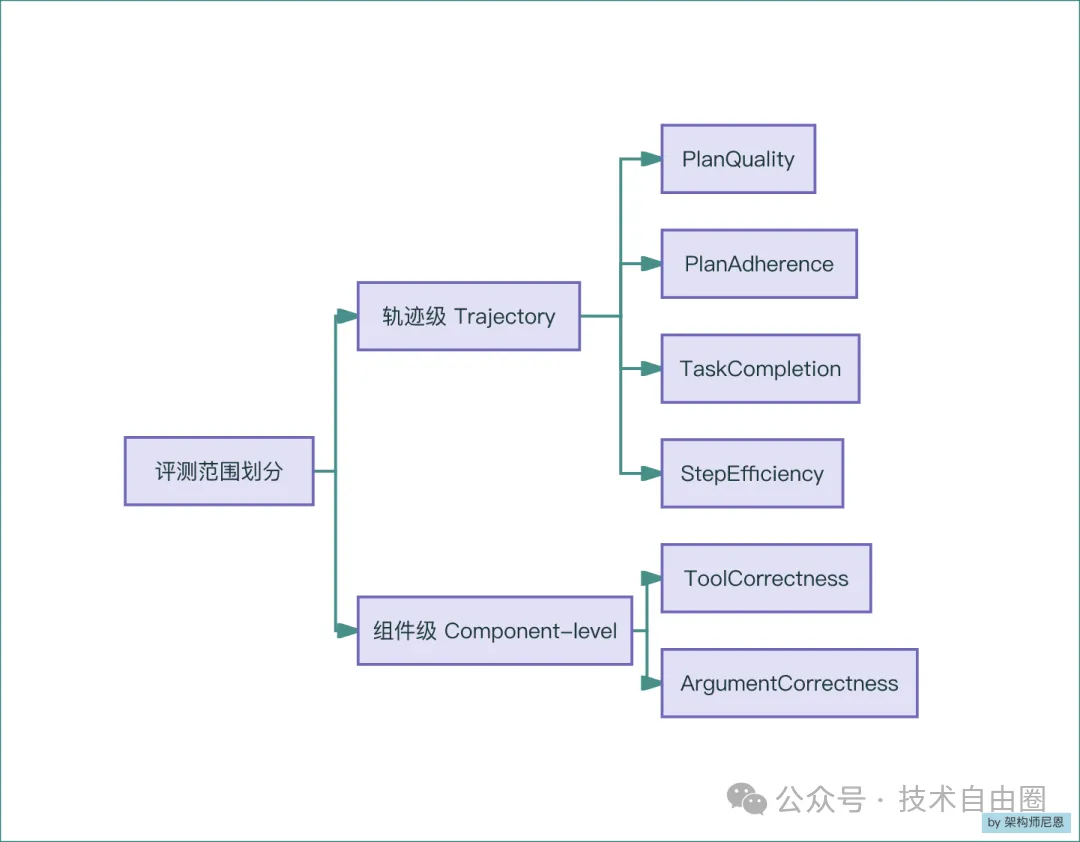
范围不一样,对应的适用场景,自然也就 不 同啦: 一个 Agent 实例,是可以同时挂载这两类指标,相互之间不会产生冲突。 轨迹级指标,一般放到 evals_iterator 参数里面批量传入;组件级指标,直接通过装饰器绑定到对应的 span 上就可以。 PlanQuality,计划质量,用来评判计划本身的合理性。 它会从 trace 里面提取用户任务和 Agent 生成的计划,交由 LLM judge 输出任务和计划之间的对齐分数,对应的计算表达式是 这里有一个工程约定带来的边界,我们是必须留意的:如果 trace 里面没有提取到显式输出的计划,这个指标默认给到满分 1.0,它只负责评估已经输出出来的计划,不会对隐式思考做校验。 也就是说,如果你的 Agent 全程做隐式思考,不会向外透出计划文本,那这个指标基本就失去评估效力了。 PlanAdherence,计划遵循度,评判的是实际执行动作和前置计划能不能对上。 计算公式写作 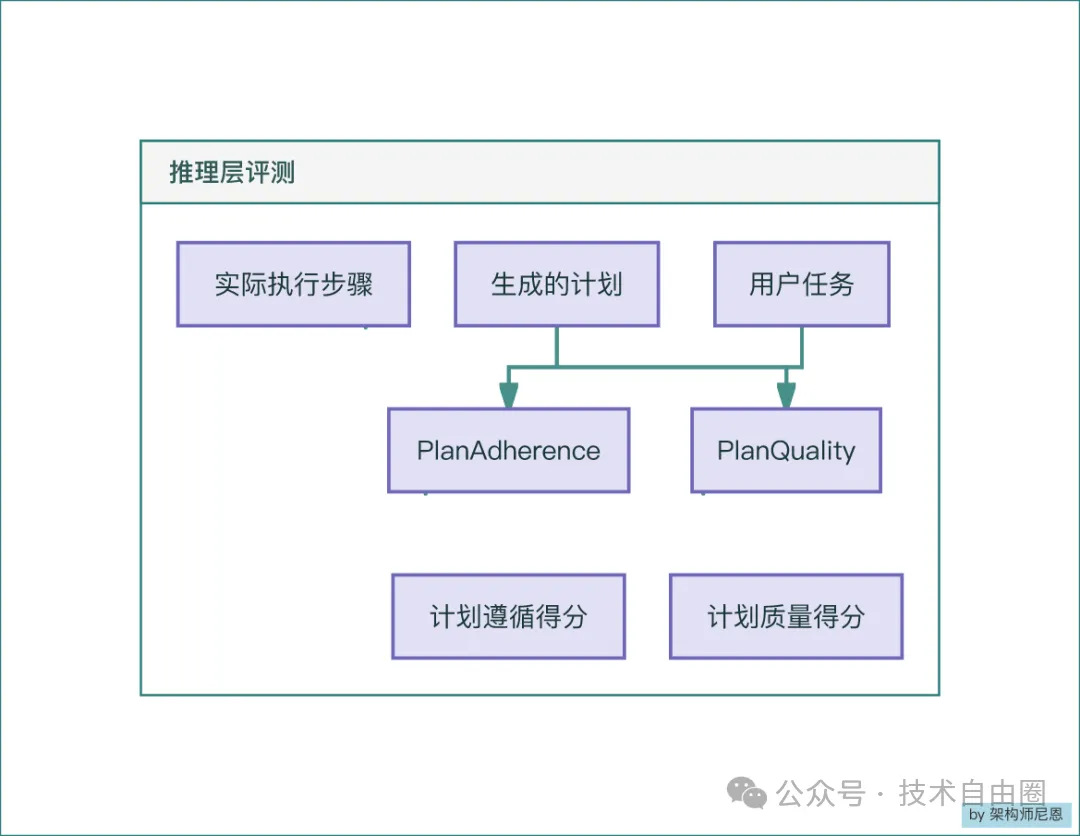
这两个指标的学术源头,就是 Agent GPA 论文里面定义的 Plan Quality 与 Plan Adherence。 在 RigorBench 这类面向代码 Agent 的评测数据集里面,也能找到同源的评估维度,很多文献里面会叫 Planning Fidelity、Plan-Execution Alignment。 它们都属于无参考(referenceless)的轨迹指标,不需要提前准备期望输出,评估精度的上限,很大程度上取决于 trace 内部计划信息完整到什么程度。 ToolCorrectness,工具正确性,用来判断工具的选择和调用动作是否合规。 计算逻辑为 这个指标一共提供五种不同严格等级,从宽松到严格依次是:仅匹配工具名称,校验输入参数匹配性,校验返回结果匹配性,纳入调用顺序约束,要求工具调用列表和预期列表完全一致。 它在六个指标里面,是默认可以走确定性比对逻辑的那一个,基准真值来自数据集,不需要大模型参与打分,评估成本更低,结果复现性更好。 还有一个容易被忽略的隐性行为,当我们给 span 传入 available_tools 可用工具列表的时候,指标会额外启用 LLM 去判断当前工具选择是不是全局最优,最终得分,取确定性分数和 judge 打分里面更小的那一个。 ArgumentCorrectness,参数正确性,用来校验传入工具的参数是不是合理。 计算公式是 它不会去比对预先写死的期望值,而是依托整条上下文,判断当前参数是不是可以从前置信息里面合理推导出来。这个特性,刚好适配参数值没办法提前穷举,但是参数语义必须和用户诉求对齐的场景。举个例子,用户提出「订 3 月 15 号纽约飞往巴黎的机票」,日期、起降城市这类信息,就需要从用户请求里面推导得到。它对应的学术概念,就是 RecToolBench 等工具评测论文里面提到的 Parameter Appropriateness。 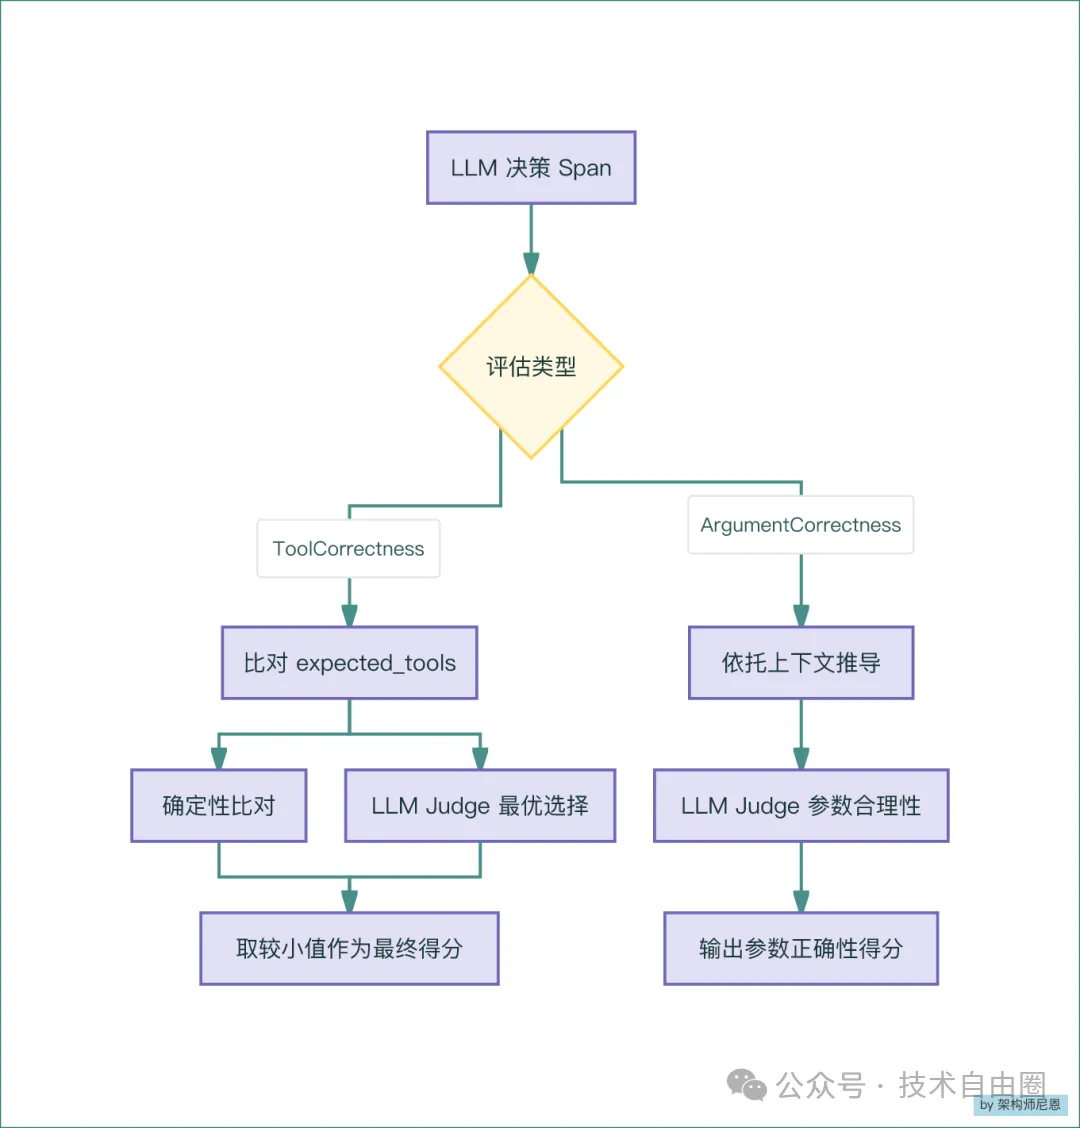 这两个指标,都会挂载在 LLM 决策 span 上,以组件粒度完成取样,能够精准捕获一类很典型的故障:工具本身选对了,但是传入的参数发生幻觉。
TaskCompletion,也就是任务完成度。 属于整套 Agent 评测体系里面的顶层指标,计算公式 任务信息可以从 trace 自动推断,也可以显式传入,满分代表任务完全达成。它在各类 Agent benchmark 里面,共识度相对来说是最高的基础指标,T-Eval、ToolBench 这类主流评测基准,都会把它作为顶层观测项,对应 GPA 论文里面的 Goal Fulfillment。 这里有一点要区分清楚,它属于轨迹指标,而不是黑盒指标,打分的时候,会把 trace 里面全部步骤和中间结果纳入考量,不只是读取最终返回文本。 StepEfficiency,也就是步骤效率,用来判断整条链路里面有没有多余动作。 计算公式是 工程落地里面,有一个非常好用的诊断组合:TaskCompletion 得分很高,但是 StepEfficiency 得分偏低,这个状态往往意味着 Agent 能够把任务做完,但是执行路径还有优化空间,优化方向就是精简步骤,同时保障任务成功率。 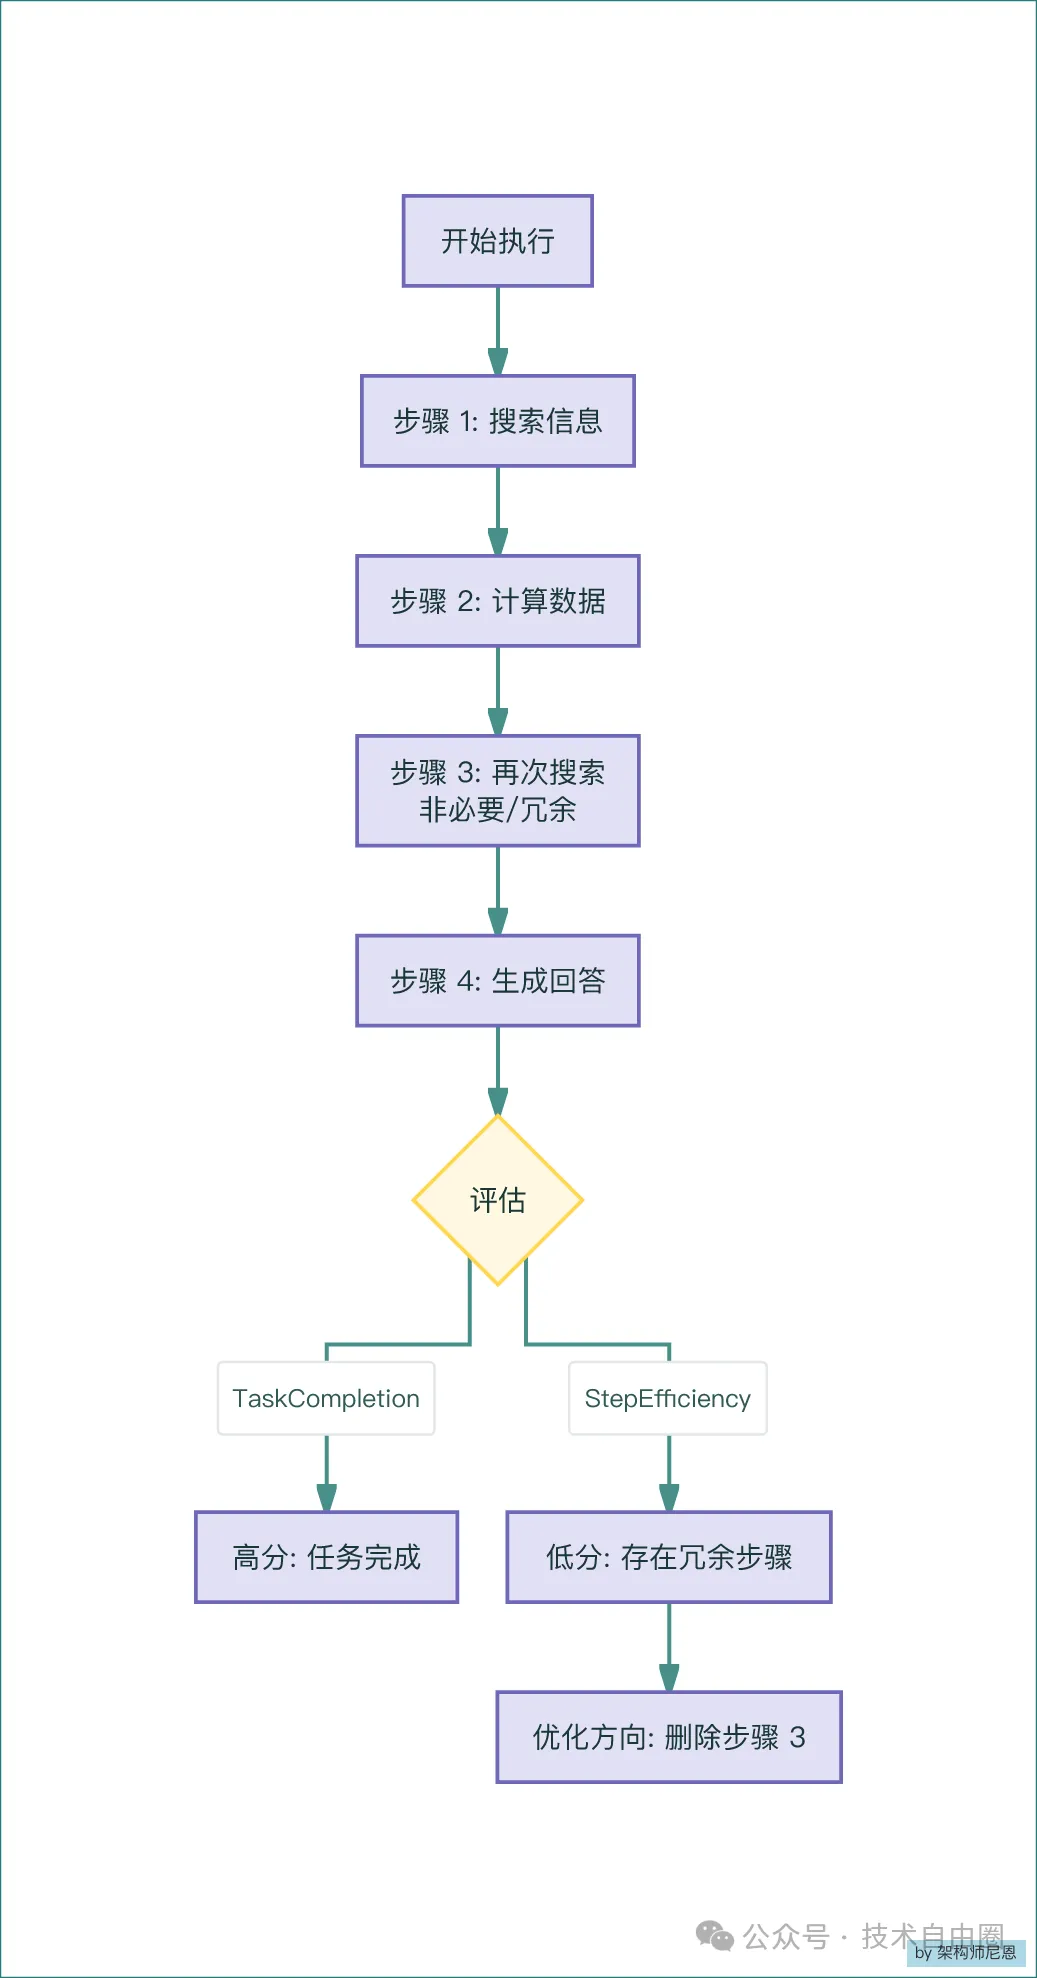 这个指标,是成本敏感型生产场景里面比较常用的。我们也要留意,学术论文里面的效率评估,很多会叠加 token 开销、接口耗时一起计算,DeepEval 默认版本,只从语义层面判断步骤的必要性,业务侧的资源成本,还需要单独补充指标去采集。
我们先把对比的参照物明确下来。 RAG 评测领域的行业基线,就是 Ragas 定型的那一套指标,相关体系在 EACL 2024 的论文里面完成规范定义: 很多人第一眼看到两套指标,都会产生同一个疑问:它们不都是依托 LLM-as-judge,输出 0~1 之间的分数吗,差异到底在哪里? 差异集中在四个维度,也是方案评审、面试沟通里面高频被问到的点。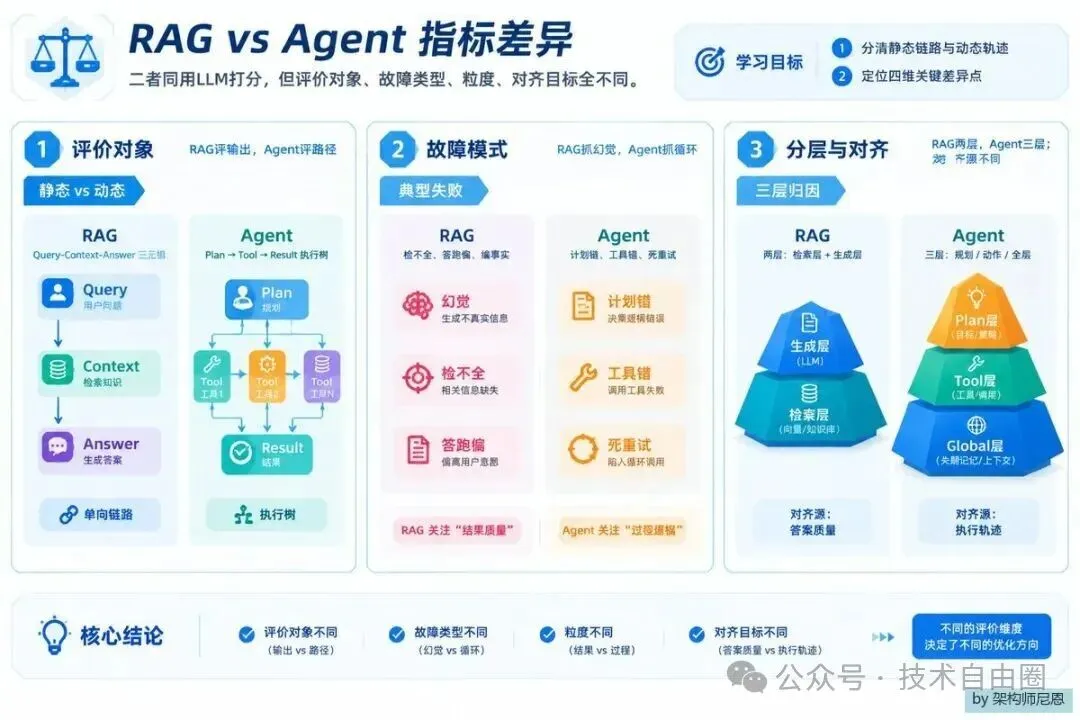
第一,评价对象不一样。 RAG 指标评估的是静态检索生成链路里面,各个组件输出之间的对齐关系,它默认整条链路单向流转、不会产生分支、不会持续对外执行动作。 Agent 六指标评估的是动态执行轨迹,也就是 trace span 树,评估素材是有序的执行序列,包含计划文本、每一轮决策、每一次工具入参、工具返回内容、重试动作。说白了,RAG 指标评估的是输出质量,Agent 这套指标评估的,是整条路径的质量。 第二,捕获的失败模式不一样。 RAG 4 指标重点抓的故障,集中在检索和生成环节:检索到无关片段、关键上下文缺失、回答脱离检索素材产生幻觉、回复和用户问题不匹配。 Agent 六指标捕获的故障,全部属于规划执行循环独有的类型:计划拆解逻辑出错、执行动作偏离计划、选错工具、参数幻觉、重复冗余调用、进入无效重试循环。举一个很直观的例子,同一个 Agent,两次运行之后输出文本完全一致,一次是直达目标的短路径,一次绕了多轮重试,RAG 的忠实度、相关性指标都会给到高分,但是 StepEfficiency、ArgumentCorrectness 就可以把链路隐患识别出来。 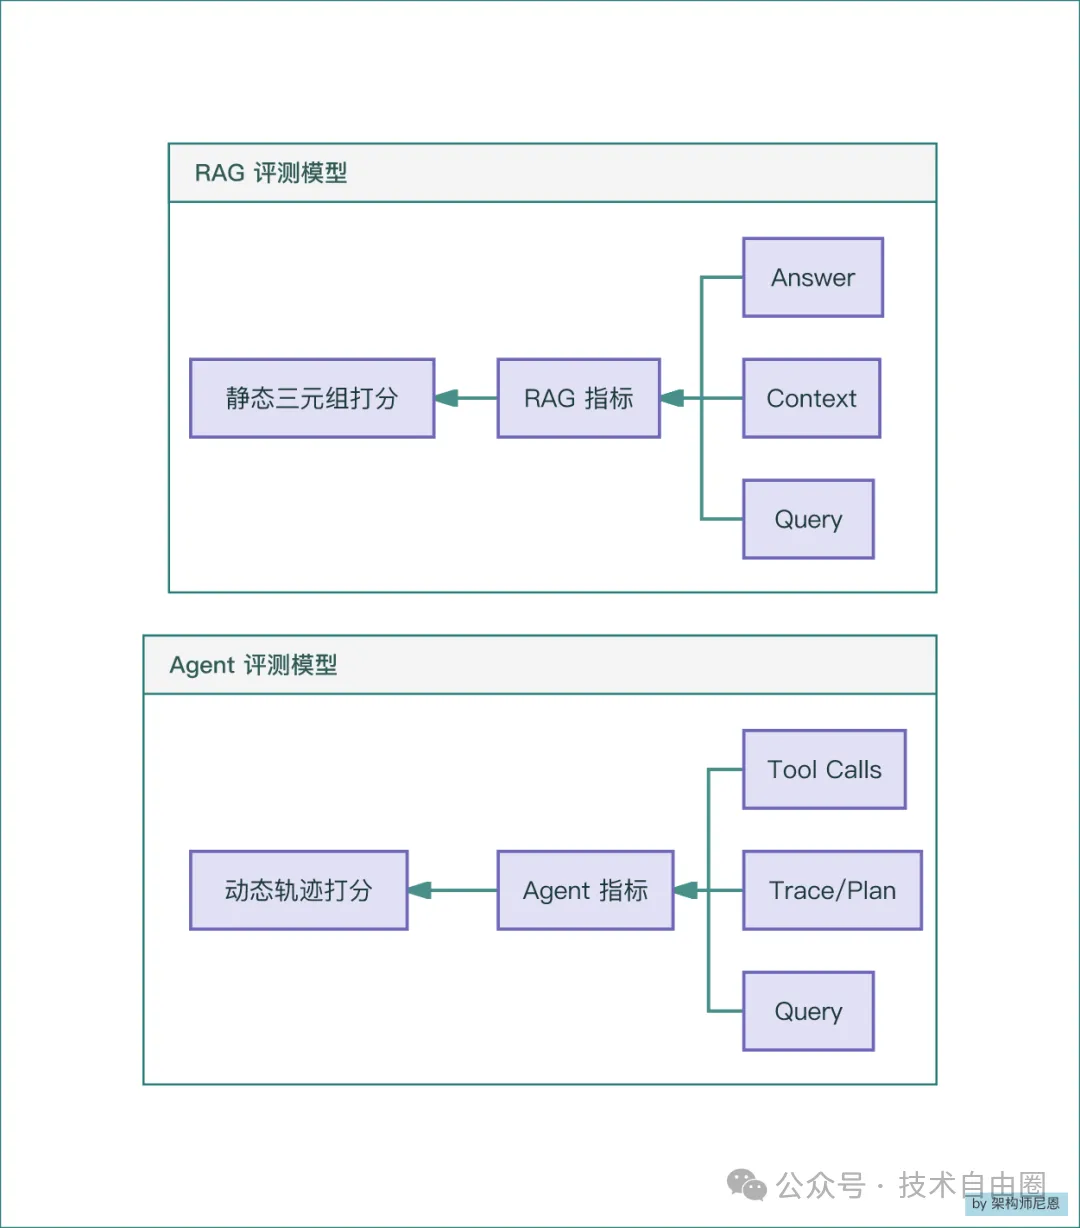
第三,分层粒度不一样。 RAG 4 指标大体上分为两层,检索层指标 + 生成层指标,里面没有专门对应规划的层级。 Agent 六指标是三层划分,推理规划层 + 动作组件层 + 全局执行层,分层设计的核心目的,就是故障定位。故障发生在哪一个 span、哪一次工具调用,指标就挂载在对应的位置上。相对来说,RAG 指标很难做到这种细粒度的归因,拿到一个低分,我们往往很难快速判定根源是检索环节还是生成环节。 第四,judge 的对齐目标不一样。 RAG 里面的 LLM judge,对齐基准只有一个,就是检索拿到的上下文事实。Agent 六指标的对齐源是多元的:一部分对齐用户原始目标,也就是 TaskCompletion;一部分对齐 Agent 自己生成的计划,也就是 Plan 两个指标;还有一部分对齐工具的 schema 和业务约束,也就是 ToolCorrectness、ArgumentCorrectness。 两套指标,并不是二选一的关系,更多是互补关系。 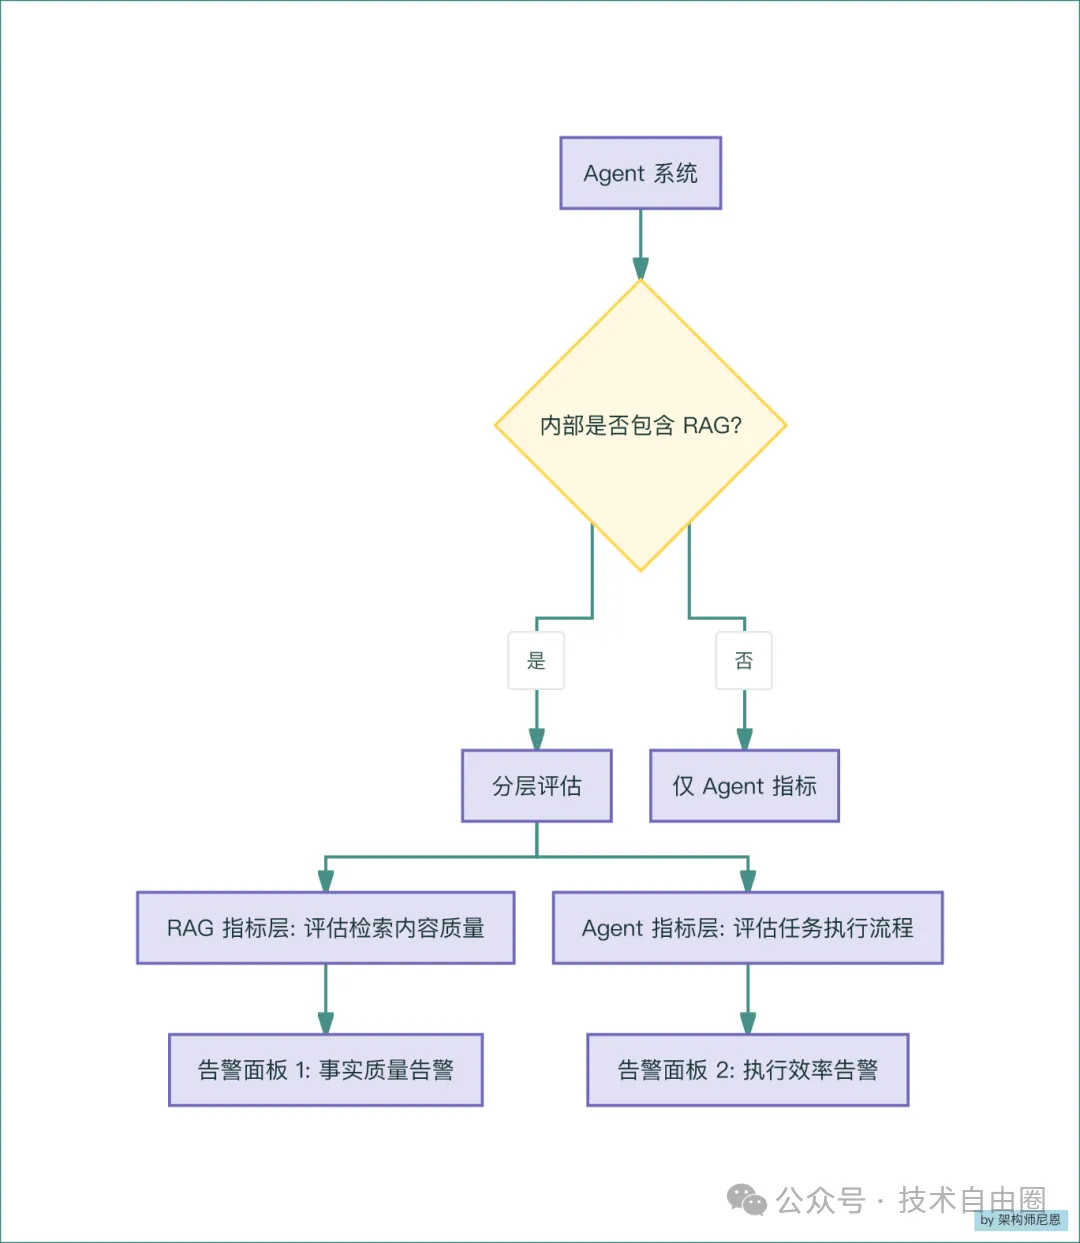
很多 Agent 内部,本身就集成了 RAG 检索能力,比较合理的做法,是两套指标分开采集、分开配置告警。 简单概括,RAG 指标管 Agent「说得好不好」,Agent 指标管 Agent「做得对不对、省不省」。 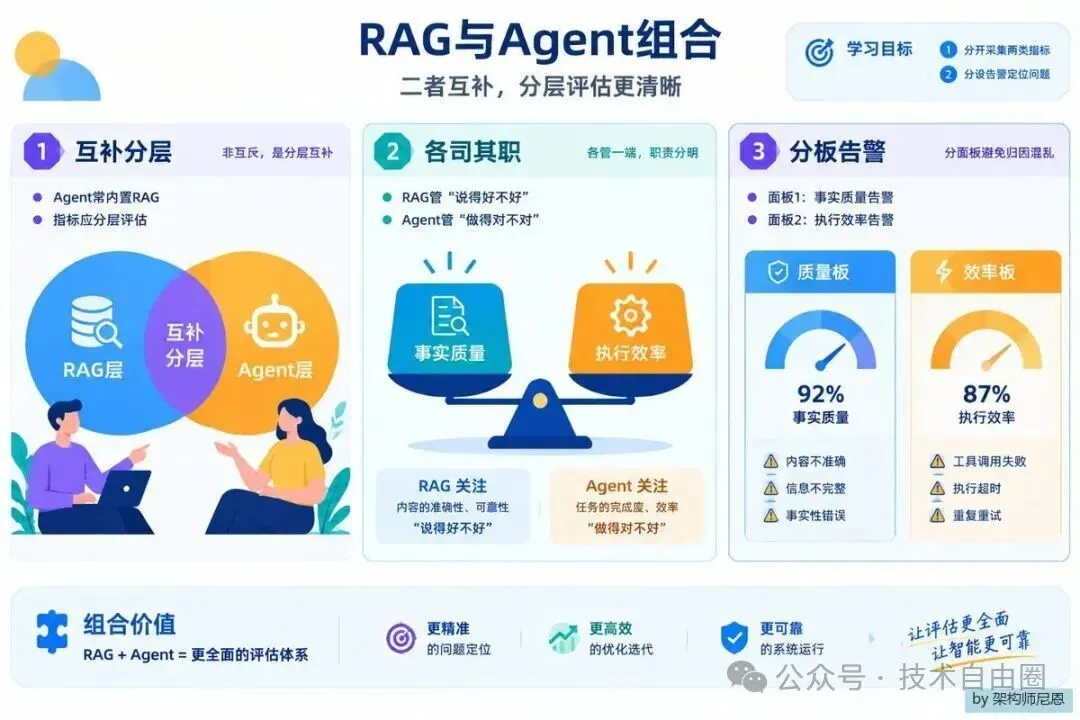
如果把两类指标混在同一个告警面板里面,故障归因的链路会变得混乱。 我们把这套六指标放到工程决策里面, 搭建企业内部 CI 门禁、版本回归测试的时候,这套指标的适配性是比较好的,它原生兼容 pytest,和 trace 链路绑定,故障定位能力足够强。 搭建线上持续监控体系的时候,TaskCompletion、ToolCorrectness 适合放到核心 KPI 看板持续观测;Plan 系列指标,更适合离线回归、版本对比场景。 最后做一个总结。 这套六指标,是学术领域已有思想工程化落地之后的产物,具备对应的论文底座,也积累了一定的工业共识,属于 Agent 轨迹评测方向里面一条主流基线,大家可以在生产场景进行借鉴和使用。 一般来说,我们维护的是 RAG + Agent 的混合系统, 按照前面提到的思路,分层设置评估链路,两套指标各司其职。 
28岁 年薪 100W ! 只要路子对,工资高 到 破想象,像做梦一言,非常梦幻,这个 下一步是 200w。 刷一年 八股 升级 失败 ,31岁小伙 绝望了! 痛定思痛,走三化三驱 捷径,10 天逆袭,太扎心了 三观颠了:3本 进国企 年60w,公金10W, 没任何一点关系。最大的背景 就是 AI架构 裸辞学AI,可以吗? 26岁4年小伙裸辞,学AI 一个月3大厂offer,逆涨30% 年薪50w,完全可以裸体学习 涨薪 传奇: 28/3-4年/代码0经验/一线运维,7个月 逆袭 AI 专家,年薪64W涨一倍。 证明一个硬道理:低起点 0经验,也能 进大厂 + 冲100万 一个天一个地: 31岁同学 刷 一年八股文,进阶失败, 自以为聪明却走出 一年最大弯路;28岁同学走捷径13天逆袭,太伤人了 梦幻:40岁 项目经理, 5年没写代码,开滴滴10个月 ,找尼恩升级P9, 一个月逆天改命, 收 两个架构offer, P9级架构太香了 逆天:从修手机到AI开发,2个月 大逆袭 ! Java+AI 太香了! 成了: 卖肥料一年,上岸 架构师 。月薪3w 比 卖肥料 香 太多!Java架构+AI架构,帮助31岁小伙伴 大逆袭 逆袭 100万 P8。37岁 空窗6个月,靠 Java+AI双栖架构, 2个月上岸 100w年薪到手,职业重生+逆天改命! 一飞冲天, 逆 首席: 37 岁 借力 Java+AI 逆袭 首席架构 , 年薪80W+太香了 31岁 /专科 升架构成功, 收10个offer 变 offer 皇帝 !! 下一步,直冲100W 职业救助站 
技术自由圈 
工业级 6大 Agent 基线指标 + RAG 4大基线指标 对照:定义、公式、原理 系统拆解
尼恩说在前面
面试官问: 工业级 6大 Agent 基线指标 + RAG 4大基线指标 ? Agent 为什么需要独立于 LLM 的六维基线指标?和 RAG 的四类指标本质区别在哪?
《尼恩 架构笔记》《尼恩高并发三部曲》《尼恩Java面试宝典》的PDF,请到文末公号【技术自由圈】获取
工业级 6大 Agent 基线指标 + RAG 4大基线指标 对照:定义、公式、原理 系统拆解
一、为什么 Agent 需要一套独立的基线指标
二、框架底座:两层结构 × 三层评测范围
@observe(type="llm", metrics=[...]) 挂载,取样的范围就局限在这一次决策点上。轨迹级指标回答的,是整条执行路径走得怎么样; 组件级指标回答的,是单独这一步决策有没有出问题。
# 轨迹级与组件级指标挂载示例from deepeval.metrics import ( PlanQualityMetric, ToolCorrectnessMetric)# 1. 轨迹级指标:传入 evals_iterator,评估整个 tracetrajectory_metrics = [PlanQualityMetric()]# 2. 组件级指标:通过装饰器挂在具体的 LLM 调用函数上@observe(type="llm", metrics=[ToolCorrectnessMetric()])def call_llm_for_tool_selection(context):# 这里只评估这一步工具选得对不对 return llm.invoke(context)三、六大基线指标逐个拆
3.1 推理层:PlanQuality 与 PlanAdherence
AlignmentScore(Task, Plan),评判维度包含计划逻辑是否自洽、任务拆解是否合理、任务依赖关系是否正确。AlignmentScore((Task, Plan), Execution Steps),它会把用户任务、Agent 生成的计划、已经发生的执行步骤三样内容一起送入 judge,比对实际动作序列和预先规划步骤的一致性。官方文档里面,也比较推荐把这两个指标成对配套使用。说白了,一份高质量的计划但是执行完全跑偏,和一份漏洞百出的计划被严格完整执行,从业务风险层面看,两者都属于需要治理的问题。3.2 工具层:ToolCorrectness 与 ArgumentCorrectness
正确使用的工具数 / 调用工具总数,它会拿 LLM span 里面实际发起的工具调用,和 Golden 数据集上配置的 expected_tools 做比对。正确生成的输入参数数 / 工具调用总数,和 ToolCorrectness 刚好相反,它完全依托 LLM 驱动,属于无参考指标。这两个指标,都会挂载在 LLM 决策 span 上,以组件粒度完成取样,能够精准捕获一类很典型的故障:工具本身选对了,但是传入的参数发生幻觉。# 工具正确性配置示例:设置严格度from deepeval.metrics import ToolCorrectnessMetric# 严格模式:不仅工具名要对,参数也要匹配metric = ToolCorrectnessMetric( strict_mode=True, evaluation_steps=["Check if arguments match expected values"])# 宽松模式:只要调用了正确的工具名即可metric_loose = ToolCorrectnessMetric(strict_mode=False)3.3 执行层:TaskCompletion 与 StepEfficiency
AlignmentScore(Task, Outcome),核心回答用户提出来的诉求有没有被满足。AlignmentScore(Task, Execution Steps),它会对冗余工具调用、不必要的推理循环、一切非必需的执行步骤施加负向打分,对应 GPA 论文里面的 Execution Efficiency。这个指标,是成本敏感型生产场景里面比较常用的。我们也要留意,学术论文里面的效率评估,很多会叠加 token 开销、接口耗时一起计算,DeepEval 默认版本,只从语义层面判断步骤的必要性,业务侧的资源成本,还需要单独补充指标去采集。四、六大 Agent 基线指标 与 四大 RAG 基线指标的系统对比
4.1 RAG 基线指标是什么
Faithfulness(忠实度),用来校验回答内容是否忠于检索上下文,不存在无依据编造; Answer Relevancy(回答相关性),校验最终回答和用户提问的贴合程度; Context Precision(上下文精确度),校验检索结果里面相关片段的排序质量; Context Recall(上下文召回率),校验任务需要的信息,是不是都已经被检索链路拿到。DeepEval 内部,同样封装了同源的指标,也就是 ContextualRelevancyMetric、FaithfulnessMetric 等。这套指标的评估证据,是一组静态三元组:用户 query、检索上下文、最终回答。
4.2 RAG 4 指标 & Agent 六指标 的关键差异
4.3 RAG 4 指标 & Agent 六指标 怎么组合
Ragas 指标,负责评估每一轮检索生成内容的事实质量,也就是忠实度、相关性、上下文精确率和召回率; DeepEval 的六个 Agent 指标,负责评估规划逻辑、工具调用行为、轨迹执行效率。
# 混合系统评测配置:RAG + Agentfrom deepeval.metrics import FaithfulnessMetric, TaskCompletionMetric# 1. RAG 指标:评估检索内容的质量rag_metrics = [ FaithfulnessMetric(), ContextualRelevancyMetric()]# 2. Agent 指标:评估任务执行流程agent_metrics = [ TaskCompletionMetric(), StepEfficiencyMetric()]# 3. 综合评估:分别查看报告test_case.evaluate(rag_metrics + agent_metrics)五、收尾: Agent 六指标 选型与学术支撑说明
狠狠卷 尼恩 三高架构 +尼恩 AI架构 , 完成 P7/P8/p9 升级,实现逆天改命
小伙赶在32岁 末班车,拿到 京东P7(60w), 撬开P8(年薪100W)通道, 逆天改命了!!!
实现职业转型,极速上岸
关注职业救助站公众号,获取每天职业干货助您实现职业转型、职业升级、极速上岸---------------------------------
实现架构转型,再无中年危机
关注技术自由圈公众号,获取每天技术千货一起成为牛逼的未来超级架构师
几十篇架构笔记、5000页面试宝典、20个技术圣经请加尼恩个人微信免费拿走
暗号,请在 公众号后台 发送消息:领电子书
如有收获,请点击底部的"在看"和"赞",谢谢
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
