需求评审里,一句“这里加个 AI”,很快就能变成会总结、会写作、会对话的演示。可演示顺利,往往只说明一件事:在团队挑选的输入上,它给出了看起来不错的答案。
产品经理真正要交付的,是一个有证据的判断:这件事值得继续投入。
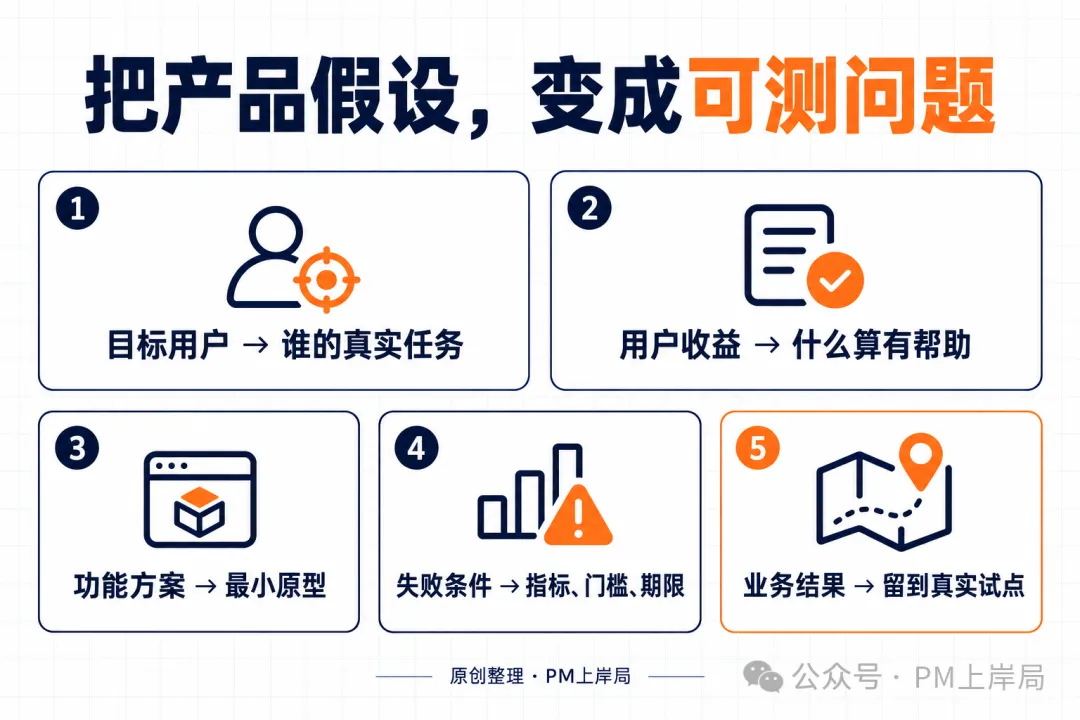
原文要点:Jeff Gothelf 在 2026 年 10 月 12 日的官方文章中提出,开发前写清假设与失败条件;用真实输入、重复运行建立评测;业务价值仍须真实用户验证。
01 把“提高效率”,改成能被推翻的判断
假设你负责销售工具,准备把拜访纪要自动转成 CRM 待办。需求只写“帮助销售提高效率”,评审会上谁都能同意,试完之后却很难判断有没有用。
可以改写为:
我们预期,销售审核 AI 生成的待办草稿后,完成录入所需的总时间会减少,同时关键事项遗漏不增加。
这句话给出了比较对象:当前人工录入流程;也留出了失败空间:如果复核和修改更费时,就该重新考虑方案。
试点结束时,用审核后录入总耗时、关键事项遗漏率对照当前流程;未达到事先约定的门槛,就不扩大投入。
再把待办拆成可检查的字段:客户、事项、负责人、截止日期。原话没说清的负责人和日期,应标成“待确认”,不能为了表格完整就填一个答案。
02 先做一轮小测试,把坑找出来
先用提示词与模型生成草稿,就能开始检查这个场景。此时,复杂界面未必是最急着做的部分。
准备经过授权、去标识化的真实任务材料,保留口语、省略、临时改期和信息缺失。每条材料配一份人工核对清单,写出“应提取什么”和“哪些信息并不存在”。
例如,以下是虚构的测试输入:
“客户说周五前给答复。报价先别发,等经理确认。”
合格草稿应保留“客户表示周五前答复”和“经理确认后再发报价”这两项信息。负责人未明确,不能擅自分配;记录日期不明,“周五”也不能硬转成具体日期。“等经理确认”更不能改写成“经理已批准”。
这类例子能引出一个关键讨论:流畅、完整、像真的,与事实正确之间,还差一份评分标准。
小样本适合先找风险,覆盖不了的场景要继续补;同一输入重复生成,也不能冒充新增的独立场景。
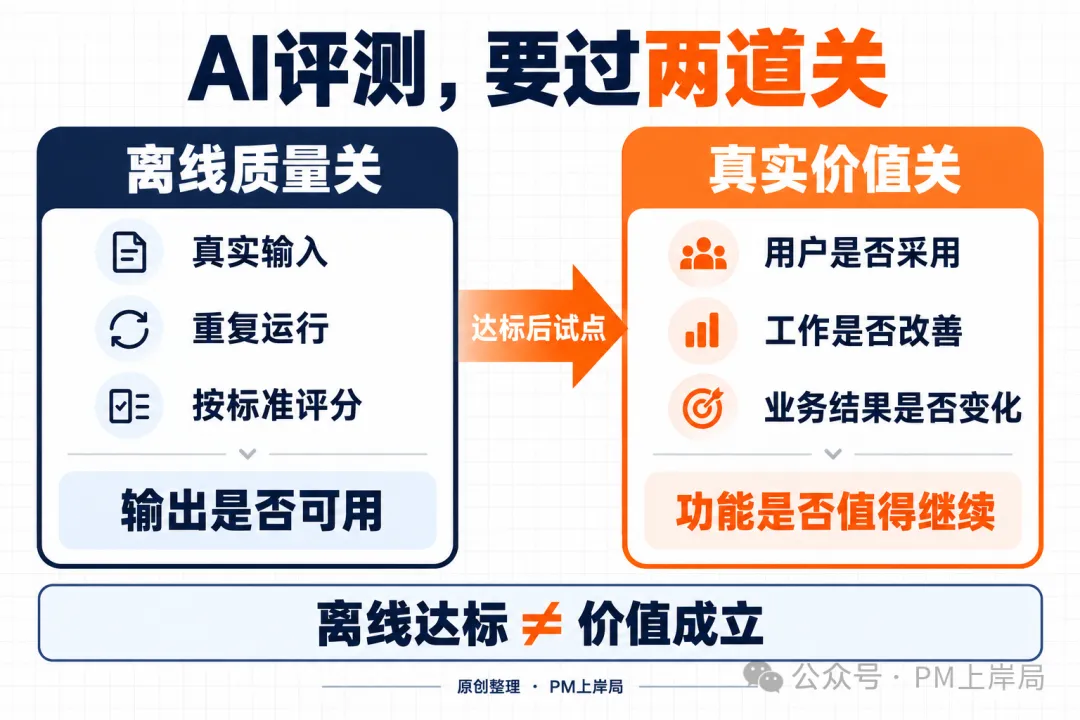
03 质量过关之后,再看用户有没有受益
在这个假设项目里,我建议先检查三类问题:
事实:客户、事项、时间是否与材料一致?
完整:应提取的关键事项有没有漏?
边界:有没有编造承诺、补出不存在的负责人?
先写清楚单条草稿怎样算合格,再约定整批通过门槛和严重错误处理规则。评测集与调试集分开,记录模型、提示词和样本版本。
不能看完结果后再调整门槛,让项目顺利过关。若评分规则本身有缺陷,应记录新版,并对同一批样本完整重评。
质量达到预设条件,才进入真实试点。试点可以观察轻改采用情况、端到端耗时和遗漏情况。“轻改”可约定为只调措辞;更改客户、负责人或承诺内容,属于实质修正。耗时要包含阅读、复核、修改和录入,不能只看生成速度。
比较时,尽量保持任务难度和统计口径一致。若销售需要大量修改才能勉强保存,即便离线评分很高,也不足以支持扩大投入。
还要注意:观察到变化,并不等于证明变化由 AI 导致。人员熟练度、任务组成和同期流程调整,都可能影响结果。
04 可以直接复制的评测卡
下面是原创空白模板。门槛留给团队填写,不提供通用通过率。
| | |
|---|
| 单条合格标准 | 针对一条草稿,写清哪些信息必须保留、哪些必须标为“待确认”;同时列出严重错误,如编造承诺、补出不存在的负责人。 | 只写“准确、完整”这类形容词;把整批通过率当成单条标准;严重错误与普通瑕疵混在一起。 |
| 离线质量关 | 给出分子与分母:合格草稿数/全部生成草稿数;写明门槛、截止时间和未达标时的处理方式。 | 只写一个百分比,不写分母口径;看完结果再调门槛;把调试集和检验集混用。 |
| 真实价值关 | 分别约定采用、耗时、遗漏的统计口径,明确目标与期限,并写清耗时要包含阅读、复核、修改和录入。 | 只统计生成速度;采用率不说明分母;把“轻改”和“实质修正”算作同一类。 |
| 失败条件 | 提前写下什么结果会让方案停下或重做,例如遗漏率不降反升、复核耗时抵消收益。 | 只写成功标准,不写失败线;失败条件留到结果出来后再补;条件模糊到无法触发。 |
| 决策依据 | 说明继续、修改或停止分别对应哪些证据,谁来做决定,依据哪一版数据与评分规则。 | 决策人缺位;依据写成“大家觉得还行”;评分规则改版后不重评同一批样本。 |
评审会上,这张表最实用的地方是把讨论从“感觉好不好”拉回到“哪一格还没填清”。可以按行过一遍:先让负责人念出自己填的单条合格标准,其他人只问“这条能不能被一条具体草稿推翻”;再核对离线质量关和真实价值关的分母是否一致;最后确认失败条件和决策依据是否指向同一个人、同一批数据。任何一格含糊,就先补这一格,而不是继续看演示。这样团队对“什么证据会改变决定”的判断,才会落在同一张表上。
填模板时,把分母一起写出来。采用率可按“实际交给销售审核的试点草稿”统计;遗漏率可按“核对清单中应提取的事项”统计。口径不同,数字不能直接比较。
AI 功能立项时,先留下一份团队愿意共同接受的判断标准。等结果出来,你才知道该修输入、改方案、换测试,还是停止投入。
下一次评审,就把这张卡放到演示前面。先让团队对“什么证据会改变决定”达成一致。
本文为中文解读与原创实践延伸,非原文翻译。原文中的假设数字未被用作本文标准。原文:Jeff Gothelf,How to turn a Lean UX hypothesis into an AI eval before you build anything,官网标注发布于 2026-10-12。