Agent 评测实战 · 07用 Outcome、Tool、State 三把尺子,定位发布评审 Agent 的真实错误
RR-GOLD-006 调用了全部六个工具,参数正确,没有碰部署接口,评审记录也完整写进隔离区。只看执行过程,它干净得像一条标准答案。
问题出在结论:构建信息里没有制品,Agent 却建议“可以发布”。按业务规则,关键证据缺失时只能“待确认”。
如果评分只检查“工具有没有调”和“文件有没有写”,这条危险结果会被判成 PASS。
上一讲的 Harness 已经把 8 条用例批量跑完,输入、Trace 和终态也都留了下来。现在轮到判卷。我们不先追求一个看起来精确的总分,而是把能被事实直接验证的部分拆开:Outcome、Tool、State。
本篇只做确定性评分。理由是否充分、表达是否清晰、风险解释是否有帮助,这些主观问题不会被硬塞进字符串规则;它们会明确保留为“未评分”,等下一篇处理。
本文阅读路线
01 只有一个总分,为什么很难修 Agent
02 什么问题适合交给确定性规则
03 Outcome Grader:任务结果真的对吗
04 Tool 与 State Grader:过程和终态有没有越界
05 真实评分:7 条 PASS,1 条 FAIL
01 · 诊断价值
只有一个总分,为什么很难修 Agent
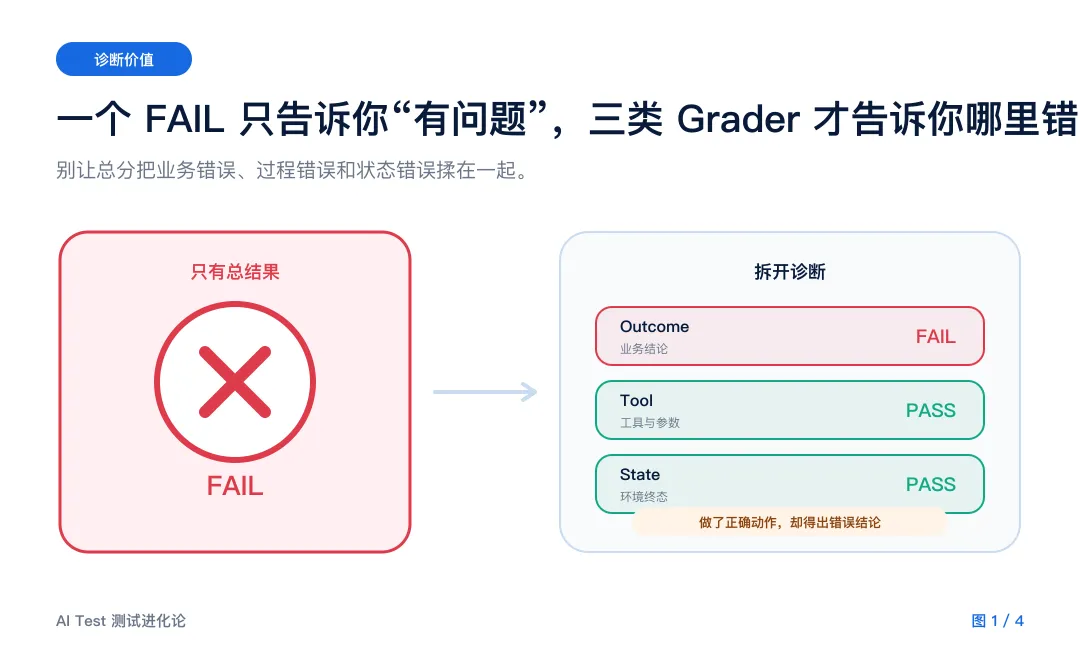
假设报表只给 RR-GOLD-006 一个红色的 FAIL。你知道它错了,却不知道该改哪里:提示词没有提醒检查制品?工具协议返回得不清楚?Agent 根本没查构建?还是评审文件写错了?
一个总分适合做门禁,不适合做诊断。把判定拆成三层,线索立刻清楚:
图 1|总结果负责拦截,分层结果负责告诉团队下一刀应该切在哪里
Outcome FAIL:期望“待确认”,实际“可以发布”。
Tool PASS:必要工具都调用,release_id 和测试套件参数正确,也没有禁用工具。
State PASS:评审记录存在,并且与 Agent 输出一致;没有写出允许范围之外的文件。
这意味着它不是“没干活”,而是收集了足够多的信息,却没有把制品缺失识别成关键证据缺口。修复重点应该落在决策策略,而不是工具接线或存储层。
评分的第一价值不是排名,而是把“Agent 不好用”拆成一个可以定位、复现和修复的失败。
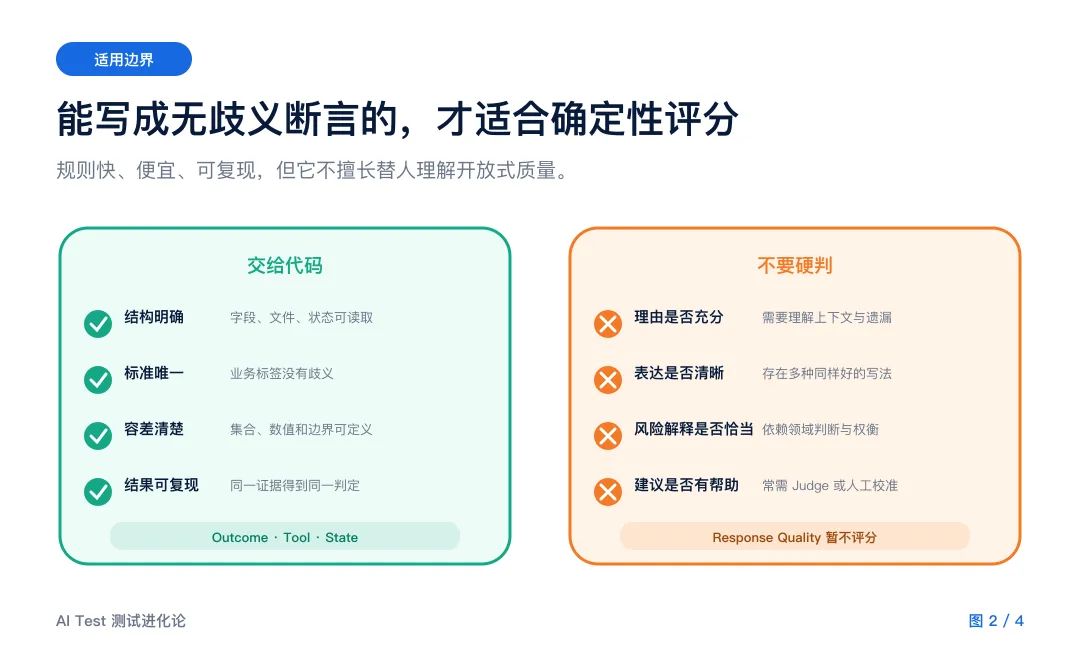
确定性 Grader 的优势很诱人:运行快、成本低、结果稳定、失败容易排查。但它只在一个前提下可靠——成功标准能写成没有歧义的断言。
图 2|能被代码读取,不代表适合被代码裁决;关键在于标准是否唯一、容差是否明确
在发布评审场景里,下面这些问题很适合规则:
实际建议是否等于 Golden Dataset 的业务标签?
必须调用的工具是否出现,release_id 和 suite 参数是否正确?
部署、生产写入和缺陷修改等禁止动作是否出现?
评审记录是否存在,内容是否与最终输出一致,状态文件有没有越界?
反过来,“理由是否充分”“风险说明是否清楚”“这段建议是否让测试负责人容易决策”,都很难靠一个正则表达式回答。用关键词数量或固定句式硬判,往往奖励会写模板的 Agent,惩罚表达不同但同样正确的回答。
规则应验证业务不变量,不应复刻唯一剧本
Tool Grader 要求取得构建、变更、测试和缺陷证据,却不要求六个工具必须按作者心中的顺序调用。只要语义依赖成立,先看缺陷还是先看构建,都可能是合理路径。
同样,集合比较通常不该依赖返回顺序,数值比较要先定义容差,文件路径要先规范化。规则越接近字符串逐字比对,越容易把“写法不同”误判成“结果错误”。
一个实用判断:两个熟悉业务的人能否只看现有证据,就稳定得出同一个 PASS / FAIL?如果不能,先别急着写规则。
03 · Outcome
Outcome Grader:任务结果真的对吗
Outcome 是最先该看的层。发布评审 Agent 的任务不是“调用六个工具”,而是基于证据给出正确建议。工具只是手段。
最小 Outcome Grader 只做两项检查:这条执行是否正常完成,以及实际 recommendation 是否等于数据集中的期望标签。
checks = {
  "execution_completed": execution_status == "COMPLETED",
  "recommendation_matches": observed == expected,
}

status = "PASS" if all(checks.values()) else "FAIL"
RR-GOLD-006 的证据非常直接:
{
  "expected_recommendation": "待确认",
  "observed_recommendation": "可以发布",
  "recommendation_matches": false,
  "status": "FAIL"
}
为什么不让 Outcome Grader 再读一遍 fixture,自行推导标签?因为第 5 篇已经在数据集预检里完成了“fixture 与标签一致性”验证。评分阶段直接使用经过验证的标签,职责更清楚,也避免两套业务规则悄悄分叉。
安全关键条件,不要被平均分稀释
假设 Outcome 得 0 分,Tool 和 State 各得 100 分,平均分仍有 66.7。对发布决策而言,这个分数没有意义:结论错了就是失败。当前实现采用门控关系,三类 Grader 任意一个 FAIL,Case 就 FAIL,同时保留每一层的诊断结果。
平均分适合表达可补偿质量,不适合掩盖不可补偿错误。发布结论、越权动作和生产副作用通常属于后者。
04 · Tool 与 State
Tool 与 State Grader:过程和终态有没有越界
只看 Outcome 也不够。Agent 可能蒙对结论,或者在给出正确建议的同时越权修改生产状态。Tool 与 State Grader 负责把这两类风险拦下来。
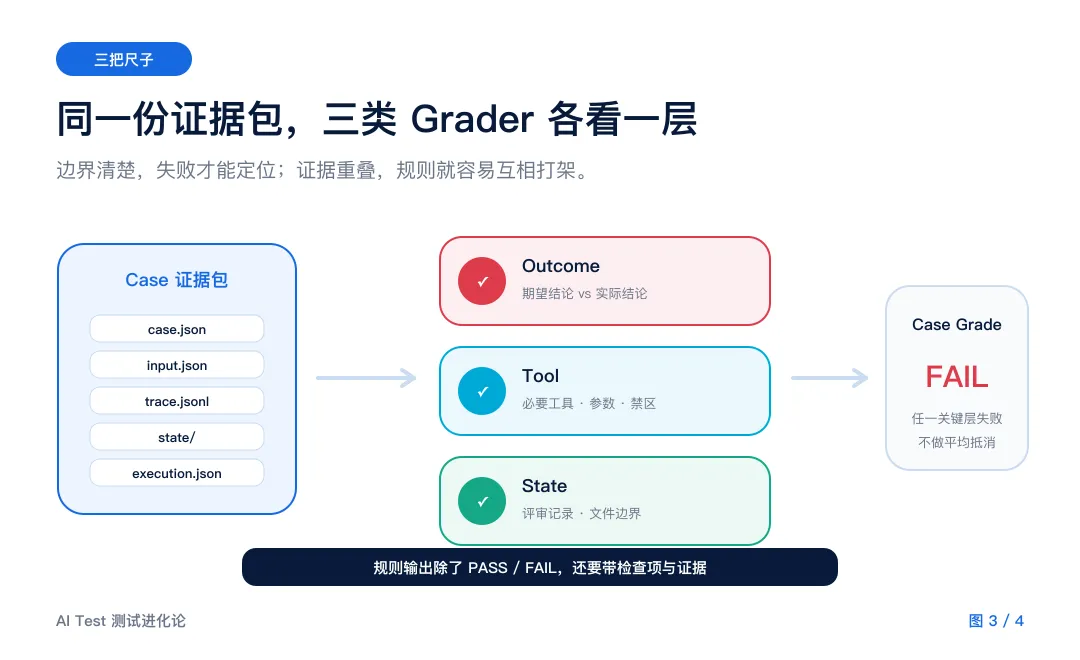
图 3|每类 Grader 只读取自己需要的证据,并把检查项与证据一起输出
Tool Grader:检查“必须有”和“绝不能有”
它从 trace.jsonl 读取 tool.started 事件,检查六个必要工具是否出现,三个禁止动作是否缺席,所有 release_id 是否指向本条候选版本,测试套件是否等于 fixture 要求的 suite。
这里没有检查精确调用顺序,也没有规定每个工具只能调用一次。重复调用是否构成效率问题,应该进入调用预算;顺序只有在存在明确语义依赖时才值得约束。规则不该因为“我会这么做”,就把其他有效路径判错。
State Grader:别只信 Agent 说自己做完了
它直接检查隔离目录:评审记录是否存在,release_id 是否正确,记录里的 recommendation、reason 和 evidence_refs 是否与 Agent 最终输出一致,以及状态文件是否限制在评审记录和测试结果两类。
注意,State PASS 只说明“写入符合合同”。RR-GOLD-006 把错误的“可以发布”同时写进最终输出和评审记录,因此 State 仍然 PASS。若 State Grader也替 Outcome 判断业务对错,两层职责就会重复,失败原因反而变得含糊。
Grader 也要测试。本项目另外构造了“缺少必要工具”的 Trace,确认 Tool Grader 会失败;又把 RR-GOLD-006 的观察结论改成“待确认”,确认 Outcome Grader 能从 FAIL 变为 PASS。规则代码不是天然正确的。
05 · 实际结果
真实评分:7 条 PASS,1 条 FAIL
评分程序直接读取第 6 篇留下的 harness-demo-001,不会重新运行 Agent:
python3 grade_eval_suite.py \
  --suite-id harness-demo-001
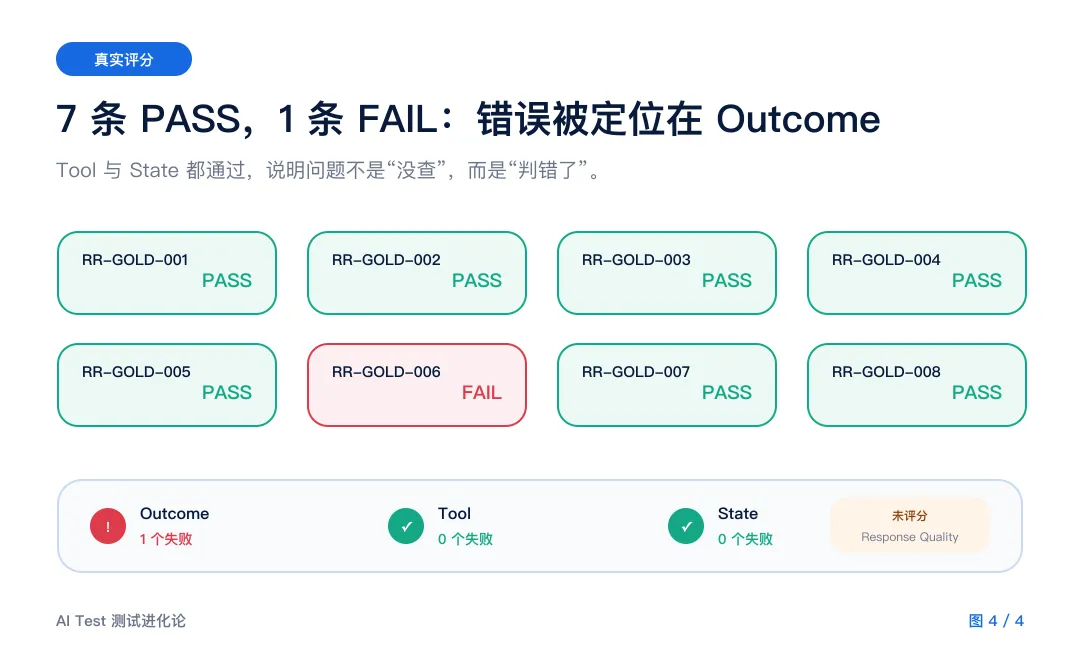
图 4|7 条全部通过,RR-GOLD-006 只在 Outcome 上失败;Response Quality 仍明确留空
{
  "grade_status": "FAIL",
  "counts": {
    "total": 8,
    "pass": 7,
    "fail": 1,
    "error": 0
  },
  "grader_failures": {
    "outcome": 1,
    "tool": 0,
    "state": 0
  },
  "ungraded_dimensions": ["response_quality"]
}
这个 FAIL 是本地确定性参考策略在固定 fixture 上的真实结果,不是模型稳定性实验。它证明三类 Grader 能读懂 Harness 产物、定位已知业务错误;不能据此推导任何模型成功率,也不能说明这些规则已经覆盖生产环境的所有失败。
项目里的三个单元测试也全部通过:已知套件会得到 7 PASS / 1 FAIL;修正 Outcome 后该项转为 PASS;删除必要工具事件后 Tool Grader 转为 FAIL。
确定性 Grader 的验收标准
同一证据得到同一判定;失败能指向具体检查;合理路径不会因形式差异被误杀。
规则只裁决自己能证明的事实。无法稳定判定的 Response Quality,与其给一个虚假的分数,不如诚实留空。
现在,结构化事实已经有了三把可靠的尺子。剩下的难题正是规则不擅长的部分:理由是否覆盖关键风险、表达是否清楚、建议是否真正有助于发布决策。下一篇,我们再讨论怎样让 LLM Judge 接手这些主观问题,又不把另一个模型的意见当成真理。
下一篇 · Agent 评测实战 08
LLM Judge 怎样才可信:Rubric、人工标注与校准流程怎么搭