我是老薛,今天来聊聊「图像分割的三种粒度怎么选」——一次只讲一个事情。这是「人工智能数据标注」的第 10 期,也是新排期 A 段(文字载体的数字化)的头一篇。上一期讲框,框是方的,可世界不是方的:印章是圆的,豌豆叶带锯齿,古籍里一整块插图还带着虫蛀的破洞。这些要标到「哪一片像素属于它」,就得从框往上走一步,走到分割。这一期有个刚出炉的现实由头:2026 年 10 月 16 日,中国政府采购网公布山东省智慧图书馆体系「珍贵古籍数字化及其知识化加工项目」中标结果,标书里要求加工软件支持字框、列框等多类型版面切分,并执行 2024 年 2 月国家图书馆《古籍数字化和知识标引规范手册(暂行)》。也就是说,出版社和图书馆现在掏钱买的,已经不只是「把字认出来」,而是「把这一页切成有结构的区域」。切区域,就是分割。
先把三种粒度的名字对上号。
语义分割:逐像素分类,只回答「这个像素属于哪一类」,不区分个体。三片叶子全涂成同一个「叶子」类,涂完数不出有几片。
实例分割:逐像素 + 区分个体。三片叶子三个 ID,能数出三片,需要「类别」和「个体编号」两个字段。
全景分割:两者合一。可数的(叶子、印章、插图)给实例 ID,不可数的背景(纸面、天头、地脚)给语义类,全图每个像素归属且只归属一次。
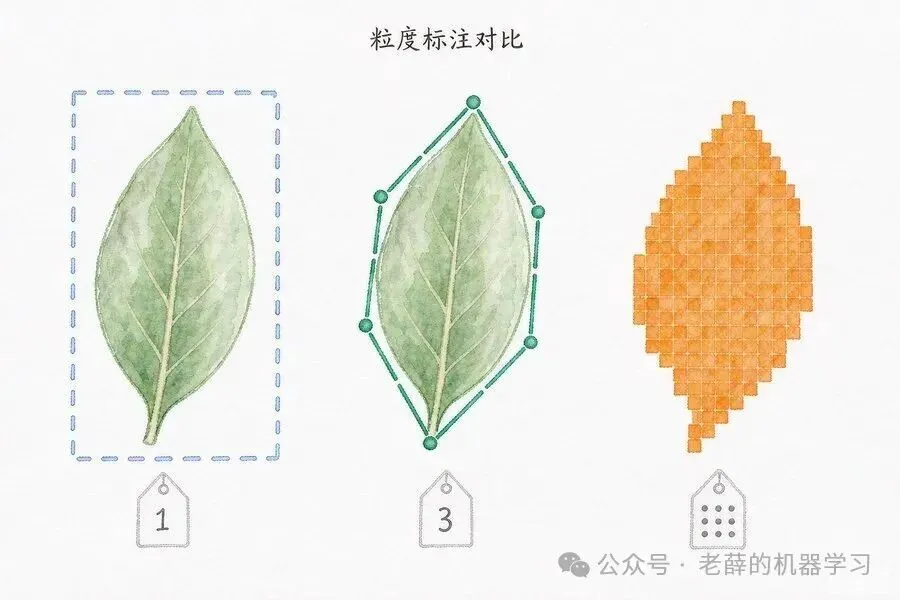
再看价钱。计价单位跟着粒度变:框是「个目标」,一次 4 次点击;多边形是「个点」,一条周长约 460 像素的叶形轮廓要 23 到 154 个点;像素级是「个像素」——600dpi 扫一页,一个插图区轻易几十万像素,验收时逐像素算账。
左:框,4 次点击;中:多边形,几十个点;右:像素级,逐像素计价
一句话记住粒度与价钱:粒度越细越贵,但下游能做的事越多;越粗越省,但下游只能做粗活。选型不是越细越好,是看下游要拿它干什么。
规矩一:顶点密度按曲率给,别按个数给。
最常见的一刀切规范是「每个目标 20 个点」,这是偷懒写法:规则形状浪费点,不规则形状不够用。正确写法是按弯曲程度定间距——平直处 10 到 20 像素一点,曲率大处 3 到 5 像素一点。下表是自跑实验的读数:一条周长约 460 像素的不规则叶形轮廓,整条边界用同一间距布点的结果。
读法:间距从 20 收到 10 像素,点数翻倍、IoU 从 96.3% 抬到 99.2%,这段最划算;再往下收到 5、3 像素,点数还翻倍,IoU 只挪到 99.8%,纯烧钱。所以规范写「平直处 10–20 像素、曲率大处 3–5 像素」是对的,但必须补一句:只有曲率大的地方才用到 3–5 像素。
规矩二:点数预算紧的时候,先改布点方式,别硬加点。
同一形状、同样 12 个点:均匀布点(沿周长等分)拿到 IoU 88.2%,按曲率自适应布点(弯处密、直处稀)拿到 90.0%,白赚 1.8 个百分点。但收益随点数衰减——24 个点只赚 0.6 个百分点,48 个点只剩 0.08。结论:点数少于 16 个时改布点方式最划算;到 48 个还在纠结,就该换工具了。
规矩三:孔洞要单独成环,断裂不要硬连。
虫蛀的洞、印章缺笔的口,这些「属于背景却被目标包围」的区域是孔洞。通行做法是再画一个内环,且绕行方向与外环相反(外环顺时针、内环逆时针),靠方向告诉下游哪儿实心哪儿是空。用奇偶规则填充的工具可以不反向,但规范必须写死一种,否则同一个文件在不同工具里解出的 mask 会打架。至于断裂:笔画断成两截、墨迹中间有白道,按一个目标标,不拆成两个,拆了下游实例计数就错。
规矩四:工具按边界硬度选,不按习惯选。
出版场景里两类工具各有主场:CVAT 多边形适合硬边——印章方框、插图边界、版心四至,边界干脆,导出 COCO polygon 直接可用;Label Studio 的笔刷适合软边与残缺——残字、洇墨、虫蛀边缘,这些地方不存在「正确的那条边」,刷一条经验边界比硬点二十个点更接近共识。规范里写死一句:硬边用多边形,软边用笔刷,同一目标不得混用两种画法——混用会让一致性统计失去意义。
规矩五:mask 存 RLE 还是 PNG,看你要拿它干什么。
COCO 生态默认把 mask 存成 RLE(行程编码:一串「空多少、实多少」的计数),Label Studio、CVAT 也能导出 PNG。很多人以为 RLE 是为省空间,其实不是。下面是 256×256 画布实测(整块位图 8192 字节):
读数很反直觉:越规则的形状,PNG 越碾压 RLE——版面条块这种直边区域,PNG 只要 55 字节,RLE 要 944 字节。RLE 的价值不在省空间,而在另外三件事:能按实例存、能直接算面积和交集、能塞进 JSON。选型判据:进 COCO 生态做训练评测用 RLE;给人看、给印刷环节用、要长期归档用 PNG。
下面是自跑的最小实验,seed=42,画布 256×256:真值用解析式生成(圆盘与不规则叶形),多边形按奇偶规则栅格化,逐像素比对。声明在前:这是最小类比,不是任何真实分割项目的复现,看趋势和口径,不看绝对值。
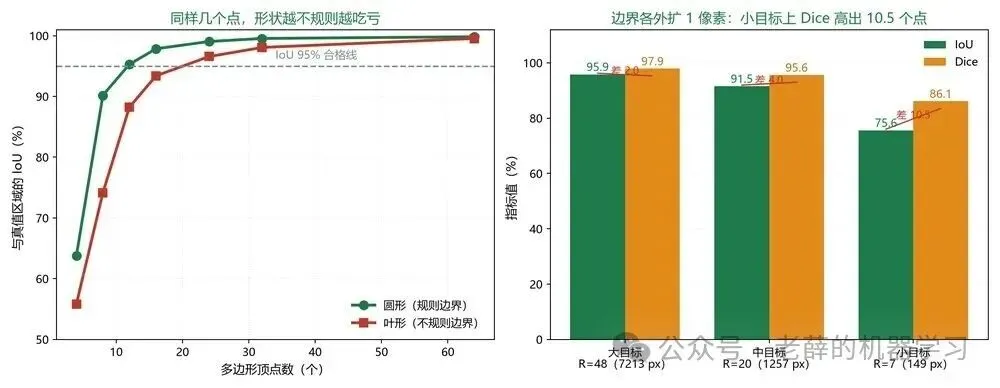
读数一:同样几个点,形状越不规则越吃亏。
同为 8 个顶点:圆形拿到 IoU 90.2%,不规则叶形只有 74.2%;跨过 95% 合格线,圆形 12 个点就够(95.3%),叶形要 24 个点(96.6%),16 个点还差(93.4%)。「每个目标标 12 个点」这条规范,对圆形已合格,对锯齿状目标差了 7 个百分点。
读数二:小目标上,Dice 会比 IoU 高出一大截。
给目标边界整体外扩 1 像素(模拟手抖),看两个指标怎么报数:
同样外扩 1 像素,小目标上 Dice 比 IoU 高出 10.5 个点
同一批标注、同一个误差,小目标上 Dice 比 IoU 高出 10.5 个点,大目标只高 2.0 个点。原因不是谁更准,而是数学关系:Dice = 2×IoU/(1 + IoU) 是恒等式,两者严格单调等价,排序永远一致。但数值口径完全不同,阈值不能混用:
选型判据:小目标占比高的项目(古书里的小印章、遥感里的小房子),用 Dice 验收等于自动放水。医疗与遥感偏爱 Dice 有道理——那些场景边界本身模糊、真值也不唯一,IoU 惩罚过重会淹没有意义的差异;但你要知道它是把标准调松了,不是更准。
边界说明:真值为解析式,误差为整体等距外扩;真实项目误差是不均匀抖动,模型也会平滑部分噪声,实际差距通常小于本表。要看方向:目标越小,Dice 与 IoU 差值越大,阈值换算必须写进规范。
这期作业:给项目写一份能落地的分割标注规则,六步按优先级排:
1先定粒度,再定字段。要数个数用实例分割(带实例 ID),只切区域用语义分割(只带类别 ID)。定错则后面全返工。
2顶点间距写进规范,区分曲直。平直处 10–20 像素一点、曲率大处 3–5 像素一点;给「曲率大」配可操作判据(如相邻两段方向变化超 30 度)。
3给孔洞和内环定绕行方向。外环顺时针、内环逆时针(或相反),全项目统一,写明填充规则是奇偶还是非零。
4按边界硬度分工:硬边多边形、软边笔刷。同一目标不得混用两种画法。
5验收指标写死并附阈值换算表。内部建议 IoU≥0.75;若用 Dice 则写 Dice≥0.857,并按目标面积分档报数。
6导出格式一次定终身。进训练用 COCO RLE,交付归档用 PNG,两种都导。
本期的可拿走产物两件:outputs/templates/17-标注规范模板-通用.md 的第一块(任务定义 + 标签体系 + 边界规则),以及 outputs/templates/mIoU_Dice_计算.py(输入两个 mask 数组,出 IoU、Dice、分档统计与阈值换算)。后面 26 期往同一模板继续加块。
第一问:这在流水线的哪一格?
在 A 段「扫得了字」内部,具体是版面元素区域分割这一格:上接扫描(拿到整页图),下接第 11 期的版面分析(页→栏→段落→行)。没有这一步,阅读顺序、跨页断裂、页眉页脚剔除都无从谈起。山东标书里的「字框、列框等多类型版面切分」,说的就是这一格加下一格。
第二问:上线前后工作量差多少?
纯手工:框 4 次点击一个目标,多边形 23 到 154 次点击一条轮廓,像素级按像素量级计。加预标注(模型出 mask、人只改错)后,布点量从几百次点击降到几次点击加目视确认——这是一体化视觉模型(点、框、掩码、matte 一个模型全出)值得关注的原因。但记住上一期的教训:预标改出来的只能进训练集,验证集与测试集必须留人手原标。
第三问:下游拿它干什么?
四件事:一、抠图,插图前景做成数字资产;二、印章、眉批、藏书票各切独立区域,各走各的识别流程;三、这批区域就是第 11 期版面分析模型的训练数据;四、资产盘点——一册书多少插图、多少印章、版心多大,全变成可统计的数字。出版社愿为「切区域」掏钱的真正原因在这里:它不是标注,是把实物变成可清点的资产。
- 三种粒度:语义只分类不计数、实例分类又计数、全景两者合一;计价单位从「个目标」→「个点」→「个像素」。
- 顶点按曲率给:平直处 10–20 像素、曲率大处 3–5 像素。实测(周长约 460 px 叶形):20 px→23 点 IoU 96.3%,10 px→46 点 99.2%,再加密收益极小。
- 点数少于 16 个时改曲率自适应布点,同点数白赚 1.8 个百分点;到 48 个还纠结就该换工具。
- mask 存储:PNG 在规则区域上远省于 RLE(版面条块 55 B vs 944 B);RLE 的价值在按实例存、算面积、进 JSON。
- 指标口径:Dice = 2×IoU/(1+IoU),排序一致但阈值不能混用(Dice 0.90 = IoU 0.818)。小目标上 Dice 比 IoU 高出 10.5 个点,小目标占比高的项目用 Dice 验收等于放水。
下一篇是第 11 期:OCR 与版面分析(一)——一页书怎么变成结构化数据:元素层级怎么定(页→栏→段落→文本行→词)、阅读顺序有哪两种标法、什么时候必须标倾斜框、输出格式在 PAGE-XML 与 JSONL 之间怎么选。
参考资料:1. 中国政府采购网《2026 年山东省智慧图书馆体系建设珍贵古籍数字化及其知识化加工项目结果公告》(2026-10-16):要求 600dpi 全彩冷光源扫描、24bit;加工软件须支持字框、列框等多类型版面切分;须执行 2024 年 2 月国图《古籍数字化和知识标引规范手册(暂行)》及 2014 年 5 月《古籍数字化工作手册》(V.1 修订版)。2. AI/TLDR 模型发布页收录:腾讯开源 WeVisOne-VL(2026-10-24),覆盖点、框、掩码到像素级 matte。本文仅以之说明像素级标注的工具门槛在下降,未做实机评测。3. 自跑实验:work/实验-图像分割-20261029.py,结果存 work/实验结果-图像分割-20261029.json。画布 256×256,seed=42,真值为解析式(圆盘与叶形 r=60×(1+0.28sin3θ+0.12sin5θ)),多边形按奇偶规则栅格化。属最小类比,非真实项目复现。4. Dice = 2×IoU/(1+IoU) 为二集合情形下的数学恒等式,本文阈值换算表据此计算;mIoU 为 PASCAL VOC 等基准的通行指标,Dice 在医学影像与遥感中广泛使用。5. 存储对比中 RLE 体积按行程数 × LEB128 估算(非 COCO 实际文本字节),PNG 体积以 zlib 最高压缩级别处理位图近似(非真实编码器输出),均作量级对照。6.「六步」「三问」及选型建议为作者基于上述材料与本实验的分析,不含未公开实测数据。