YOLO学习03-评测指标(精确率、召回率、mAP50、mAP50-95)
- 更新时间 2026-10-29 03:35:46
YOLO学习03-评测指标(精确率、召回率、mAP50、mAP50-95)YOLO学习02-自定义数据训练(数据集准备、标注、训练、推理) 👆在上一章的训练结果中可以看到训练后在runs目录下生成了train文件夹作为训练的结果,其详细目录结构如下: 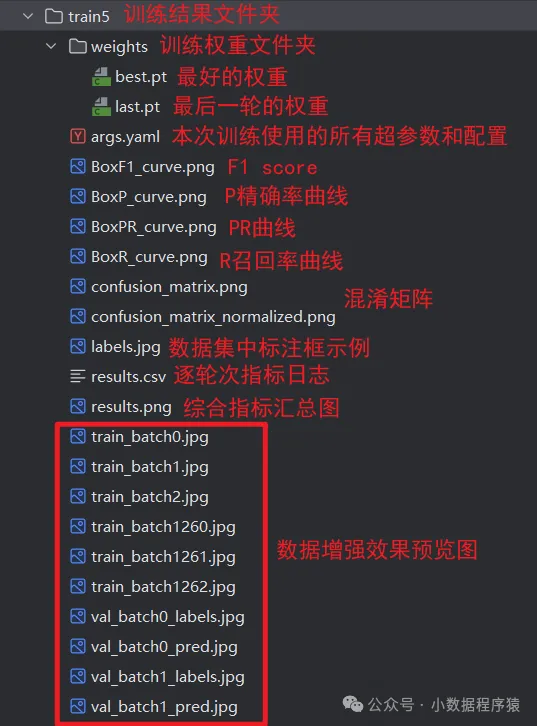
一、通用概念 在预测框与真实框之间: IoU:交并比,交集面积/并集面积,表示两个框的重合程度,越接近于1说明检测越准确。一般IoU>0.5就算命中。 TP:True Positive,预测正确的样本数; FP:False Positive,预测错误的样本数; FN:False Negative,待预测的所有正确样本中未被预测正确的样本数,即真实结果中多少个漏掉了没找到。
二、精确率P Precision,预测正确的样本/预测的所有样本,精确率高说明预测结果中很多都是对的,即误报少; 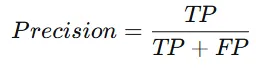
随着conf变化的趋势:conf越低,精确率越低,会出现误报;conf越高,排除掉的垃圾预测框就多,精确率越高。 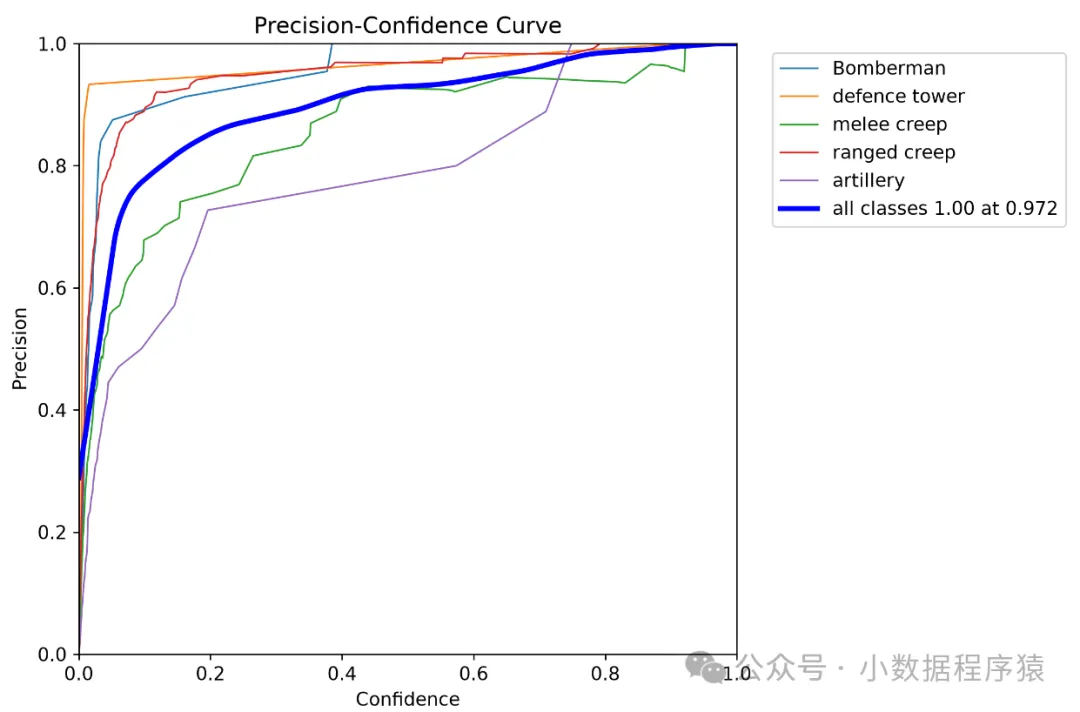
三、召回率R Recall,也叫查全率,预测正确的样本/真实正确的结果总数,召回率高说明真实结果里很多都被预测对了,即漏报少。 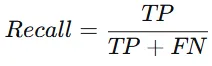
随着conf变化的趋势:conf的提高可能会误排除一些预测正确的框,召回率就会降低一些。召回率越低,会出现漏报。 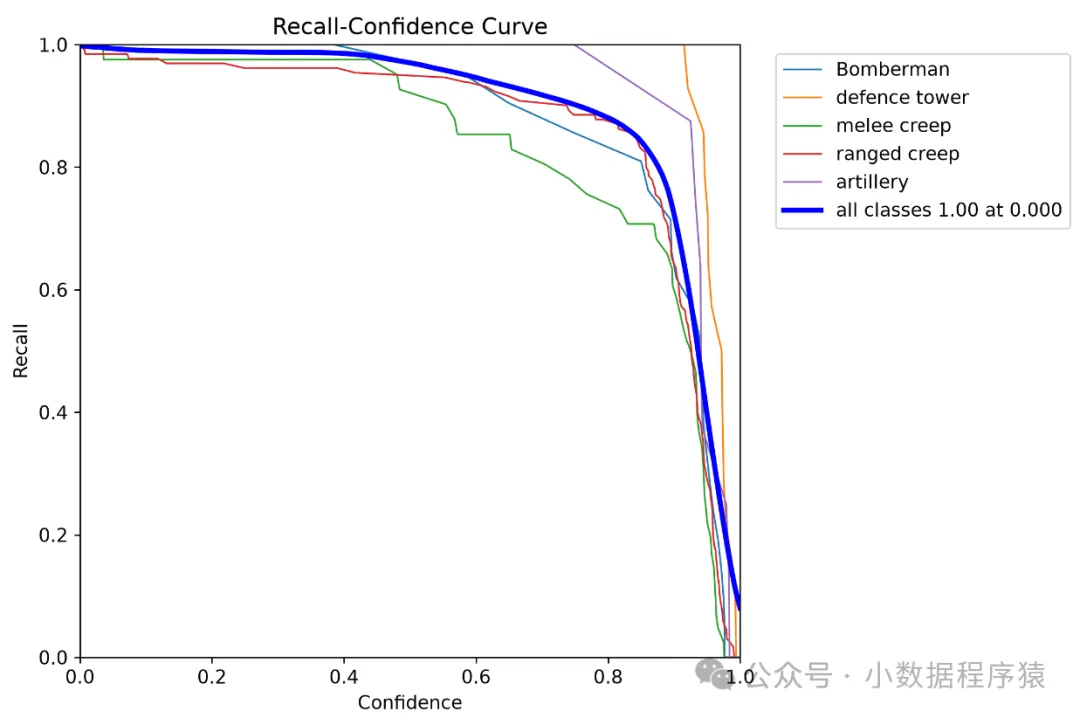
四、P-R曲线 精确率和召回率组成的曲线。是评估检测性能最核心的图表之一,曲线下的面积(AP)越大,即曲线越靠近右上角,模型性能越好。多个类别的AP取平均,得到mAP。 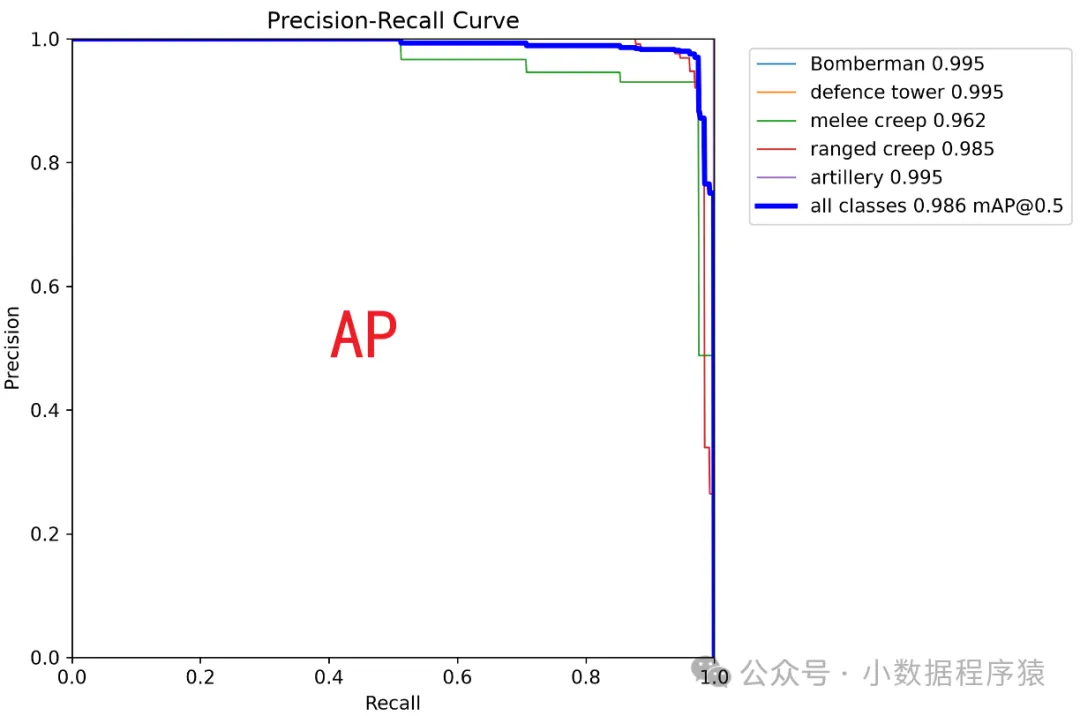
mAP50:所有类型的AP进行平均,便得到mAP,即平均平均精度。 mAP50-95:IOU从0.5依次取值到0.95,得到的所有mAP的值进行求平均,得到mAP50-95,即平均平均平均精度。 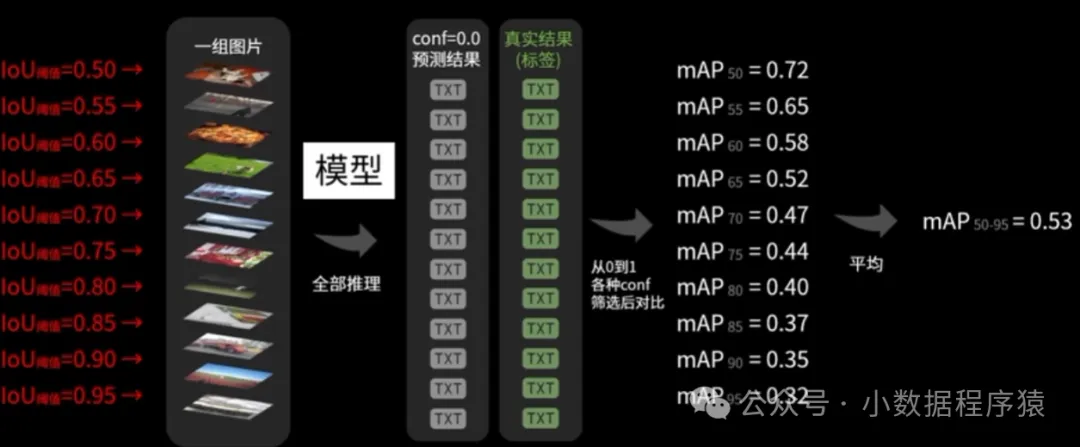
(该截图来自b站up:林亿饼) 每轮训练的验证过程的日志中可以看到以上这几个指标的值: 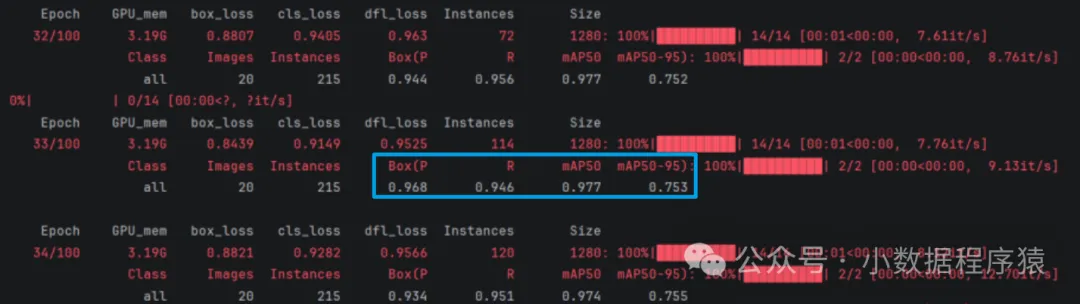
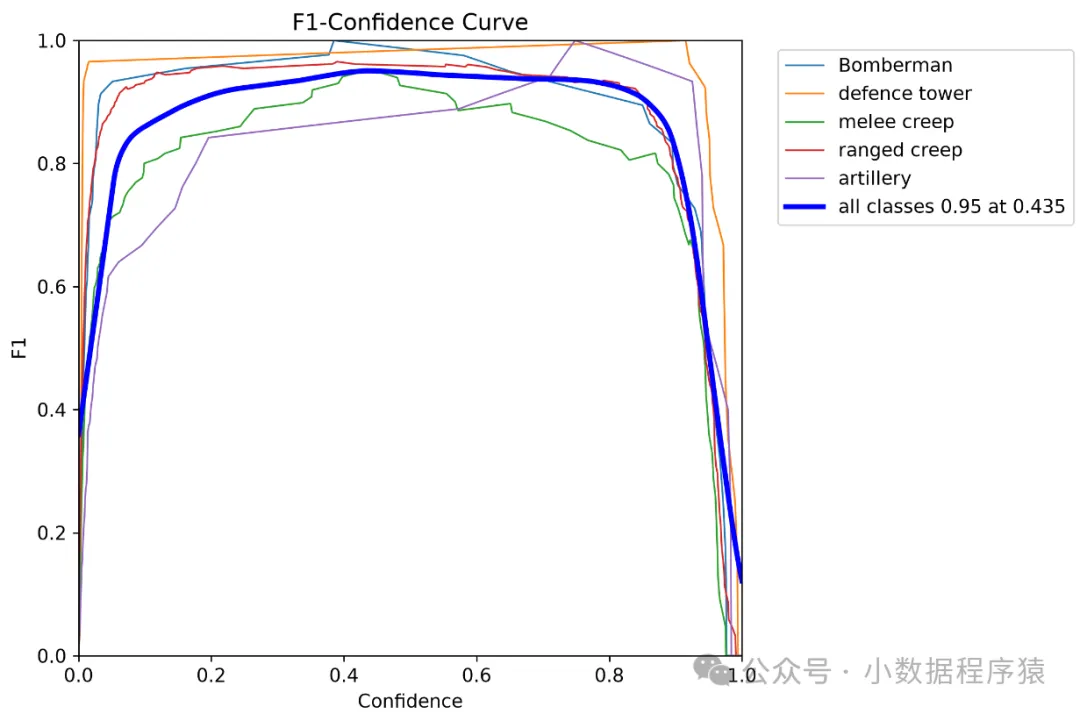
五、F1 score 是精确率和召回率的综合分。不只看精确率或只看召回率,而是要求两者都比较高,其中只要一个被拉低,F1就会被拉低。 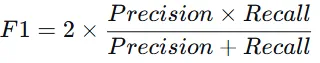
六、混淆矩阵 精确表示模型在哪些类别之间容易混淆。横轴为预测类别,纵轴为真实类别,对角线上的数值表示正确分类的比例,非对角线则表示误分类。右图(confusion_matrix_normalized.png)为归一化版本,为错误率表示。 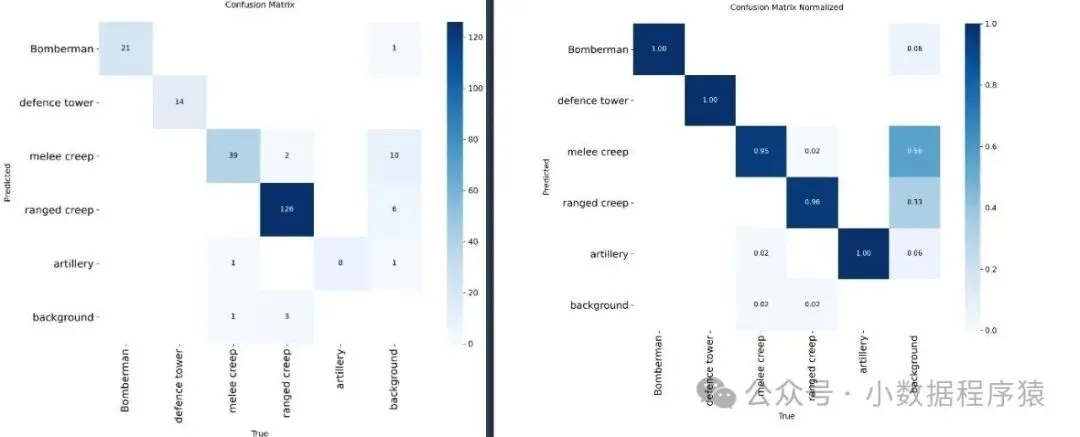
七、权重文件.pt 对上面P、R、mAP、mAP50-95这四个指标做加权平均,即每个指标分别和对应的权重相乘后再求和,得到每一轮训练的fitness,即每一轮训练的模型对验证集的适应度。 每一轮都会把本轮的fitness和最优的fitness进行对比,如果比最优的还要好的话,就会把当前模型保存成best.pt。所有轮训练完成后拿到best.pt验证验证集,得到四个指标曲线进行保存。 此外每一轮训练都会把当前模型保存成last.pt。
八、数据增强效果预览图 在投入大量计算资源之前,用肉眼快速确认"喂给模型的数据"是否正常,是排查数据问题的第一道防线。 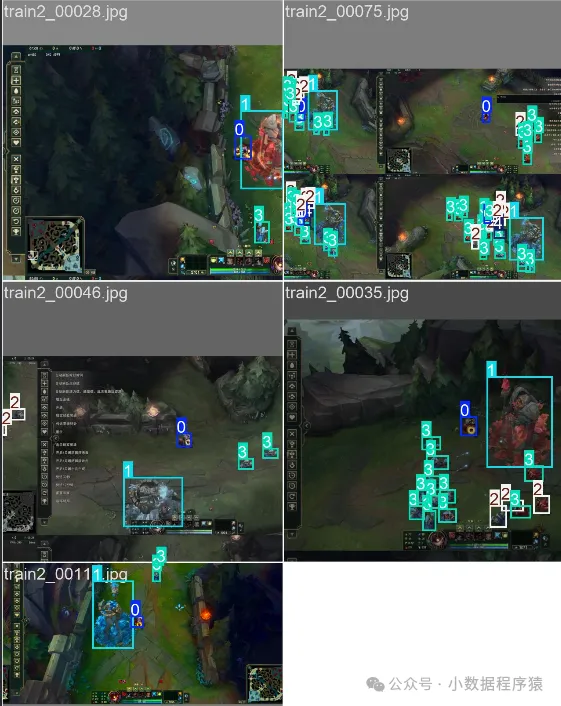
8.1 train_batch*.jpg 检查训练数据是否加工合格。 训练时,YOLO会对图像进行在线数据增强,如Mosaic拼接、颜色变换、缩放等。这些图片展示的就是经过增强后,实际输入模型的训练样本。主要检查:1. 增强操作是否正常生效;2. 标注框是否与增强后的图像"严丝合缝"
展示模型对验证批次的预测结果(画出了预测框和置信度)。这是最直观的定性评估方式,可以让你亲眼看到模型在没见过的数据上表现怎么样: 8.4 总结 像 mAP、F1 这些指标是定量的,告诉你"好不好";而这些预览图是定性的,帮你回答"为什么不好"。
如有任何问题或建议,欢迎在评论区留言或后台私信~
8.2 val_batch*_labels.jpg
展示验证集的真实标注,因为验证集没有经过复杂的在线增强,这些图可以用来核验验证数据本身的标注质量:框是否漏标、错标,类别是否正确。
8.3 val_batch*_pred.jpg
预测框是否与目标对齐;
置信度是否合理(正确目标通常置信度较高);
有没有明显的漏检(真实有目标但没框)或误检(框在了背景上)。
如果 mAP 很低,查看 val_batch*_pred.jpg 可能发现模型系统性地漏检某一类小目标,从而指向锚框(anchor)不匹配或该类别样本不足的问题。
如果训练损失正常但验证指标不佳,检查 train_batch*.jpg 可能会发现增强过强,导致训练分布与验证分布差异过大。
感谢您的关注~🌹
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
