一个客服 agent 接到用户提问:「年度会员买了第 20 天,还能退款吗?」它回答得很干脆:「7 天内可以全额退款,超过 7 天不支持退款。」用户截图投诉,因为现行政策是「30 天内按剩余天数退款」。
复盘时几个方向都有人提:换一个更好的 embedding 模型,把 chunk 切小一点,换一个更强的生成模型,把 prompt 写得再严一点。每个方案都说得通,可没人说得清这条错答到底错在哪一步。
这条错答背后至少有四种可能,分别落在链条的四层上:
| | |
|---|
| 旧版政策没下线,新旧两版一起进了上下文,模型跟了旧版 | |
| 新版在知识库里,但排第 6,被 top-5 截掉,没进上下文 | embedding、chunk、rerank、k 值 |
| 新版进了上下文、旧版没进,模型还是答 7 天,它更相信自己熟悉的「7 天无理由退货」 | |
| agent 判断这是常识问题,根本没调检索,直接答了 | |
四种根因,修法完全不同。方向判断错了,花一周换完 embedding,错答还在。
麻烦在于,四种根因产出的是同一句话。「7 天」可能来自旧版文档,可能来自模型脑子里的常识,也可能是 agent 压根没查。只看最终答案分不出来,必须看过程:上下文里有没有新版、有没有旧版,agent 有没有调检索。
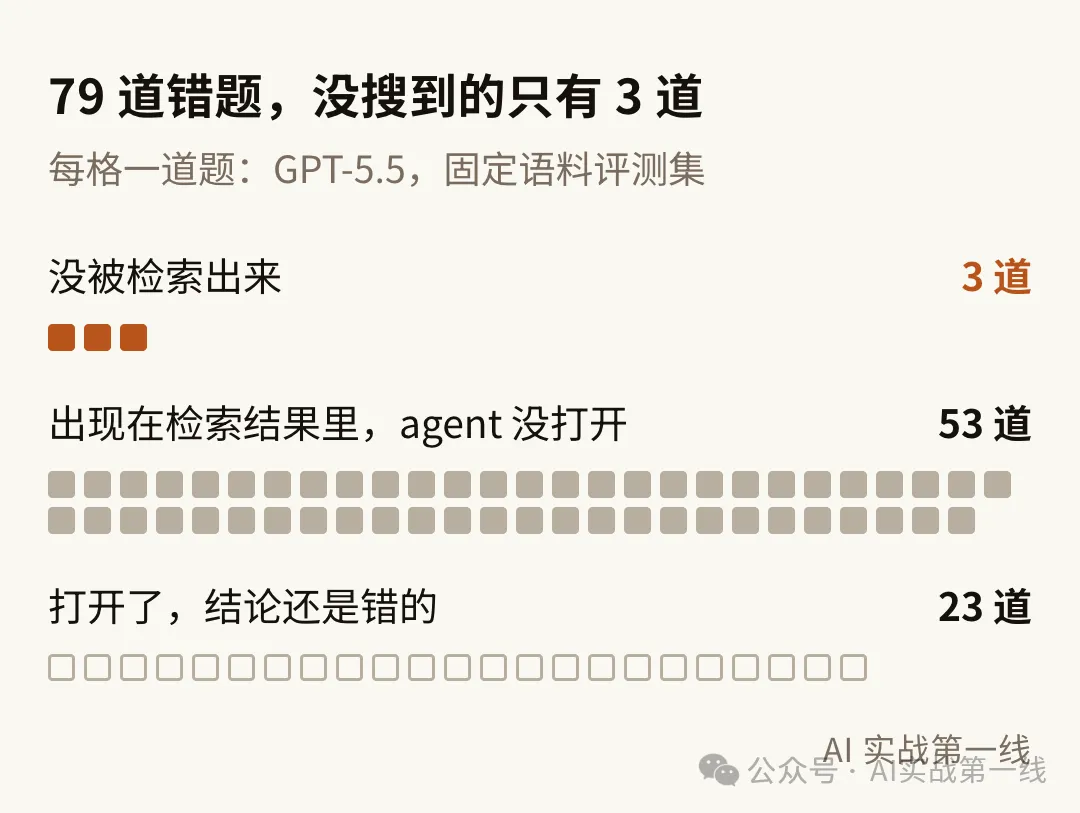
大家最先怀疑的通常是检索,但检索未必是主因。2026 年 9 月一篇研究深度搜索 agent 的论文里,GPT-5.5 在一个固定语料的评测集上答错了 79 道题,标准答案所在的文档根本没被检索出来的只有 3 道。另外 53 道,文档已经出现在检索结果里,agent 没打开;剩下 23 道,文档打开了,结论还是错的。
换到企业私有文档上,比例又不一样,分块和检索的问题能占到六成。「先怪谁」没有通用答案,只能一层层查。
这篇按指标从简单到复杂讲 RAG 评测:召回率和精确率,排序,陈述级召回,生成侧指标和拒答,再把检索和生成交叉起来定位,然后放到知识库和 agent 链路里。每一层都回到这条退款错答,看这一层的指标能查出什么、查不出什么。最后一节讲怎么在团队里把这套评测跑起来:测试集怎么建,trace 记什么,多久跑一次。
最朴素的一组指标,前提是你知道每道题「该找到哪几块」。给测试集里每道题标出证据在哪,比如退款这道题,证据是新版退款政策第 2 条的原文。检索返回 top-k 之后,把证据映射到对应的块,再按块 ID 比对:
Hit Rate@k(命中率) —— top-k 里至少命中一个证据块的题目占比。只关心捞没捞到,适合做冒烟测试Recall@k(召回率) —— 证据块里有多少进了 top-k。一道题需要三块证据只捞到一块,召回率就是三分之一Precision@k(精确率) —— top-k 里有多少块是证据。上下文预算紧的时候要盯它,每塞进一块无关内容,都在多花 token、多加噪声这三个数按 ID 算,不调 LLM,同一个检索版本跑两次结果完全一样,几乎没有成本。它们是 RAG 评测里最该先建、也最常被跳过的一层。很多团队一上来就接 LLM 打分的框架,检索侧却连一个可复现的基线都没有。
标证据有个实操细节:不要直接标 chunk ID,要标「文档 ID + 原文片段」。分块策略一改,chunk ID 全部重排,按 ID 标的测试集当场作废;按原文片段标,评测时再映射到当前的分块上,换多少种切法都能复用同一套标注。
回到退款那道题:新版政策那一块不在 top-5 里,召回率就是 0。只要确认新版确实在知识库里,问题就定位在检索层。
召回率低的时候,检索就是主瓶颈,换检索器的收益最直接。2026 年 3 月的 AgentIR 论文让同一个深度搜索 agent(Tongyi-DeepResearch)换检索器,答题准确率从 BM25 的 33.98% 升到 Qwen3-Embedding-8B 的 50.72%,换成论文自己训练的检索器后到了 66.27%。
这一层有两个常见的误读:
跨 k 值、跨 chunk 大小比绝对值 —— 没有意义。k 越大召回率越高,k 接近语料总量时召回率恒为 1;chunk 切得越小,同样的上下文预算里能塞进更多块,召回率也天然偏高。比较 256 和 512 两种切法时,要先固定上下文的 token 预算,再看端到端的结果把召回率高当成证据被用上了 —— 召回率高只说明证据进了结果列表。开头那 79 道错题里,有 53 道的标准答案文档就在检索结果里,agent 没打开。有没有被用上,要往后看召回率不管顺序。新版政策排第 1 还是第 5,Recall@5 都一样,可对生成来说差别很大:排在前面的证据更容易被模型用上,排在后面的常常被忽略,或者在截断时被挤掉。退款那道题里,新版排第 6、被 top-5 截掉,就是排序的问题。
排序看两个指标:
MRR(平均倒数排名) —— 只看第一个命中的证据排第几,排第 1 得 1 分,排第 2 得 0.5 分,排第 5 得 0.2 分。适合一条证据就能回答的事实型问题nDCG@k(归一化折损累计增益) —— 每个命中按位置打折,越靠后折扣越大,还能处理分级相关性(相关程度分几档标注,不只是相关、不相关)。多条证据都重要时用它实际系统一般分两段,各看各的指标。粗召回阶段 k 取几十到上百,只看召回率,任务是别漏;rerank 之后 k 取 3 到 10,看 nDCG 和 MRR,任务是把最有用的排到最前。
评 rerank 有个常见错误:拿 rerank 前的 Recall@50 和 rerank 截断后的 Recall@5 比,后者必然更低,这是截断的代价,不是 rerank 变差了。正确的比法是在同一个 k 下比:rerank 后取前 5,对比不做 rerank 直接取前 5。
这一层最容易踩的坑,是一个名字像精确率、实际只看排序的指标。RAGAS 的 Context Precision 按位置加权算精度,分母是「top-K 里被判为相关的块数」,不是「语料里一共有多少相关块」。
后果是:100 个相关块只捞上来 1 个,只要它排在第 1 位,Context Precision 就是满分 1.0。这个指标回答的只是「已经捞上来的,排得对不对」,对召回率完全不敏感。把它当成「检索准不准」的综合分,会把一个漏召回很严重的系统看成满分。
三、陈述级召回:从「找到文档」细化到「找到那句话」
按块算召回有个盲区:块找对了,块里不一定有回答需要的每一条信息。退款政策那一块如果只写了「年度会员支持退款」,没写「按剩余天数计算」,块召回是满分,模型照样答不全。
陈述级召回把粒度从块细化到句子。先把标准答案拆成几条独立陈述,退款这道题可以拆成「30 天内可以退」「按剩余天数计算」「超过 30 天不退」三条;再逐条判断检索结果里有没有支撑它的原文。三条里有两条找得到依据,召回率就是三分之二。RAGAS 的 Context Recall、Amazon 的 RAGChecker 框架里的 Claim Recall,都是这个思路。
它比块召回多出两样代价:要有标准答案,每道题还要调 LLM 拆句、判定,成本和不确定性都高一个档次。建议分层用:日常回归跑块召回,碰到「块召回满分、答案仍然错」的题,再用陈述级召回去查。
证据进了上下文之后发生的事,要靠生成侧的指标来看。
生成侧最常用的指标是忠实度(Faithfulness):把回答拆成独立陈述,逐条判断能不能在检索上下文里找到依据,有依据的陈述占比就是分数。
退款那条错答,如果上下文里只有旧版政策,「7 天内全额退款」完全忠实于上下文,忠实度满分,答案照样是错的。所以生成侧至少要分开看三件事:
忠实度高、正确性低,问题在上下文本身,回检索层或数据层去查;忠实度低,说明模型加了上下文里没有的东西。
同样叫忠实度,三家主流框架目前的判据并不一样:
RAGAS —— 陈述必须能从上下文直接推出,推不出就算不忠实DeepEval —— 只要不和上下文矛盾就算通过。新版把「上下文里没有依据」的陈述单独归为 borderline,默认配置下 borderline 也算通过LlamaIndex —— 整段回答只判一次「是」或「否」,上下文里任何一处支持就判「是」,哪怕大部分上下文都和它无关一条靠模型自身知识答对的回答,在 DeepEval 上拿高分,在 RAGAS 上被扣分,两个框架给出相反的信号。所以忠实度分数不能跨框架比,换框架等于换了一套打分标准,历史分数要全部重跑。
带引用的回答还要多查一步,分两层:先查出处在不在、链接能不能打开,这一层用规则就能做;再查出处的原文撑不撑得起这句话,这一层要 LLM 或人工逐条核。后一种问题更隐蔽,出处是真的,原文说的却是另一回事,只查第一层会全部放过。
拒答在几家框架里的默认处理正好相反。TruLens 的 Groundedness 对所有「我不知道」都给满分,一个对什么问题都回答不知道的 agent 也能拿高分。RAGAS 的 FactualCorrectness 则相反,知识库里确实没有答案、agent 正确拒答时,它照样打 0 分。
两种默认处理错在同一个地方:拒答对不对,不取决于回答本身,取决于这道题能不能答。退款那道题知识库里有新版政策,agent 回一句「不清楚,请咨询人工客服」,就是过度拒答;换成「年度会员能不能转给家人用」,知识库里没写,agent 编一个答案才是最糟的结果,说「不清楚」反而是对的。
所以测试集里每道题要先标知识库里有没有答案,回答也分「作答」和「拒答」,交叉成一张拒答交叉表:
报表上至少出三个数:可答题的正确率、可答题的过度拒答率、不可答题的正确拒答率。单看一个数会把调优带偏:只看正确率,团队会把 agent 调得对拿不准的题也硬答;只看忠实度或幻觉率,又会把它调成什么都说不知道。
落到实现上,先判断一条回答是不是拒答,关键词规则加一次 LLM 判断就够;再按题目的标签查这张表。框架给拒答的默认分不要直接用。
还有两类题落不进这张表。它们的答案知识库里有,但不能照常作答,也不该用一句「不知道」打发:
前提有误 —— 比如「年度会员 7 天退款怎么申请」,问题本身带着错误前提,理想回答是先纠正:现行政策是 30 天内按剩余天数退信息不全 —— 比如「我的会员能退吗」,没说买了多久,理想回答是给出条件规则,或者追问购买时间,而不是猜一个具体结论这两类单独标成「需纠正或追问」,评分标准里写清理想行为,只回「不知道」不给满分。
拒答扣多少分,还要看答错的代价。同一个客服 agent 里,各类题的代价就不一样:
政策和金额类 —— 退款规则、扣费金额,答错会直接引发投诉和赔付。硬答的代价远高于拒答,拒答后转人工即可,发布门槛主要卡不可答题的正确拒答率操作指引类 —— 怎么开发票、怎么改绑手机,答错的代价低,拒答反而让用户卡在原地。发布门槛主要卡可答题的过度拒答率做法是按题型分组,每组单独定门槛,不要用一个总分把两类错平均掉。
不可答题必须专门建,因为检索会让模型更敢答。蚂蚁集团等 2026 年 8 月发布的 HopRefusalBench 发现,开了搜索之后,10 个被测模型里有 9 个的正确拒答率反而下降:检索回来一堆看起来相关的内容,模型就不再拒答了。
检索和生成两侧的指标都有了,交叉起来看。横轴用检索侧的陈述级召回;纵轴用上下文利用率(Context Utilization,RAGChecker 里的叫法),也就是被检索到的那些标准答案陈述里,有多少写进了回答。
| | |
|---|
| 检索没给够,生成已经尽力:预算投到检索,先查语料里有没有 | |
| 先修检索。召回低时利用率只在很少几条陈述上算,这个数不可靠,召回修上来再重测 | 召回了不会用:改 prompt、调上下文组装顺序、换生成模型,加检索没有用 |
退款案例放进来:新版政策进了 top-5、旧版没进(召回高),回答还是 7 天(利用率低),落在右下格,该修生成;新版排第 6 被截掉,落在左列,该修检索。新旧两版同时进了上下文的情况,召回和利用率都可能正常,要到第七节的数据层去查。
错误落在哪一格,比例因场景差很多。一项针对领域私有文档的研究里,分块和检索的问题合计约占六成,凭空编造只占全部错误的约 4%;在医学问答这类通用知识上,最常见的失败反而是证据检索到了,被模型自己的已有知识覆盖掉。
决定分布的关键变量,是知识库的内容和模型的参数知识重不重合。企业私有文档模型没见过,问题集中在分块和检索,与其先防模型编造,不如先查证据有没有被找全。通用知识模型本来就会,它更容易拿自己的知识覆盖检索结果,退款案例里的「7 天无理由退货」就是这一种。
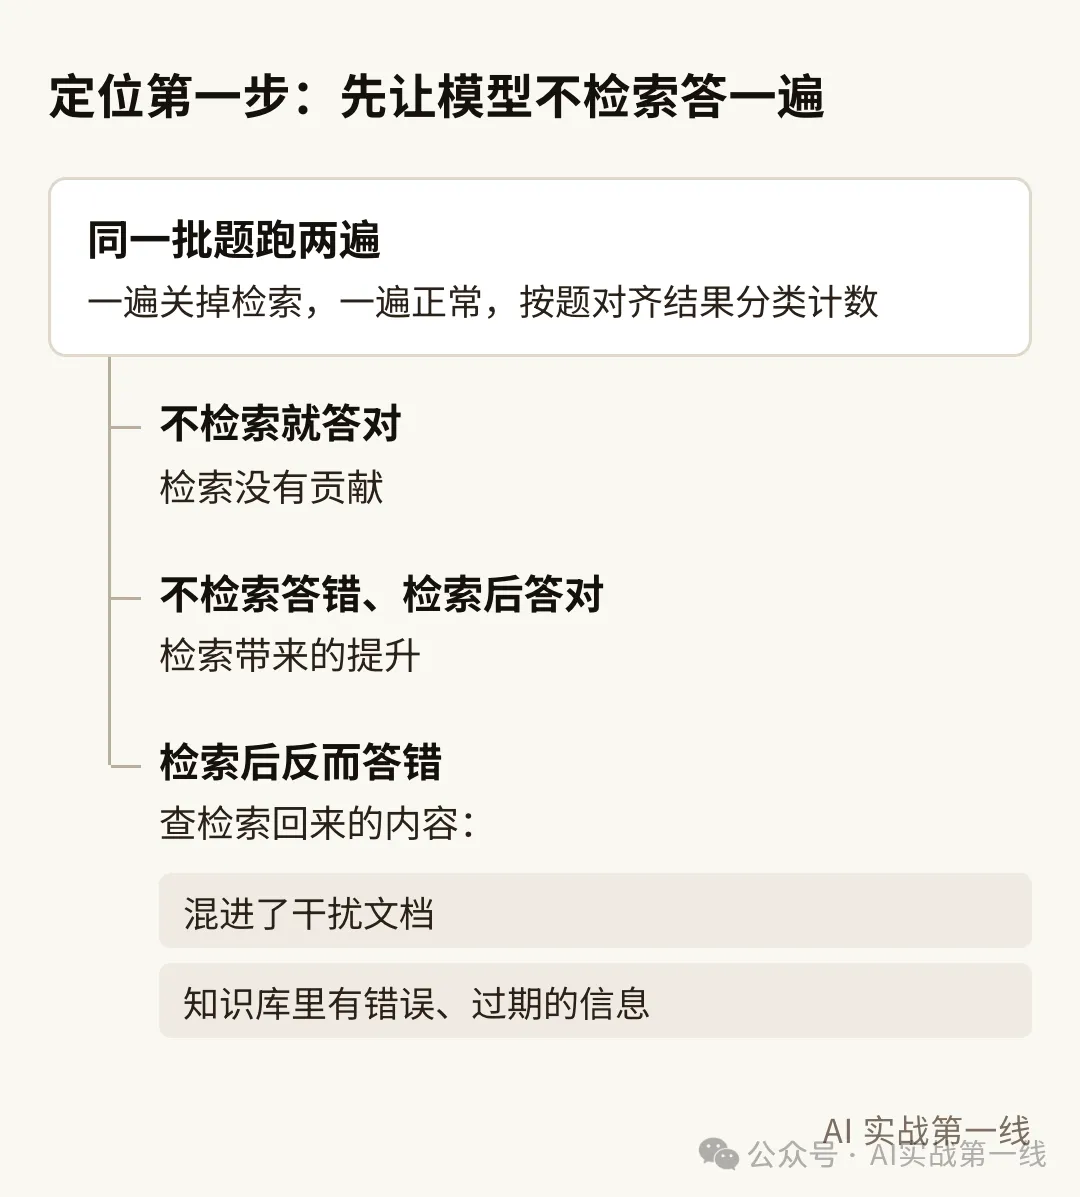
这个基线做起来很简单:同一批题跑两遍,一遍关掉检索,一遍正常,按题对齐结果分类计数。它还能顺带发现一个隐患:端到端分数很健康,大部分题却是模型靠自己知识答对的。这时候检索其实没起作用,换一个领域或者换一个模型,分数就会掉下来。
不检索基线的结果怎么读,先要分清 RAG 在这个场景里是主要依据还是补充。
强依赖场景 —— 客服、政策、价格、合同条款,答案必须以知识库为准,每句话都要有依据。模型不检索也答对了不算数:它今天碰巧答对,政策一改就会错。这类场景把忠实度和引用当门槛,不检索基线的正确率越高越要警惕,说明模型在靠自己的记忆答补充场景 —— 比如问一个成语用在什么场合,绝大部分模型自己就会,知识库只补少量冷僻条目和容易用错的地方。这类场景正确性是主指标,模型用自己的知识答对就算对;检索只看它补上的那部分:不检索答错、检索后答对的题有多少,检索后反而答错的又有多少场景不分,指标就会选错:拿补充场景的标准评客服,会放过碰巧答对的回答;拿强依赖场景的标准评成语问答,会把模型本来答得好的题判成没有依据。
前面所有指标都默认知识库是对的。退款案例里,如果新旧两版政策同时在知识库里,召回率、排序、忠实度可能全部合格,答案照样是错的。
模型对检索回来的内容几乎照单全收。2026 年 9 月一项研究里,一份过期文档就推翻了 GPT-5.5 原本答对的 83 道医学题中的 74 道。模型分不出新旧,文档写什么它就答什么。
所以用干净的知识库测,测不出系统在脏数据下的表现,而真实的知识库几乎不可能是干净的。
检索相关性在这一层也帮不上忙。Arize Phoenix 的检索相关性评估器在判据里专门写明:相关不等于正确,只判断信息和问题的主题有没有关系,不判断它是否准确、是否最新。旧版退款政策和用户的问题高度相关,相关性满分。检索相关性高、答案却错了,问题多半出在数据层,不在检索层。
数据层要单独建测试,做法并不复杂:
冲突样本 —— 挑 20 道政策类的可答题,把对应文档复制一份,改掉关键数字,生效日期往前调,和原文档一起放进测试用的知识库。看答案跟新版走还是跟旧版走,跟旧版的比例就是这一层的核心指标时效元数据 —— 每份文档带生效日期和失效标记,检索时过滤掉已失效的,多个版本同时命中时优先新版。测试时专门查两件事:失效文档有没有被召回,召回了有没有被过滤掉文档变更回归 —— 政策一改,把受影响的题挑出来重跑。退款政策从 7 天改成 30 天那天,就该有一批题自动重跑,确认旧版已经检索不到、回答已经换成新口径八、agent 链路:检索变成 agent 自己做的决策
传统 RAG 里,检索是固定的一步:每个问题检索一次,取 top-k。到了 agent 里,检索变成一个工具,查不查、查几次、用什么词查、查完信不信,都由 agent 自己决定。退款案例里最隐蔽的那种根因就在这一层:agent 判断这是常识问题,没调检索,直接按「7 天无理由退货」答了。
前面几节的指标都只能评单次 top-k,评不了 agent 的检索决策。agent 层要多评三样:
检索决策 —— 该查的时候查了没有,不该查的时候有没有乱查。退款这类政策问题,答案随时会变,就该设成必须检索,不能交给 agent 凭常识判断。Anthropic 2026 年 1 月的 agent 评测指南也专门提到,要防止模型在不该搜索的时候去搜轨迹 —— 查询词、调用次数、调用顺序。要注意轨迹指标的边界:Google Gemini Enterprise Agent Platform 的轨迹指标只比对调用了哪些工具、顺序对不对,不看检索回来的内容有没有用。调对了检索工具、取回一堆无关内容,轨迹分照样满分成本 —— 搜索次数、token、延迟要和准确率放在同一张表里。同样的准确率,每题搜 5 次和每题搜 200 次不是一回事,不报成本的准确率没有可比性agent 场景还多出一个问题:错误会传下去。agent 在某一步走偏之后,往往不会停下来,而是带着错误继续调十几次工具,出错的那一步和最终暴露错误的地方隔得很远。只看最终答案,定位不到那一步。
在 trace 上找出错的那一步,有两条路。
第一条,给每一步挂上对应的指标。DeepEval 让开发者把 trace 里的每一步标成检索、LLM、工具或 agent 类型,检索步挂检索指标,LLM 步挂忠实度;Phoenix 的检索相关性评估器不管来源是向量检索、工具调用、MCP 还是网页搜索,一律当检索步打分。这条路要求 trace 记得全,第九节会列出要记哪些字段。
第二条,让 LLM 读完整条 trace 做自动归因。这条路目前还不可靠,2026 年 4 月的 TraceElephant 基准里,把完整轨迹交给判官,找对出错步骤的准确率也只有 30.3%。判官常被下游的症状吸引,过早认定一个看起来合理的诊断,放过了真正的根因。自动归因现在适合用来缩小排查范围,最后的结论还得人去看 trace。
测试集从真实失败开始
测试题有三个来源,比重不一样:
线上真实问题 —— 从日志和用户投诉里取,是测试集的主体。Anthropic 的评测指南建议从真实失败里取 20-50 个任务起步,用户投诉过的那条退款错答,就该是测试集里的第一条人工构造的边界题 —— 不可答题、冲突题、跨文档题,线上日志里数量少,也没人标过,要专门写自动合成题 —— 只做补充。合成题的答案都出自某个块,天然没有「知识库里没有答案」的题,RAGAS 目前的三种出题器里也没有无答案类,这部分只能人工补每道题至少标这几个字段:
| | |
|---|
| | |
| | |
| 30 天内可退,按剩余天数计算;超过 30 天不退 | |
| | |
| | |
| | |
题建好后先查泄漏。公开多跳基准里有大量题不给文档模型也能答对,拿它们评自己的 RAG,测的很大一部分是模型本身的知识。测试题要建在自己的私有语料上,再跑一遍第六节的不检索基线,把不检索也能答对的题剔出去或者单列。
trace 一定要记最终喂给模型的上下文
trace 记不全,前面的指标大半算不出来。每一步至少记这些:
最常见的缺口在第四行。很多系统只记了检索结果,没记截断之后真正进了 prompt 的内容。退款那道题要判断「新版在不在上下文里」,看的必须是这一份,检索结果里有不代表模型看到了。
评测节奏:便宜的每次跑,贵的抽样跑
每次改动 —— 证据映射到块之后算的召回率、MRR、nDCG,不调 LLM,几分钟跑完。掉了就不合并,和单元测试一个待遇每个版本 —— LLM 打分的忠实度、正确性、拒答交叉表,在全量测试集或分层抽样上跑,和上一版逐题对比。逐题对比是为了挑出分数变了的题交给人工看,不是让判官逐题下结论每周 —— 人工复核 30 条左右,一半挑判官打分和上周变化大的,一半随机,用来校准判官线上 —— 采样真实请求,跑不需要标准答案的忠实度和相关性;差评、投诉、转人工的会话,定期回流成新的测试题判官看排名可信,看单条要靠人工锚点
LLM 判官在这套流程里用得最多,也最需要被检查:
适合比版本,不适合判单条 —— TREC 2025 RAG 评测(美国国家标准与技术研究院主办的信息检索评测)里,自动相关性标注在单条上和人工的一致率很低,汇总到系统排名层面,却和人工排出的顺序高度一致归因时偏向归咎于生成 —— 一项研究里的 LLM 归因器判断「错在检索还是生成」,和人工只有 57.8% 一致,而且系统性地偏向说是生成的错。判官的偏差恰好把团队往换模型、改 prompt 的方向带,所以归因结论要用 trace 复核用少量人工标注校正 —— 每周那 30 条人工复核,顺便用来估判官的系统偏差:判官平均比人工打高还是打低、高多少,从自动分数里扣掉。几十条人工标注就够用,不需要全量人工判官版本锁定 —— 判官本身是 API 背后的模型,版本悄悄一升级,打分口径就变了。判官的模型版本和 prompt 要像代码一样打版本号;再固定一批人工标注过的锚点样本,定期让判官重打一遍,分数漂了先查判官,再查产品 | | |
|---|
| Hit Rate@k、Recall@k、Precision@k | 要标证据位置,按原文片段标,不按 chunk ID 标;不调 LLM、可复现,最先建 |
| | 标注同上,nDCG 可用分级标注;rerank 前后在同一个 k 下比;RAGAS Context Precision 只看排序,不看召回 |
| Context Recall、Claim Recall | 要标准答案,由 LLM 拆陈述;专门查「块召回满分、答案仍错」的题 |
| | 正确性要标准答案;三家忠实度判据不同,不跨框架比;引用查出处和内容两层 |
| | 每题标答案类型和题型;不用框架给拒答的默认分;按题型的错误代价分组定门槛 |
| | 要陈述级标注;先跑不检索基线,分清模型自身知识的贡献;强依赖场景和补充场景分开读 |
| | 要人工构造冲突和过期样本;文档带生效日期,政策变更触发回归 |
| | 要完整 trace;每步挂对应指标;轨迹指标不看内容;自动归因只用来缩小范围 |
| | 要 30-100 条人工锚点;判官看排名可信、看单条不可信;判官版本锁定 |
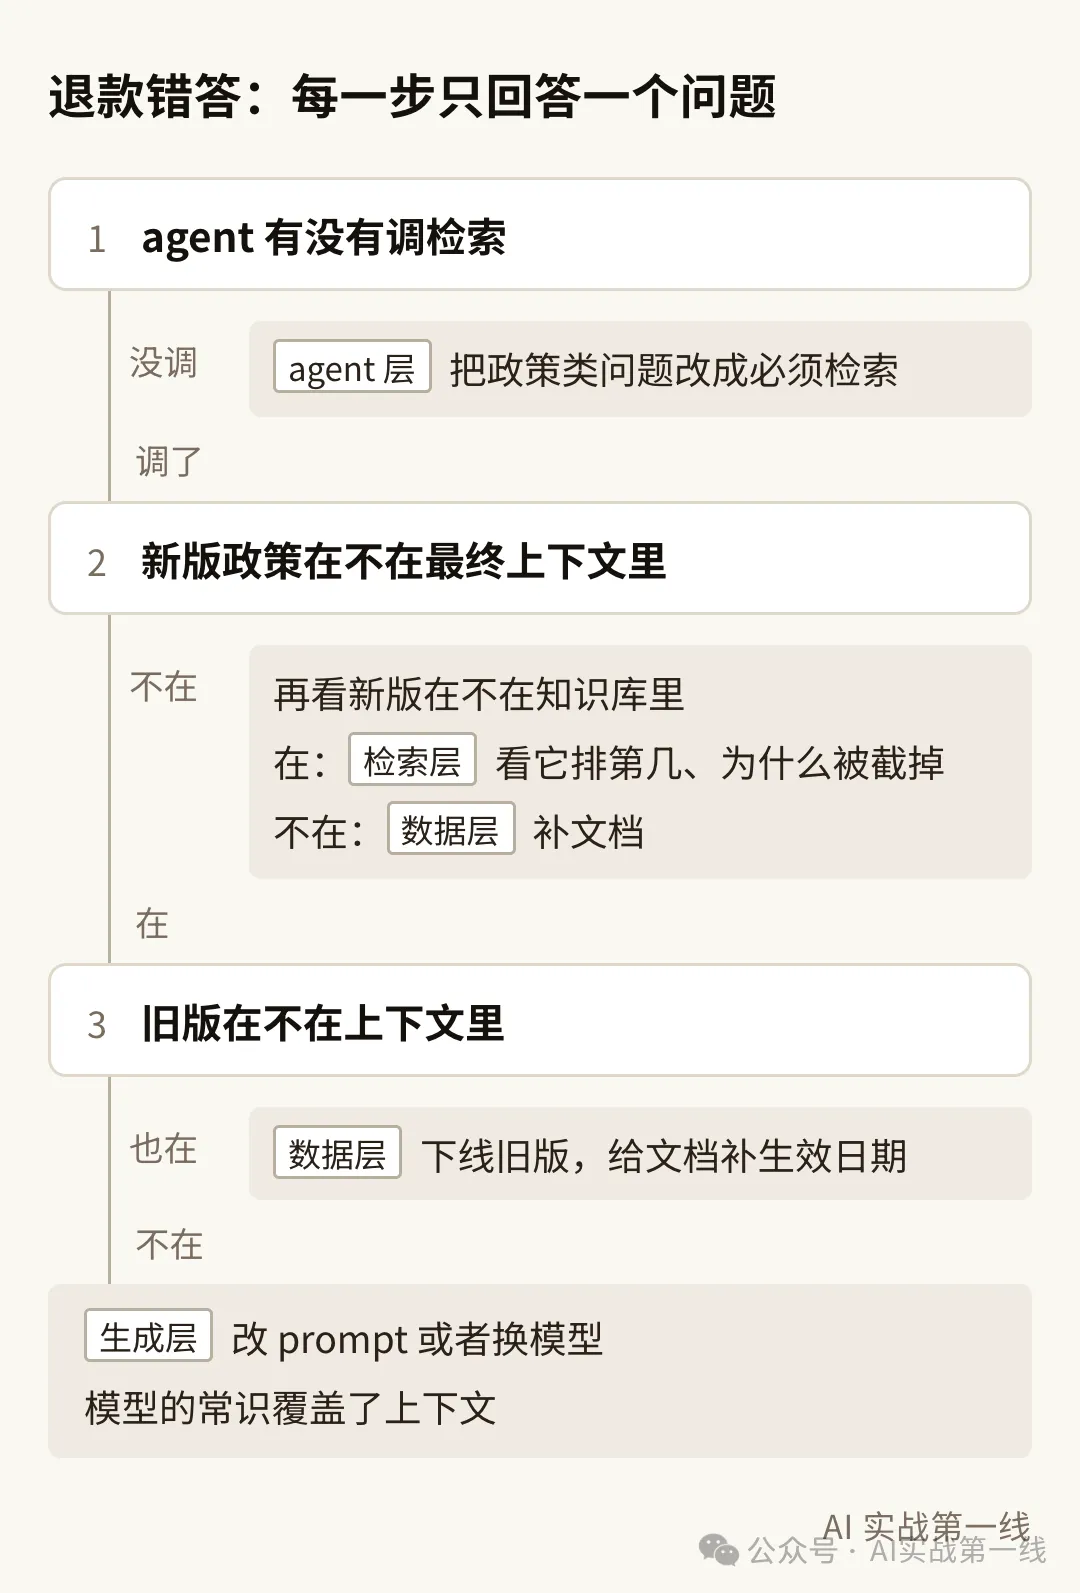
按这篇的顺序,那条「7 天全额退款」可以这样一层层查:
政策类问题之所以必须检索,原因在第一步:不给检索让模型直接答一遍,它多半也答「7 天」,这条常识就在它脑子里,所以这类问题更不能交给 agent 自己决定查不查。
端到端分数负责报警,告诉你系统变差了;分层指标负责定位,告诉你该修哪一环。知识库本身也是要被评测的一个组件,它出错的时候,下游所有指标都可能显示正常。
如果你手上有一个 RAG 系统或者带检索的 agent,可以从最简单的三件事开始:从真实问题里挑 50 道,标上证据所在的原文片段,跑出第一版召回率;再手写十来道知识库里没有答案的题,看 agent 是拒答还是硬答;最后让模型不检索把这 50 道答一遍,看看有多少题其实根本没用上检索。