以大模型 Agent 客服为场景,从维度定义到回归闭环的完整产品方案
一、方法论:评测集如何设计
1.1 问题定义:为什么 AI 产品必须有评测集
传统软件 QA 有明确预期——输入 A 必须输出 B。但大模型产品的输出是概率性的:同一输入多次调用结果不同,模型/prompt/知识库任一变更都可能引起不可预期的能力退化。
没有评测集,AI 产品团队会陷入三个致命困境:
- 改不动:改一版 prompt,不知道是进步还是退步——"感觉变好了"不算数。
- 说不清:老板问"效果到底怎么样",只能拿几个 cherry-picked 截图交差。
- 追不回:线上出了幻觉事故,回溯发现三天前某次更新已经引入回归,但没有基线对比就无法定位。
评测集的本质 = 把"感觉"变成"可重复、可对比、可追踪"的量化基线。
1.2 评测体系全景架构(产品视角)
一套完整的 AI 产品评测体系由五层组成,自上而下:
| | | |
|---|
| L1 · 指标定义层 | | | |
| L2 · 用例构建层 | | | |
| L3 · 评分引擎层 | | | |
| L4 · 执行管线层 | | | |
| L5 · 闭环反馈层 | | | |
本方案聚焦 L1-L3(产品核心职责),L4-L5 给出工程交付要求。
2.1 评测维度设计(L1 指标定义层)
维度设计遵循"业务后果倒推"原则——先问"这个 AI 产品出了什么错会造成多大损失",再决定"评什么"。
以 Agent 商家客服为例,六大核心维度:
| | | | |
|---|
| 任务完成率 | | 未完成 = 转人工/流失/投诉。直接影响人工成本和商家满意度 | | |
| 事实准确性 | 回复中的具体事实(价格/时效/政策)是否与知识库一致 | | LLM-as-Judge + 关键实体 spot check | |
| 安全合规 | | 一次数据泄露 = 品牌危机 + 法律风险(一票否决) | | |
| 工具调用正确性 | Agent 是否在正确的时机调用正确的工具、参数是否正确 | 错误调用 = 执行了不该执行的操作(退款/改地址),不可逆 | | |
| 对话流畅度 | | | 人工 Likert 5 分量表 + LLM 评分辅助 | |
| 兜底合理性 | 超出能力边界时是否正确转人工/给出合理引导而非硬答 | 硬答 = 产生幻觉;过度转人工 = 浪费自动化价值 | | |
2.2 维度设计的关键原则
- 互斥且穷尽(MECE):维度之间不重叠,组合后覆盖全部业务风险面。"准确性"和"合规性"要分开——一条回复可以事实准确但违规承诺。
- 可判定:每个维度必须有明确的评分标准,避免"好/不好"的模糊判断。用"是否包含字段 X""调用工具 Y 的参数 Z 正确"替代主观评价。
- 可追踪:维度分数必须支持按时间/版本/场景切片,才能发现回归和定位原因。
- 业务锚定:及格线来自业务 SLA,不来自"技术上能不能做到"。
2.3 用例构建策略(L2 用例构建层)
用例质量决定评测上限。一套好的用例需要回答:"从哪来、有多少、怎么分布、如何维护"。
来源(五源汇聚)
| | | |
|---|
| 线上真实对话回流 | | | |
| 业务场景枚举 | | | |
| 对抗性构造 | | | |
| 历史事故复现 | | 确保已修复问题不回归(regression cases) | |
| 新版本 feature 定向 | | | |
分布控制(三层分层抽样)
- 意图层:按业务意图分类(查物流/退款/改地址/投诉/咨询...),每个意图至少 N N条,权重按线上真实流量占比。
- 难度层:简单(单轮直答)/ 中等(多轮追问)/ 困难(模糊意图+冲突上下文+边界操作),比例建议 40/40/20。
- 上下文层:单轮 / 3轮 / 8轮+长对话,覆盖上下文窗口压力场景。
规模计算(够用即可,不贪多)
最低门槛公式:每个维度 × 每个意图类别 ≥ 30 条(满足统计检验基本功效),总体建议 500-2000 条为核心集,配合全量冒烟集(100-200 条,每次 prompt 变更即跑)。
维护机制
- 自动回流:线上新增高频意图/差评自动进候选池,产品周会审核入集。
- 季度淘汰:连续 3 个版本 100% 通过的用例降级为冒烟集;业务规则变化的用例标记失效、重新标注。
- 版本锁定:每个大版本发版时冻结评测集快照(v2.2 用 eval_set_20260915,v2.3 用 eval_set_20261015),保证纵向可比。
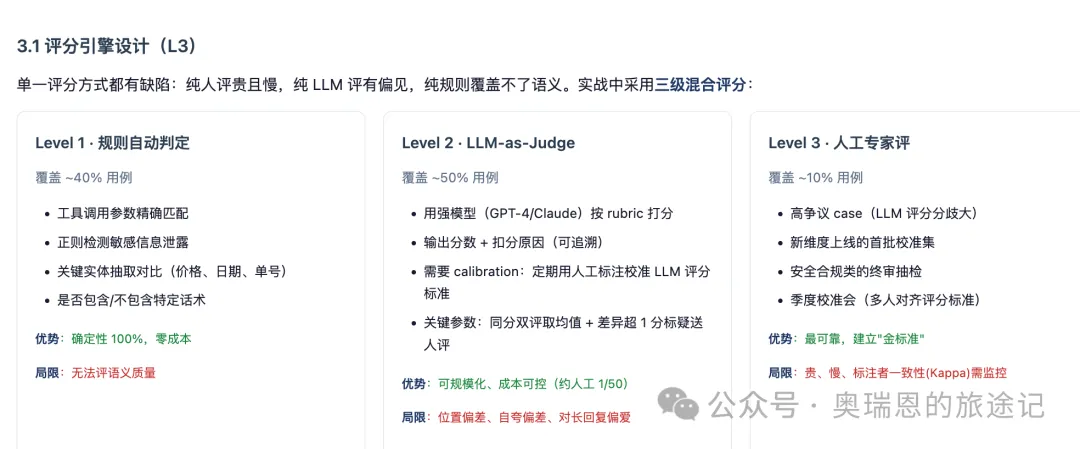
3.1 评分引擎设计(L3)
单一评分方式都有缺陷:纯人评贵且慢,纯 LLM 评有偏见,纯规则覆盖不了语义。实战中采用三级混合评分:
Level 1 · 规则自动判定
覆盖 ~40% 用例
优势:确定性 100%,零成本
局限:无法评语义质量
Level 2 · LLM-as-Judge
覆盖 ~50% 用例
- 用强模型(GPT-4/Claude)按 rubric 打分
- 需要 calibration:定期用人工标注校准 LLM 评分标准
- 关键参数:同分双评取均值 + 差异超 1 分标疑送人评
优势:可规模化、成本可控(约人工 1/50)
局限:位置偏差、自夸偏差、对长回复偏爱
Level 3 · 人工专家评
覆盖 ~10% 用例
优势:最可靠,建立"金标准"
局限:贵、慢、标注者一致性(Kappa)需监控
3.2 LLM-as-Judge 的实操设计(重点)
这是当前 AI 产品团队最高性价比的评分手段,但有四个必须解决的工程问题:
| | |
|---|
评分标准漂移
| 写结构化 Rubric——每个分数档给出明确定义 + 3 个 few-shot 示例(好/中/差各一) | 设计 Rubric 并持续校准。这是 AI PM 最核心的可交付物之一【Rubric/对照表】 |
位置偏差
| | 验收 LLM Judge 时必测"同内容换位置是否同分" |
自夸偏差
| 用异构模型(如 Claude 评 GPT、GPT 评通义)做交叉验证 | |
成本失控
全量跑 LLM Judge 的 token 费用高 | 分层抽样:规则先筛确定性的 40%,剩余 60% 全走 LLM Judge;月度成本约 = 用例数 × 60% × 平均 input tokens × 单价 | 在方案中写清预算与 ROI(1 次人工评测 ≈ XX 元 vs. LLM ≈ XX 元) |
3.3 Rubric 示例(Agent 客服 · 任务完成率维度)
【维度】任务完成率
【定义】用户提出的主要诉求是否在对话结束时被实质性解决(而非敷衍/答非所问/遗漏关键步骤)。
【评分标准】
5 分 · 完美解决:正确识别意图 → 调用正确工具 → 给出完整信息 → 用户无追问
4 分 · 基本解决:核心问题回答了,但有 1 个次要信息点遗漏,用户可能需要追问一次
3 分 · 部分解决:只解决了表层问题,未处理深层需求(如用户问"物流到哪了"实际要改地址,AI 只给了物流)
2 分 · 未解决:答案方向错误,用户需重新描述或转人工
1 分 · 有害:给出了错误操作指引(如引导用户做违规操作)
【Few-shot 示例】
Case: 用户说"我的快递三天没动了帮我催一下"
5 分回复:识别"物流异常+催件"意图 → 调用 queryLogistics 工具查状态 → 调用 urgeShipment 工具发起催件 → 告知"已催促,预计24H内更新" ✓
3 分回复:查了物流状态并告知"还在运输中",但未执行催件操作(遗漏用户显式动作请求)✗
4.1 执行管线设计(L4)
评测不应是一次性项目,而应嵌入产品迭代的持续交付管线:
| | | |
|---|
| Prompt 微调 | | | |
| 模型版本切换 | | | |
| 知识库更新 | | | |
| 新功能上线 | | | |
| 周度巡检 | | | |
4.2 工程交付要求(产品向研发提的接口规范)
作为产品经理,不需要自己写管线,但需要定义接口与约束:
- 输入格式:每条用例 JSON 包含
case_id, input(messages), expected_behavior(评分锚点), dimensions[], tags[], difficulty - 输出格式:系统返回
actual_output, tool_calls[], scores{dimension: score}, latency_ms, token_cost - 可重放:相同输入 + 相同 model/prompt/config → 必须产生相同评测分数(通过固定 seed / 缓存 LLM Judge 结果实现)
- 可追溯:报告中每条 case 的扣分必须可展开看到"评了什么、依据是什么、谁/什么模型给的"
- 门禁机制:CI 流水线中,总分低于阈值或安全维度出现 1 条 fail → 阻断发布
4.3 闭环反馈设计(L5)
评完不是终点。评测结果必须流回产品和研发,形成 PDCA:
| | |
|---|
| | Review 维度趋势,讨论 Top 失分 case 归类 |
| | 按"模型能力不足 / prompt缺陷 / 知识库缺失 / 工具设计缺陷"聚类 |
| | |
| | |
| | 人工标注与 LLM Judge 对齐度 review,调整评分标准 |
北极星指标设计:不只看"评测分数",而是追踪评测通过率 → 线上事故率的相关性。如果评测全绿但线上事故不降,说明评测体系本身需要升级。
5.1 落地分阶段路线
不建议一上来就做"大而全"——从最小可用闭环起步,逐步加厚:
| | | |
|---|
| MVP · 冷启动 | | | 200 条人工构造用例 + 纯规则打分 + 手动执行 + Excel 报告 |
| V1 · 半自动化 | | | 500 条用例 + 规则+LLM 双引擎 + 脚本触发 + JSON 报告 |
| V2 · 集成化 | | | 1000+ 用例 + 三级评分 + 自动触发 + Web 看板 + 告警 |
| V3 · 智能化 | | | 2000+ 用例 + 自适应抽样 + 回归检测模型 + 归因聚类 |
5.2 角色分工(AI 产品经理在评测体系中的定位)
产品经理(你)的 ownership:
- 评测结果驱动的产品决策(这个 prompt 到底改不改)
需要协作的角色:
- 算法/工程:实现执行管线、LLM Judge 集成
- 运营/客服:提供线上真实对话样本、反馈 badcase
5.3 常见陷阱与应对
| | |
|---|
| | 每月对比评测集 vs. 线上真实意图分布,偏移 >15% 触发再采样 |
| | 固定 Judge prompt + 温度=0 + 金标准集(人工标注锚点 case)校验 |
| | 用例中必须含 30%+ 多轮 case,评完整 session 而非单条回复 |
| | 安全维度独立门禁,不被加权平均——1 条 fail 即阻断 |
| | 连续 3 版满分 → 降级为冒烟;引入 10% "过期挑战"(随机重跑老 case 检测隐性退化) |
6.1 方案核心总结
一句话:AI 产品评测集 = 把"老板问效果怎么样"从尴尬变从容的系统工程。
产品 PM 的三个不可替代价值:
- 定义"什么算好"(维度 + Rubric)——算法和工程无法自己决定
- 控制"评什么"(用例分布与优先级)——保证评测对齐业务
- 决定"评完怎么干"(门禁标准与迭代方向)——把分数翻译为行动
"商家客服 Agent 项目中主导搭建了完整评测体系——从 6 维度定义(任务完成率/事实准确/安全合规/工具调用/流畅度/兜底)到 800+ 条分层用例,落地了规则+LLM Judge+人工三级评分引擎,接入 CI 作为发版门禁。核心成果:将幻觉率从 6.2% 降至 3.5%、线上事故定位时间从 2 天缩短到 4 小时。"Rubric 音标:/ˈruːbrɪk/(读作"入-布瑞克",重音在前)
字源:来自拉丁语 rubrica(红赭石)。古罗马人写法律文件时,用红笔把每一条的"标题"标出来——这个红色标题就叫 rubrica。
现在的含义:一整套明确的评分对照标准。
类比:
- 没有 Rubric → 老师改卷凭感觉("嗯,还行吧,给个 82")
- 有 Rubric → 老师改卷翻对照表("论点清晰+3分,举例恰当+2分,错别字扣1分")
在 AI 行业里,Rubric = 你写给评审模型(或人)看的打分说明书,让它知道"5 分长什么样、3 分长什么样",这样每次打分才稳定、可复现。