QUOTE
10 月 6 日建仓,10 月 25 日 19,612 星、1,933 个 fork,过去七天净增约 1.7 万星。google-research/harness2 是这一周 GitHub 上跑得最快的 AI 项目之一。
它做的事有点反常识:模型权重一行不动,只改模型外面那八份文件——系统提示、护栏、记忆、工具说明、子 Agent、技能、脚本、插件。
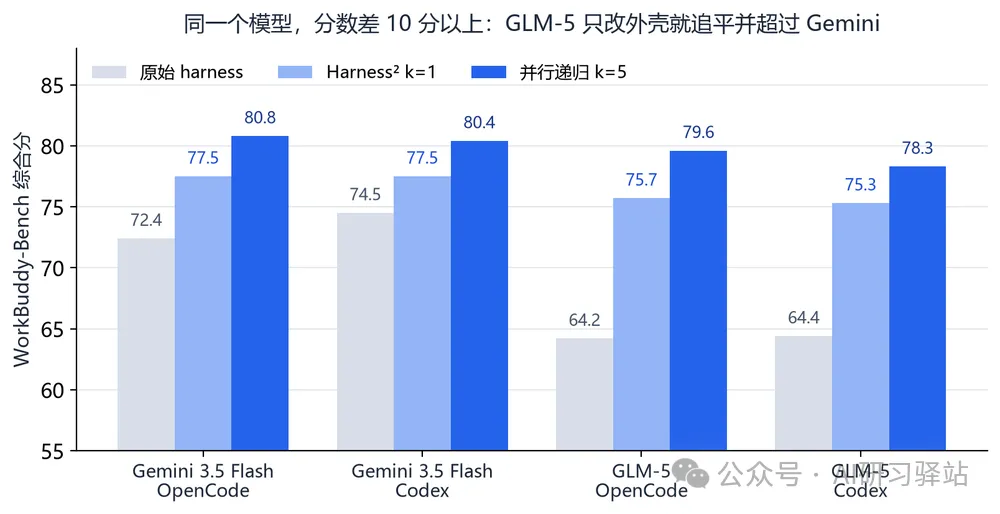
效果很直接:GLM-5 从 64.2 分涨到 75.7 分,把原始配置下的 Gemini 3.5 Flash(72.4)挤到后面。但同一套方法用在 Gemini 3.5 Flash 自己身上,只涨 3.0 分。
—— AI研习驿站
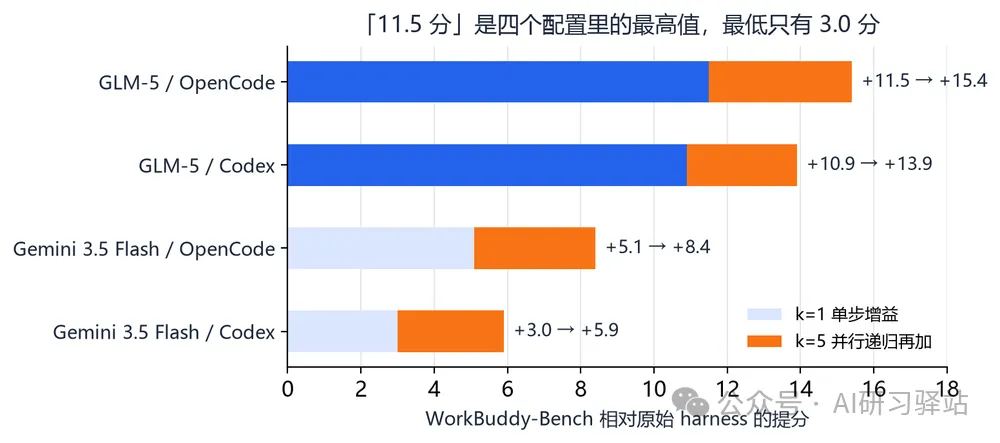
11.5 分和 3.0 分之间那 8.5 分的差距,才是这篇文章要说的事。论文摘要里写的是「最高 11.5 分」,这个数字来自四个模型与 harness 组合里的一个;另外三个分别是 10.9、5.1、3.0。同一套方法,在不同底座上的回报差了三倍多。
这不是挑刺。一个方法在什么条件下有效、在什么条件下形同虚设,比它最好能涨多少分有用得多。下面把论文的六张表、两个案例、以及仓库里那份 README 的警告一起拆开看。
01
EIGHT FILES
模型是发动机,harness 是方向盘和仪表盘
同一个模型,工具说明写得含糊、上下文塞得太满、脚本没有校验、失败之后没人让它回头看一眼,跑出来的东西能差一大截。这些不属于模型能力的部分,行业里统称 harness。
论文给的案例特别能说明问题。同一道 JobBench 任务,原始 harness 的失败原因是两条:财务数字跨文件对不上;写完文档不重新打开检查。这不是模型不会算,是没人告诉它「先核对输入、再动笔、最后自己跑一遍校验脚本」。
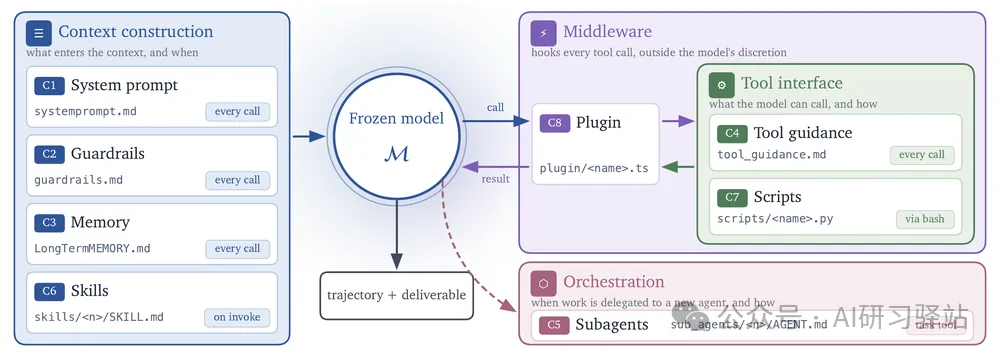
Harness² 把这层东西切成了八个可改的单元,每个单元对应仓库里一个真实文件:系统提示是 systemprompt.md,护栏是 guardrails.md,长期记忆是 LongTermMEMORY.md,工具说明是 tool_guidance.md,脚本在 scripts/ 下,技能在 skills/ 下,子 Agent 在 sub_agents/ 下,插件是 plugin/ 里的 TypeScript。
图 1:八个可编辑组件,按「什么时候进入上下文」分成四组。左边三组每次调用都进上下文,脚本通过 bash 调用,子 Agent 走工具调用。来源:google-research/harness2 仓库 README(Apache-2.0)。
为什么绕开权重?论文的理由很实在:闭源模型改不了,微调要算力要标注,训完还可能把原来的本事忘掉。改 harness 不碰参数,上限低,但门槛也低——一个下午能改完,改坏了 git 回滚。
02
NO ANSWER KEY
没有标准答案,它靠「两次跑得不一样」来判断改得对不对
自动改 harness 的老问题是判断依据从哪来。有测试集的场景好办,跑一遍看分数。可真实工作里,一份法务备忘录、一张对账表,没有参考答案可以 diff。
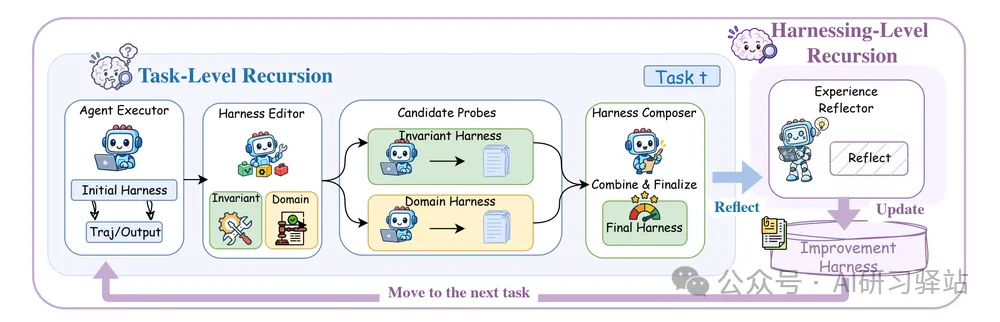
Harness² 的解法叫 Propose–Probe–Compose,三步一循环。先用原始 harness 跑一遍,留下完整轨迹和产出;编辑器模型看着轨迹提两版改法,一版针对通用的毛病(计划太粗、工具乱用),一版针对这道题的领域知识;两版各跑一次,composer 对比两次行为的差异,把有证据支撑的改动合进最终 harness。
图 2:一次任务级的循环。右上是第二层「经验反射」:每次改完把采用的 harness 和有证据的教训写进改进库,供下一个任务取用。来源:google-research/harness2 仓库 README。
关键在「对比」而不是「打分」。它不问这次比上次高几分,问两次执行哪里不一样、哪处差异像是这次改动造成的。好处是不需要评分器,代价也很清楚:两次跑可能犯同一个错,还互相印证成「没问题」。行为差异是真的,和正确性有关是另一回事。
第二层递归管的是积累。每个任务结束后,采用的 harness 和教训进改进库,新任务仍然从公共的基础 harness 出发,不会把历史上所有改动一路背下去。这个设计挺克制,也解释了后面的一个坑:库里没东西的时候硬要精炼,分数会掉。
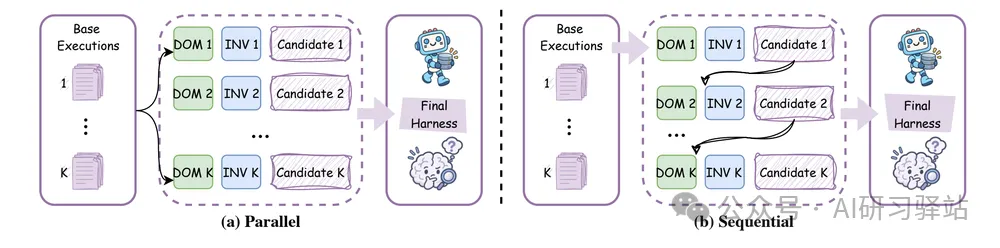
图 3:扩大递归预算的两种方式。并行是同时探 K 个通用候选和 K 个领域候选,再产出 K 份合成;顺序是把改进后的 harness 和证据带进下一轮,一轮比一轮深。来源:google-research/harness2 仓库 README。
03
RUN IT
装起来跑一题:依赖比想象中重,命令倒是干净
仓库是 Apache-2.0,纯 Python 主体,执行器默认 OpenCode,可以切 Codex。要跑带模型的基准,除了 Node.js 20+ 和 Google Cloud CLI,LAB 还需要 Pandoc 和 Poppler,WorkBuddy-Bench 需要 Docker。这套依赖对做 Agent 评测的团队不算重,对只想试一下的人不算轻。
# 装依赖 + 配置模型
uv pip install -e .
cp .env.example .env
gcloud auth application-default login
# 跑一道 LAB 题:先装基准,再跑、判分、出报告
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
以上命令取自仓库 README 的 Run a benchmark 一节。判分和出报告必须与精炼时用同一个 benchmark、执行器、子集、k、模式和随机种子,否则分数对不上。
两个参数决定一切。--k 是任务级递归预算,k=1 只做一轮提议-探测-合成;--mode 选并行还是顺序。加 --dry-run 可以只看任务选择不发模型请求,调参数时能省不少钱。
04
THE NUMBERS
四个配置逐一摊开:11.5 分的旁边,是 3.0 分
WorkBuddy-Bench 覆盖办公、网页、代码三个域,分数是三域宏平均,每格跑三次取均值。四组「模型 × 初始 harness」的下场是这样:
| | | |
| Gemini 3.5 Flash / OpenCode | | | |
| | | |
| | | |
| | | |
表 1:WorkBuddy-Bench 三域宏平均分,每格三次运行取均值。来源:论文 Table 1,arXiv 2610.14224。
图 4:四个配置的原始分、单步结果和 k=5 并行递归结果。GLM-5 的两根浅蓝柱子起点低、涨得最多,说明弱底座的可改空间更大。数据来源同表 1,本刊自绘。
把增益单独拎出来更清楚:GLM-5 配 OpenCode 是 +11.5,配 Codex 是 +10.9;Gemini 3.5 Flash 配 OpenCode 是 +5.1,配 Codex 只有 +3.0。同一套编辑流程、同一个编辑器模型,回报差出近四倍。
图 5:单步增益与 k=5 递归追加的增益。橙色段是并行递归在单步之上的额外收益,四个配置分别再加 2.9、3.3、3.0、3.9 分。数据来源:论文 Table 1,本刊自绘。
有个细节容易被忽略:GLM-5 单步涨到 75.7 之后,已经高于 Gemini 3.5 Flash 的原始分 72.4。论文自己也点出了这件事——弱模型经过一轮 harness 编辑,可以反超强模型的原厂配置。这句话听着提气,反过来说也成立:Gemini 3.5 Flash 的原始 harness 里,至少丢了 5 分。
05
OTHER BENCHMARKS
另外两个基准:一个天花板只有 36 分,一个只算「部分通过」
JobBench 考的是端到端职业任务,执行链很长。四个配置的原始分是 31.5、33.9、20.6、23.6,改完最好也只有 36.0。+4.5 分放在 31.5 的基数上是 14% 的相对提升,但绝对水平仍然不到四成——这个基准本身就把当前 Agent 的上限压得很低。
LAB 是哈维的法律任务基准,论文报的是 partial,也就是逐条标准的通过率,不是整份交付物通过。所以「+11.8 个百分点」听起来比 WorkBuddy 的 11.5 分更猛,量纲根本不是一回事。而且这 11.8 只出现在 GLM-5 配 OpenCode 这一格;Gemini 3.5 Flash 配 Codex 只涨 4.0。
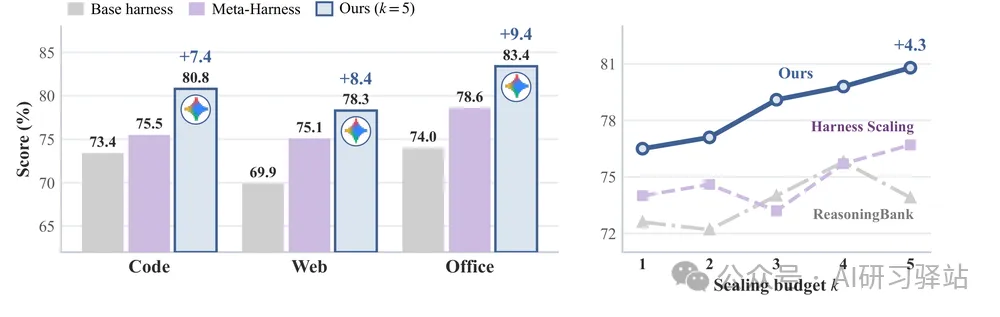
官方那张总览图更容易看错。它画的是 Gemini 3.5 Flash 单模型的三域分数,配上 k=5 的 +7.4、+8.4、+9.4 三个标注,视觉上很整齐。但那已经是递归到 k=5 的结果,不是单步;单步对应的是 +5.1。
图 6:论文 Figure 1。左图是 WorkBuddy-Bench 三个域上的对比,深蓝柱为 k=5 的 Harness²,柱顶标注是对原始 harness 的增益;右图是代码域随预算 k 从 1 到 5 的走势。来源:arXiv 2610.14224,Figure 1。
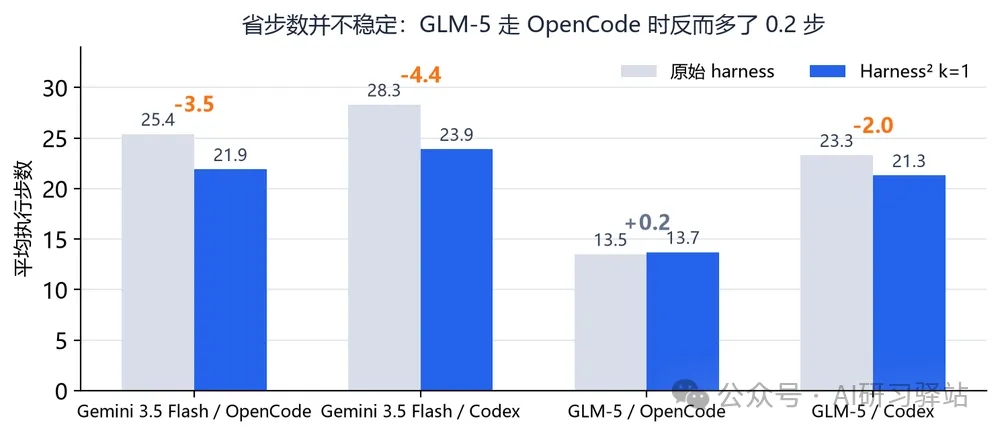
还有一个反直觉的地方:执行步数。多数配置下 Harness² 让 Agent 少走了几步,Gemini 3.5 Flash 配 OpenCode 从 25.4 降到 21.9;可 GLM-5 配 OpenCode 从 13.5 涨到 13.7。省步数不是这套方法的稳定副产物,它只是有时候顺手省了。
图 7:WorkBuddy-Bench 上的平均执行步数,橙色数字是差值。步数下降最多的是 Gemini 3.5 Flash 两条线,GLM-5 配 OpenCode 反而多了 0.2 步。数据来源:论文 Table 1,本刊自绘。
06
CASE STUDY
43.1 到 77.8:改的是一万一千字节的文本
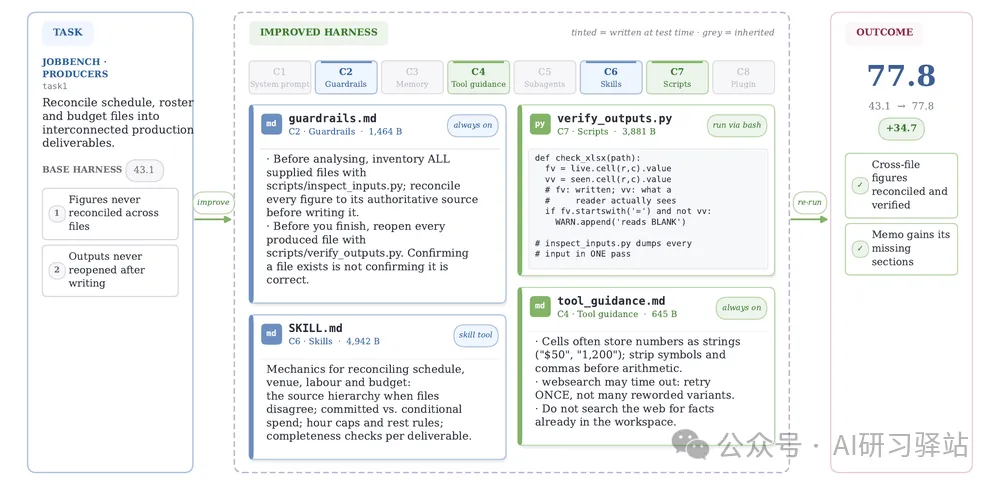
论文放了一道 JobBench 的完整案例,任务是把排班表、供应商名单和预算合成一套生产交付物。原始 harness 跑出 43.1 分,失败点写在图左侧:跨文件数字对不上,产出从不回头检查。
改完之后是 77.8 分,涨 34.7。改的东西摊开看并不玄:guardrails.md 加了「先扫一遍所有随附文件,再让每个数字回到它的来源处核对」;tool_guidance.md 加了「钱数先剥掉符号和逗号再算,网页搜不到就重试一次,不要换着关键词乱搜」;一份 4.9KB 的技能文件写清了冲突时的来源优先级;一个 3.9KB 的 Python 脚本负责逐格比对表格。
图 8:一次任务后的 harness 编辑结果。中间四份文件合计约 11KB,包括 1,464 字节的护栏、645 字节的工具说明、4,942 字节的技能文件和 3,881 字节的校验脚本。来源:harness2.github.io 项目主页案例图。
这张图的信息量比分数大。四份文件加起来一万一千字节左右,全是能 git diff、能 review、能复用的自然语言和几十行脚本。它解释了这套方法为什么在工程上可行:改动能被人读懂,也能被人否决。
但别把 34.7 当常态。这是论文挑出来的单任务案例,同一批 JobBench 任务的平均增益只有 4.5。案例值 34.7、均值 4.5,两个数字放一起才完整:方法在个别任务上能救回整条命,多数任务上只是小幅挪动。
消融:哪一块真的在起作用
在 Gemini 3.5 Flash 配 OpenCode 上逐块拆:去掉经验库,WorkBuddy 掉 3.1 分、JobBench 掉 1.8 分;去掉「通用 / 领域」的分工、换成两个同质的编辑器,JobBench 掉 3.7 分,是四项里最狠的;去掉合成步骤、让两个候选二选一,掉 1.6 和 1.9 分。三个部件都在出力,没有哪个是装饰。
07
THE BILL
账单、退化与三个默认关着的安全开关
先说钱。k=1 的一轮,等于一次基线跑、两次候选探测、一次合成,同一道题跑四遍。k=5 并行按 README 的口径是 5 个通用候选、5 个领域候选、5 份合成,加上基线,同一道题跑十六遍。
按 WorkBuddy-Bench 平均二十来步的执行长度折算,k=5 下一道题就是四百个模型回合。换来的增益是单步之上再加 2.9 到 3.9 分。这笔账划不划算,取决于这几分在你的业务里值多少钱——做一次性脚本的,肯定不划算。
再说退化。论文 Figure 7 左边那组数据是全文最值得看的:没有可用的经验库,直接对着基础 harness 反复精炼,代码域从 73.4 掉到 63.2,网页域从 69.9 掉到 65.0。少了「先有经验、再动手」这个前提,自我改进会变成自我伤害。
重复精炼也不等于更强。论文给的是 k 从 1 到 5 单调上升,但消融里 Harness Scaling 这个基线在 k 从 2 加到 3 时两个域都退了,ReasoningBank 在代码任务上最多比原始 harness 低 6.6 分。堆轮次这条路上,翻车的样本一直都有。
README 里那三条警告
执行器的网络访问默认不限制,Codex 跑的时候沙箱是关的,公开基准的评分标准在网上可能被爬到。三条叠在一起,意味着默认配置下跑出来的分数有可能是「刷」出来的,不是「做」出来的。仓库建议评测前自行配置网络限制。
再加上一行小字:这不是 Google 官方支持的产品,也不在 Google 开源漏洞奖励计划的范围内。拿它做生产工具,出了事没人兜底。
还有个绕不开的问题:这些数字全是作者团队自己跑的。Meta-Harness 那组对比也是他们跑对手、不是对手跑自己。同一张表里,GLM-5 配 Codex 的代码域,Meta-Harness 拿到 76.8,Harness² 是 74.9——单格看,对手并不总是输。整体均值 Harness² 领先,但「全面占优」这个说法不成立。
编辑器模型的选择也会改变结论。论文试了让同一个模型既当执行者又当编辑器,五个模型在三个基准上都涨,Claude Opus 5 是 +3.3、+5.5、+3.0,GLM-5 在 LAB 上单格 +13.7。不依赖更强的编辑器也能吃到收益,这是好消息;但不同编辑器带来的方差有多大,论文没有系统给。
08
VERDICT
它卖的不是免费提分,是把调参的人工换成 token
Harness² 真正解决的问题不是「让模型更聪明」,是「把改 harness 这件事从老师傅的手感,变成一条能重复执行的流水线」。八个组件是接口,提议-探测-合成是流程,经验库是缓存。工程味很重,宣传味很淡,这点很难得。
适合谁:已经有一套稳定评测集、任务重复度高、API 预算能撑住四到十六倍开销的团队。尤其是那些被闭源模型锁死、没法微调、又必须在特定流程上提分的场景。先把 k=1 跑通,量一遍自己任务上的真实增益,再决定要不要上 k=5。
不适合谁:一次性任务、对延迟敏感的线上服务、没有评分标准也不想建评分标准的团队。还有一类要小心——把它的输出直接当生产配置。自动改护栏、自动改工具说明,改错了就是权限和边界一起松掉,README 里那句「网络不限制」已经提醒过一次了。
回到开头那 8.5 分的差距。它说明的不是方法不稳定,而是 harness 的欠账不均:GLM-5 的原厂外壳欠得多,随便改改就涨十分;Gemini 3.5 Flash 的外壳已经比较讲究,能榨的只剩三分。判断一个模型值不值得上这套流程,先看它原来的外壳有多糙。
数据来源
分数与消融数据取自论文《Harness²: Recursive Agent Harnessing for an Open World》(arXiv 2610.14224,2026-10-09,Google Research 与西北大学),对应 Table 1、Table 2、Table 3 与 Figure 1、Figure 7;组件、流程与命令取自 google-research/harness2 仓库 README 与项目主页 harness2.github.io;仓库状态(19,612 星、1,933 fork、Apache-2.0、建仓 2026-10-06)取自 GitHub API 2026-10-25 快照;七日新增约 1.7 万星取自 findarepo 2026-10-25 榜单。图 1、图 2、图 3、图 8 为官方原图,图 6 为论文原图;图 4、图 5、图 7 为本刊据论文表格自绘。每题 4 遍与 16 遍的算法按 README 中 --k 与 --mode 的定义推算,非官方口径。
我是 AI研习驿站,专注于 AI 工具与开源模型的真实上手评测。
点赞、转发、评论。