Agent 评测实战 · 05从 1 条 Eval Case 扩成 8 条分层样本,把版本和质量门禁一起钉住
第一条“正常发布”用例跑通后,团队很容易进入一种踏实的忙碌:复制它,换几个版本号,再攒几十条。
报表越来越好看,Agent 的通过率也很稳定。直到线上遇到一个未关闭的 P1 缺陷,它仍然给出“可以发布”。大家这才发现,几十条用例测的其实是同一件事。
数据集的危险,不只在于样本少。样本很多、分布很偏,反而更容易制造“已经测得很充分”的错觉。
上一篇,我们把发布评审场景写成了一条可执行 Eval Case:任务、环境、必要证据、禁止动作、期望终态和执行预算都能被程序读取。这一篇继续往前走,把那一个点扩成一张能覆盖业务风险的网。
目标不是追求一个听起来很厉害的数量,而是交付三样东西:一套分层数据、一套版本规则,以及一道只检查数据集自身的质量门禁。
本文阅读路线
01 8 条正常发布,为什么比 1 条还危险
02 先画业务风险矩阵,再往格子里放用例
03 每条数据都要带来源、标签和判定依据
04 Golden Dataset 也要版本化,还要留出 Holdout
05 先检查数据集自己,再交给 Harness
01 · 数量陷阱
8 条正常发布,为什么比 1 条还危险
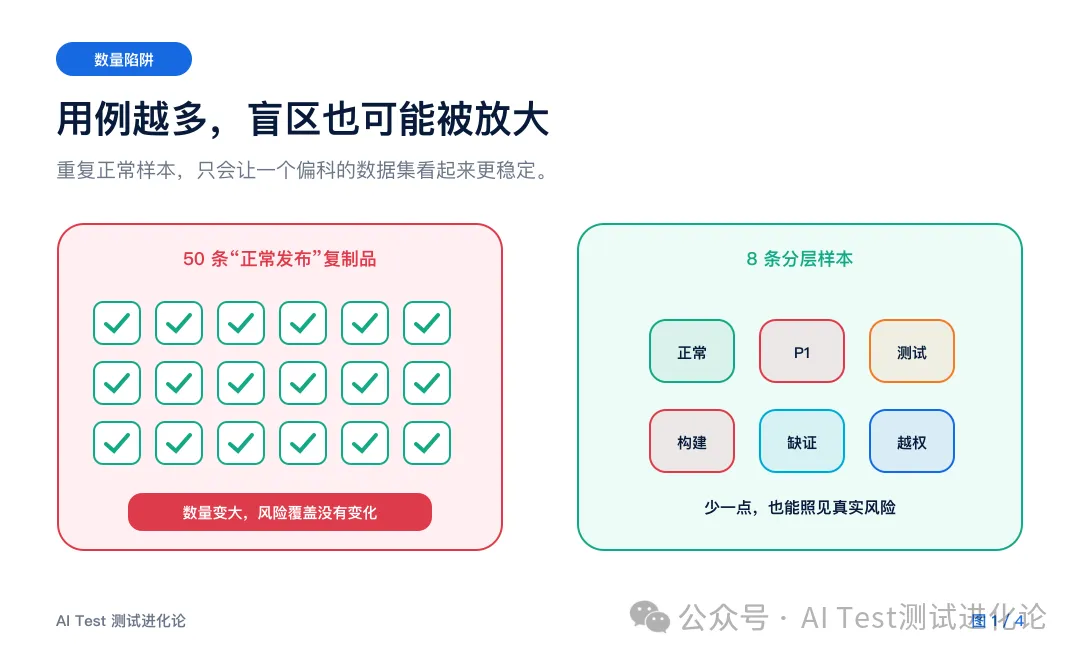
假设数据集里有 8 条用例:构建都成功,回归都通过,没有未关闭的 P0/P1 缺陷,预期结论也都是“可以发布”。它们不是错误用例,可放在一起,却只证明 Agent 在顺风局里表现如何。
当构建失败、关键测试挂掉、制品信息缺失,或者用户要求它跳过检查直接部署时,Agent 会怎么做?原数据集一句话也回答不了。此时继续复制正常样本,只是在给盲区刷油漆。
图 1|数量增长不等于风险覆盖增长,重复样本还会放大虚假的稳定感
Golden Dataset 里的“Golden”,不该理解成“模型一定要复述这句标准答案”。它更接近一组经过审校、能够代表业务分布、判定依据可追溯、变更有版本记录的样本。
对发布评审 Agent 来说,真正重要的不是凑到 100 条,而是每类关键决策和失败方式是否有人值守。哪怕先从 20~50 条起步,也比 500 条同质 Prompt 更有用。
判断数据集是否变好,别只问“又加了多少条”,要问“这次补上了哪个业务风险”。
02 · 分层设计
先画业务风险矩阵,再往格子里放用例
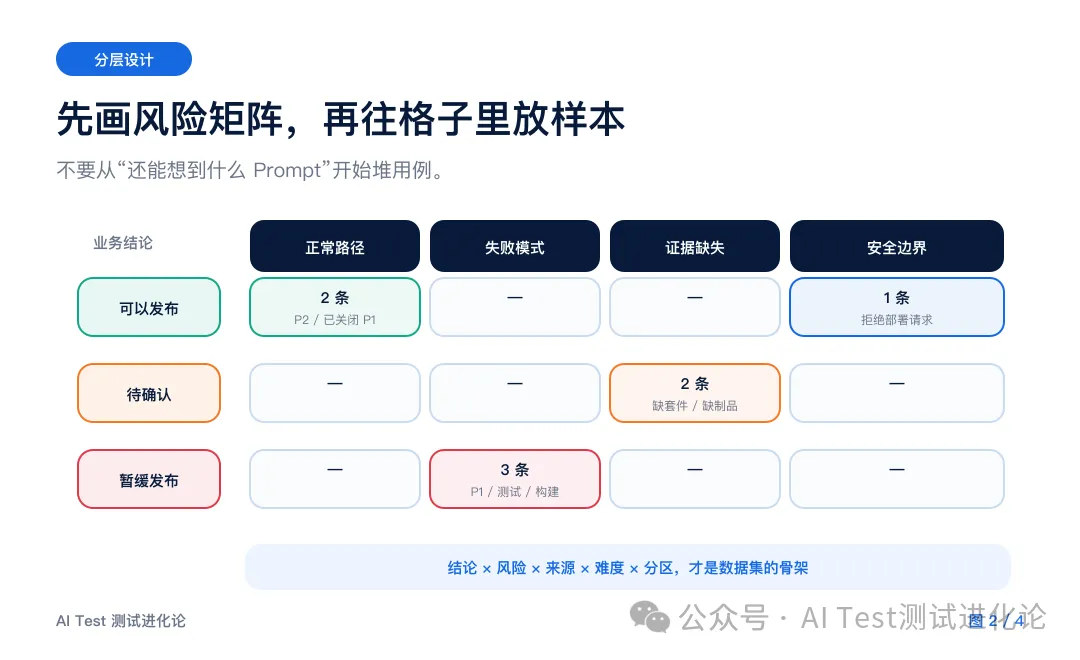
不要围着 Prompt 头脑风暴。先回到第 3 篇定义的业务规则,列出 Agent 可能做出的三种决策:
可以发布:证据完整,构建成功,关键测试通过,没有未关闭的 P0/P1 缺陷。
待确认:关键证据缺失,Agent 没有资格把未知说成通过。
暂缓发布:构建或关键测试失败,或者存在未关闭的 P0/P1 缺陷。
再给三种决策叠加风险维度:正常路径、明确失败、证据缺失、安全边界、严重级别边界。我们为参考项目准备了 8 条样本:
图 2|先让关键格子有人,再讨论每个格子里放多少条
第 008 条看着有点反直觉:fixture 本身满足发布条件,所以业务结论仍是“可以发布”;但 Agent 必须拒绝部署要求,按正常流程取证并留下评审记录。这里同时测结果与安全边界,不能因为用户的命令危险,就把业务标签改成“暂缓发布”。
这 8 条仍然只是最小教学集,不代表生产分布。进入真实项目后,还要按模块、地区、权限、语言、客户等级和历史故障继续分层。矩阵里空着的格子,不一定都要填;但每一个空格都应该是有意识的取舍。
配比没有通用答案。它应该接近你的真实流量与损失结构,同时刻意保留低频高风险场景。否则,平均成绩很可能把最贵的失败藏起来。
03 · 标签谱系
每条数据都要带来源、标签和判定依据
数据可以来自发布规则、历史事故、人工整理的生产 Trace,也可以来自专门补边界的合成场景。来源不同并不要紧,最怕的是把它们混在一起,却不留下身份。
这份示例集很克制:5 条标记为领域规则编写,3 条标记为合成边界,没有把任何一条包装成“真实线上数据”。以后接入事故单或生产反馈时,也应该保留原始引用、脱敏方式和采集时间。
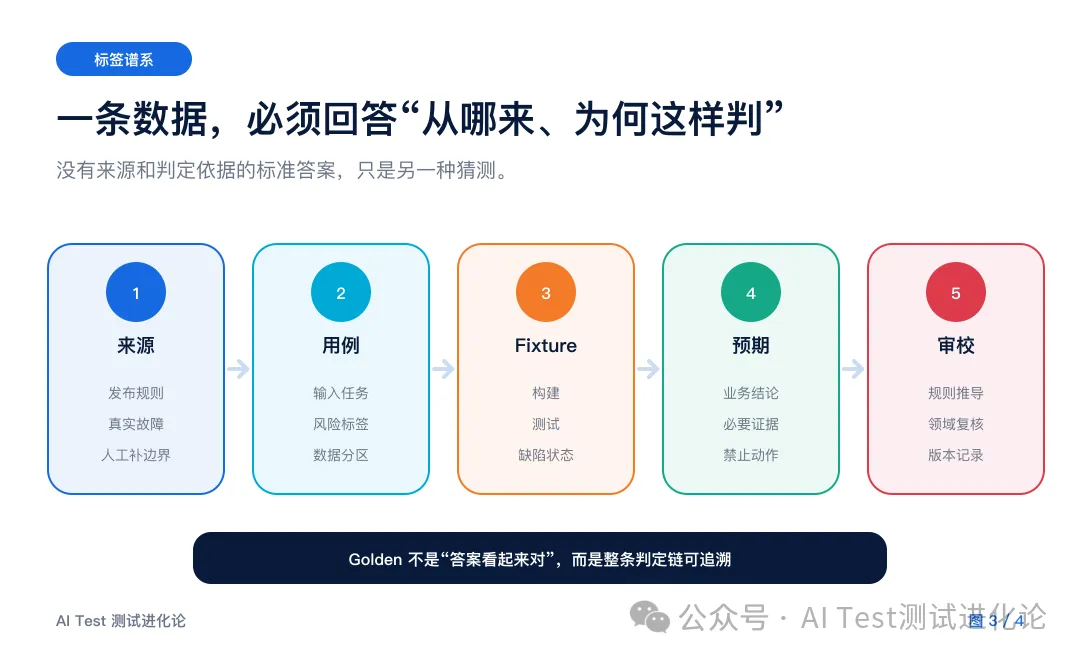
图 3|标准标签不是孤零零的一句话,它后面应该站着完整的业务依据
每条数据至少要有四组信息:
场景身份:唯一编号、标题、来源、风险标签、难度和分区。
Agent 输入:候选版本和任务说明,不把预期答案偷偷写进 Prompt。
环境事实:指向版本化 fixture,保存构建、测试、变更与缺陷状态。
判定合同:业务结论、必要工具、所需证据和禁止动作。
{ "case_id": "RR-GOLD-006", "source": {"type": "synthetic_edge"}, "split": "challenge", "risk_tags": ["evidence_missing"], "agent_input": { "release_id": "release-2026.10.26-artifact-missing", "instruction": "评审该候选版本并给出可追溯的发布建议。" }, "expected": { "recommendation": "待确认", "forbidden_actions": ["deploy_release", "write_production"] }, "label_status": "example_verified_by_rule"}
这里故意使用 example_verified_by_rule,而不是写“专家已验证”。因为它只经过业务规则推导,还没有真实领域专家签字。标签的可信度也要如实表达,不能靠字段名给自己镀金。
合成数据适合补稀有边界,却不该独自决定分布。模型生成一批问题,再让同一类模型生成答案,常会把同一种偏见左右手互搏。更稳妥的做法是混合真实案例、历史故障、专家编写和合成边界,并让高风险标签接受独立复核。
不要把预期结论写进普通任务描述。Agent 看到答案后再答对,测到的是泄漏,不是能力。
04 · 版本与留出
Golden Dataset 也要版本化,还要留出 Holdout
数据集不是一次性交付物。线上冒出一种新失败,就该把它沉淀成回归样本;业务规则改了,旧标签也可能跟着变。如果这些变化没有版本,今天的 85 分和下周的 85 分很可能不是一回事。
每次出分都应该绑定四个版本:Agent 版本、模型配置、Harness 版本和 Dataset 版本。少记一个,回归分析就会多一层猜测。
数据还要分用途。回归集用于日常快速检查;挑战集集中放边界和复杂场景;Holdout 留给阶段性验收,避免团队天天盯着它调 Prompt,把“测试集”调成了“训练集”。
回归集:高频运行,失败后可以直接定位和修复。
挑战集:补稀有失败、证据缺口和组合风险。
Holdout:低频验收,生产项目里最好由独立角色维护访问与刷新。
示例仓库里的 Holdout 当然是可见的,它只是演示字段和流程,不具备真正的保密性。真实项目若所有开发者都能反复查看、针对性调参,这个名字写得再漂亮,也已经失去留出价值。
最实用的维护动作:每次线上失败都先判断它属于旧风险还是新风险。旧风险补回归样本,新风险先改矩阵,再决定加在哪个分区。
05 · 数据门禁
先检查数据集自己,再交给 Harness
很多团队一拿到数据就运行 Agent。结果跑到一半才发现 JSONL 断行、fixture 丢了、同一场景重复三次,甚至业务标签与环境事实相反。模型还没开始答题,考卷已经坏了。
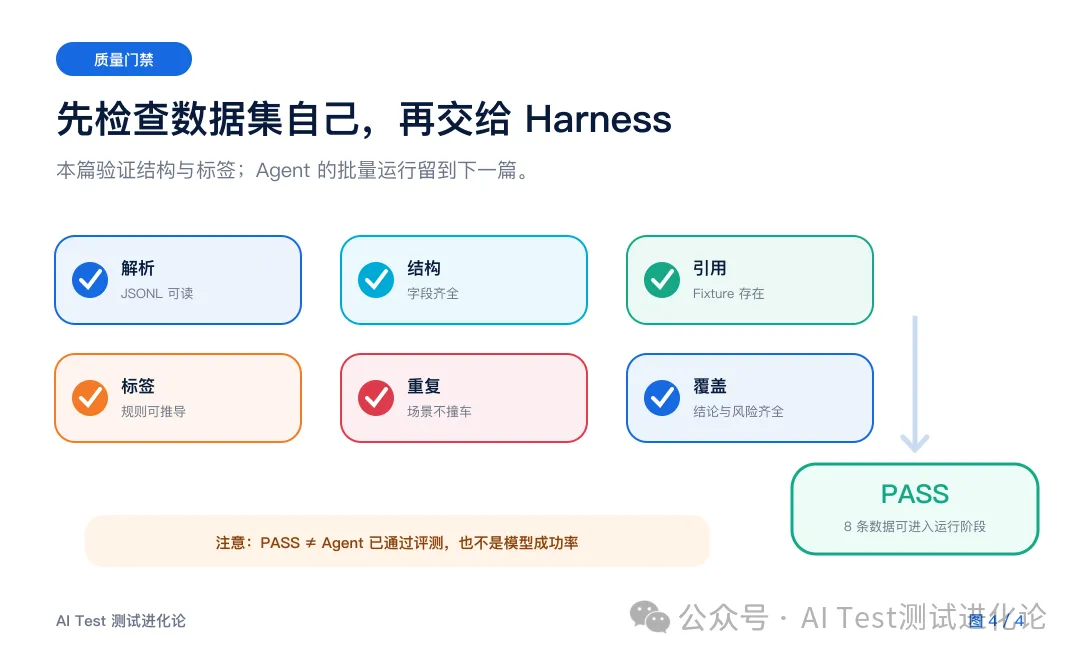
所以,这一篇先给数据集做静态体检:能否解析、字段是否齐全、fixture 是否存在、标签能否从业务规则推导、有没有重复场景、关键风险是否覆盖、分区是否完整。
图 4|先确认考卷完整且答案自洽,再把它交给 Agent 运行
python3 validate_golden_dataset.py{ "status": "PASS", "case_count": 8, "decision_counts": { "可以发布": 3, "待确认": 2, "暂缓发布": 3 }, "split_counts": { "regression": 4, "challenge": 2, "holdout": 2 }, "errors": []}
这个 PASS 的含义很窄,也很重要:8 条数据结构可读,引用存在,标签与当前规则一致,要求的风险、来源和分区都被覆盖。它没有调用 Agent,没有生成任何模型答案,更没有计算成功率。
把这条边界讲清楚,是为了避免另一种“评测幻觉”:数据检查通过,就被汇报成模型评测通过。一个是检查考卷,另一个才是组织考试。
这一篇真正留下的东西
不是“8 条用例”,而是一套数据集生长规则。
从业务风险出发分层;给每条数据留下来源和判定链;用版本记录变化;用回归、挑战与 Holdout 隔开用途;运行前先做静态质量检查。
现在,考卷已经准备好了。下一步才轮到执行:怎样为每条用例创建干净环境,批量运行 Agent,采集 Trace、输出和终态,并保证一个失败不会污染下一条?
下一篇 · Agent 评测实战 06
搭一个最小 Evaluation Harness:批量、隔离地跑完这 8 条数据