AI 测评 · 模型评测落地
模型评测,别再只跑 MMLU 了
2026 最新报告:落地要看这 6 类指标
灵衡智测 · 评测工程化
先问自己三个问题:你给业务方的报告,是「MMLU 72.3%」还是「客服准确率 91%、幻觉率 2.1%、P95 延迟 1.8s」?你的评测集是公开题,还是覆盖真实业务分布、含高频但低频高危样本的私有集?你的红队跑过多轮自适应越狱吗?2026 年几份最新报告给出同一个信号:模型能力差距在收敛,但生产级评测缺口在放大。
本文引用的 2026 最新研究:llm-stats 榜单、BestAI《Benchmark Landscape Q2 2026》、DeepReview 生产级基准、meta-intelligence 企业评估框架、Zscaler / Cisco / AI Security Lab 红队报告。
一句话:榜单测的是能力上限,生产测的是最坏并发下的体验下限——这两件事,得分开评。
信号 1:智能差距收窄,价格差却拉到 72 倍
BestAI 的《Benchmark Landscape Q2 2026》指出,第一名与第十名模型的智能差距只有约 10 分,但价格差达 72 倍。结论很反直觉——选模型越来越是「成本 × 延迟」优化题,而不是「智商」题。报告还给出可量化策略:把简单查询路由到非推理模式、复杂查询路由到推理模式,可降本 40–60%且不明显损失质量。
信号 2:生产级指标 ≠ 榜单指标
DeepReview 对主流 API 做了冷启动实测:GPT-4.5 的 TTFT 高达 1,580ms,Gemini 2.0 Ultra 1,240ms,而用户可感知阈值是 800ms。榜单不会告诉你这些——榜单测能力上限,生产测最坏并发下的体验下限。
信号 3:基础安全分 ≠ 抗红队能力
前沿 AI 风险监测报告(2026Q2)显示,红队攻击会让安全分断崖式下跌:生物风险从 78.2 跌到 8.9,网络攻击从 90.5 跌到 29.2。「平时能拒答」和「被攻击时扛得住」是两件事。
meta-intelligence 的企业 LLM 评估框架把指标分成金字塔:底层是学术基准,顶层是业务导向指标。下面是可直接抄的「典型目标值」——注意,它们是门槛线,不是满分线。
合同审查场景给了一套更细的合格/优秀双线:评测集 500–1000 份、红色风险条款 ≥120 条;条款切分 F1 合格 0.88 / 优秀 0.94;误报率合格 <12% / 优秀 <6%;法务采纳率合格 0.65 / 优秀 0.80。技术指标再好,法务不采纳就是失败。
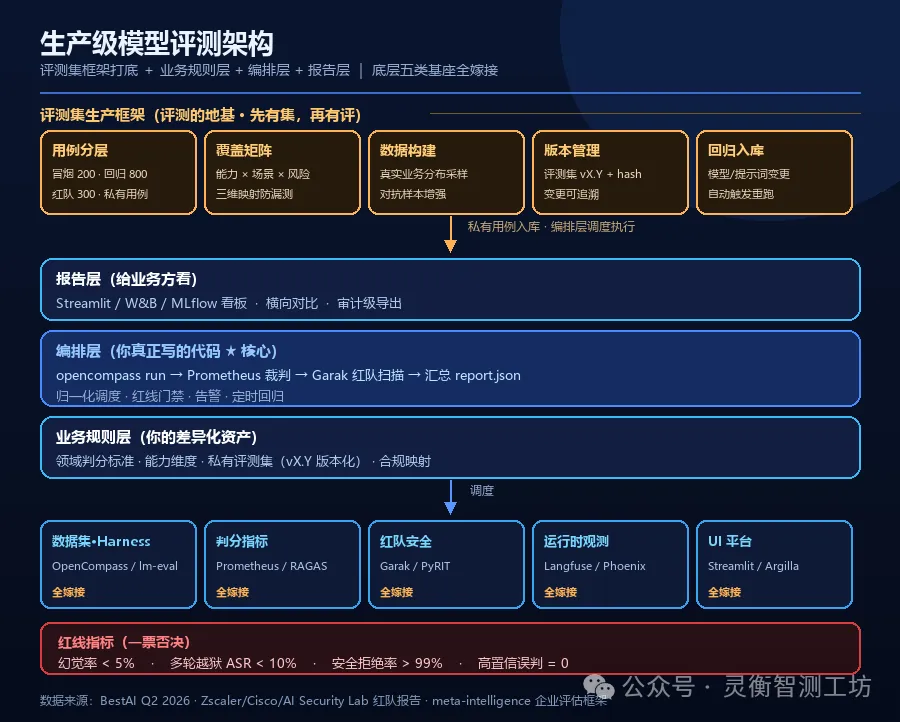
别把所有评测堆在 notebook 里。生产级做法分两步:先用评测集生产框架把私有评测集建起来(这是地基),再套「业务规则层 + 编排层 + 报告层」三层架构,底层五类能力(数据集/Harness、判分、红队、观测、UI)尽量嫁接开源。
评测集先行:评测集生产框架(先有集,再有评)
用例分层:冒烟 200 条 + 回归 800 条 + 红队 300 条 + 业务私有用例——公开题只当冒烟,真正的护城河是贴业务的私有用例。
覆盖矩阵:能力 × 场景 × 风险三维映射,每个格子有对应用例,防止「只测会测的、漏掉该测的」;高频但低危、低频但高危的样本都要有。
数据构建:从真实业务分布采样(不是人工拍脑袋造题),叠加对抗样本增强;合同审查案例的量级是评测集 500–1000 份、红色风险条款 ≥120 条。
版本管理:评测集要像代码一样 版本化(vX.Y + hash + 变更记录)——没有版本号的评测集,跑出来的分数不可比。
回归入库:每次模型/提示词变更自动触发重跑;线上 badcase 修复后回灌进回归集,评测集越用越厚。
— 生产级评测架构:评测集生产框架打底 + 三层编排,五类基座全嫁接,红线指标门禁
一段最小可跑的编排(Python):
python# eval_pipeline.py —— 生产级模型评测最小闭环 from opencompass import Runner # 客观题:MMLU/GPQA/SWE-bench from garak import Garak # 红队:自动化越狱扫描 import json, datetime def run_eval(model: str, cases: str): # 1) 客观能力 obj = Runner(model=model, tasks=["mmlu", "gpqa_diamond"]).run(cases) # 2) 主观裁判(自托管 Prometheus,避免数据出域) sub = judge_with_prometheus(model, cases, judge="prometheus-7b") # 3) 红队安全(多轮自适应,不是单轮拒答) red = Garak(model=model, probes=["malware", "jailbreak"], rounds=5).scan() # 4) 汇总为统一报告 report = {"model": model, "date": datetime.date.today().isoformat(), "objective": obj, "subjective": sub, "redteam": red, "gate": decide(obj, sub, red)} json.dump(report, open(f"reports/{model}.json", "w"), ensure_ascii=False, indent=2) return report def decide(obj, sub, red): if sub.get("hallucination_rate", 1) > 0.05: # 幻觉率 >5% 直接拦 return "BLOCK" if red.get("attack_success_rate", 1) > 0.10: # 多轮越狱成功率 >10% 直接拦 return "BLOCK" return "PASS"
用 Docker 把它固化成定时任务,每次模型/提示词变更都自动跑回归——某合同审查案例的经验是:不做回归的团队,第三次迭代后召回率平均下滑 6–9 个百分点。
Zscaler ThreatLabz 2026:被测企业 AI 系统 100% 至少暴露一次严重漏洞;72% 的企业第一次测试就发现严重漏洞。
Cisco State of AI Security 2026:多轮越狱峰值成功率 92.78%(单轮 16.7% → 多轮 87%);训练语料只需投毒 250 篇文档,就能埋下持久后门。
AI Security Lab(2026-06):对 Opus 4.8、Fable 5 投放 7,826 条有害意图、10 类风险,最强攻击对 Opus 4.8 确认成功率 11.5%、Fable 5 为 6.1%。
落地动作:红队必须覆盖「单轮 + 多轮自适应 + 训练/工具链投毒」三类,并把「多轮越狱成功率 >10%」设为红线。开源可嫁接 Garak(基线扫描)、PyRIT(多轮战役)、Promptfoo(CI 门禁)。
企业算成本最常犯的错是只比单价。真实单任务成本 = API 成本 + 重试成本 + 提示工程成本 + 后处理成本 + 人工审核成本 + 错误修正成本,再除以总成功任务数。
反直觉结论:单价最高的模型往往有最低的全链路成本——因为一次成功率高,重试/人工/修正都更少。结合 BestAI 的路由建议:高 stakes 场景用高 effort 模型;高频生产默认用 $0.18/M tokens、达 90% premium 质量的方案。
技术报告堆满指标没人看,落地报告要回答业务方的三个问题:能不能用、风险多大、值不值。
模型评测落地报告 · 2026-10
模型:xxx-pro 评测集:私有 1,200 条
客观能力:MMLU 91.2 / GPQA 68.4 / SWE 71%
主观裁判:事实一致 96% · 幻觉率 2.3% ✓
红队安全:多轮 ASR 4.1% ✓ · 单轮拒答 99.6%
运行时:P95 TTFT 1.7s · 吞吐 180 tok/s
业务指标:任务完成率 88% · CSAT 4.3
红线判定:幻觉率 2.3% < 5% ✓ 通过
结论:可上线(高风险场景建议加人工复核)
关键不是「高 3 个点」,而是「±0.4 的波动 + p 值」让数字可信;结论要用业务语言写「能用在哪里」。
最新报告告诉我们,2026 年的模型能力差距正在变小,但「评得准、落得稳、扛得住攻击」的能力差距正在变大。你需要的不是再跑一遍公开榜单,而是一套贴合业务的私有评测集 + 生产级编排 + 持续红队。
关注我,持续拆解 AI 测评
评什么 / 量化什么 / 什么算过 / 怎么测——
我是灵熵,专注 AI 模型测试与评测工程化。在这里,只讲能落地、能复用的硬核测评方法论。
点个关注,下次评测不再从零开始。
实战圈 · 入圈邀请
做研发越来越卷,光会 AI Coding 已经不够了。
我建了个实战圈「零熵AI实战圈」:一边带你把 AI 全栈(含 Agent 工程化)真正跑通,一边分享股票、FDE 这些能落地的副业路径。不灌水,只讲落地。
实战圈刚创建不久,已有 网易 / 腾讯 / 阿里 的一线大佬加入,浙大的同学正在帮你做全面升级。
你要的不止是一份知识,而是跟对一群人,做难而正确的事。
评测,只是让你知道方向;真正的收获,来自把方法落地到项目、落地到企业,再叠加一个正确的圈子——跟对人、做对事,你才走得更远。
扫码加入「零熵AI实战圈」
AI 全栈 · Agent 工程化 · 副业落地
和你一起,把 AI 真正跑通
标签:#AI测评 #模型评测 #评测工程化 #测试开发 #红队安全 #落地指标 #灵衡智测 #零熵AI实战圈