过去几个月,我把"用 AI 做科研"这件事拆成一件件可复用的技能包,收集、去重、分类、打分、排序,做成一份每天可更新的skill榜单。截至 2026 年 10 月 25 日,清单共计收录 115 个项目,累计 346,227 颗星,其中 88.7% 是 2026 年才创建的。
这篇文章把排序规则、分类口径、完整名单一次说清,并对四个反常识的数据给出解释。先说结论:这份榜最值得看的不是名次,是它暴露的供给结构失衡——宣称"覆盖全流程"的项目占了一半,拿到的星不到两成;真正被收藏的,是扎进一个学科、一个环节的小工具。
一、这份榜是什么
「学术论文 Skill 排行榜」只做一件事:把中文用户能直接上手的科研技能包找出来,排个名。抓取、过滤、分类、打分、发布全部由脚本跑完,每天凌晨执行一次,输出榜单页面、JSON、CSV 与 RSS,同时留一份当日快照,只保留 60 天。
规则是公开的:搜索词与种子名单写在一个配置文件里,筛选与打分逻辑写在一个脚本里,任何人可以按同一套规则复现当天的名次。
换言之,它测量的不是学术成果,而是学术生产工具的供给密度。
二、排行依据:四道门槛、一条主排序、一个辅助分
门槛设了四条,必须同时满足:星数不低于 100;不是 fork、未被归档;命中至少一个 Skill/Agent/Workflow 信号(skill、claude code、codex、opencode、mcp、workflow);命中至少一个 Academic/Research/Paper 信号(academic、paper、literature、peer review、科研、论文)。在此之上,还要求命中"强信号"与高置信度学术信号,或者属于人工维护的种子名单;leetcode、trading、minecraft 一类明显非学术的词会被直接剔除。
100 星这个数,是"有人知道"与"没人知道"之间的分界。它不是行业标准,只是个折中:往上提,2026 年新起的项目会整批消失;往下放,榜单会被一次性账号和课程项目灌满。
主排序是星数降序,趋势分只作辅助,用于识别近期上升的项目。
趋势分的构成是四项加权:近 7 天新增星数(权重 1.2,主信号)、最近 push 的时间新鲜度(90 天线性衰减)、新项目加权(180 天衰减)、当前星数规模(取 log10 平滑)。
规则有三处结构性局限,用之前必须知道。
第一,星数计的是关注度,不是可用性。 我们没有为它设质量维度:不看 SKILL.md 数量、不看能否跑通、不看引用是否核验。
第二,100 星门槛把冷启动项目全部挡在门外。 88.7% 的项目创建于 2026 年,赛道极新,供给正在爆发;但一个刚发布、还没起量的好项目,在任何一天都进不了榜。这形成一个回路:先上榜的获得曝光,曝光带来星数,星数保证它继续上榜。
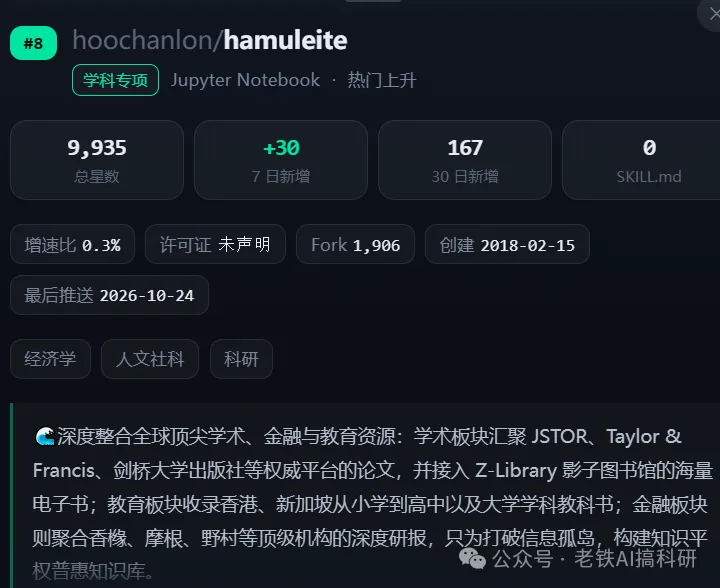
第三,关键词过滤无法区分项目类型。 星数第 8 的 hoochanlon/hamuleite 有 9,935 星,SKILL.md 数量为 0——它是整合 JSTOR、Taylor & Francis、剑桥大学出版社与 Z-Library 的资源导航项目。它有价值,但它不是技能包。
一句话概括:这份榜能回答"这个圈子里什么最受关注",不能回答"哪个最好用"。后者只能自己去筛选了。
三、分类结果
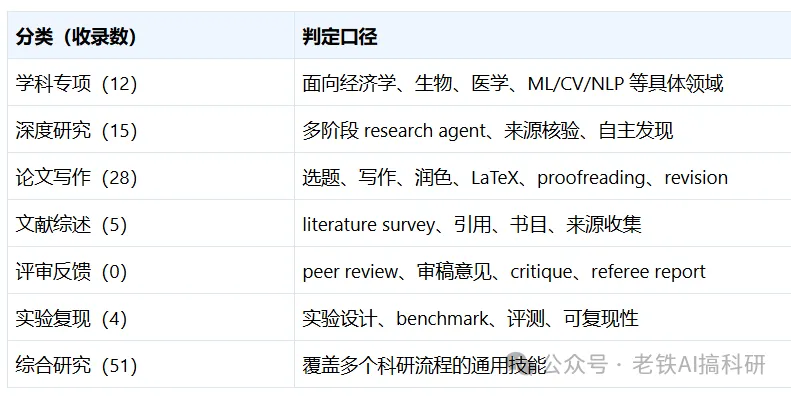
把 115 个项目归入 7 类,每个只进一类,按关键词命中数与固定优先级匹配。下表是这 7 类的判定口径:
换一个切法,结构问题立刻显形——把 7 类按科研流程的位置重新归并:
- 输入端(找与读)
- 加工端(做与算)
- 输出端(写与审)
- 跨段(宣称全能)
这样来看:一篇论文最难的三件事——做出可靠结果、通过同行评审、以及两者之间的论证——恰好落在供给最薄的三处。
四、完整榜单
4.1 总量:34.6 万星,六成项目不足千星
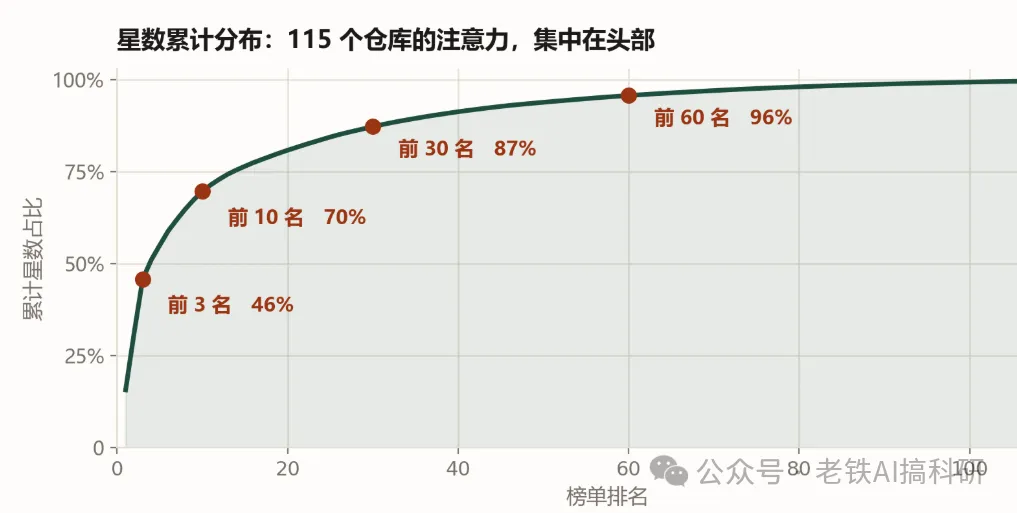
115 个项目合计 346,227 星,中位数 600,均值 3,011。均值是中位数的 5 倍,说明分布极度右偏。
前 3 名合计 158,744 星,占全榜 45.8%;前 10 名占 70%;前 30 名占 87%。与此同时,72 个项目(62.6%)不足 1,000 星。
这不是健康的"长尾",是一个清晰的三层结构:3 个头部、十几个腰部、近百个尾部。
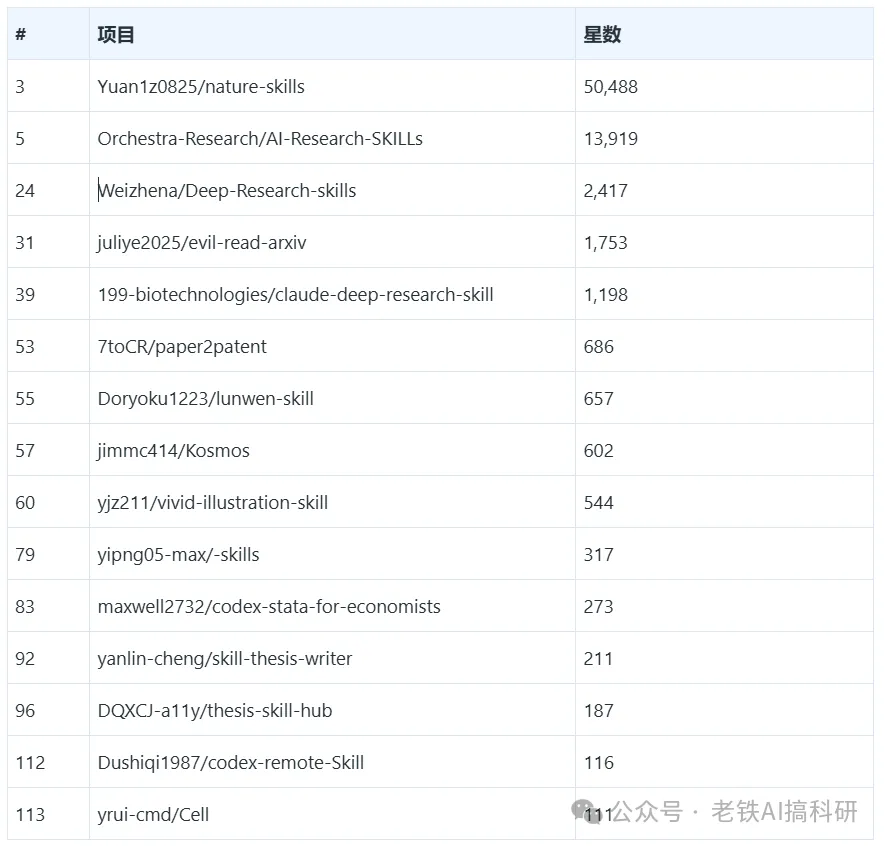
4.2 前 15 名
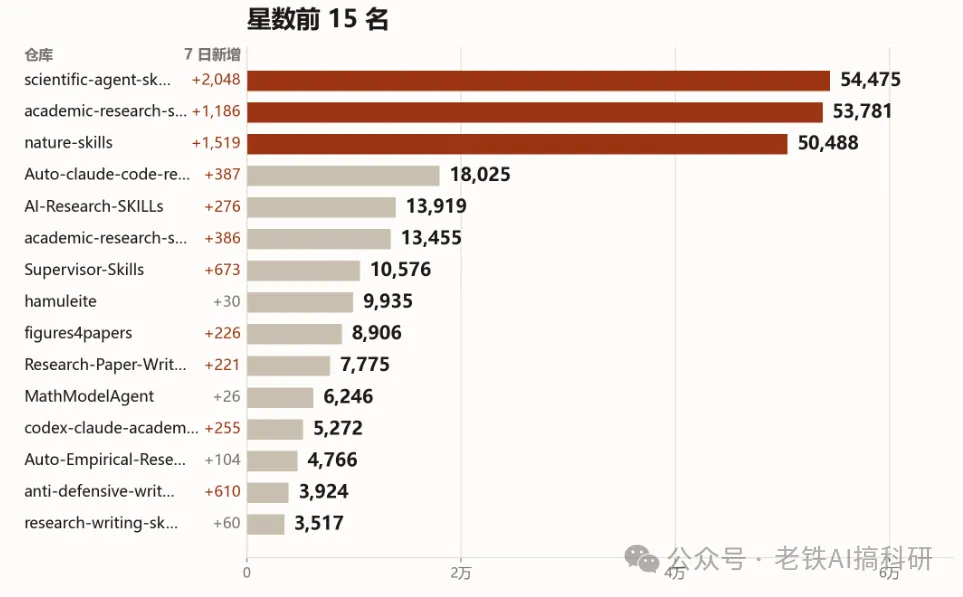
前十名值得逐条看,因为它们的差异比名次更有信息量。
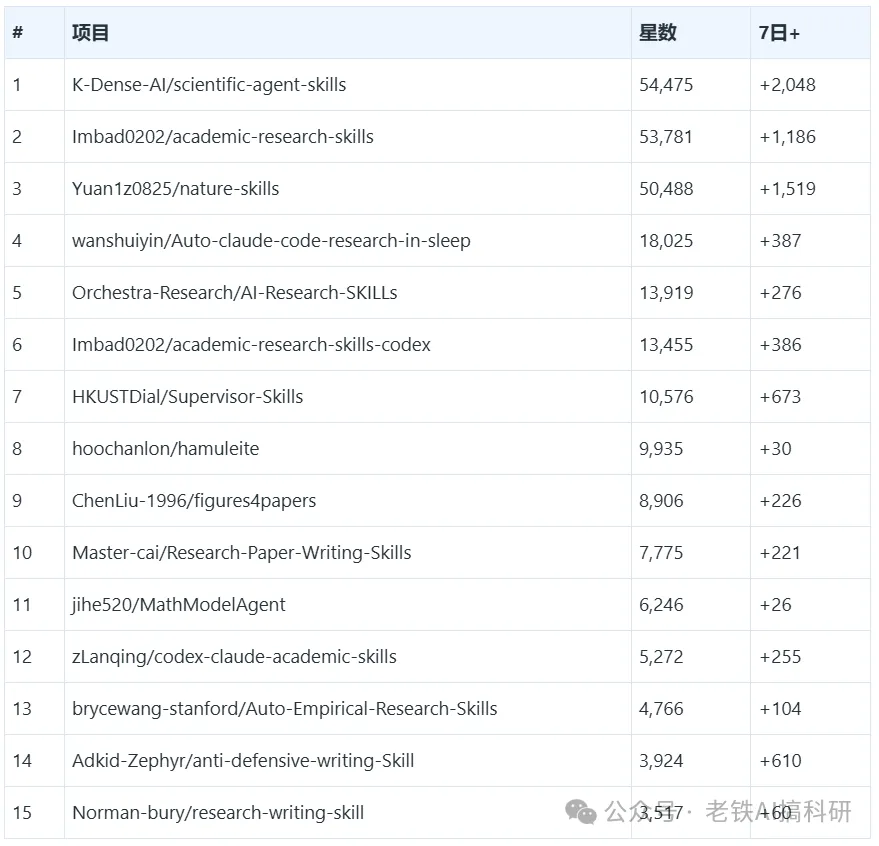
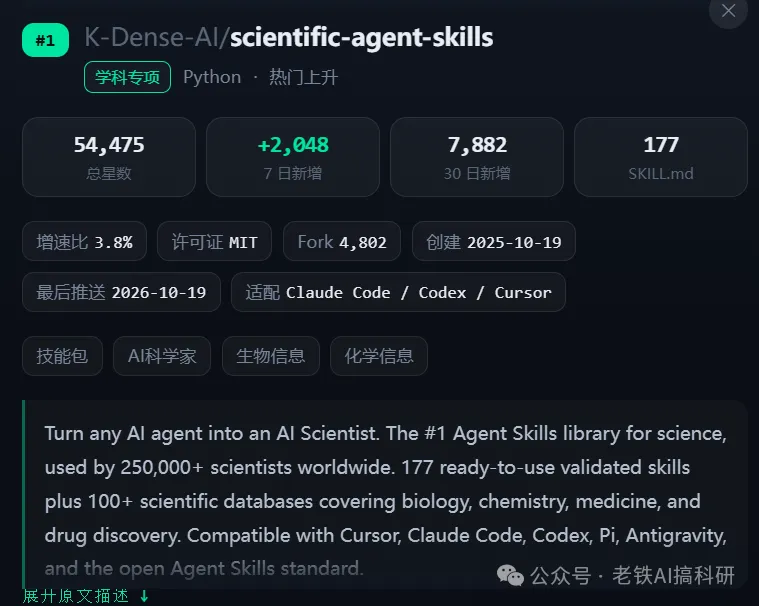
第 1 名 K-Dense-AI/scientific-agent-skills(54,475 星),177 个 SKILL.md,MIT 协议,覆盖生物、化学、医学、药物发现与 100 多个科学数据库,目标是"把任何 agent 变成 AI Scientist"。它是唯一在技能数量与学科覆盖两个维度同时登顶的项目,落点在实验,不在写作。
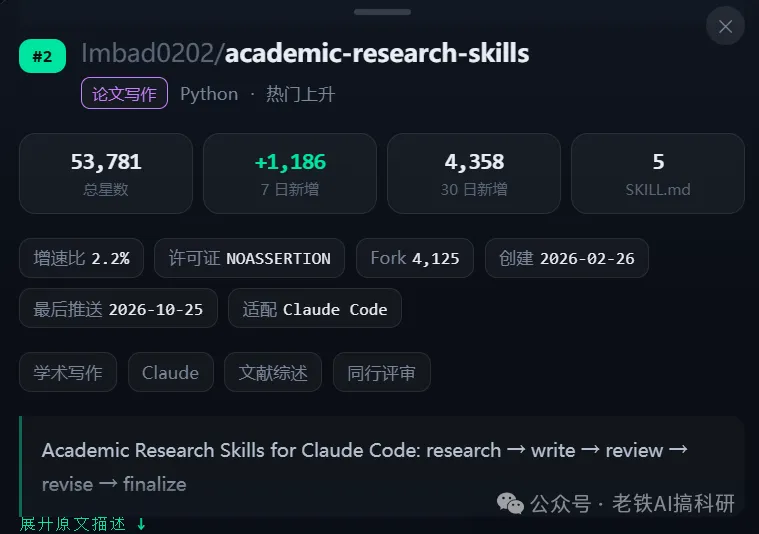
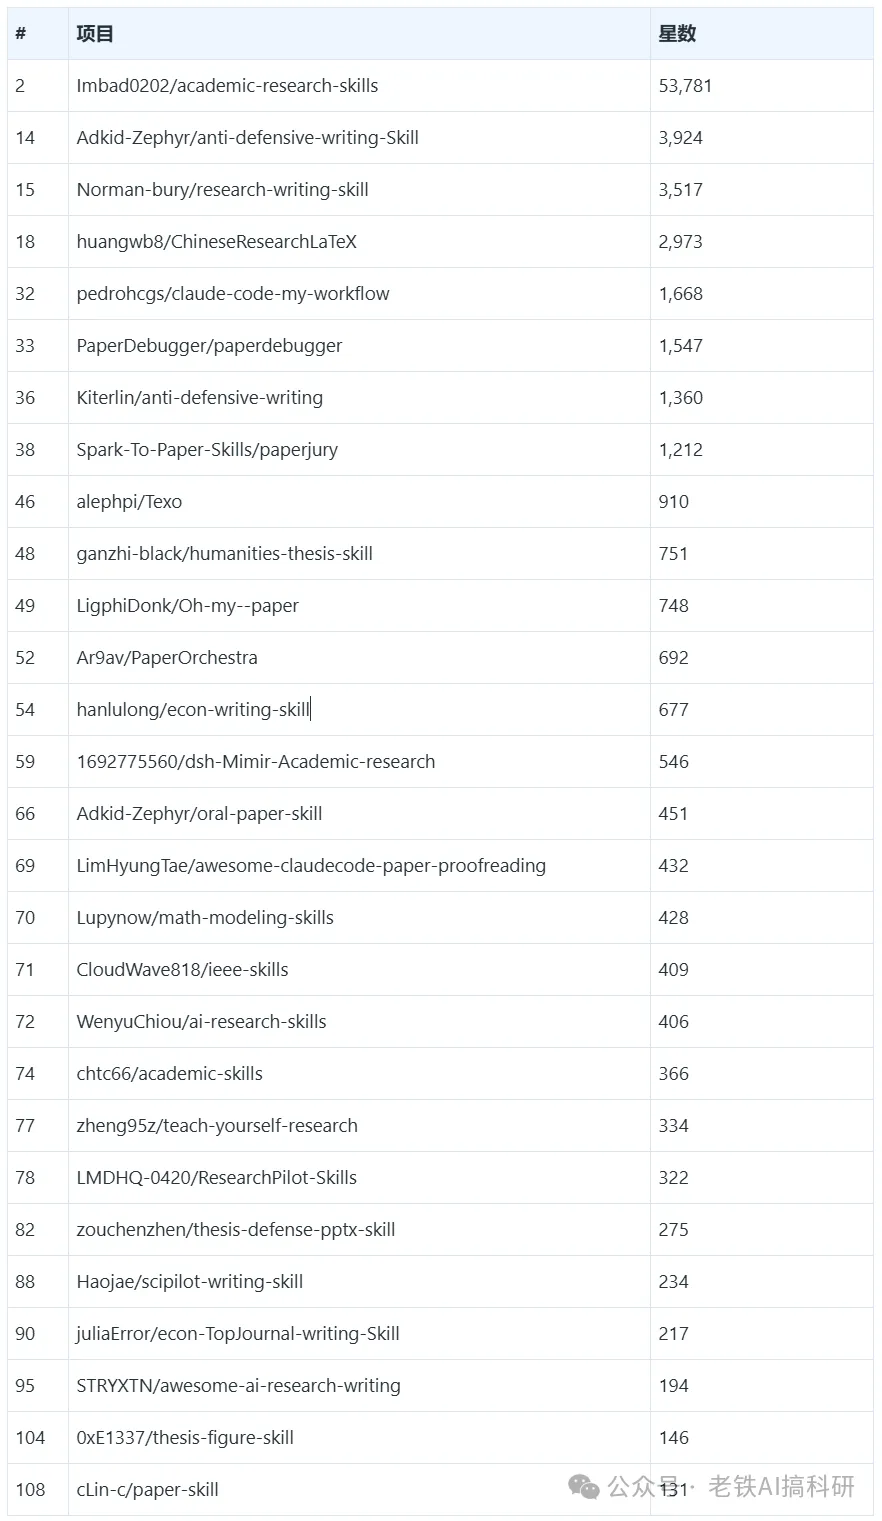
第 2 名 Imbad0202/academic-research-skills(53,781 星),只有 5 个 SKILL.md,走 research → write → review → revise → finalize 五段流程,专供 Claude Code。5 个文件拿到 5.3 万星,是"流程清晰"胜过"内容堆量"的直接证据。
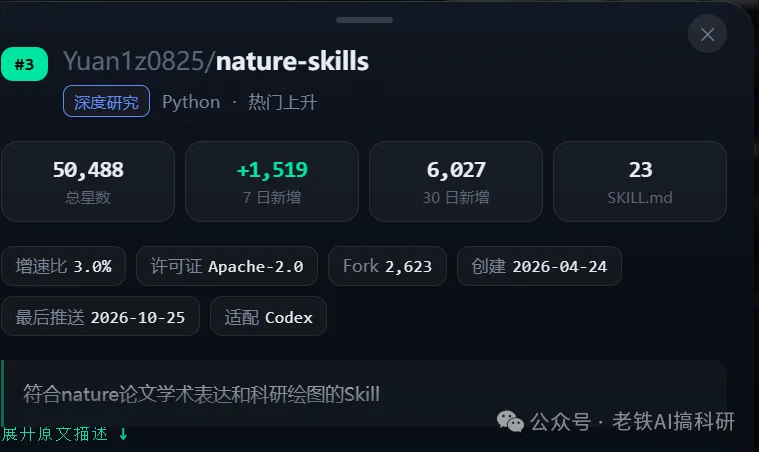
第 3 名 Yuan1z0825/nature-skills(50,488 星),23 个技能,主打 Nature 级学术表达与科研绘图,面向 Codex,中文说明。对国内投稿者,这是刚需而非尝鲜。
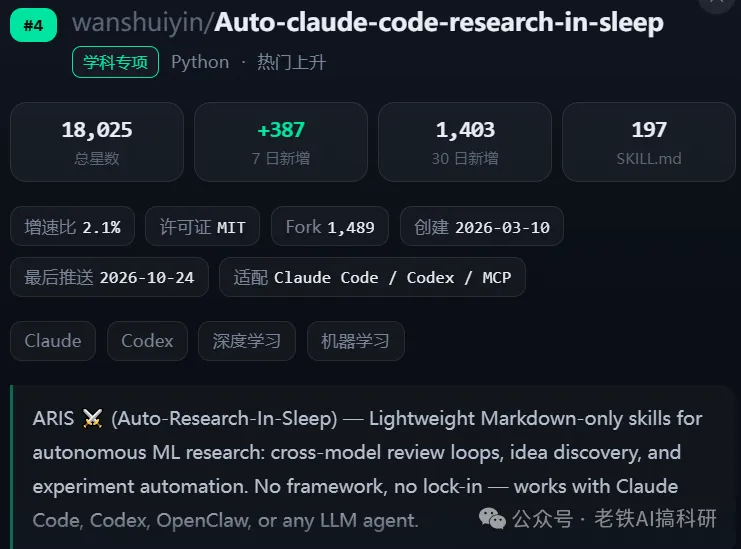
第 4 名 wanshuiyin/Auto-claude-code-research-in-sleep(18,025 星),197 个纯 Markdown 技能,让 agent 在你睡觉时自主跑机器学习实验。技能数量全榜第二。
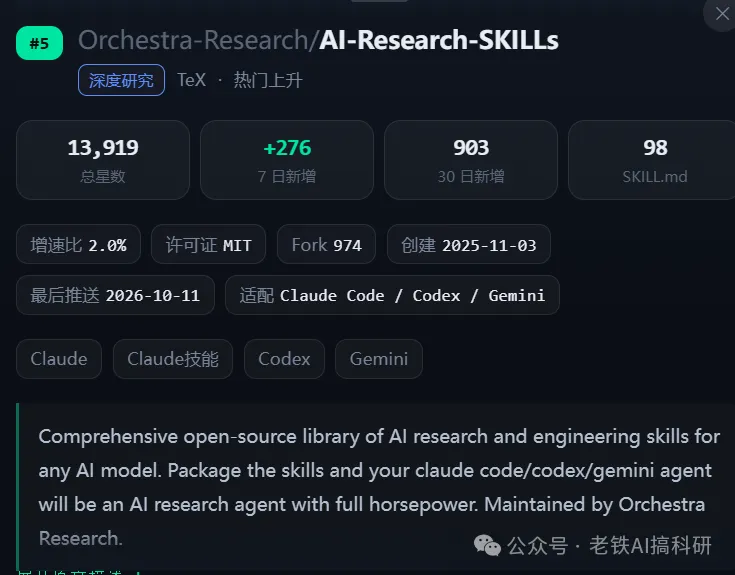
第 5 名 Orchestra-Research/AI-Research-SKILLs(13,919 星),98 个技能,AI 研究与工程的综合库,同时支持 Claude、Codex、Gemini。
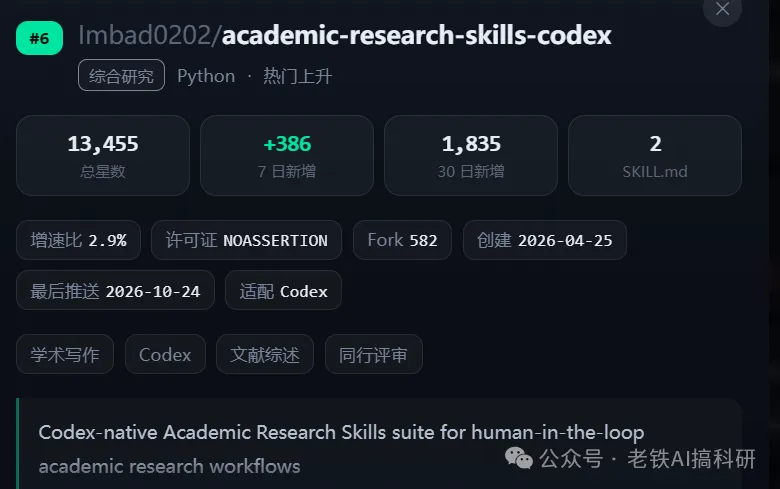
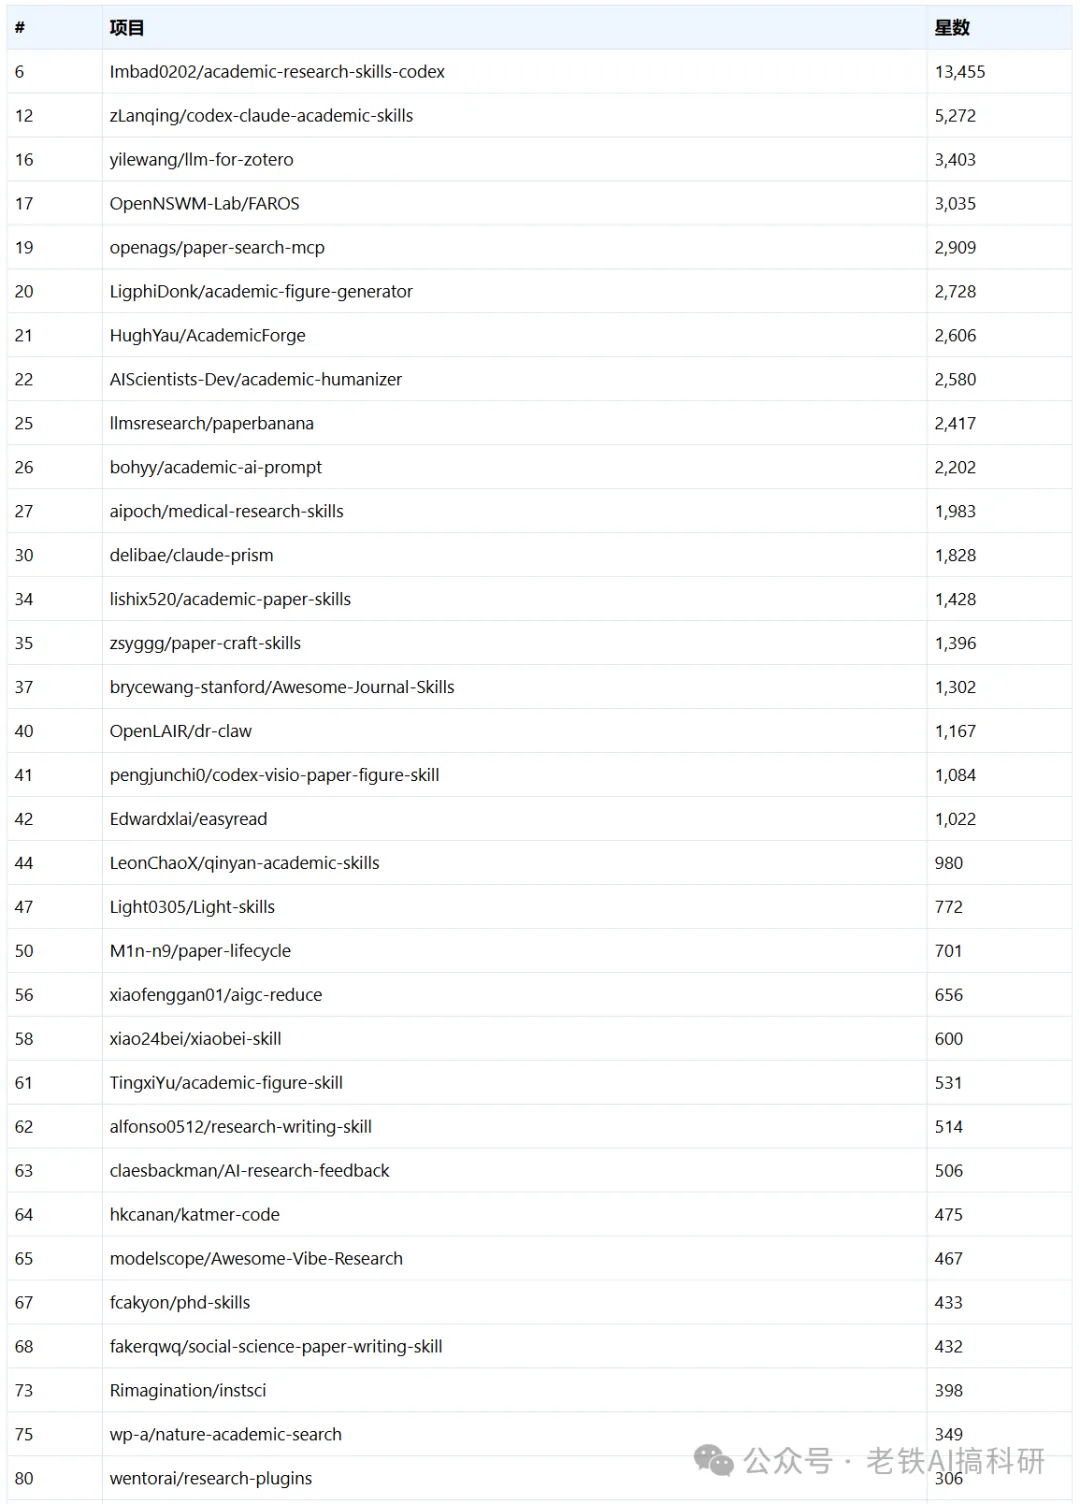
第 6 名 Imbad0202/academic-research-skills-codex(13,455 星),与第 2 名同一作者的 Codex 移植版,仅 2 个技能文件。
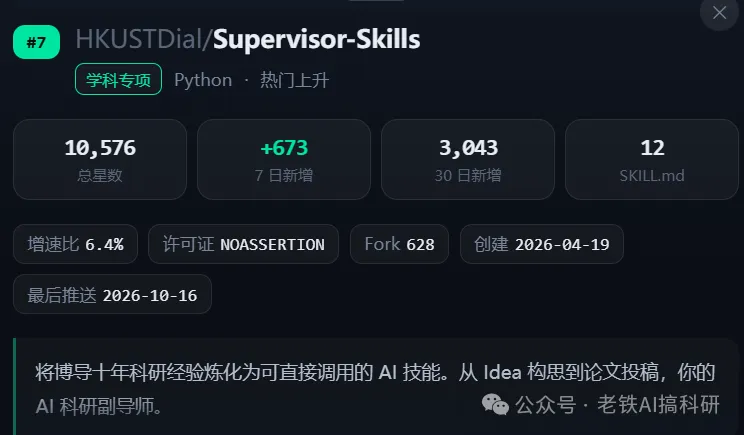
第 7 名 HKUSTDial/Supervisor-Skills(10,576 星),12 个技能,把博士生导师的判断经验封装为"AI 科研副导师",从选题构思到投稿。港科大实验室出品,7 天新增 673 星,是全榜头部里增速最快的。
第 8 名 hoochanlon/hamuleite(9,935 星),SKILL.md 为 0,学术与金融资源导航站。
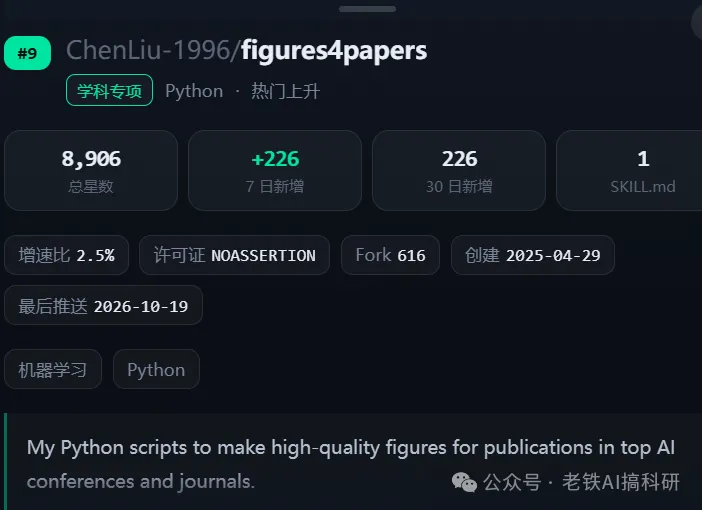
第 9 名 ChenLiu-1996/figures4papers(8,906 星),1 个技能,顶会论文配图的 Python 脚本集。
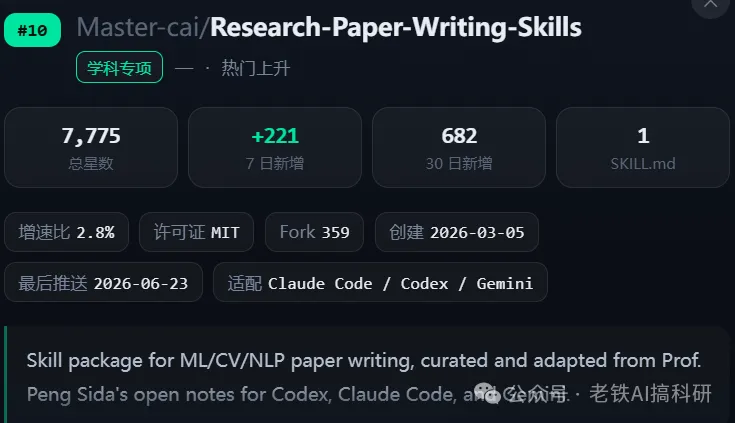
第 10 名 Master-cai/Research-Paper-Writing-Skills(7,775 星),1 个技能,改编自彭思达教授的公开写作讲义,面向 ML/CV/NLP。
4.3 学科专项(12 个)
按定义,这一类面向具体学科。
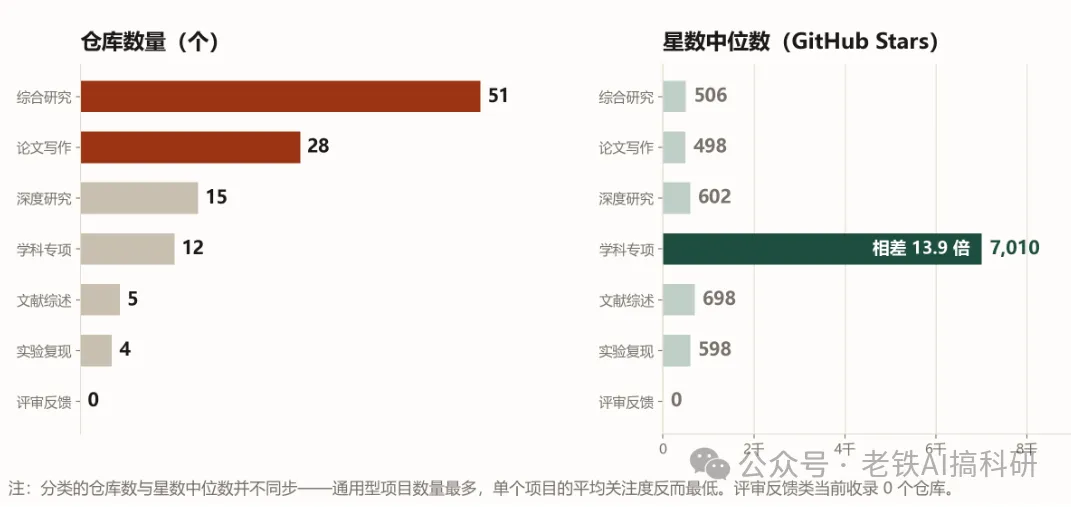
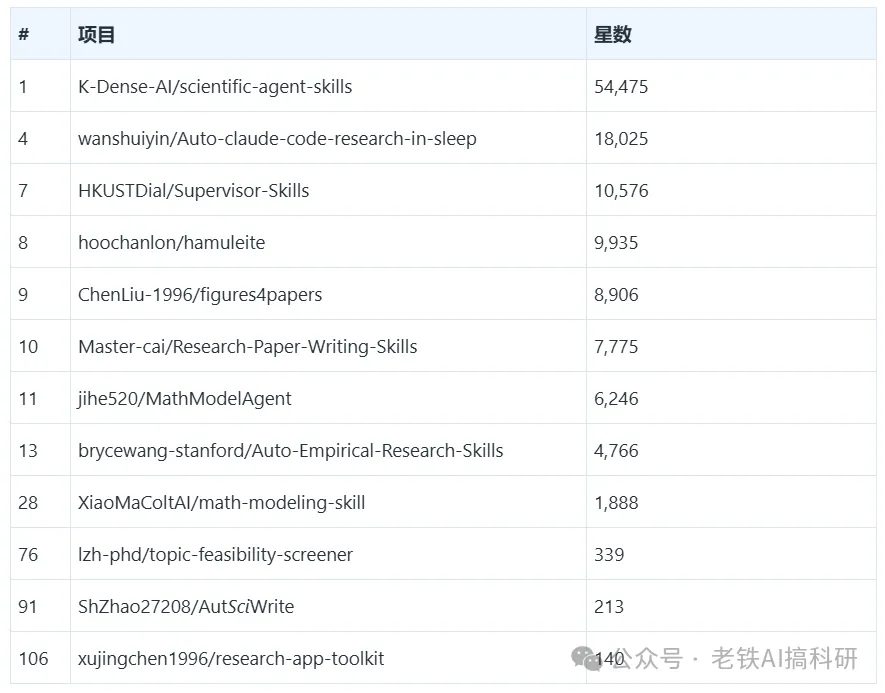
它的数量只占 10.4%,星数却占 35.6%,中位数 7,010 星——是综合研究类(506 星)的 13.9 倍。经济学、医学、生物、数学建模各有专门项目,其中数学建模方向已有三个项目同场竞争(MathModelAgent 6,246 星、math-modeling-skill 1,888 星在本栏,math-modeling-skills 428 星被归入论文写作类)。
4.4 深度研究(15 个)
这一类做的是"多阶段检索 + 来源核验 + 自主发现",是文献工作的上游。
头部两个项目(nature-skills 50,488 星、AI-Research-SKILLs 13,919 星)都出自这一栏,说明"读得深"比"写得好"更早形成产品。
4.5 论文写作(28 个)
数量第二、竞争最激烈的一类,28 个项目里 20 个不足 1,000 星。去掉第 2 名的 53,781 星之后,这一类剩余 27 个项目合计仅 24,870 星,中位数 498——除一个超级头部外全线长尾。
这一栏还有一个细节:全榜至少 5 个项目专攻"反防御性写作"与"去 AI 味"(本栏 3 个:anti-defensive-writing-Skill、anti-defensive-writing、humanities-thesis-skill;综合研究类 2 个:academic-humanizer、aigc-reduce)。同一痛点被反复实现,说明需求真实且尚未被满足。
4.6 综合研究(51 个)
数量最多、平均关注度最低的一类:44.3% 的项目,18.2% 的星数,中位数 506 星,33 个项目不足 1,000 星。多数项目的描述高度相似——"从选题到投稿的完整工作流"。
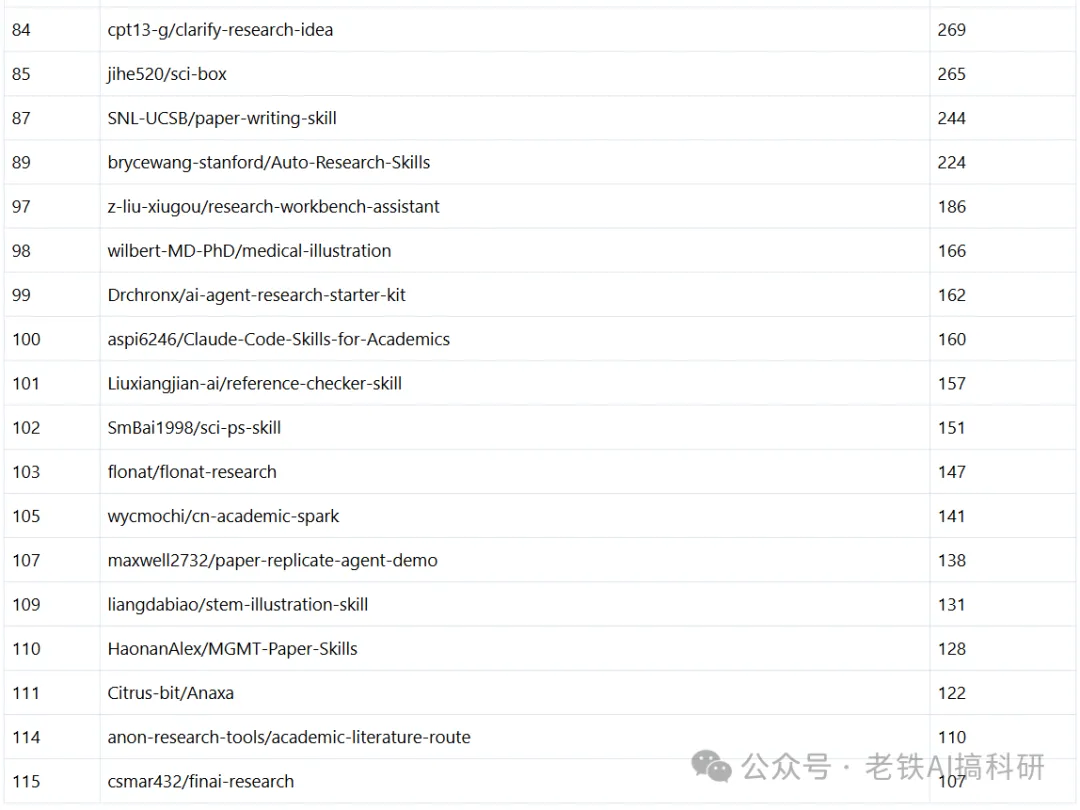
这一栏不是没有好项目(academic-research-skills-codex 13,455 星、codex-claude-academic-skills 5,272 星),而是分化极严重:两个腰部项目撑起门面,其余 49 个项目里有 33 个不足 1,000 星。
4.7 文献综述(5 个)与实验复现(4 个)
这两类是全榜最薄弱的环节,合计 9 个项目、7,868 星。
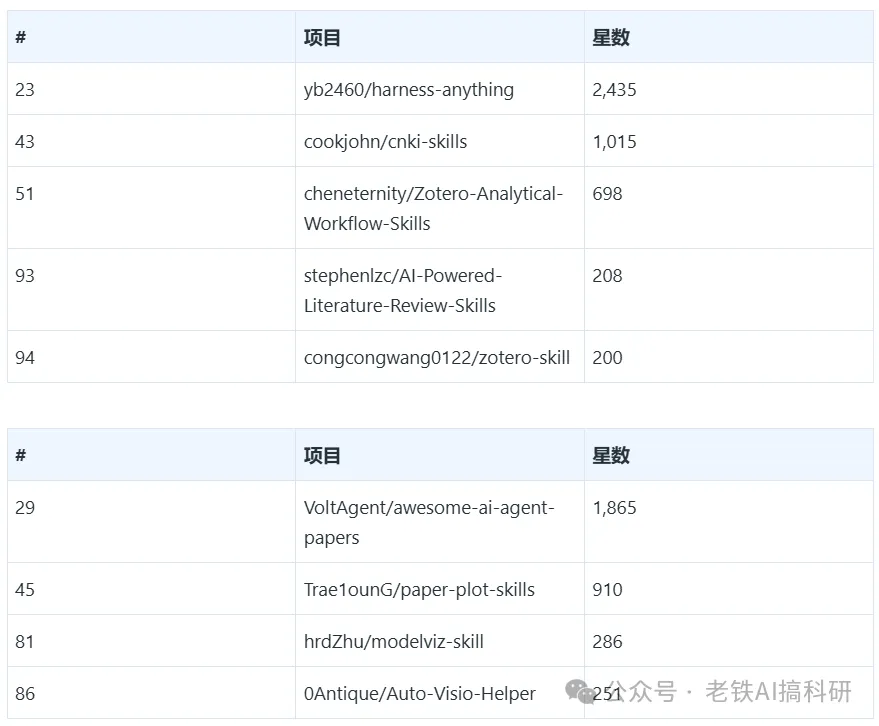
文献综述 5 个至少名实相符:3 个围绕 Zotero 与知网做工具链(harness-anything 2,435 星负责调用 Zotero/WPS/Office,cnki-skills 1,015 星负责检索知网并导出,zotero-skill 200 星负责整理分类),2 个做综述生成工作流(AI-Powered-Literature-Review-Skills 208 星走 8 阶段流程,Zotero-Analytical-Workflow-Skills 698 星做精读模板)。
实验复现 4 个则暴露了口径问题:paper-plot-skills(910 星)复现顶会论文图表,modelviz-skill(286 星)内置上百个数学建模绘图模板,Auto-Visio-Helper(251 星)把图转成可编辑的 Visio 文件,awesome-ai-agent-papers(1,865 星)是一份 2026 年 agent 论文清单——3 个做绘图,1 个是论文清单,没有一个做实验复现。
薄弱的原因不难推断:这两类必须接通外部系统(数据库、文献管理器、实验环境),工程量大、失败面广,不像写作类只要一份规则文档就能交付。
4.8 评审反馈(0 个)
全榜只有一个空类:评审反馈。分类表里给它留了位置,判定口径写得很清楚(peer review、审稿意见、critique、referee report),但至今没有一个项目满足收录条件。
最接近的是第 38 名 Spark-To-Paper-Skills/paperjury(1,212 星),做投稿前的模拟审稿压力测试,被归入论文写作类;它最近的 push 停在 2026 年 8 月,已被标记为 stale。
反过来说,这也是全榜最大的一块空白。
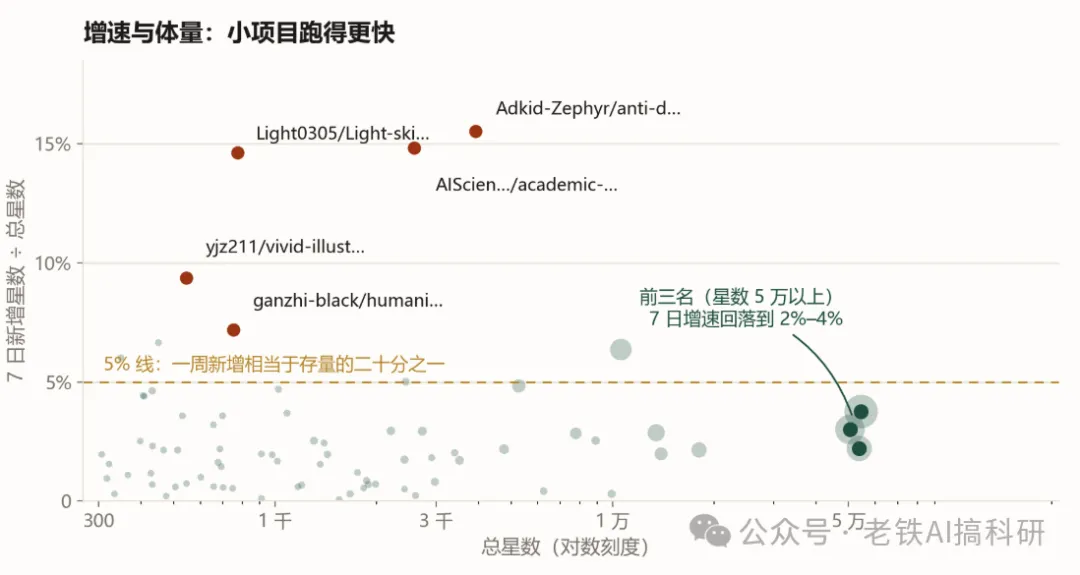
4.9 增速榜:一周涨得最快的 12 个
星数是存量,增速是当期注意力。按"7 日新增 ÷ 总星数"排序,取星数 300 以上的项目(下图气泡大小为 30 日新增星数,下表按同一比例排序;分类信息见前文各小节):
五、四个反常识结论
第一,数量与关注度倒挂,且原因不在"用户不识货"。 综合研究类以 44.3% 的项目数量拿到 18.2% 的星数,学科专项以 10.4% 的项目数量拿到 35.6%,中位数相差 13.9 倍(数据见上文图一)。
原因在于嵌入成本。通用技能难以嵌入具体学科的数据格式、术语体系与评价标准,一个"通用论文写作技能"能做的只是调整句式与结构,用户试用一次就发现它不懂自己的领域;而一个面向经济学识别策略的技能知道要跑 Stata、要报告聚类稳健标准误、要处理固定效应与样本选择。通用性带来的是可试用性,专业性才带来留存。
第二,增长最快的项目越来越轻。 7 日增速前两名是 Adkid-Zephyr/anti-defensive-writing-Skill(2 个技能文件,一周 +610 星,占存量 15.5%)与 AIScientists-Dev/academic-humanizer(1 个文件,+383 星,14.8%)。两者做的是同一件事:删除论文里的防御性表述与 AI 写作痕迹。
原因在交付成本。写作风格是规则问题——可枚举、可验证、不依赖任何外部数据管道,两个文件就能交付一个完整解决方案;而文献综述要接数据库、实验复现要跑环境,工程量大,注定跑不快。能被写成规则的问题,先被技能化。
第三,星数不等于技能数。 全榜 8,614 个 SKILL.md,其中 69% 集中在三个项目(Awesome-Journal-Skills 4,166 个、Auto-Empirical-Research-Skills 1,172 个、medical-research-skills 605 个)。15 个项目一个 SKILL.md 都没有,全榜技能数不足 5 个的项目共 70 个,约六成。
判断一个项目是不是真的技能库,看 SKILL.md 数量比看星数可靠:低于 5 个的,多半是单点脚本或资源清单。分类层面也有同类问题——实验复现一栏的 4 个项目,没有一个做实验复现。
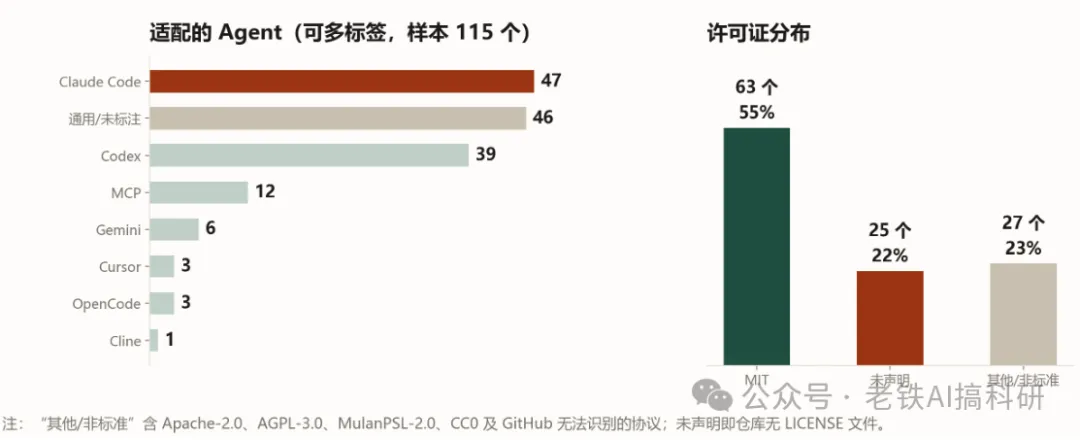
第四,生态是双极,许可证是隐患。 适配对象上,Claude Code 47 个、Codex 39 个、MCP 12 个、Gemini 6 个、Cursor 与 OpenCode 各 3 个,另有 46 个项目未标注。Claude Code 与 Codex 两极占绝对多数,其余平台基本是移植适配。
许可证分布更需要注意:MIT 63 个(55%),未声明 25 个(22%),其余为 Apache-2.0、AGPL-3.0、MulanPSL-2.0、CC0 或 GitHub 无法识别的协议。两成项目没有 LICENSE 文件,默认保留全部权利,直接搬进课题组或商业项目存在法律风险。
六、怎么用:三步与三条避坑
排名解决的是"先看哪个",不解决"该不该用"。所以使用方法压成三步,每一步都能在五分钟内做完。
三步选型。
第一步,定位。先确认自己卡在流程的哪一段:找不到文献,去"文献综述"与"深度研究";数据画不出、算不对,去"实验复现"与"学科专项";写不出来、改不下去,去"论文写作";投稿前想过一遍审稿人视角,目前只能自己拼。跨段跳选"综合研究",是最容易踩空的一步。
第二步,三看。SKILL.md 数量是否达到 5 个以上(低于此多半不是技能库);最近 30 天是否有 push(全榜只有 46 个满足);LICENSE 是否明确(MIT 或 Apache-2.0 可放心改)。
第三步,最小验证。拿一篇自己的旧稿跑一遍,观察它改动的是格式还是判断。只调整句式、分段、连接词的,价值有限;能指出论证跳跃、数据与结论不匹配、审稿人可能追问什么的,才是值得留下的。
三条避坑。
- 星数高不等于能用。第 8 名 9,935 星,
SKILL.md 为 0,买不到任何技能。 - 6 个项目已进入 stale 状态(30 天无 push 且 7 日零增长),其中包含 1,212 星的
paperjury——高星项目同样会停更。
还有一条针对文献类工具:全榜只有 2 个项目带引用核验标记。任何声称"自动综述"的工具,输出的参考文献都必须逐条核对 DOI,这是目前这套生态最确定的短板。
七、结语
做完这版榜,最大的收获不是排出名次,而是看清一件事:这个领域的真实产品逻辑,和"做一个大而全的 AI 科研平台"几乎相反。115 个项目里跑出来的,都是把某个环节钉死的窄工具;而宣称覆盖全流程的那一半,拿到的星不到两成。
三个判断留在这里,供后续验证:学科深度优于流程广度(13.9 倍的中位数差距);轻量单点优于全流程平台(增速前二都是 1–2 个文件的项目);评审环节是当前唯一的空白(0 个项目,而它决定论文命运)。
这份榜会继续每天更新,规则改动都会写进变更记录。本文所有数字取自 2026 年 10 月 25 日快照,星数是动态值,读者复核时会有偏差。
现在,我已将这个报告做成了网站,请大家加入我的知识星球获取链接。
觉得有用,点个"👍"“💗”,转给铁子们吧~我是老铁,下次见。