先说一个容易被标题带偏的地方:月之暗面目前并没有叫「Kimi 3 Pro」的模型。大家嘴里说的「Kimi 3 Pro」,官方全名是 Kimi K3.1 Pro。它不是新一代底座,而是 7 月发布的 Kimi K3 继续训练出来的版本。下文统一叫它 K3.1 Pro。
10 月 23 日(北京时间 24 日凌晨)发布后,这个模型在 Hacker News 上拿到约 850 分、将近 500 条评论(据 CGTN 统计),国内外媒体标题清一色是「逼近 Claude Opus 5.5」「价格只有一半」。这篇文章写给开发者,只想回答三个问题:它到底多少钱、跑分里哪些是真的强、拿来写代码能不能替掉 Opus 5.5。
本文所有数字都标了来源。「官方自报」指月之暗面自己跑、自己发的数;「第三方」指 Artificial Analysis、Arena 这类独立机构或个人测出来的数。两者别混着看。数据截至 2026 年 10 月 25 日。
一、先把基本信息理清楚
| | |
|---|
| | |
| 2026-10-23(北京时间 10-24 凌晨) | |
| K3 的后训练版本,底座没换,强化学习算力大幅增加 | |
| 总参数 2.8 万亿,每个 Token 激活约 1040 亿 | |
| MoE(混合专家),896 个专家里每次激活 16 个 | |
| | |
| | |
| | |
| 只能开着,分 low / high / max 三档,默认 max | |
| 还没放出 | |
几个词解释一下:
- MoE(混合专家):可以想成一家有 896 个专家的公司,每来一个活只叫最对口的 16 个人上班。所以它「脑子」很大,但每次推理只动一小部分,成本没有 2.8 万亿参数听起来那么吓人。
- 后训练:底座模型训好之后,再用强化学习一类的方法「补课」。K3.1 Pro 的提升几乎全来自这一步。
- 开放权重:把模型参数文件公开给大家下载。注意,它和「开源」不完全是一回事,K3 用的就是月之暗面自定义的许可证,对超大规模商用有附加条件(据 madrobot.blog)。
眼下最关键的一点:权重没发之前,K3.1 Pro 实际上就是一个只能走 API 的闭源模型,Artificial Analysis 页面上也暂时把它标成 Proprietary(专有)。媒体说的「全球最大开源模型」,目前还是一张期票。好在 K3 在 7 月是按时开放权重的,算有前科可查。
另外,就算权重放出来,个人也基本跑不动:MXFP4 量化后光权重就约 1.4 TB,月之暗面给 K3 的推荐配置是 64 卡以上的超节点。对绝大多数开发者来说,「开放权重」的实际意义是以后会有更多第三方云厂商提供它,价格可能被打下来,而不是自己在家部署。
二、价格:每个 Token 便宜一半,每个任务未必
API 标价
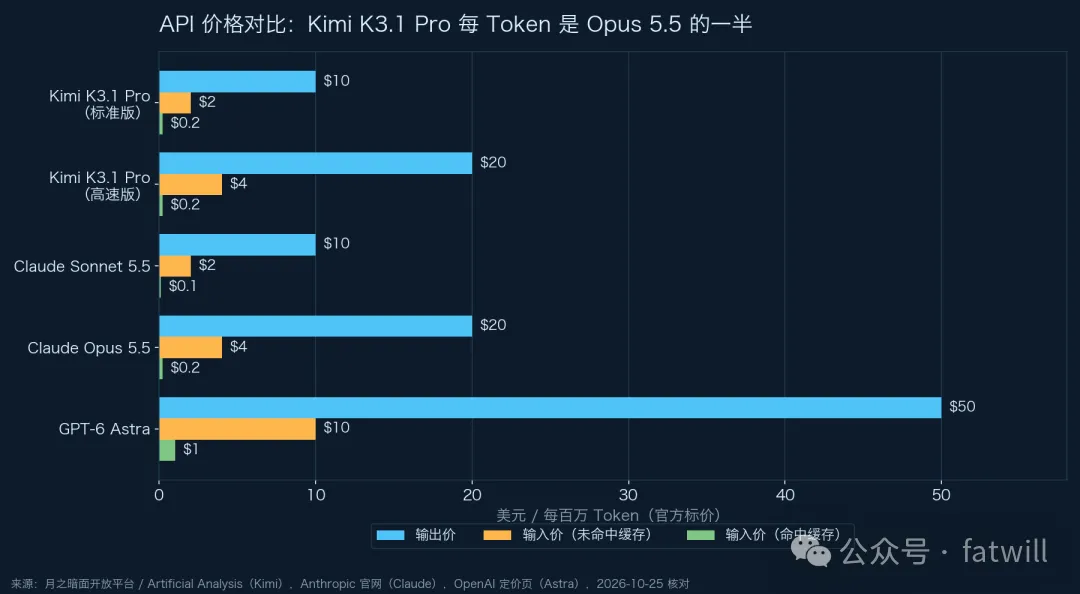
单位都是「美元(或人民币)/ 每百万 Token」。直接结论:
- 对 Opus 5.5:K3.1 Pro 输入输出都正好是一半,缓存命中价一样。
- 对 Sonnet 5.5:价格几乎一样,Sonnet 的缓存命中价还更低(10 月 7 日降到 $0.10)。
- 对上一代 K3($3 / $15 / $0.30):三项全部降了三分之一。
Highspeed 高速版是同一个模型,跑得快 2 到 3 倍,价格翻倍,刚好和 Opus 5.5 一样贵。
「按任务算」才是真账单
这里有个很多宣传图不提的坑:K3.1 Pro 话特别多。
Artificial Analysis 跑完它整套智能指数测试,K3.1 Pro 一共吐出约 1.5 亿个输出 Token,同类模型中位数只有 8700 万(来源)。结果是:Token 单价降了 33%,但每道题的平均成本是 $1.98 到 $2.11,和 K3 的 $2.00 基本持平。降价被「多想多写」吃掉了。
不过拿它跟 Opus 5.5 比,按任务算依然便宜不少:同一套测试,Opus 5.5(max 档)每题约 $5.98,K3.1 Pro 约 $2.11,差不多三分之一(据 Artificial Analysis 数据,Leader Menu 转引)。还有一个加分项:独立博主 Lex 实测,同样一段文字,Opus 的分词器要多用 1.47 到 1.65 倍的 Token(notesbylex),等于 Opus 实际还要更贵一点。
小结:比 Opus 5.5 便宜是真的,大约是一半到三分之一;比 K3 便宜基本是假的;和 Sonnet 5.5 比,价格上没优势。
订阅方案
如果你不走 API,而是用 Kimi Code(月之暗面的终端编程工具,类似 Claude Code):
- 官方文档写明:K3.1 Pro 需要 Plus / Moderato 及以上,Pro / Allegretto 及以上才能解锁 100 万上下文和 Highspeed(Kimi Code 更新日志)。
- 海外价格:Plus $19、Pro $39、Max $99、Ultra $199 每月,年付约八折。10 月 18 日起旧名 Moderato、Allegretto、Allegro、Vivace 改为老用户套餐名(GEO Toolbox 核对官方帮助中心)。
- 国内 Kimi Code 页面:Andante ¥49、Moderato ¥99、Allegretto ¥199、Allegro ¥699 每月(连续包月价,年付更低,见 kimi.com/code)。
对照组 Claude:Pro 约 $17 到 $20 每月,Max 从 $100 起(Finout)。
提醒一句额度问题:有 X 用户说 $100 档套餐的五小时额度二十分钟就用完;另一位 Hacker News 用户说 $99 档在单个会话 47 分钟内触顶(据 Vito Ruocco 汇总)。这只是个例,不是官方数据,但和「话多」这个特点对得上。
三、跑分:先看官方,再看第三方
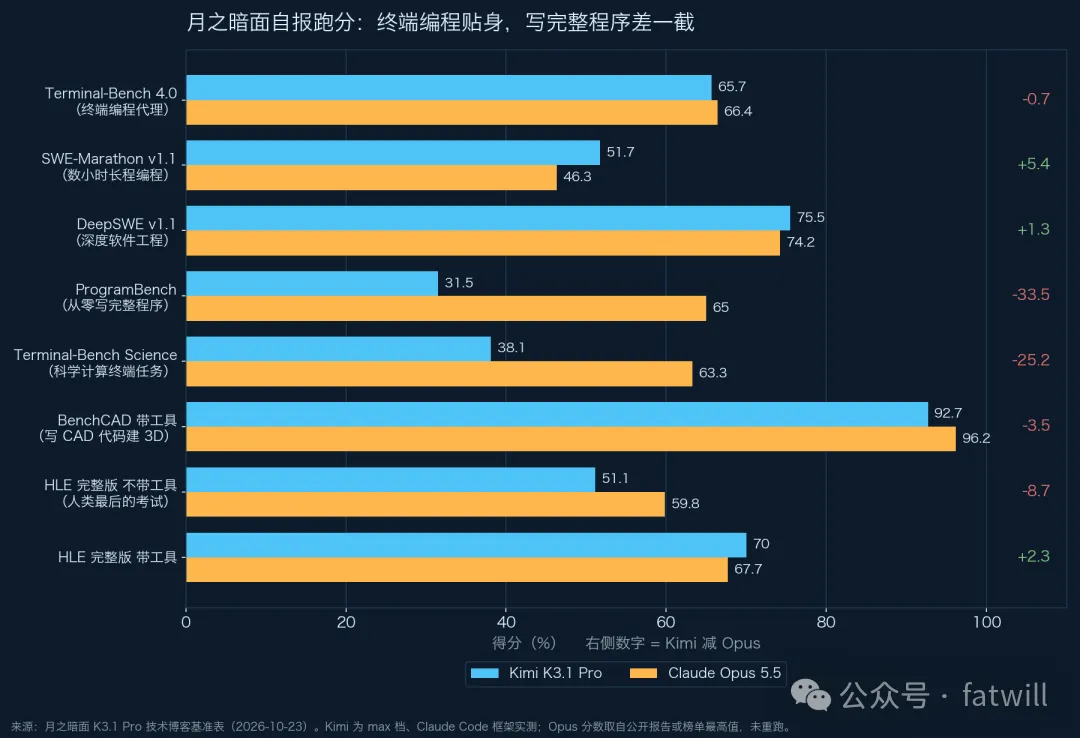
官方自报(月之暗面技术博客)
| | | | |
|---|
| | | | |
| | | | |
| | | | |
| | | | Opus +33.5 |
| Terminal-Bench Science 0.1 | | | | Opus +25.2 |
| | | | |
| | | | |
| | | | |
| | | | Opus +21.5 |
| | | | |
| | | | |
| | | | |
| | | | |
| | | | |
数据来源:月之暗面 K3.1 Pro 技术博客,由 The Decoder 转载整理,以及 aihubmix、notesbylex 的逐项摘录。
有人数过,月之暗面完整的表里一共 47 项,K3.1 Pro 拿了 16 项第一;但这 16 项里有 11 项至少一个对手没有分数,还有 3 项是月之暗面自己出的内部基准(据 notesbylex)。
你可能想找但找不到的数
用户最常问的 SWE-bench Verified 和 LiveCodeBench,月之暗面这次的官方表里都没有。我查了几个基准汇总站,K3.1 Pro 在这两项上都是空白(例如 AI Release Tracker)。网上有篇「架构拆解」文章给了 SWE-bench Verified 48.6%,但没有给出任何来源和测试设置,我不采用。
你可能在别处看到「Kimi K3 SWE-bench Verified 93.4%、LiveCodeBench 87.2%」,那是上一代 K3 的数,不能直接套到 K3.1 Pro 头上。月之暗面这次换成了 Terminal-Bench 4.0、SWE-Marathon 这批更新的基准,而且 Terminal-Bench 这类基准版本之间不可比(K3 时代报的 88.3 是 2.1 版,和 4.0 版的 65.7 不是一回事)。
第三方 / 独立测试
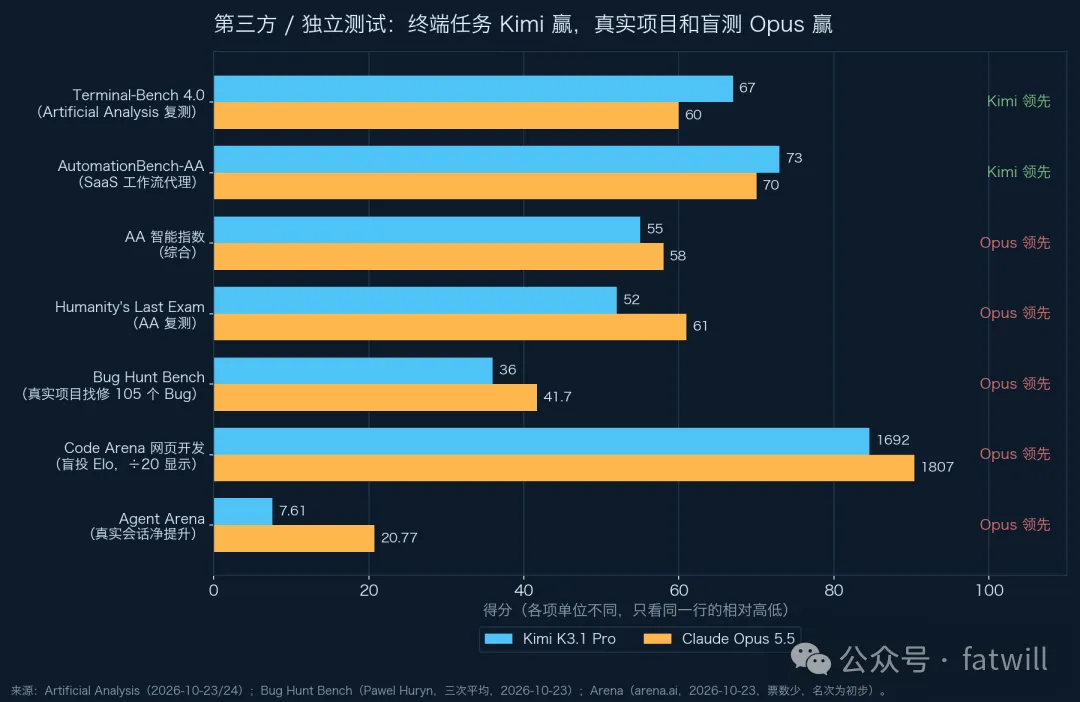
Artificial Analysis(独立评测机构,自己重跑所有模型):
- 智能指数 55 分,215 个模型里排第 4,前面是 Opus 5.5(58)、Sonnet 5.5(56)、Meta 的 Muse Wonder Full(56)。比 K3 的 44 分涨了 11 分(来源)。
- Terminal-Bench 4.0 测得 67%,是它测过的所有模型里最高的,同一套测试下 Opus 5.5(max)是 60%,Sonnet 5.5 是 64%。
- AutomationBench-AA(SaaS 软件里的代理工作流)73%,Opus 5.5 是 70%。
- 但 Humanity's Last Exam 只有 52%,Opus 5.5 是 61%;CritPt 物理推理 25% 对 32%(据 The Beat)。
- 分行业指数(金融、法律、工程等 6 项)Opus 5.5 全部领先,差距 3 到 7 分(据 GPTunneL 整理的 AA 数据)。
- 幻觉:AA-Omniscience 测试里,「不会却硬答」的比例从 K3 的 53% 降到 44%。月之暗面自己说的「幻觉降低 65%」(23.4% 降到 8.3%)是内部压力测试,官方也注明它不代表日常使用的错误率。
- 速度:每秒约 73.5 个输出 Token,在 186 个模型里排中游偏后。
Arena(真人盲投,两个匿名回答选一个更好的):
- Code Arena 网页开发榜 第 8 名,1692 分,和 Claude Opus 5(上一代)的 1691 几乎打平。榜首是 Opus 5.5,1807 分。
- Agent Arena(真实代理会话,看任务有没有完成、用户满不满意)第 11 名,净提升 +7.61%,Opus 5.5 是 +20.77%。
- 票数只有几百张,名次还不稳定(据 GPTunneL 整理的 arena.ai 数据)。
国内有媒体写「代码榜 1692 分超过 Claude Opus 5」,数字没错,但那是上一代 Opus 5,不是 Opus 5.5。这种写法很容易让人看岔。
Bug Hunt Bench(独立博主 Pawel Huryn,在两个真实生产项目里埋了 105 个 Bug,测试不报红,没有提示):
- K3.1 Pro(max 档,同样用 Claude Code 跑,和官方条件一致):三次平均修好 36 个,三次分别是 36、42、30,波动很大。
- Opus 5.5(max):41.7 个;Opus 5.5(xhigh):36 个。
- 更扎心的是开放权重的 DeepSeek V4.1 Flash 修了 42.7 个,花费只有 K3.1 Pro 的约七分之一。
- 还有一次在约 12.8 万 Token 上下文时,K3.1 Pro 的思考和输出开始胡言乱语,3.9 分钟后什么都没改就结束了,API 也没报错。
以上 Bug Hunt Bench 数据来自 GPTunneL 的转述,原作者在 X 上发布。
四、长处和短处
长处
- 性价比(对 Opus 而言):Token 单价一半,按 AA 的任务成本算大约三分之一。网友做 3D 小游戏的案例,10 小时、400 万 Token 花了约 52 美元(钱江晚报),属于个例,但方向和第三方数据一致。
- 长时间的代理式编程:Terminal-Bench 4.0 官方和 AA 都测出了和 Opus 同档的成绩,SWE-Marathon 领先。说白了,就是把它丢进终端让它自己折腾几个小时,它能坚持住。
- 前端、3D、游戏引擎:会写 Blender 和 CAD 脚本,会用 Unity、Unreal、Godot,Three.js 单文件演示效果不错。社区里一个「体素宝塔岛」的对比,Kimi 花 $5.71,Opus 花 $17.13,效果 Opus 细节略多(据 Vito Ruocco)。
- 金融和办公文档:OfficeQA Pro v2 官方报第一,AA 的 GDPval-AA 排第三,只比 Opus 5.5 少 20 分。
- 长上下文:100 万 Token,而且不按长度加价(GPT-6 Astra 超过 27.2 万 Token 整单涨价)。
- 中文:作为国产模型,中文写作和中文语境理解是它的传统强项;国内直连、支付宝微信付款,对国内团队省事。这一点我没找到专门的第三方中文基准,算体验层面的优势,不算有数字支撑。
- 可预期的「开放」:如果 11 月 4 日权重如期发布,对数据不能出境、需要私有化的团队,它会是能力最强的选择。
短处
- 偏科明显:从零写完整程序(ProgramBench)只有 Opus 的一半,科学计算终端任务落后 25 分,清洗过的 HLE-Diamond 落后 21.5 分。社区有人直接说它是「尖刺型」模型:演示好看的地方(前端、3D)强,别的地方弱(GPTunneL)。
- 话多、慢:输出 Token 是中位数的 1.7 倍,速度中游偏后,订阅额度消耗快。
- 稳定性:Bug Hunt Bench 三次结果差 12 个,还出现过长上下文崩坏;发布当天 API 多次返回 429「引擎过载」(ap7i)。
- 调用限制多:思考模式不能关,关了直接报 400;温度固定 1.0、top_p 固定 0.95,改了会报错;多轮对话要把完整的 assistant 消息(含思考内容)回传,否则输出可能不稳(Piyush Mehta)。从别家模型平滑切过来,要改代码。
- 数据去向:权重放出前只能用官方 API,国际版隐私政策写的是新加坡服务器(VentureBeat)。
- 故意削弱的安全能力:为了开放权重,月之暗面主动删掉了网络攻防相关训练数据,内部漏洞利用测试从 90.5% 降到 81.0%;ExploitBench 上 74.7 对 Opus 的 91.0。对一般开发者无所谓,对做安全研究的团队是短板(这个决定本身我觉得挺负责任)。
五、核查:「编程逼近 Opus 5.5」到底怎么回事
这句话从哪来
源头有三层:
- 官方技术博客那张跑分表:Terminal-Bench 4.0 上 65.7 对 66.4,只差 0.7 分,这是「逼近」最直接的出处。
- Artificial Analysis 的发布当天通报:智能指数第 4、离 Opus 5.5 只差 3 分、Terminal-Bench 4.0 测出全场最高的 67%。
- 媒体和社交平台标题:「Claude Opus 5.5 怕了」「性能强悍到海外刷屏」一类。还有一层得说清楚:VentureBeat 报道,有截图显示月之暗面的推广方给博主的稿件要求里写着「请不要加付费合作标签」,建议话术包括「中国刚刚让 Opus 5.5 人人都能免费用」。截图未经核实,出自谁也不清楚,月之暗面截至 10 月 25 日没有回应(VentureBeat、explainx)。所以看到「免费 Opus」这种说法,先打个问号:权重没发,API 也不免费。
测试条件对不对等
这是最容易被忽略的部分。我把官方脚注逐条看了一遍(OpenLM.ai 转载的脚注全文):
- 思考档位:K3.1 Pro 全部用 max 档。对手也说是「各自最高档」,这一点基本对等。
- 测试框架(scaffold):K3.1 Pro 的几乎所有编程分数都是在 Claude Code(Anthropic 自家的编程代理)里跑的。打个比方,框架就像赛车的底盘和变速箱,同一个发动机换个底盘,圈速会差很多。所以这些分数只代表「在 Claude Code 里的表现」,换到 Kimi Code、Cursor 或者你自己的代理里,结果可能更好也可能更差。
- 对手分数不是重跑的:Opus、GPT 这些对手的分数,取的是它们自家技术报告或官方榜单上「报过的最高值」,不是月之暗面在同一环境里重新跑的。脚注还写了「闭源模型测试可能包含降级(fallback)行为」。也就是说,表里每一行左右两边,很可能不是同一套跑法。
- 同一个基准,不同人测结果不一样:Terminal-Bench 4.0 上,官方表是 Kimi 65.7 输给 Opus 66.4;AA 自己测是 Kimi 67 赢 Opus 60。两份数据结论相反,差的就是框架和设置。
- 部分基准是自己出的:Kimi Code Bench 2.0、3.0 是月之暗面内部基准,自己出题自己考。
好的一面是:AA 用自己的框架重跑后,Terminal-Bench 分数不降反升,说明官方这个最核心的数没有灌水。这在厂商自报数据里不常见。
跑分和实际项目可能差在哪
- 任务类型:Terminal-Bench 测的是「在终端里把一个明确的小任务做完」。真实项目里大量工作是读懂一个几万行的陌生仓库、找出一个测试不报错的隐藏 Bug,这正是 Bug Hunt Bench 测的东西,K3.1 Pro 在这里比 Opus 5.5(max)少修 5.7 个,还不如 DeepSeek V4.1 Flash。
- 长上下文下的稳定性:跑分的单个任务通常不长,真实会话动辄几十万 Token,那次 12.8 万 Token 崩坏就是例子。
- 真人体验:Agent Arena 是真人在真实会话里打分,K3.1 Pro 第 11,净提升只有 Opus 5.5 的三分之一多一点。
- 账单:跑分不显示你要多付多少重试和返工。话多加上偶尔翻车,按「完成一个任务」算的成本,差距会比标价表上的一半小。
结论
「编程逼近 Opus 5.5」这话说对了一半。
在终端里的代理式编程、长程编程任务上,逼近是真的,而且有第三方复测撑腰,甚至可以说打平。但在从零写完整程序、科学计算、真实项目找修 Bug、真人盲测这些更接近日常开发的维度上,Opus 5.5 仍然明显领先,差距不是「逼近」两个字能概括的。官方表的对比条件也不完全对等(框架是 Claude Code、对手分数是抄来的最高值),所以「逼近」只能理解成「在月之暗面挑选的那几项基准上接近」,不能理解成「拿来写代码和 Opus 5.5 一样好」。
六、选型建议
用 K3.1 Pro 比较划算的场景:
- 跑长时间、自动化的终端编程代理,而且预算敏感。比如批量改脚本、迁移配置、做工程脚手架。
- 前端页面、Three.js 演示、3D 建模脚本、小游戏原型。
- 国内团队,需要直连、人民币付款,或者计划等权重放出后私有化部署。
- 作为「第二模型」:主力用 Opus 或 Sonnet,把量大、可以重试的活路由给 K3.1 Pro。
还是 Opus 5.5 更合适的场景:
- 大型陌生仓库里的排错、重构、代码审查,错一次的代价比 Token 贵。
- 安全研究、漏洞分析(K3.1 Pro 的开放版本是刻意削弱过的)。
另外两个提醒:
- 如果你本来就在用 Sonnet 5.5,换 K3.1 Pro 价格上不省钱,AA 指数上 Sonnet 还高 1 分,没必要为了「便宜」切过去,先在自己的任务上对比。
- 最靠谱的评估方法,是社区总结的「四个数」:拿自己仓库里固定的一组任务,记一次通过率、重试次数、Token 账单、人工返工时间(什么值得买社区)。11 月 4 日权重放出、第三方托管上线后再跑一遍,这几个数比任何榜单都有用。
总结
Kimi K3.1 Pro(也就是大家说的「Kimi 3 Pro」)是目前离闭源第一梯队最近的「准开放权重」模型:Artificial Analysis 综合第 4、终端编程测试第一、价格是 Opus 5.5 的一半。这些都是真的。
但「编程逼近 Opus 5.5」只在一部分基准上成立。真实项目找 Bug、写完整程序、真人盲测这几项,它都还落后一截;而且它话多、偶尔不稳,便宜的幅度按任务算会打折扣。把它当成 Opus 的便宜平替会失望,当成一个在特定任务上很能打的高性价比选手,会很满意。
参考链接
- Artificial Analysis:Kimi K3.1 Pro 发布评测
- Artificial Analysis:Kimi K3.1 Pro 模型页
- Kimi Code 更新日志(官方,含会员与思考模式说明)
- Tech Insider:官方基准表(含 Opus 5.5 对比)
- GPTunneL:独立测试汇总(Arena、Bug Hunt Bench、StealthMark)
- Vito Ruocco:Kimi K3.1 Pro vs Opus 5.5 真实账单
- Anthropic:Claude Opus 5.5 官方页面与定价
- VentureBeat:K3.1 Pro 与付费推广争议
- CGTN:Hacker News 讨论与 OrcaRouter 提醒
📖 本文同步发布于博客:https://fatwill.cn/articles/341888f6-9fdb-4845-9977-a1df3dfa9343
欢迎关注公众号,获取更多技术分享 🎉