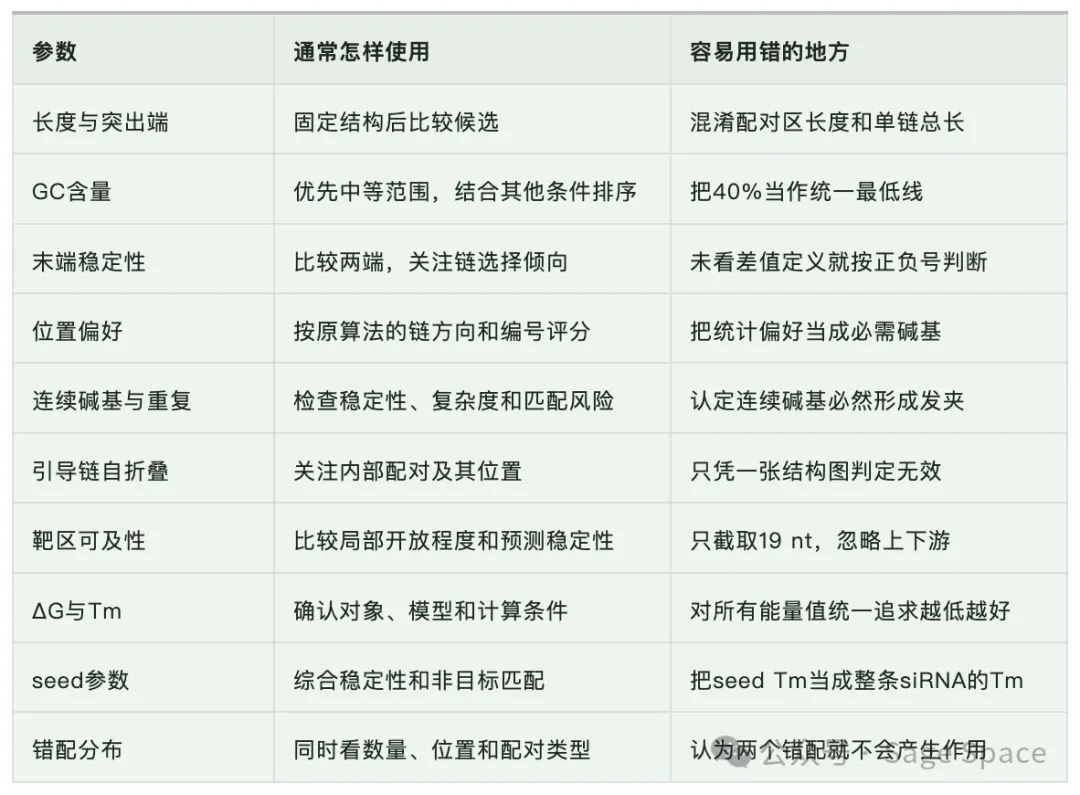
同一段mRNA上,可以选出很多条与目标完全互补的siRNA候选。但做过筛选就会发现,它们的效果可能差得很远。
设计软件通常会给出GC含量、末端稳定性、二级结构、自由能和脱靶评分。有的候选GC合适,却被结构筛选排除了;有的整体评分不错,seed相关风险又比较高。
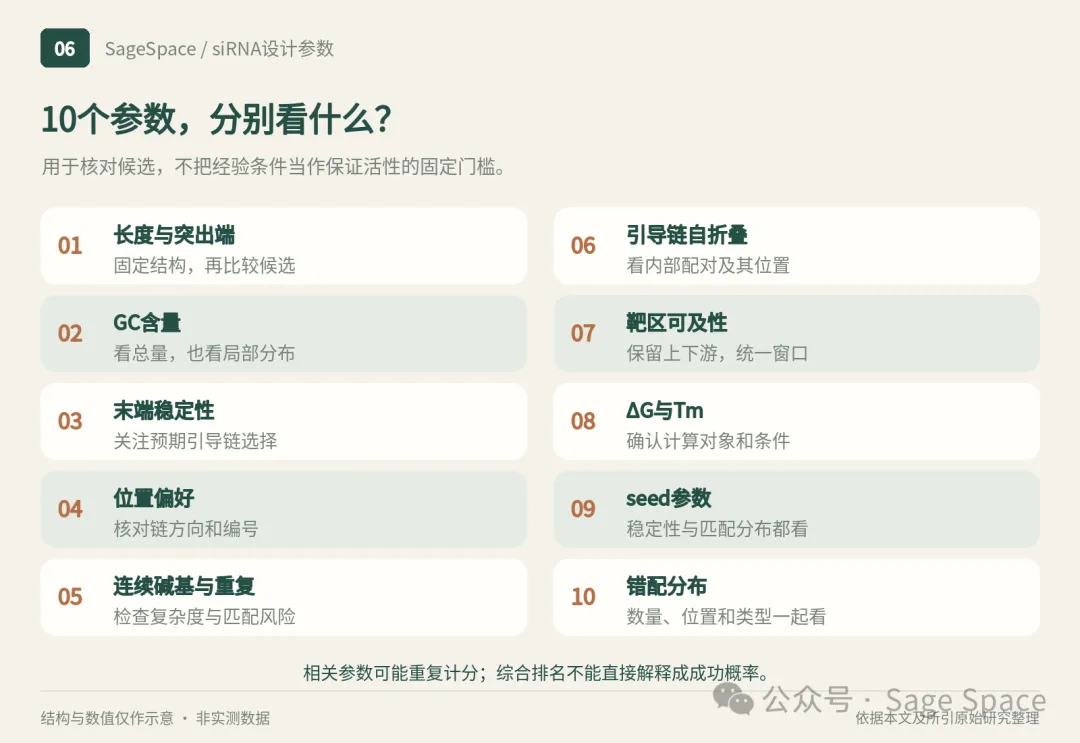
这些参数分别在检查什么?为什么这样筛?数值越高越好,还是越低越好?
这篇集中讨论常规合成siRNA的序列选择。默认目标序列已经确认,直接从长度、碱基组成和结构讲起。
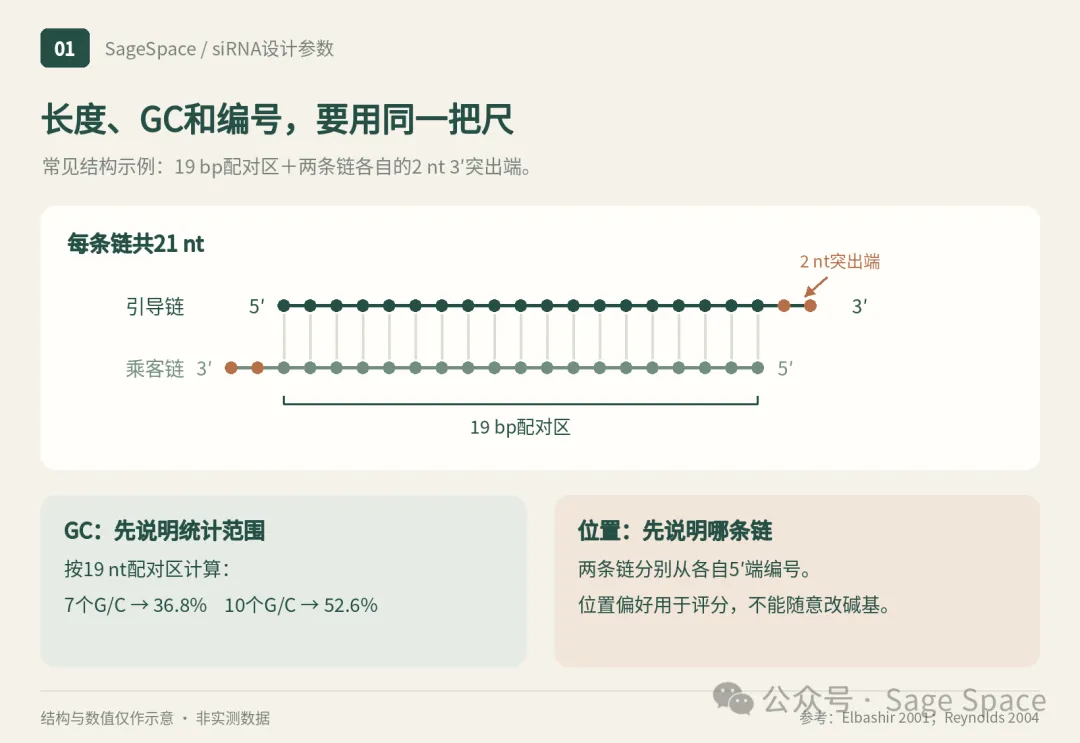
文中的引导链,指预期识别目标RNA的反义链;另一条为乘客链。涉及位置编号时,均从相应链的5′端开始。
01|长度:为什么常见的是19 bp双链区?
常见的siRNA由19 bp配对区和两条链各自的2 nt 3′突出端组成,因此每条链总长为21 nt。
19 bp描述两条链之间的配对长度,21 nt描述一条链的总长度。订购表里的“19 nt+dTdT”,通常对应这一类结构。
这种长度与RNA干扰通路对短双链RNA的识别和装载相适应。早期研究已经证明,21 nt siRNA双链能够在哺乳动物细胞中介导序列特异性的基因沉默。[1]
既然需要与目标互补,为什么不直接做得更长?
因为长度增加时,变化的不只是结合强度,还包括双链的加工方式,以及最终进入RISC的RNA产物。
常规短siRNA可以在不依赖Dicer进一步切割的情况下发挥作用。更长的Dicer底物RNA,则需要考虑加工后的链长和末端。研究中确实有25–30 nt的Dicer底物方案,部分表现优于对应的传统siRNA,但不能把任何19 nt候选简单延长,就认为活性会提高。[2]
因此,比较候选之前,应固定分子结构。传统短siRNA、非对称双链和Dicer底物,可以采用不同的设计规则,不宜放进同一张评分表直接排名。
突出端也需要保留原有定义。dTdT是两个脱氧胸苷,UU是两个尿苷,不能把它们当作无关紧要的尾巴随意替换。
02|GC含量:为什么通常优先选中等GC?
GC含量的计算很简单:
GC含量=G和C的数量÷所统计的序列长度×100%。
对于19 nt配对区:
7个G/C,约为36.8%;
8个G/C,约为42.1%;
10个G/C,约为52.6%。
计算时应说明统计的是配对区,还是包含突出端的完整链。否则,同一条siRNA也可能得到不同的GC百分比。
GC组成会影响RNA双链的稳定性。这种影响还涉及相邻碱基的堆积,不能只用GC和AU的氢键数量解释全部差异。
GC较高的序列可能形成较稳定的双链或局部结构,影响链选择、结构重排及靶区接近。GC很低时,则需要评估配对稳定性、序列复杂度等条件。
Reynolds等人的经典研究,将30%–52%的GC含量列为有利评分条件之一。[3] 因此,40%并不是所有siRNA共同的最低合格线。
实际筛选中,可以优先考虑中等GC的候选,但不必因为36.8%低于40%就将其删除;52.6%略高于某套经验范围,也不能直接判定无效。
GC适合用于初筛,不能单独决定一条序列的去留。
尤其不要为了凑到某个百分比,主动改掉原本与目标匹配的碱基。
03|末端不对称性:同样的GC,为什么效果可能不同?
假设两条siRNA的GC都是42.1%。
第一条的GC主要分布在引导链中后段,引导链5′端附近相对富含A/U;第二条恰好相反,GC集中在引导链5′端附近。
总GC相同,双链两端的稳定性却可能不同。
siRNA装载时,两条链成为引导链的机会会受到末端结构影响。经典研究发现,两个5′端附近配对的绝对稳定性和相对稳定性,都与链选择有关。[4]
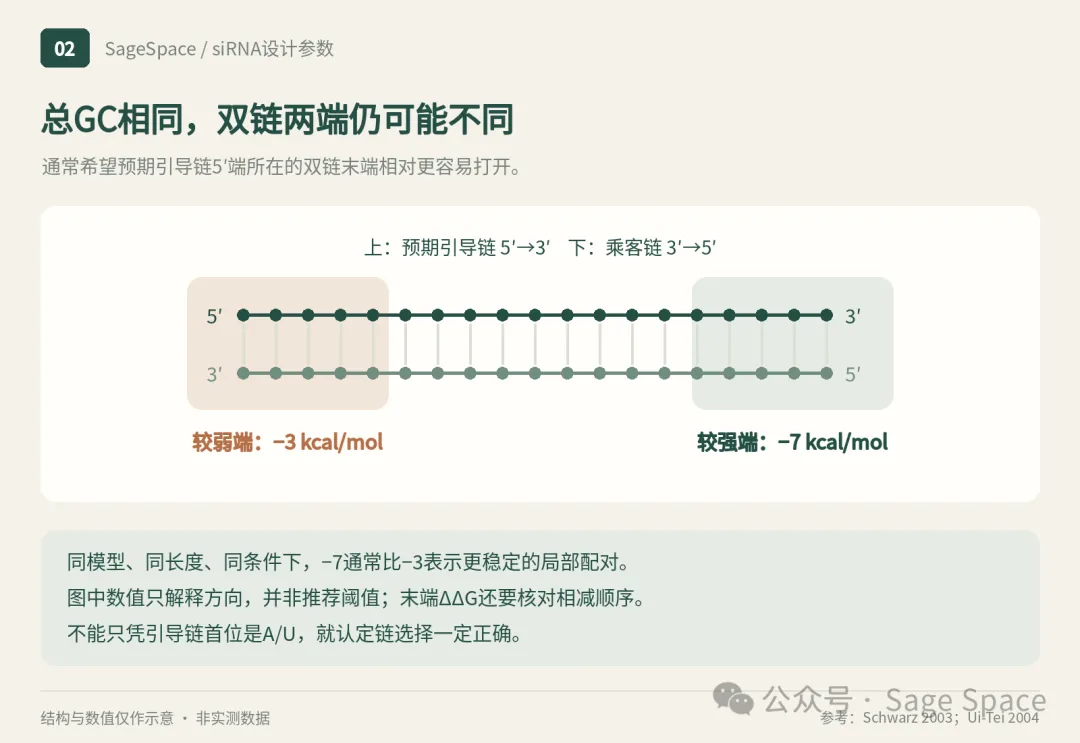
常规设计通常希望:预期引导链5′端所在的双链末端,相对更容易打开。
这里比较的是双链的两个物理末端。引导链5′端所在的一端,同时对应乘客链的3′端。不能把两条链都按5′→3′从左到右排列后,直接比较图上的左侧。
软件可能计算末端若干碱基对的自由能。例如,在相同条件下,一端为−3 kcal/mol,另一端为−7 kcal/mol,后者形成配对在热力学上更有利。
如果−3 kcal/mol对应预期引导链的5′端,这种相对差异可能更符合常见的链选择偏好。
这只是解释数值方向的假设例子,并非推荐阈值。计算3个、4个或更多末端碱基对,结果不能直接混用。
不同软件还可能采用相反的差值定义。看到末端ΔΔG为正或为负,需要核对它减的是哪一端,不能只记一个符号。
04|位置偏好:为什么某一位最好是A或U?
不少算法会检查特定位置的碱基。
例如Ui-Tei等人的规则,包括反义链5′端为A/U、正义链5′端为G/C,以及反义链5′端区域相对富含A/U。[5] 这些条件与末端稳定性和链选择存在联系。
另一些条件来自对候选活性的统计分析。例如Reynolds规则中包含正义链第3位、第19位偏好A,第10位偏好U等条件。[3]
使用时,有两个地方容易出错。
一个是链方向。
正义链第19位和反义链第19位,指向的不是同一个位置。检查参数表时,需要同时确认链方向、编号起点,以及是否包含突出端。
另一个是把统计偏好当成必需条件。
某个位点偏好A,表示它在特定研究数据中与较高活性相关,不能推导出该位点为G的siRNA一定无效。不同位置的偏好,也未必都已有明确、独立的机制解释。
这类参数更适合参与综合评分。把几套算法的全部偏好拼在一起,要求候选同时满足所有条件,可能会筛掉值得测试的序列。
如果某个位点不符合偏好,可以换一个靶位点寻找候选,而不是直接改碱基,制造与目标RNA的错配。
05|连续碱基和重复序列:为什么经常被过滤?
AAAA、GGGG、反复出现的AU或GC,往往会在设计软件中被标记。
这些情况需要分别判断。
连续G/C或局部GC富集,可能使某段配对特别稳定。简单重复和低复杂度序列,则可能在多个RNA中出现相似片段,增加特异性筛查的困难。
但连续相同碱基,并不会自动形成稳定发夹。
例如,一段GGGG还需要与序列中的其他区域形成合适的内部配对,才可能构成发夹的一部分。反过来,没有连续相同碱基的序列,也可能具有较强自互补。
因此,连续碱基过滤和二级结构预测应分别进行。
一些流程把连续4个相同碱基设为排除条件,也有规则使用不同阈值。这些可以作为缩小候选范围的经验设置,但不能统一解释为一旦超过就必然失效。
如果序列后续还要用于U6等RNA聚合酶III启动子驱动的shRNA,需要额外考虑连续T序列带来的提前终止风险。这个原因适用于相应表达体系,不能直接拿来解释化学合成siRNA中的连续U为何无效。
06|siRNA自身的二级结构:为什么要检查自互补?
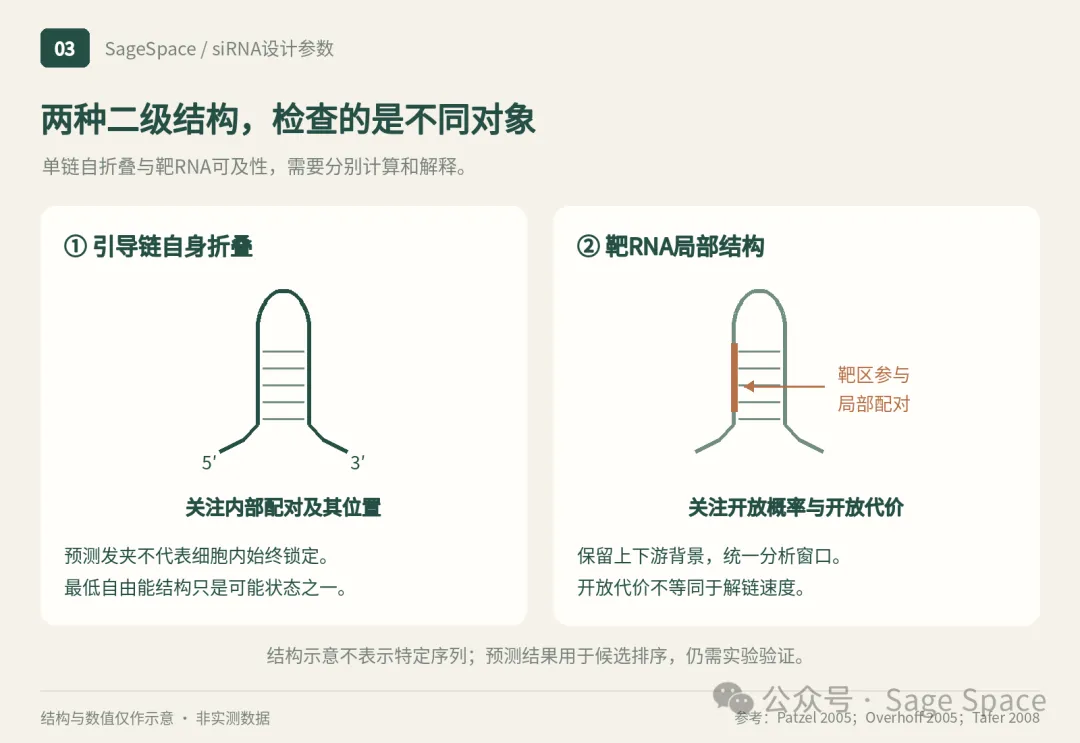
siRNA两条链之间需要形成互补双链。设计中检查的自互补,主要指一条链内部的不同片段能否互相配对。
例如,引导链前端与后端存在较强互补,就可能形成内部茎环结构。
Patzel等人的研究观察到,在其测试体系中,引导链较强的二级结构形成倾向与较低沉默活性相关,末端参与内部配对的结构尤其值得注意。[6]
不过,游离RNA单链的折叠预测,无法完整还原它在RISC中的状态。siRNA装载、乘客链去除,以及引导链与蛋白结合,都可能改变结构。
不能把一张预测发夹图,直接解释为引导链在细胞内始终被锁住。
查看结构结果时,可以关注:
是否存在较长、较稳定的内部配对;
5′端或seed区域是否参与配对;
最低自由能结构是否具有代表性;
是否还存在概率较高的其他构象。
RNAfold等工具既能输出最低自由能结构,也能计算结构集合及碱基配对概率。最低自由能结构只是模型给出的一个状态,其他近似稳定的构象也可能存在。
输入和参数也要统一。如果使用普通RNA模型,dTdT和化学修饰不能都按未修饰RNA直接处理。缺少相应热力学参数时,计算结果只能作为近似参考。
对于自折叠ΔG,也没有适用于所有链长、软件和修饰体系的统一淘汰线。候选间比较,比脱离条件记住一个阈值更有意义。
07|靶RNA二级结构:完全互补,为什么还可能不好结合?
上一节检查siRNA自身,这一节需要看目标RNA。
如果靶序列已经与上下游RNA形成稳定配对,引导链识别它时,就可能需要伴随局部结构重排。即使序列完全互补,也可能因靶区可及性不同而出现活性差异。
Overhoff等人的研究通过结构分析和实验,观察到局部靶区可及性对siRNA活性的影响。[7] 后续RNAxs相关研究,也将可及性用于候选筛选。[8]
这部分可以看两个参数。
未配对概率。
它描述某个碱基或一段连续碱基,在预测结构集合中处于未配对状态的概率。
需要区分各个碱基平均的未配对概率,以及整段区域同时未配对的概率。两者是不同的统计量,不能直接替换。
开放代价。
一些算法会把未配对概率转换成能量形式,描述目标区域处于开放状态的热力学代价。在相同计算条件下,代价较低的区域通常更容易处于可接近状态。
但它不是实验测出的解链速度,也不是RISC需要消耗多少ATP。RNAplfold的文档还特别说明,其相关输出不能简单理解为展开该区域所需的平均能量。
预测时,也不能只截取靶点的19 nt单独折叠,因为这段序列可能与更远的上下游区域配对。
分析窗口、允许的最大配对跨度和温度,都会影响结果。比较候选时,应使用一致设置;如果更换窗口后排名变化很大,也应记录这种不确定性。
细胞内的RNA还会受到蛋白结合、翻译活动等因素影响。因此,可及性预测适合辅助排序,不宜仅凭一张结构图决定候选必然有效或无效。
08|ΔG和Tm:为什么不能统一追求越低或越高?
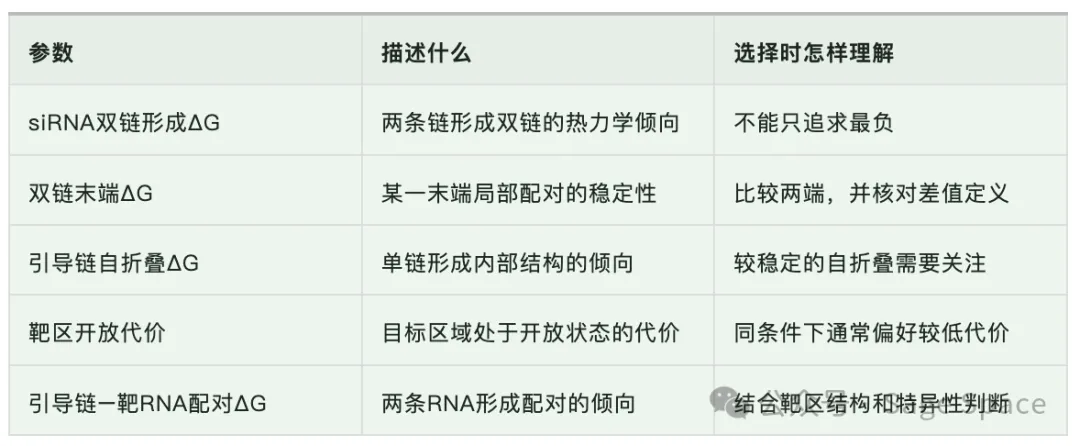
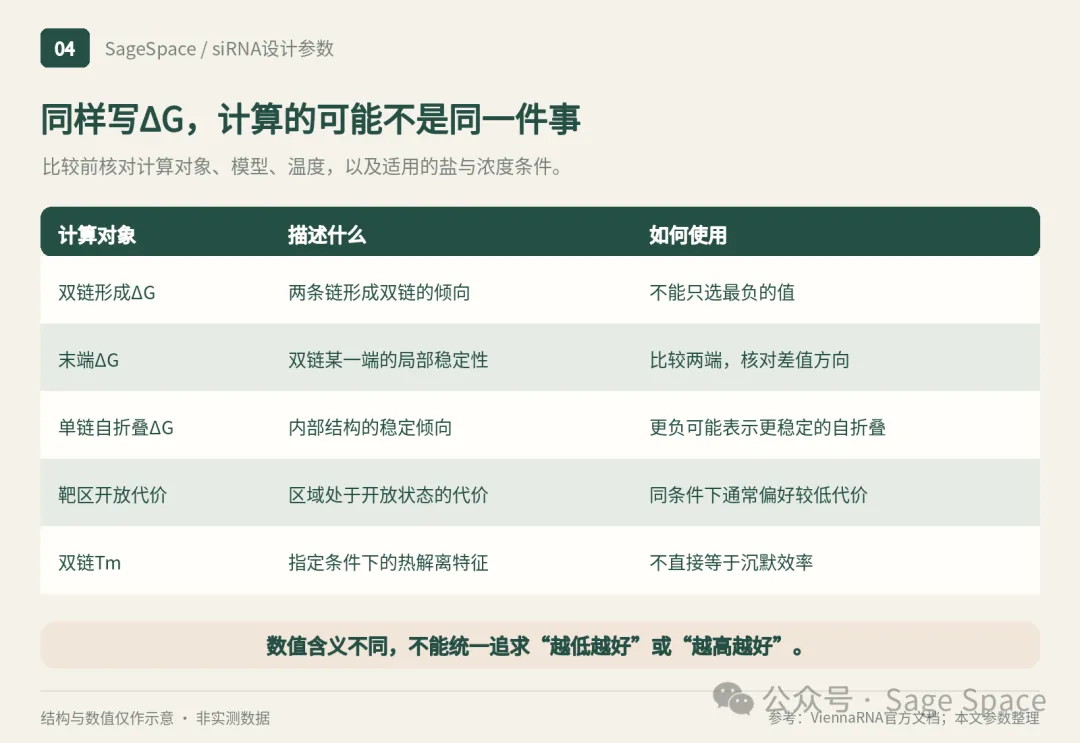
设计结果里,可能同时出现好几个ΔG。它们虽然都以自由能表示,却描述不同过程。
对于形成配对或折叠的过程,在同一模型和条件下,ΔG越负,通常表示该过程在热力学上越有利。
因此,自折叠ΔG为−8 kcal/mol,并不会因为比−2 kcal/mol更低,就自动成为更好的候选。它可能意味着更稳定的内部结构。
Tm描述热解离特征。对于常见双链两态模型,它对应一定浓度和溶液条件下约一半双链解离的温度。Tm较高通常提示该条件下双链更耐热,但不能直接换算成细胞中的沉默效率。
比较前需要确认:算的是谁,使用什么模型,温度、盐条件和链浓度是否一致。
对经过修饰的siRNA,如果软件仍采用未修饰RNA参数,得到的数值不能当作实际分子的精确热力学性质。
09|seed稳定性:只有7个碱基,为什么也要单独计算?
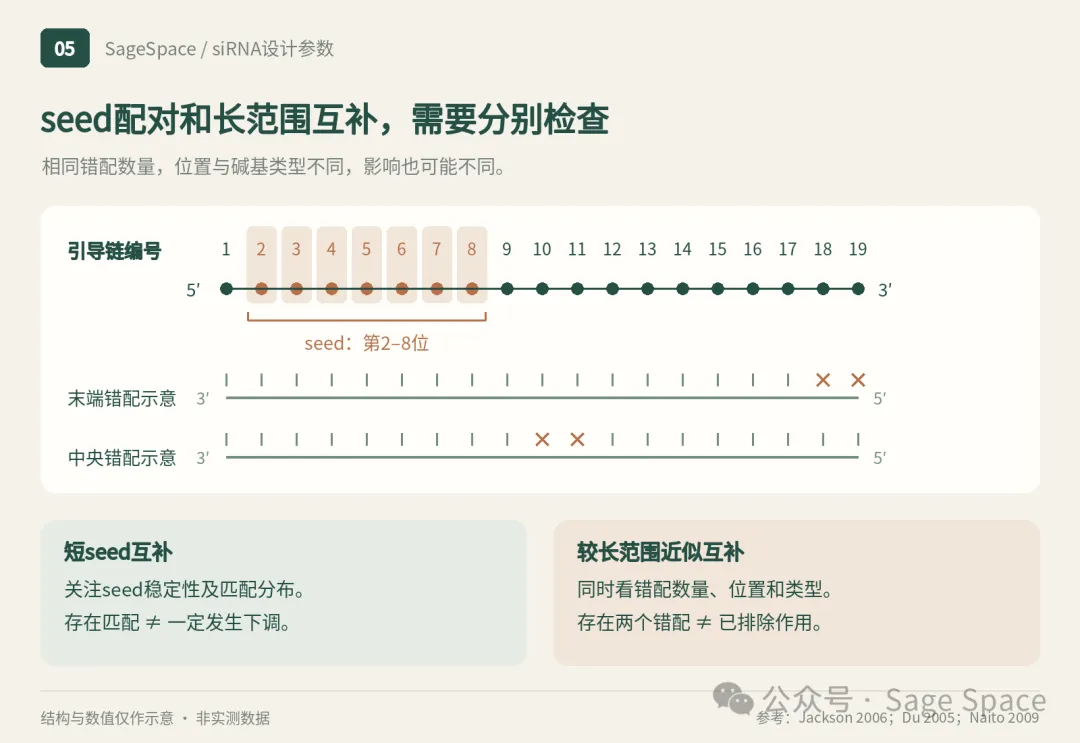
引导链5′端第2–8位通常被称为seed区域。
它参与目标识别,也可能与其他RNA的局部序列配对,产生类似miRNA的非目标调控。
Jackson等人的研究发现,很多被siRNA非预期下调的转录本,其3′UTR与引导链seed存在互补。[9] 因此,整条siRNA没有明显的近乎完全匹配,也不能排除seed相关作用。
设计中可以检查seed的碱基组成、与互补序列形成双链的稳定性,以及非目标RNA中互补位点的分布。乘客链如果参与装载,其seed也可能带来风险。
siDirect 2.0采用过seed–靶序列双链Tm低于21.5℃的筛选条件,以降低seed依赖的非目标沉默风险。[10]
这个参数有三个容易误读的地方。
首先,21.5℃指该算法条件下计算的seed双链Tm,不是完整siRNA的Tm。
其次,短seed在转录组中出现互补位点很常见,不能要求每条候选的seed都完全找不到匹配。
另外,低seed Tm和低命中次数是不同指标。某个seed即使形成配对较弱,也可能在许多转录本中出现互补位点。
seed参数可以帮助降低风险,不能单独证明没有脱靶。
10|错配数量和位置:差2个碱基,就一定不会作用吗?
假设两条非目标RNA与siRNA都存在两个错配。
第一条的错配集中在引导链3′端附近;第二条的错配位于中央区域。数量相同,配对方式和对切割的影响却可能不同。
Ago2介导的典型切割,发生在靶RNA上与引导链第10、11位相对的位置之间。中央区域的配对有助于形成适合切割的构象,因此这一带的错配往往更值得关注。
但错配效应还取决于碱基类型和周围序列。
Du等人对单碱基错配靶点的系统分析显示,错配的位置和组成都会影响沉默,部分不完全配对仍能被容忍。[11]
筛查近似匹配时,应同时查看:
总错配数量;
错配位于seed、中央还是末端;
是否存在较长的连续匹配;
是否涉及G等非标准配对;
使用的工具是否考虑缺口或局部鼓包。
不能给出两个错配一定安全这样的统一结论。
即使中央错配影响了典型切割,也仍需考虑seed相关的非切割型调控。因此,长范围配对筛查和seed筛查需要分别保留。
参数互相矛盾时,怎么选?
实际筛选时,很少有一条候选在所有参数上都表现最好。
有的GC合适,但靶区预测结构较稳定;有的引导链自身不容易折叠,末端稳定性却偏向另一条链;还有的活性评分很高,但与其他转录本存在需要关注的近似匹配。
不同参数带来的问题,处理方式也不同。
非目标RNA的高度互补需要单独评估。 如果某条候选可能同时干扰另一个基因,尤其与当前表型有关的基因,应优先寻找替代位点。较好的GC和末端结构,不能抵消这一风险。
经验范围的轻微偏离,可以结合其他条件保留。 例如GC为52.6%,略高于某套规则的上限,但末端稳定性、结构和特异性表现较好,就不必仅凭这一项删除。
结构预测的不利结果,需要考虑可信程度。 靶区在一张最低自由能结构图中位于茎部,并不足以证明它在细胞内始终无法接近。还可以检查配对概率、其他构象,以及结果对分析窗口的敏感程度。
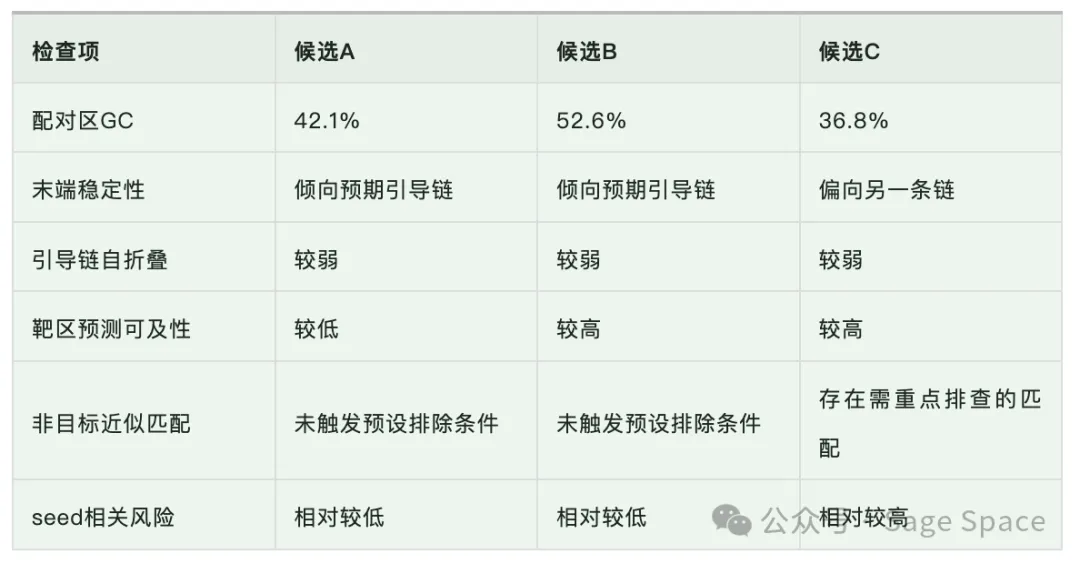
下面是一组仅用于解释筛选思路的虚构候选。假设三条都完整匹配目标,采用相同计算条件,不涉及实际敲降数据。
只看GC,A很容易排在前面。
加入其他参数后,B也值得优先测试。它的GC略高于某套经验范围,但没有必要因此放弃其他较有利的条件。
A可以保留,进一步检查局部结构预测是否稳定。C需要处理的主要问题,则是链选择偏向和非目标匹配,36.8%的GC并不是决定性缺点。
这些判断只用于安排筛选顺序,不能据此给候选预填敲降率。
此外,部分参数相互关联。GC、双链ΔG和Tm都受到碱基组成影响;5′端A/U偏好与末端稳定性也有重叠。
如果自行建立评分表,把这些指标分别赋予很高权重,可能会重复奖励同一种序列特征。没有经过实验数据校准的总分,适合帮助整理候选,不宜解释为成功概率。
设计时,可以保存这张参数表
实际记录时,除了数值,还可以给每条候选留一栏简短说明:
为什么保留,有什么顾虑,哪个参数需要结合实验再判断。
例如:GC略高于当前初筛范围,但末端结构较合适,未触发预设脱靶排除条件,保留测试。
或者:总评分较高,但与非目标转录本存在较长范围互补,暂不进入首轮。
这样的记录,比只留下一个综合分数更方便复查。
写在最后
siRNA设计中的参数,分别涉及分子结构、链选择、靶点接近和非目标识别。一个指标表现较好,不能代替其他环节的检查。
GC合适以后,还要看它分布在哪里;序列完全互补以后,还要看靶区是否容易接近;完整序列没有明显非目标命中以后,还要检查seed相关风险。
筛选得到几条候选时,可以尽量保留不同位点、不同seed,并记录各自的取舍理由。后续分别测试,才能判断哪些设计特征在当前体系中更有参考价值。
设计规则帮助缩小筛选范围,实验结果决定哪些候选能够继续使用。
下次看到设计报告里的GC、ΔG、Tm或结构评分,可以多核对一句:这个数值描述的是哪个过程,为什么会影响这条siRNA的选择?
参考文献
Elbashir SM, Harborth J, Lendeckel W, et al. Duplexes of 21-nucleotide RNAs mediate RNA interference in cultured mammalian cells. Nature. 2001;411:494–498. doi:10.1038/35078107.
Kim DH, Behlke MA, Rose SD, et al. Synthetic dsRNA Dicer substrates enhance RNAi potency and efficacy. Nature Biotechnology. 2005;23:222–226. doi:10.1038/nbt1051.
Reynolds A, Leake D, Boese Q, et al. Rational siRNA design for RNA interference. Nature Biotechnology. 2004;22:326–330. doi:10.1038/nbt936.
Schwarz DS, Hutvágner G, Du T, et al. Asymmetry in the assembly of the RNAi enzyme complex. Cell. 2003;115:199–208. doi:10.1016/S0092-8674(03)00759-1.
Ui-Tei K, Naito Y, Takahashi F, et al. Guidelines for the selection of highly effective siRNA sequences for mammalian and chick RNA interference. Nucleic Acids Research. 2004;32:936–948. doi:10.1093/nar/gkh247.
Patzel V, Rutz S, Dietrich I, et al. Design of siRNAs producing unstructured guide-RNAs results in improved RNA interference efficiency. Nature Biotechnology. 2005;23:1440–1444. doi:10.1038/nbt1151.
Overhoff M, Alken M, Far RK, et al. Local RNA target structure influences siRNA efficacy: a systematic global analysis. Journal of Molecular Biology. 2005;348:871–881. doi:10.1016/j.jmb.2005.03.012.
Tafer H, Ameres SL, Obernosterer G, et al. The impact of target site accessibility on the design of effective siRNAs. Nature Biotechnology. 2008;26:578–583. doi:10.1038/nbt1404.
Jackson AL, Burchard J, Schelter J, et al. Widespread siRNA “off-target” transcript silencing mediated by seed region sequence complementarity. RNA. 2006;12:1179–1187. doi:10.1261/rna.25706.
Naito Y, Yoshimura J, Morishita S, Ui-Tei K. siDirect 2.0: updated software for designing functional siRNA with reduced seed-dependent off-target effect. BMC Bioinformatics. 2009;10:392. doi:10.1186/1471-2105-10-392.
Du Q, Thonberg H, Wang J, et al. A systematic analysis of the silencing effects of an active siRNA at all single-nucleotide mismatched target sites. Nucleic Acids Research. 2005;33:1671–1677. doi:10.1093/nar/gki312.
 SageSpace 是一家面向科研场景的生物信息学设计与技术服务工作室,提供 siRNA、ASO、sgRNA、RNA FISH/smFISH 探针、qPCR 引物设计及 miRNA 靶点分析等服务。我们结合具体研究目标和实验条件开展设计,也在这里分享实验原理、设计思路与真实案例。欢迎关注,一起探讨 RNA 研究中的问题与方法。