这是「哈佛 Agent 系统课」系列的第 7 篇。第 7 讲在官网课表上是 9 月 30 日,课件标题是 Agent design IV: evaluation,课件 37 页。这一讲回答一个问题:怎样判断一个 agent 到底行不行。
课件先讲评测的历史,目标和指标,再逐个拆八个有代表性的 agent 基准,最后讲 agent 评测为什么难,以及它在怎样变化。第 4 页的安排里还有一项「低成本的 agent」,这份课件没有展开,只在第 35 页作业三的评分里出现,下一讲接着讲。
我按课件逐页讲,封面,空白页和动画中间帧只用一句带过。本文页码按 PDF 数。课件页脚的编号从第 35 页起比 PDF 大 1;第 37 页是空白页。
一、通知与今天的安排(第 1–4 页)
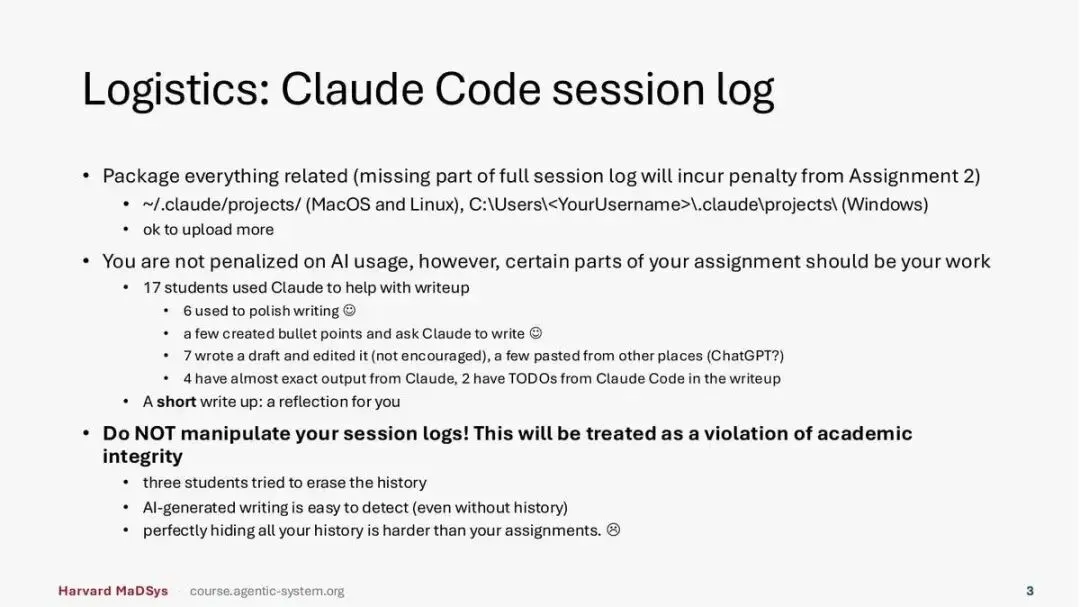
第 3 页是本讲最长的通知:交作业要附完整的 Claude Code 会话记录,篡改记录按学术不端处理。
第 1 页是封面,课程名是 Modern AI systems: agents and system optimizations,本讲标题是 Agent design IV: evaluation,讲师 Juncheng Yang。
第 2 页是通知。本周四下午 3:30 在 SEC 4.308 有答疑。期末项目的海报展示定在 12 月 7 日上午 9 点到下午 1 点,时间不合适的同学本周结束前联系讲师。作业二本周日截止,课件加了一句:早点开始。
 CS2680 第 7 讲课件 · 第 3 页
第 3 页讲 Claude Code 会话记录。作业要把相关的会话记录全部打包上交,记录缺了要从作业二里扣分。记录的位置是 macOS 和 Linux 上的 ~/.claude/projects/,Windows 上的 C:\Users\<用户名>\.claude\projects\,多传一些没关系。
第二条说,用 AI 不扣分,但作业里有些部分应该是学生自己写的。课件统计了作业一的报告:17 个学生用 Claude 帮忙写报告。其中 6 个用来润色文字;几个先列要点,再让 Claude 写成文;7 个先写草稿再让 Claude 改(课件写「不鼓励」),还有几个从别处贴来(课件打了个问号:ChatGPT?);4 个几乎就是 Claude 的原样输出,2 个的报告里还留着 Claude Code 写的 TODO。课件的要求是:写一份简短的报告,作为给自己的反思。
第三条加粗:不要篡改会话记录,否则按违反学术诚信处理。课件说有三个学生试过抹掉历史记录;AI 写的文字很容易看出来,没有历史记录也一样;把历史完美藏起来,比写作业还难。
补充Claude Code 是 Anthropic 的命令行编程 agent。它把每次会话的完整记录存成文件,放在用户目录的 .claude/projects/ 下,按项目分文件夹。本课程的作业允许甚至要求用它,所以把这些记录当作交付物的一部分。
第 4 页是今天的安排,两项:agent 评测,低成本的 agent。
二、评测 agent 的两种视角,和一段历史(第 5–7 页)
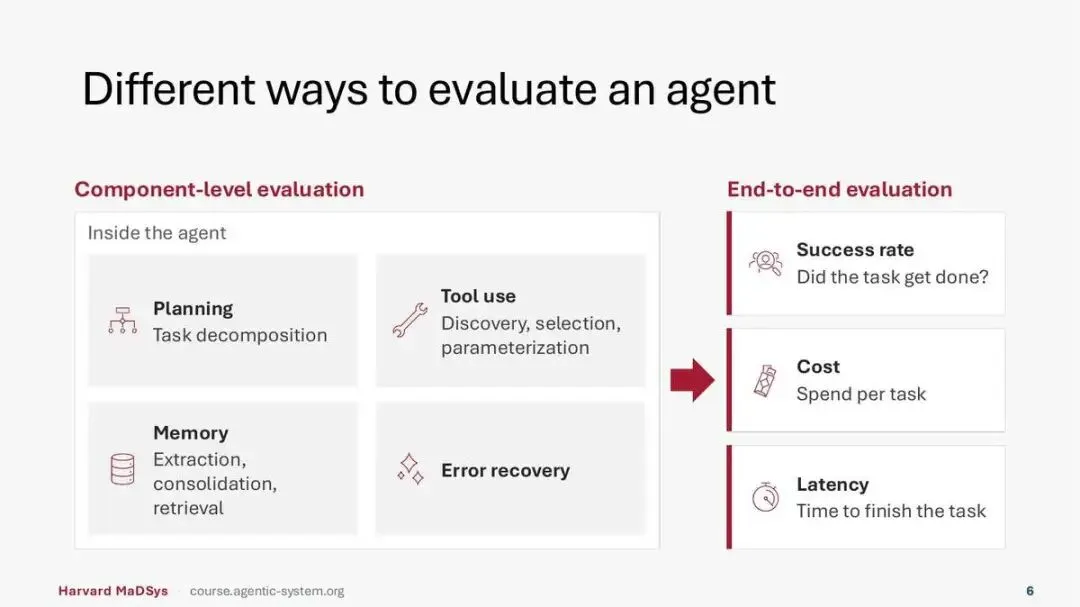
第 6 页:评测可以拆开看 agent 内部的组件,也可以只看端到端的结果:做没做成,花多少钱,用多久。
 CS2680 第 7 讲课件 · 第 5 页
第 5 页是评测部分的过渡页,问:怎样评估一个 agent 的能力?下面列出这一部分的四块内容:历史和趋势,指标,代表性的基准,挑战。
 CS2680 第 7 讲课件 · 第 6 页
第 6 页把评测分成两种。
左边是组件级评测,看 agent 内部。四个格子:规划,看任务分解;工具使用,看工具的发现,选择和参数填写;记忆,看抽取,整合和检索;错误恢复。
右边是端到端评测,三个指标。成功率:任务做成了没有。成本:每个任务花多少钱。延迟:完成任务用多长时间。中间一个箭头从左指向右。
补充记忆的抽取,整合,检索,以及错误恢复,是本系列第 6 讲的内容。第 6 讲第 19 页讲过怎样评测记忆组件,这一页把它放进了更大的评测图里。
 CS2680 第 7 讲课件 · 第 7 页
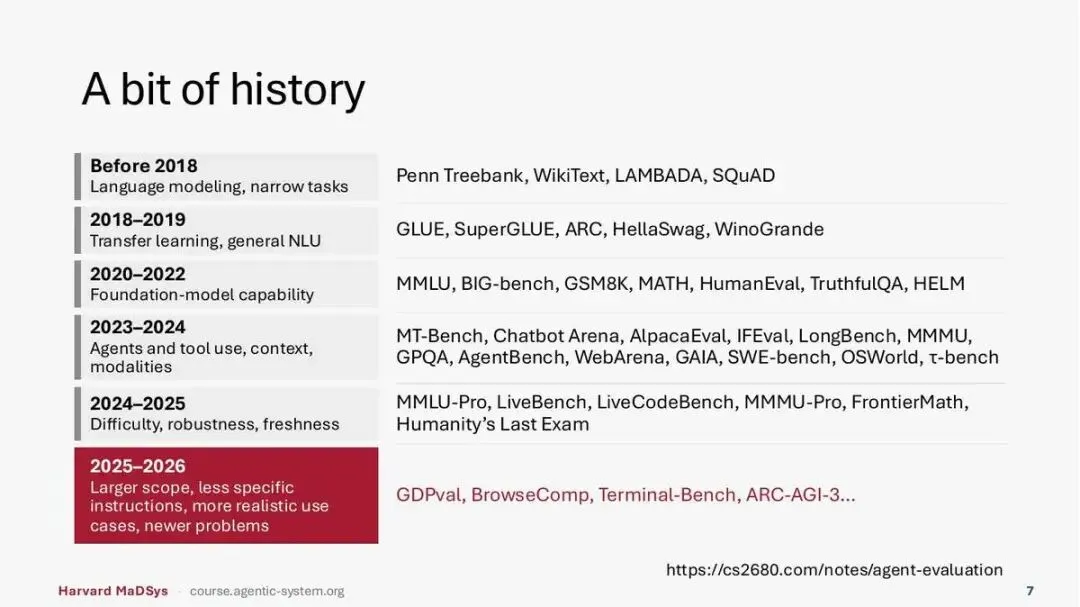
第 7 页是评测基准的一段历史,分六个时期。
2018 年以前,评测的是语言建模和窄任务,代表是 Penn Treebank,WikiText,LAMBADA,SQuAD。2018 到 2019 年,迁移学习和通用的自然语言理解,代表是 GLUE,SuperGLUE,ARC,HellaSwag,WinoGrande。2020 到 2022 年,基础模型的能力,代表是 MMLU,BIG-bench,GSM8K,MATH,HumanEval,TruthfulQA,HELM。
2023 到 2024 年,开始评测 agent 和工具使用,上下文,多模态,代表是 MT-Bench,Chatbot Arena,AlpacaEval,IFEval,LongBench,MMMU,GPQA,AgentBench,WebArena,GAIA,SWE-bench,OSWorld,τ-bench。2024 到 2025 年,重点是难度,鲁棒性和新鲜度,代表是 MMLU-Pro,LiveBench,LiveCodeBench,MMMU-Pro,FrontierMath,Humanity's Last Exam。
最后一行标红:2025 到 2026 年,范围更大,指令更不具体,用例更接近真实使用,题目更新。代表是 GDPval,BrowseComp,Terminal-Bench,ARC-AGI-3。
右下角给了一个链接 https://cs2680.com/notes/agent-evaluation ,这是官网为本讲列的参考资料。
补充「新鲜度」指题目是不是新出的。旧题公开时间长了,可能已经混进模型的训练数据,模型答对可能是背过,不是会做。第 25 页讲数据泄漏时会展开。
三、评测目标,指标,评测循环(第 8–11 页)
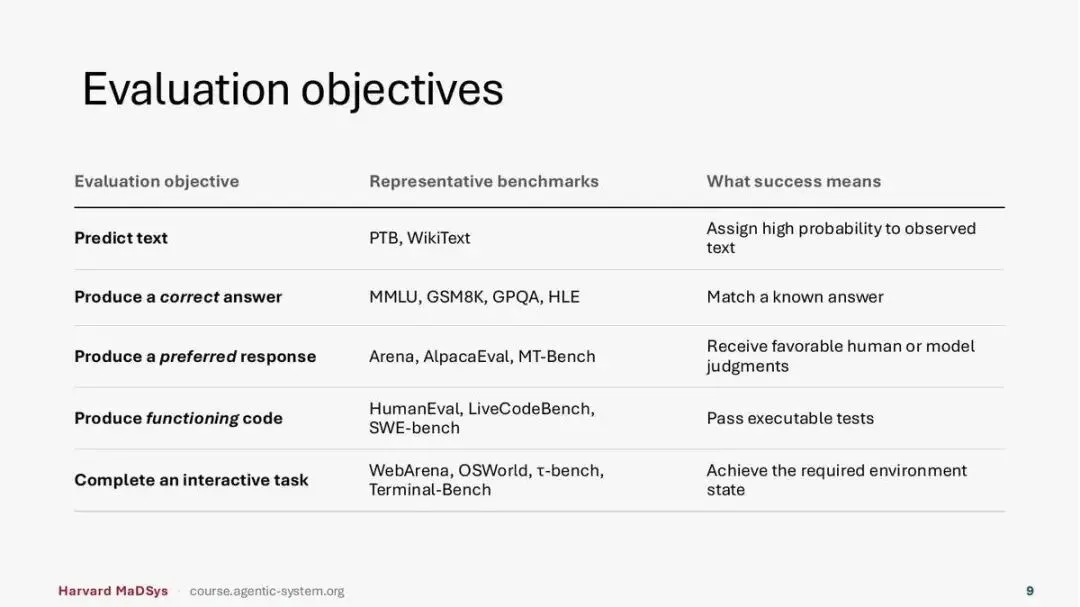
第 9 页:每一代基准的「成功」定义不同,从猜中下一个词,到让环境达到要求的状态。
第 8 页是第 9 页的动画前一帧,只有表头,内容一样。
 CS2680 第 7 讲课件 · 第 9 页
第 9 页列出五种评测目标,每种配代表基准和「成功」的含义。
预测文本:PTB,WikiText;成功是给真实出现的文本分配高概率。给出正确答案:MMLU,GSM8K,GPQA,HLE;成功是和已知答案一致。给出更受偏好的回答:Arena,AlpacaEval,MT-Bench;成功是人或模型给出好评。写出能运行的代码:HumanEval,LiveCodeBench,SWE-bench;成功是通过可执行的测试。完成一个交互任务:WebArena,OSWorld,τ-bench,Terminal-Bench;成功是让环境达到要求的状态。
 CS2680 第 7 讲课件 · 第 10 页
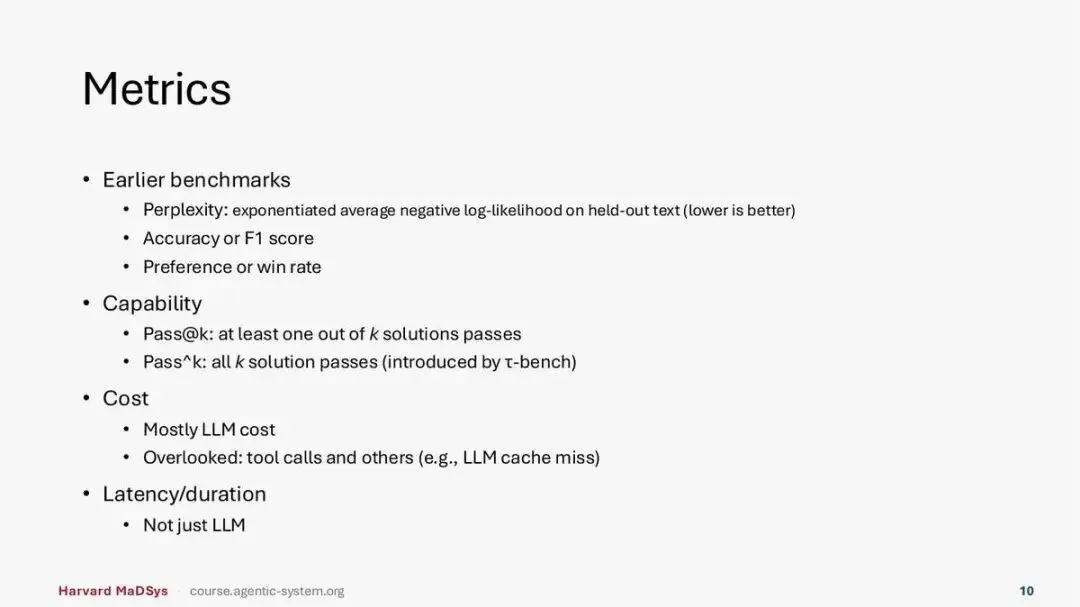
第 10 页讲指标,分四组。
早期基准:困惑度(perplexity),即在留出的文本上平均负对数似然取指数,越低越好;准确率或 F1 分数;偏好或胜率。
能力:Pass@k,k 个解里至少一个通过;Pass^k,k 个解全部通过,由 τ-bench 提出。
成本:主要是 LLM 的费用。容易被忽略的是工具调用和其他开销,例如 LLM 缓存未命中。
延迟或时长:不只是 LLM 的时间。
补充困惑度可以理解成模型在每个位置上平均要在多少个候选词里犹豫。值越低,说明模型对真实文本越「不意外」。F1 是精确率和召回率的调和平均。缓存未命中的意思是:同样的前缀如果命中了服务端的 prompt 缓存,价格会便宜很多,没命中就按原价算,所以同一个 agent 的成本会随缓存命中率变化。
 CS2680 第 7 讲课件 · 第 11 页
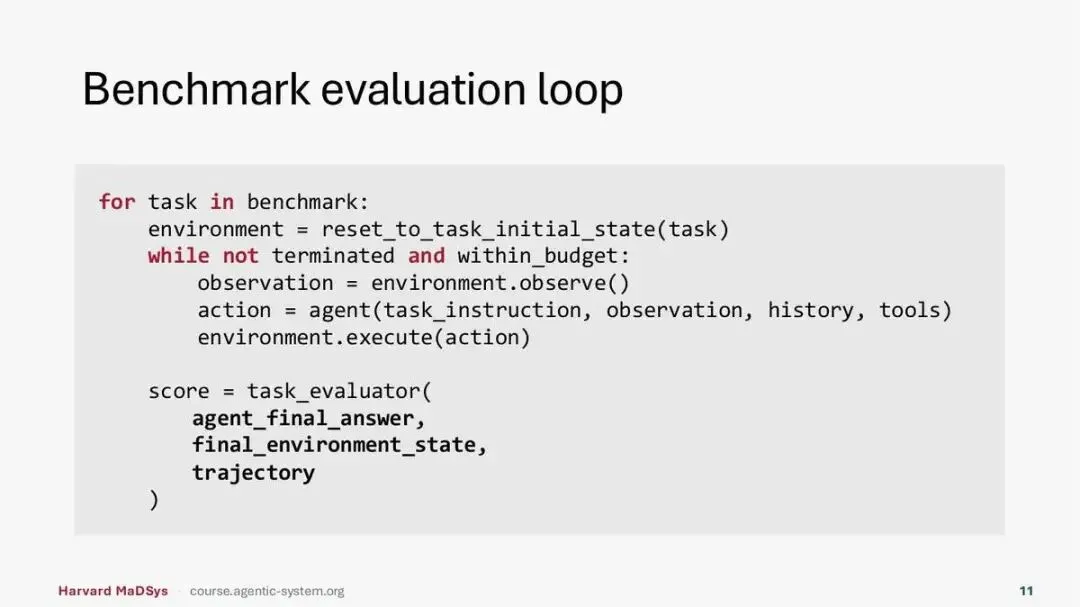
第 11 页用一段伪代码写出基准评测的循环。
对基准里的每个任务:先把环境重置到这个任务的初始状态;然后在没有结束,也没有超出预算的时候循环:观察环境,agent 根据任务指令,观察,历史和工具决定下一个动作,环境执行这个动作。循环结束后,由任务的评估器打分,输入有三样,课件把它们加粗:agent 的最终答案,环境的最终状态,轨迹。
后面每个基准,区别就在这三样输入里用哪几样来打分。
四、只看答案,只看调用:GAIA 和 BFCL(第 12–14 页)
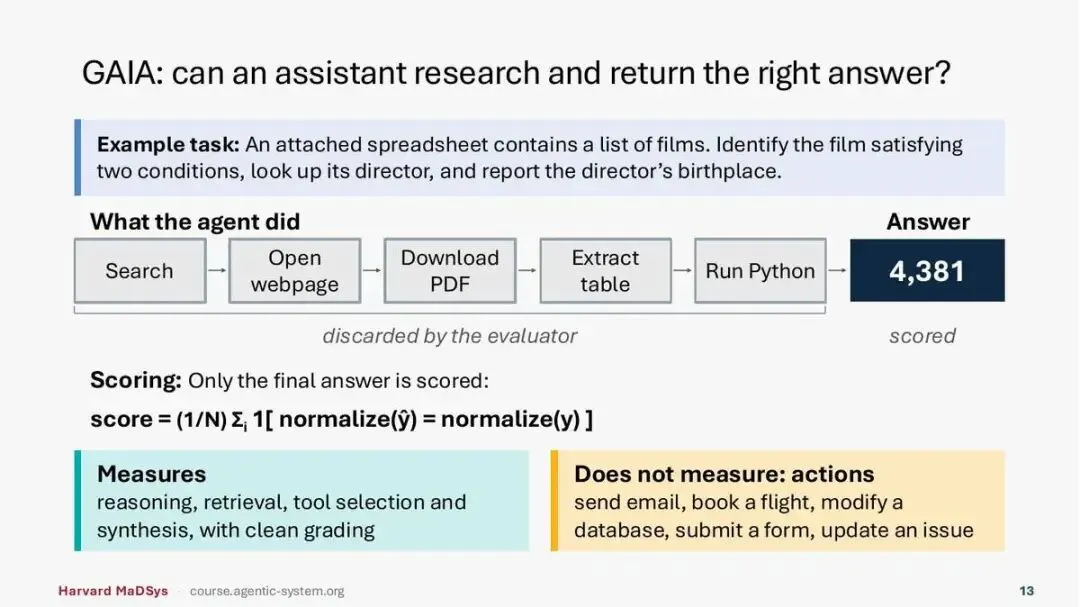
第 13 页:GAIA 只给最终答案打分,中间做了什么全部不计;它不测会改变外部世界的动作。
 CS2680 第 7 讲课件 · 第 12 页
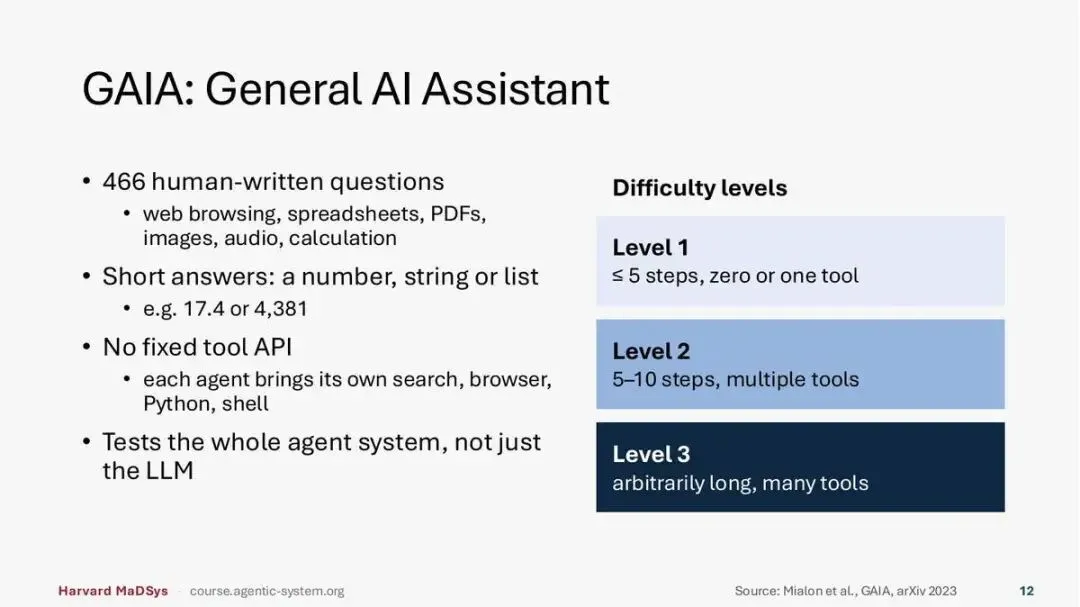
第 12 页介绍 GAIA,全称 General AI Assistant。466 道人写的题,涉及网页浏览,表格,PDF,图片,音频和计算。答案很短,是一个数字,一个字符串或一个列表,例如 17.4 或 4,381。GAIA 不规定工具接口,每个 agent 自带搜索,浏览器,Python 和 shell。所以它测的是整个 agent 系统,不只是 LLM。
右边是三个难度等级。第 1 级:不超过 5 步,用零个或一个工具。第 2 级:5 到 10 步,用多个工具。第 3 级:步数不限,用很多工具。出处是 Mialon 等人 2023 年发在 arXiv 的论文。
 CS2680 第 7 讲课件 · 第 13 页
第 13 页用一道例题演示 GAIA 怎么打分。题目是:附件表格里有一串电影,找出满足两个条件的那部,查到导演,报出导演的出生地。
agent 的过程是:搜索,打开网页,下载 PDF,抽取表格,运行 Python,最后得出答案 4,381。前五步下面写着「被评估器丢弃」,只有答案被打分。
打分公式是:score = (1/N) Σ 1[normalize(ŷ) = normalize(y)],也就是把 agent 的答案和标准答案都规范化之后比较,相等记 1 分,再对 N 道题取平均。
下面两个框。它测的:推理,检索,工具选择和综合,打分干净。它不测的:动作,例如发邮件,订机票,改数据库,提交表单,更新一个 issue。
补充normalize 指比较前先统一格式,例如去掉千分位逗号,统一大小写和空格,这样「4,381」和「4381」会被判为相同。
 CS2680 第 7 讲课件 · 第 14 页
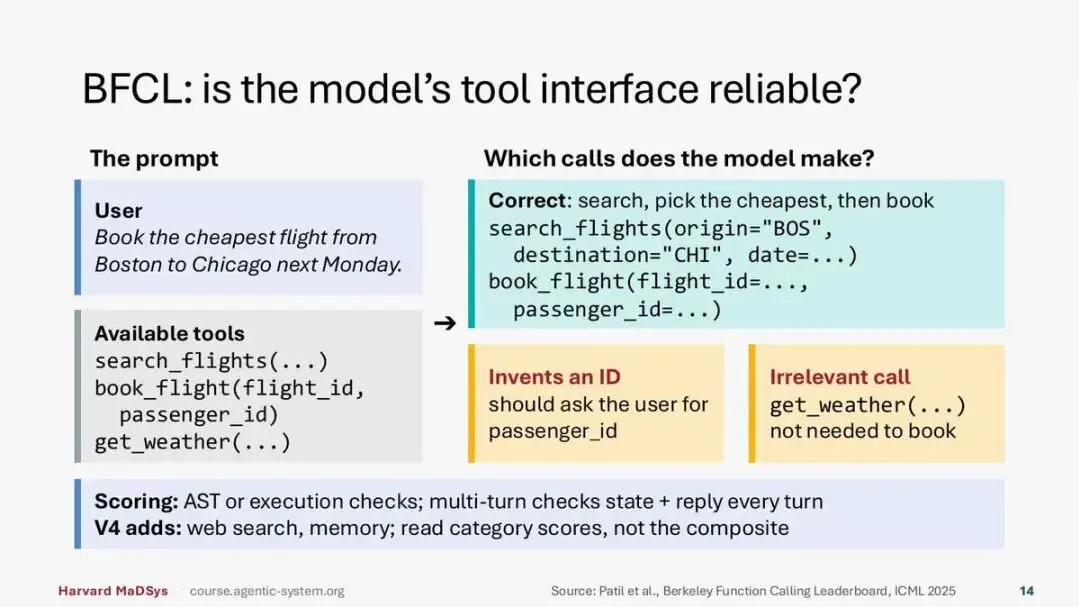
第 14 页是 BFCL,伯克利函数调用排行榜,问的是:模型调用工具的接口靠不靠得住?
例题:用户说「帮我订下周一从波士顿到芝加哥最便宜的航班」。可用的工具有三个:search_flights(...),book_flight(flight_id, passenger_id),get_weather(...)。
正确的做法是先搜索,挑最便宜的,再订:search_flights(origin="BOS", destination="CHI", date=...),然后 book_flight(flight_id=..., passenger_id=...)。课件标了两种错误:编造 ID,这时应该先问用户要 passenger_id;无关调用,比如调 get_weather(...),订票用不到。
打分方式:用 AST 检查或实际执行检查;多轮的题每一轮都检查状态和回复。第 4 版加了网页搜索和记忆两类;课件提醒看分类得分,不要只看综合分。出处是 Patil 等人,ICML 2025。
补充AST 是抽象语法树。AST 检查不真的执行函数,只把模型写出的调用解析成结构,核对函数名,参数名,参数类型和取值对不对。执行检查则是真的调用,看结果。
五、在网页,桌面和代码仓库里做事:WebArena,OSWorld,SWE-bench(第 15–17 页)
第 15 到 17 页三个基准都只检查最终状态,轨迹不打分。
 CS2680 第 7 讲课件 · 第 15 页
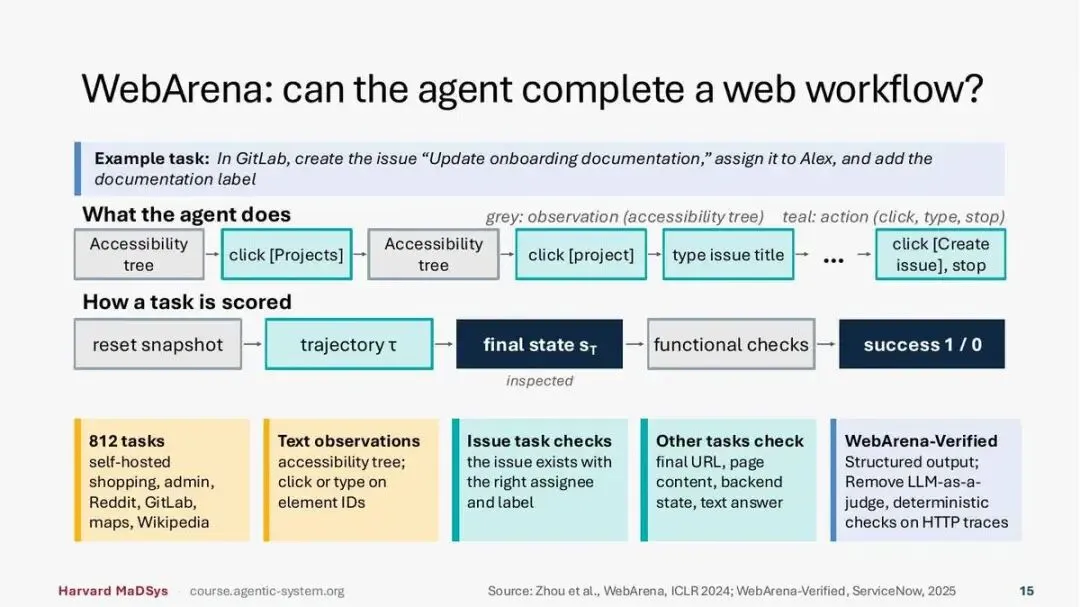
第 15 页是 WebArena,问:agent 能不能完成一个网页上的工作流程?例题:在 GitLab 里创建一个名为「Update onboarding documentation」的 issue,指派给 Alex,加上 documentation 标签。
agent 的过程:读可访问性树,点击 Projects,再读可访问性树,点击项目,输入 issue 标题,……,最后点击「Create issue」并停止。灰色格子是观察,青色格子是动作(点击,输入,停止)。
打分流程:重置快照,agent 跑出轨迹 τ,检查最终状态 sT,做功能检查,结果是成功 1 或失败 0。
底部五个格子。812 个任务,网站全部自己部署,包括购物,后台管理,Reddit,GitLab,地图和维基百科。观察是文本形式的可访问性树,动作是在元素 ID 上点击或输入。issue 这类任务检查 issue 是否存在,指派人和标签对不对。其他任务检查最终 URL,页面内容,后端状态,或文字答案。WebArena-Verified 改成结构化输出,去掉了 LLM 当裁判的环节,改成对 HTTP 流量做确定性检查。出处是 Zhou 等人,ICLR 2024;WebArena-Verified 来自 ServiceNow,2025 年。
补充可访问性树(accessibility tree)是浏览器给读屏软件准备的页面结构,把按钮,链接,输入框列成一棵带编号的树。agent 读这棵树,比读原始 HTML 短得多,也比看截图更容易定位元素。
 CS2680 第 7 讲课件 · 第 16 页
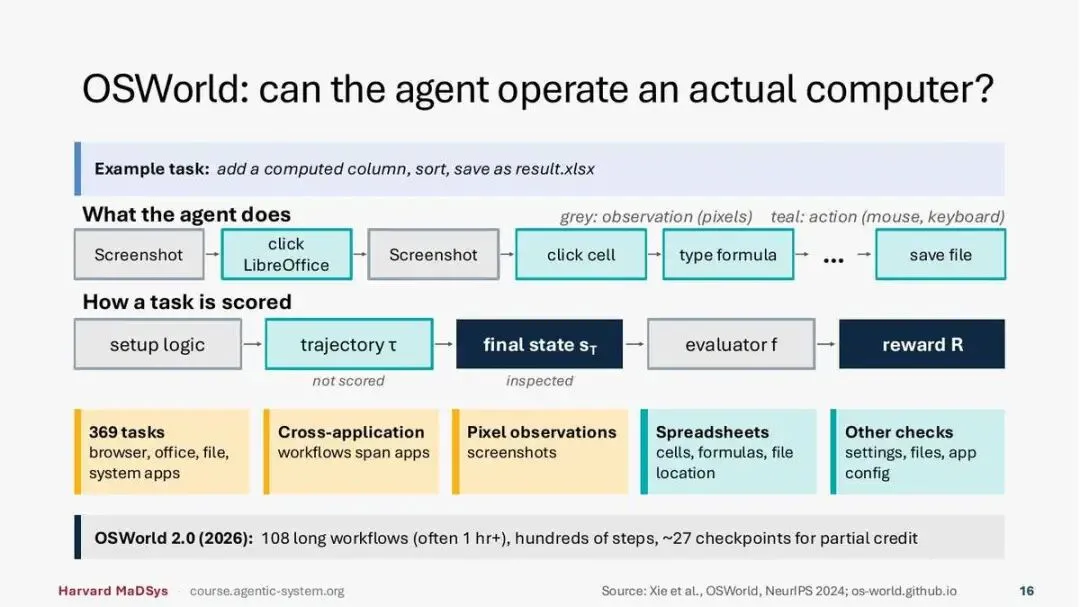
第 16 页是 OSWorld,问:agent 能不能操作一台真正的电脑?例题:加一列计算列,排序,另存为 result.xlsx。
agent 的过程:截图,点击打开 LibreOffice,截图,点击单元格,输入公式,……,保存文件。观察是像素,动作是鼠标和键盘。
打分流程:先跑初始化逻辑,agent 跑出轨迹 τ,轨迹不打分;检查最终状态 sT,由评估器 f 给出奖励 R。
底部格子:369 个任务,涉及浏览器,办公软件,文件和系统应用。有跨应用的工作流。观察是截图。表格类任务检查单元格,公式和文件位置;其他任务检查设置,文件和应用配置。
最下面一行:OSWorld 2.0(2026 年)有 108 个长工作流,常常超过 1 小时,几百步,平均约 27 个检查点,可以拿部分分。出处是 Xie 等人,NeurIPS 2024,以及 os-world.github.io。
 CS2680 第 7 讲课件 · 第 17 页
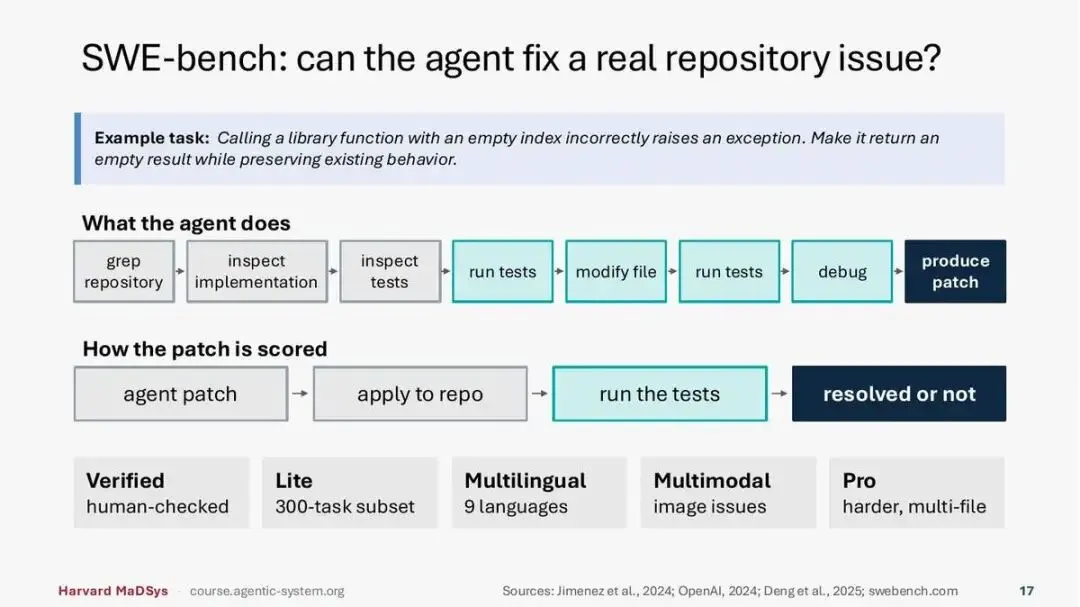
第 17 页是 SWE-bench,问:agent 能不能修好一个真实代码仓库里的 issue?例题:调用某个库函数时传入空索引,会错误地抛出异常;改成返回空结果,同时不破坏已有行为。
agent 的过程:grep 仓库,看实现,看测试,跑测试,改文件,再跑测试,调试,产出补丁。
打分流程:拿 agent 的补丁,打到仓库上,跑测试,结果是「解决」或「没解决」。
底部是五个变体。Verified:人工核对过的子集。Lite:300 题的子集。Multilingual:9 种编程语言。Multimodal:带图片的 issue。Pro:更难,常要改多个文件。出处是 Jimenez 等人 2024,OpenAI 2024,Deng 等人 2025,以及 swebench.com。
六、和人对话,在终端干活,在公司上班:τ-bench,Terminal-Bench,TheAgentCompany(第 18–23 页)
第 19 页:τ-bench 提出 pass^k,要求同一个场景跑 k 次全部成功,比 pass@k 严格得多。
 CS2680 第 7 讲课件 · 第 18 页
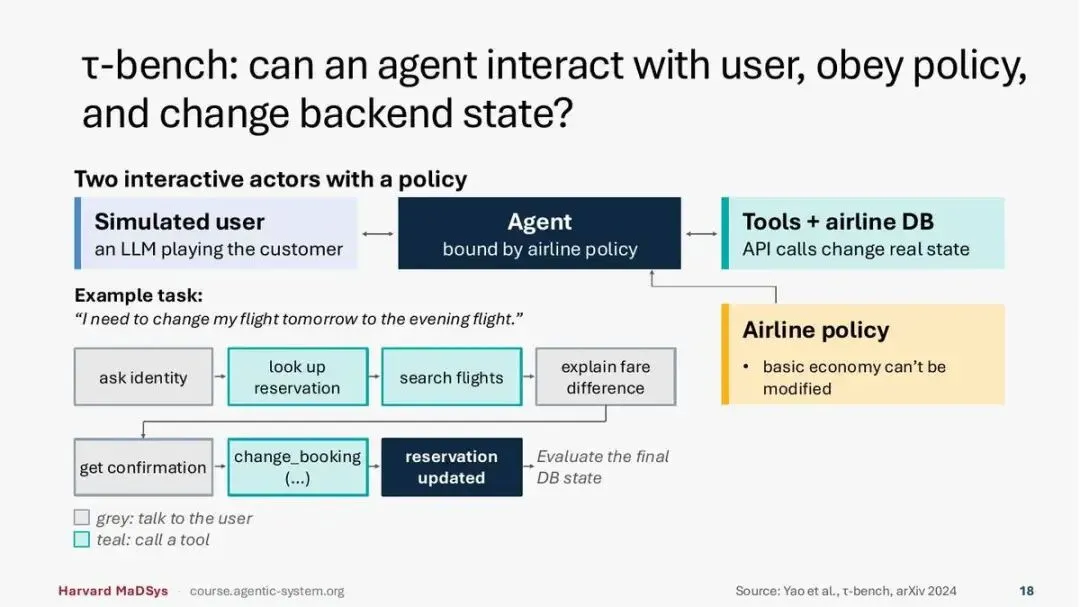
第 18 页是 τ-bench,问:agent 能不能一边和用户对话,一边遵守规定,一边改后端状态?
图上有两个会互动的角色和一套规定。模拟用户:由一个 LLM 扮演顾客。agent:受航空公司规定约束。工具和航空公司数据库:API 调用会改变真实状态。规定的例子:基础经济舱不能改签。
例题:「我想把明天的航班改成晚上那班。」agent 的过程:核实身份,查预订,搜航班,解释票价差额,取得确认,调用 change_booking(…),预订更新。最后评估数据库的最终状态。灰色是和用户说话,青色是调用工具。出处是 Yao 等人 2024 年发在 arXiv 的论文。
 CS2680 第 7 讲课件 · 第 19 页
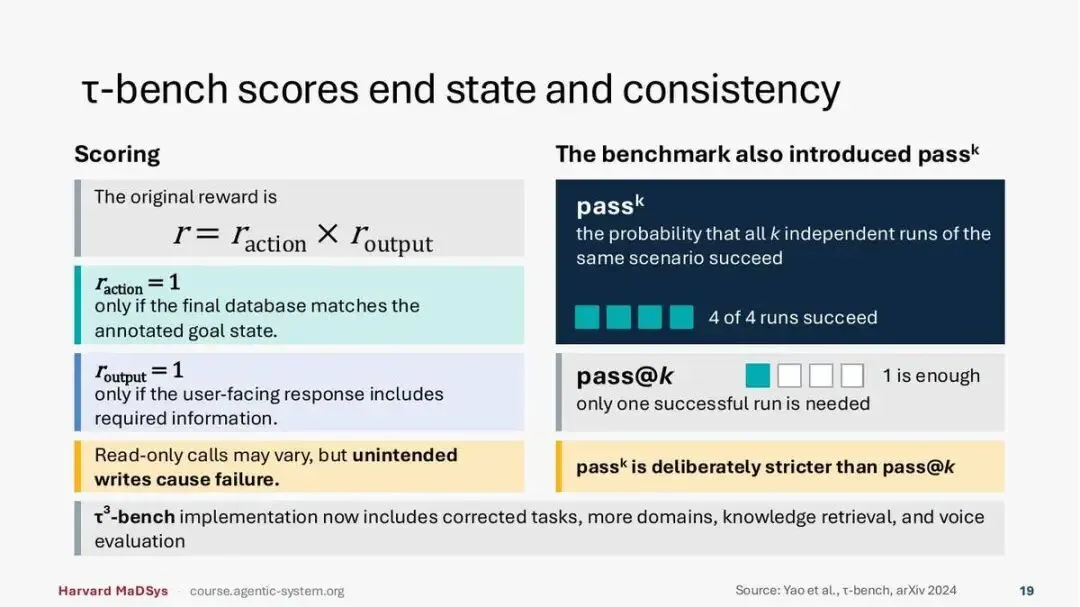
第 19 页讲 τ-bench 怎么打分。
原始的奖励是 r = r_action × r_output。r_action = 1,当且仅当最终数据库和标注的目标状态一致。r_output = 1,当且仅当给用户的回复里包含了必须提供的信息。只读的调用可以不同,但任何意外的写操作都直接判失败。
右边是 τ-bench 提出的 pass^k:同一个场景独立跑 k 次,全部成功的概率。图上是 4 次运行 4 次成功。下面对照 pass@k:只要有一次成功就算。课件说,pass^k 是有意设计得比 pass@k 更严格。
最后一行:τ³-bench 的实现修正了一些题目,增加了更多领域,知识检索和语音评测。
补充如果一个 agent 每次独立运行的成功率是 p,pass@k 约等于 1 −(1 − p)的 k 次方,k 越大越接近 1;pass^k 约等于 p 的 k 次方,k 越大越接近 0。比如 p = 0.8,k = 4 时,pass@4 约 99.8%,pass^4 约 41%。第 6 讲第 22 页的「每步 95%,50 步只剩 8%」是同一个算法。
 CS2680 第 7 讲课件 · 第 20 页
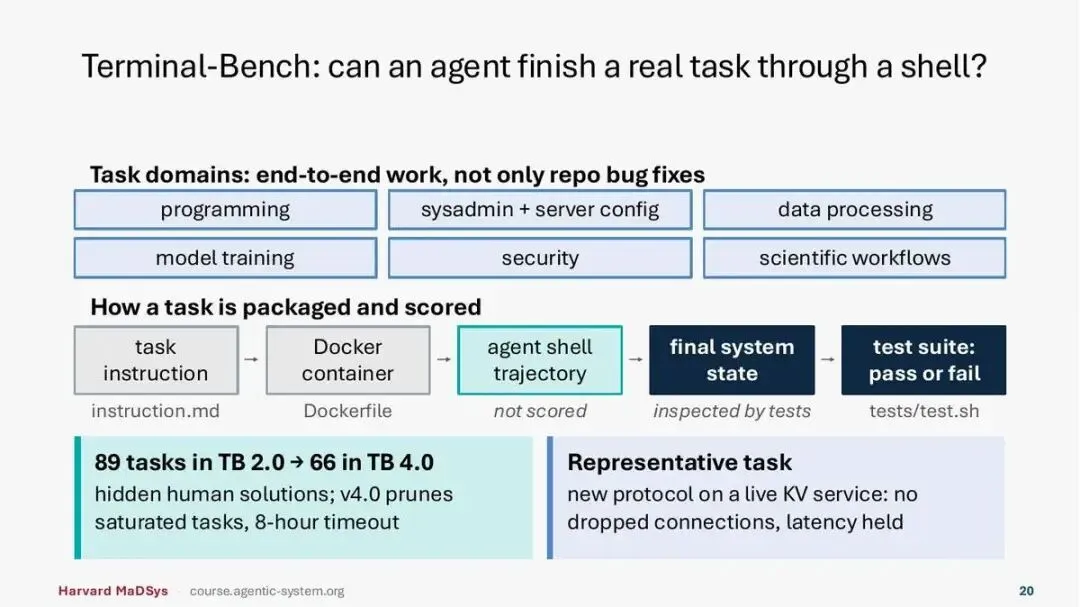
第 20 页是 Terminal-Bench,问:agent 能不能只靠一个 shell 完成真实任务?
任务领域不只是修仓库里的 bug,而是端到端的工作:编程,系统管理和服务器配置,数据处理,模型训练,安全,科学计算流程。
任务的打包和打分:任务说明写在 instruction.md;环境是一个 Docker 容器,由 Dockerfile 定义;agent 在 shell 里跑出轨迹,轨迹不打分;最终的系统状态交给测试检查;测试套件写在 tests/test.sh,结果是通过或失败。
左下:Terminal-Bench 2.0 有 89 个任务,到 4.0 剩 66 个。人写的参考解答不公开;4.0 删掉了已经被做饱和的任务,超时上限是 8 小时。右下是一道代表题:在一个正在运行的键值服务上换一套新协议,不能断连接,延迟要保持住。
补充Docker 容器是一个隔离的运行环境,里面装好了指定的系统和软件。每个任务从同一个镜像启动,保证每次评测的起点一样,agent 在里面做什么也不会影响宿主机。
 CS2680 第 7 讲课件 · 第 21 页
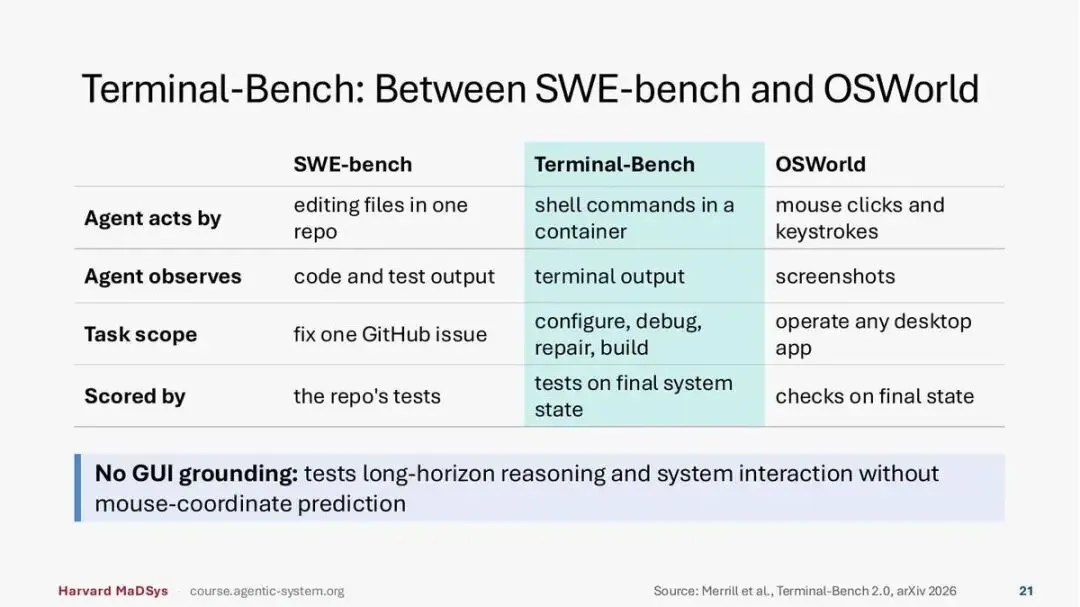
第 21 页把 Terminal-Bench 放在 SWE-bench 和 OSWorld 中间比较,四行。
agent 怎么行动:SWE-bench 是在一个仓库里改文件;Terminal-Bench 是在容器里执行 shell 命令;OSWorld 是鼠标点击和键盘输入。agent 观察什么:代码和测试输出;终端输出;截图。任务范围:修一个 GitHub issue;配置,调试,修复,构建;操作任意桌面应用。怎么打分:仓库自带的测试;对最终系统状态跑测试;检查最终状态。
下面一句:Terminal-Bench 没有 GUI 定位的问题,测的是长程推理和系统交互,不需要预测鼠标坐标。
 CS2680 第 7 讲课件 · 第 22 页
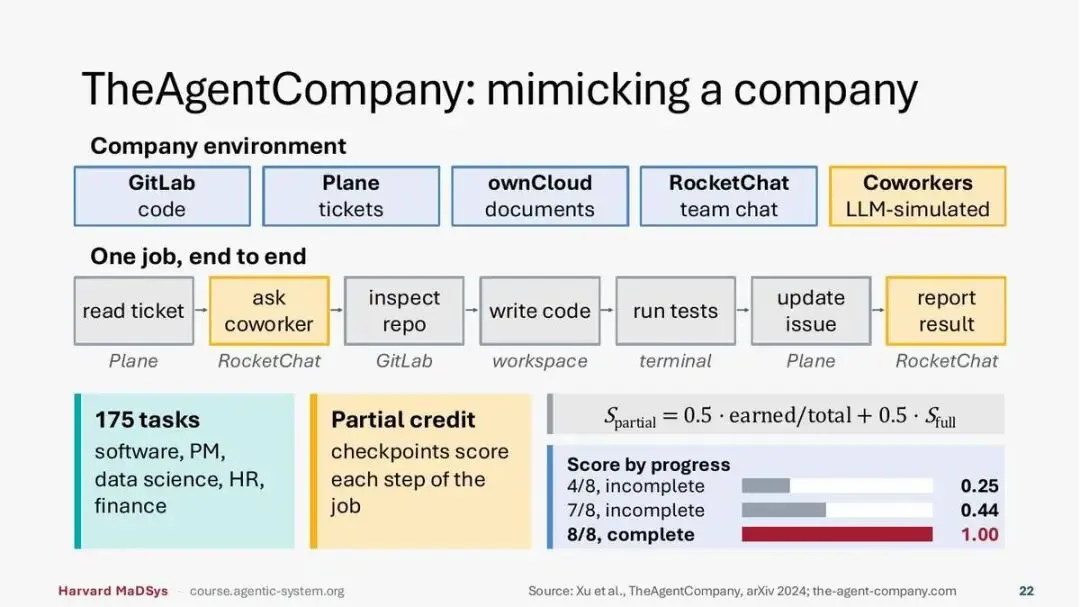
第 22 页是 TheAgentCompany,模拟一家公司。
公司环境有五样:GitLab 放代码,Plane 管工单,ownCloud 放文档,RocketChat 是团队聊天,同事由 LLM 模拟。
一份完整的工作:在 Plane 读工单,在 RocketChat 问同事,在 GitLab 看仓库,在工作区写代码,在终端跑测试,在 Plane 更新 issue,在 RocketChat 汇报结果。问同事和汇报结果两格标成黄色,和「同事」那一格同色。
175 个任务,覆盖软件开发,项目管理,数据科学,人力资源和财务。按检查点给部分分,工作的每一步都打分。公式是 S_partial = 0.5 × 已得检查点 / 总检查点 + 0.5 × S_full。右下角三个例子:完成 4/8,没做完,0.25 分;完成 7/8,没做完,0.44 分;8/8 全部完成,1.00 分。出处是 Xu 等人 2024 年发在 arXiv 的论文,以及 the-agent-company.com。
补充S_full 是「整个任务是否完成」,完成为 1,否则为 0。所以 7/8 的得分是 0.5 × 7/8 + 0 ≈ 0.44;全部完成才能拿到后一半的 0.5。这个设计既奖励进度,又让「做完」和「差一点做完」之间有明显的差距。
 CS2680 第 7 讲课件 · 第 23 页
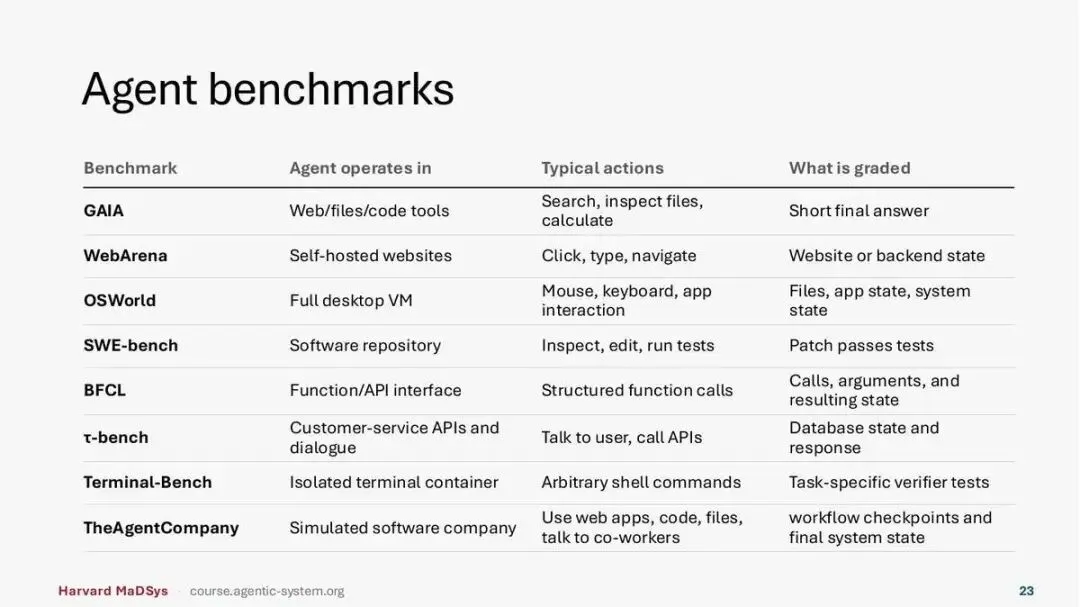
第 23 页把八个基准汇总,每个列出 agent 在哪里工作,典型动作,打分对象。
GAIA:网页,文件,代码工具;搜索,查文件,计算;打分看简短的最终答案。WebArena:自己部署的网站;点击,输入,导航;打分看网站或后端状态。OSWorld:完整的桌面虚拟机;鼠标,键盘,应用操作;打分看文件,应用状态,系统状态。SWE-bench:代码仓库;查看,编辑,跑测试;打分看补丁能否通过测试。
BFCL:函数或 API 接口;结构化的函数调用;打分看调用,参数和产生的状态。τ-bench:客服 API 和对话;和用户说话,调用 API;打分看数据库状态和回复。Terminal-Bench:隔离的终端容器;任意 shell 命令;打分靠每个任务专门的验证测试。TheAgentCompany:模拟的软件公司;用网页应用,写代码,处理文件,和同事说话;打分看工作流检查点和最终系统状态。
七、数据泄漏不只发生在训练里(第 24–26 页)
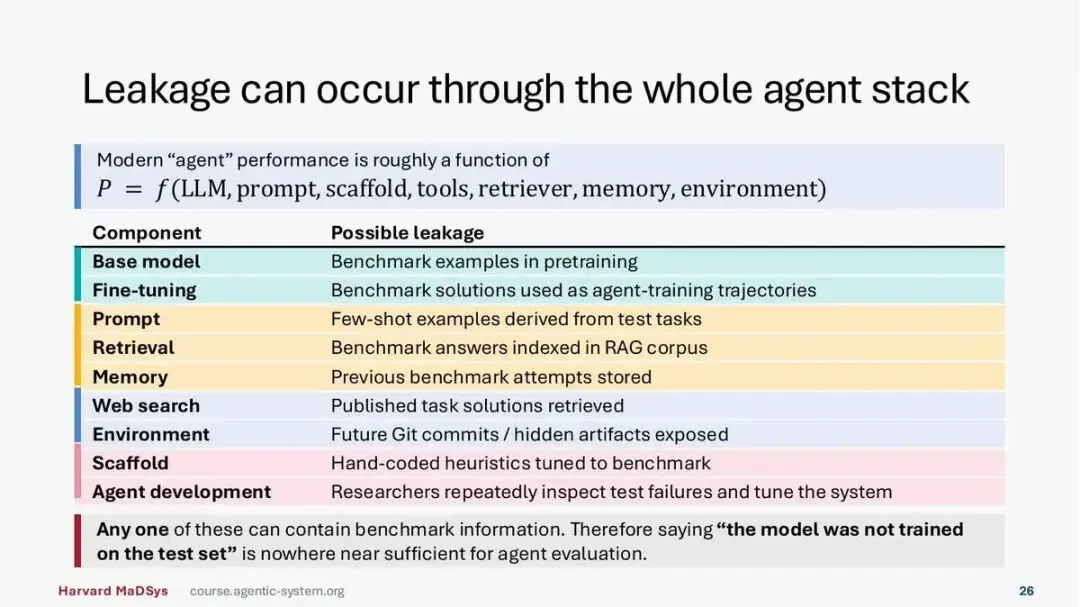
第 26 页:agent 的表现取决于整个栈,栈里任何一层都可能带进基准信息,「模型没在测试集上训练过」远远不够。
 CS2680 第 7 讲课件 · 第 24 页
第 24 页是第二部分的过渡页:agent 评测很难,而且在变化。下面两项:挑战,演变。
 CS2680 第 7 讲课件 · 第 25 页
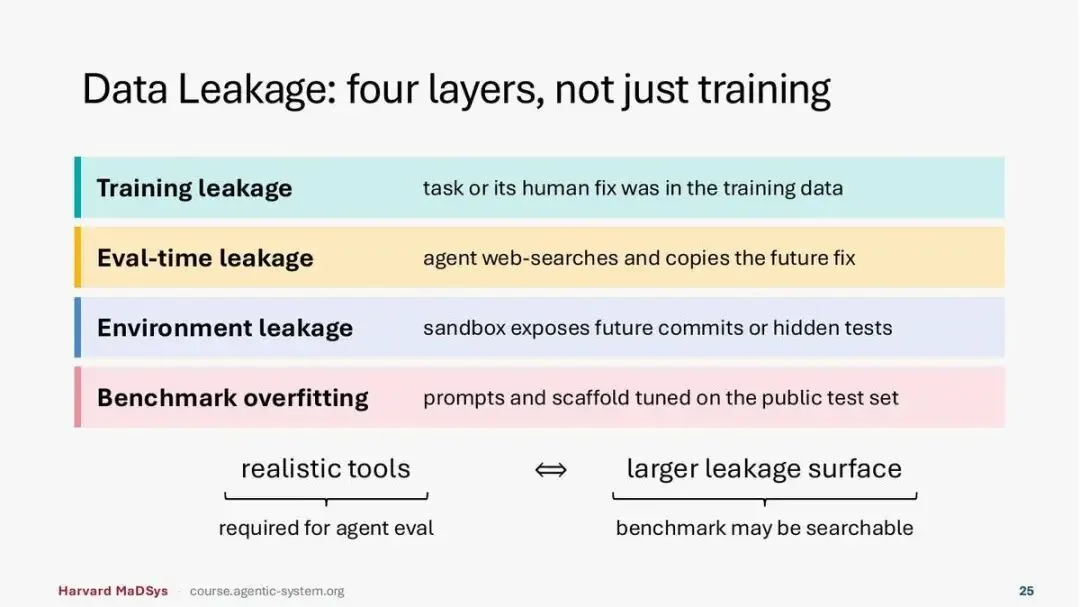
第 25 页把数据泄漏分成四层。训练泄漏:题目本身或人写的修复进了训练数据。评测时泄漏:agent 上网搜索,抄到了后来公开的修复。环境泄漏:沙箱里能看到未来的提交,或者隐藏的测试。基准过拟合:prompt 和脚手架是对着公开测试集调出来的。
下面一行是一组对应:agent 评测需要真实的工具,真实的工具意味着更大的泄漏面,基准的答案可能就搜得到。
补充脚手架(scaffold)指包在模型外面的那层程序,包括 prompt 模板,工具定义,循环和重试逻辑。本系列前几讲叫它 harness。以 SWE-bench 为例,题目来自 GitHub 上已经修好的 issue,修复的提交是公开的,所以 agent 联网时有可能直接搜到答案。
 CS2680 第 7 讲课件 · 第 26 页
第 26 页说泄漏可能出现在 agent 栈的每一层。课件先写了一个式子:现代 agent 的表现大致是 P = f(LLM, prompt, 脚手架, 工具, 检索器, 记忆, 环境) 的函数。
然后逐层列出可能的泄漏。基础模型:预训练里有基准的例题。微调:基准的解答被当成 agent 训练轨迹。prompt:few-shot 例子取自测试题。检索:基准答案被索引进了 RAG 语料。记忆:之前做基准的记录被存了下来。网页搜索:搜到了公开的题解。环境:暴露了未来的 Git 提交或隐藏文件。脚手架:手写了针对基准调过的规则。agent 开发:研究者反复看测试失败的用例,再去调系统。
底部加粗:任何一层都可能含有基准信息。所以说一句「模型没在测试集上训练过」,对 agent 评测来说远远不够。
八、基准只给一轮用户输入(第 27–30 页)
第 30 页:单轮打分奖励自信地猜,问一句澄清要多花步数,却拿不到分。
 CS2680 第 7 讲课件 · 第 27 页
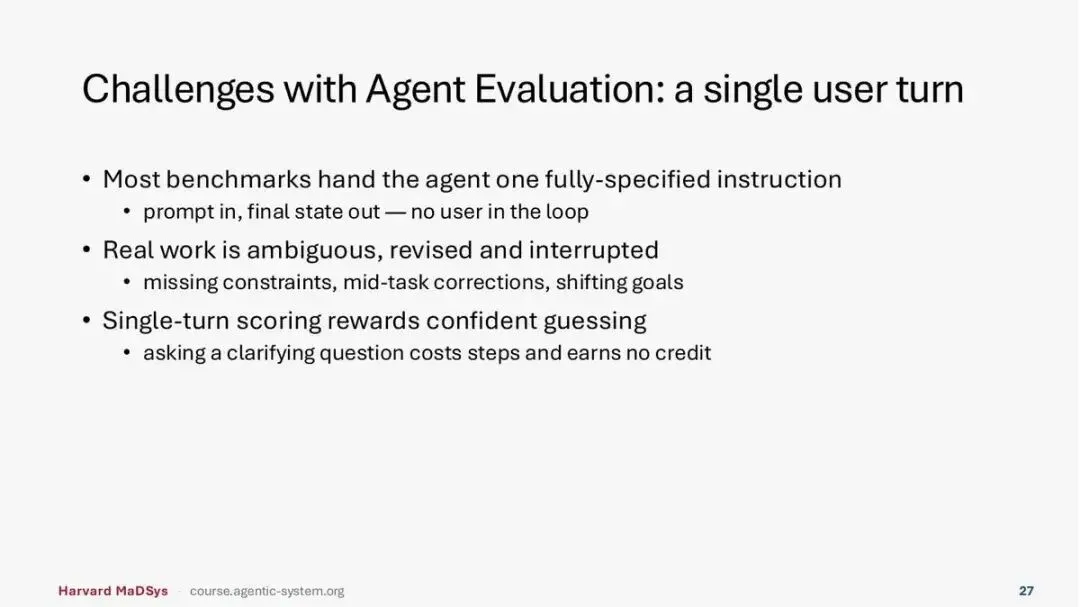
第 27 页讲第一个挑战:基准只有一轮用户输入。
大多数基准给 agent 一条完全说清楚的指令:prompt 进去,最终状态出来,中间没有用户。真实工作是含糊的,会被修改,会被打断:约束没说全,做到一半被纠正,目标在变。单轮打分奖励自信地猜:问一句澄清要多花步数,却拿不到分。
 CS2680 第 7 讲课件 · 第 28 页
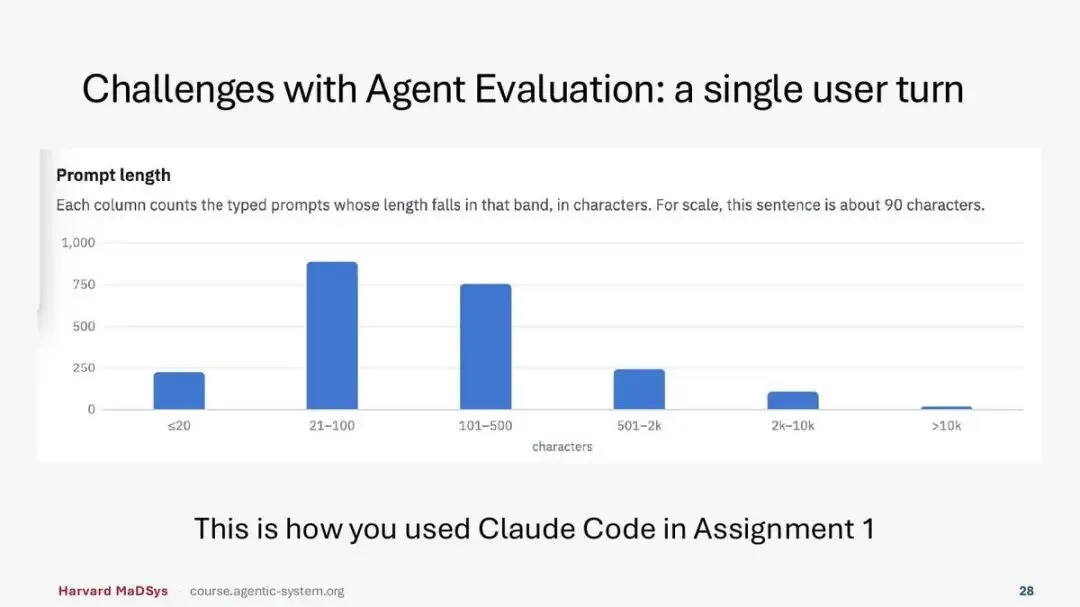
第 28 页是一张柱状图,标题是 prompt 长度,统计学生在 Claude Code 里手打的每条 prompt 有多少字符。图注说,这句说明文字本身大约 90 个字符。
21 到 100 个字符的最多,接近 900 条;其次是 101 到 500 个字符,约 750 条;不超过 20 个字符的,501 到 2k 的,各两百多条;2k 到 10k 的约 100 条;超过 10k 的很少。图下一句:这就是你们在作业一里使用 Claude Code 的方式。
 CS2680 第 7 讲课件 · 第 29 页
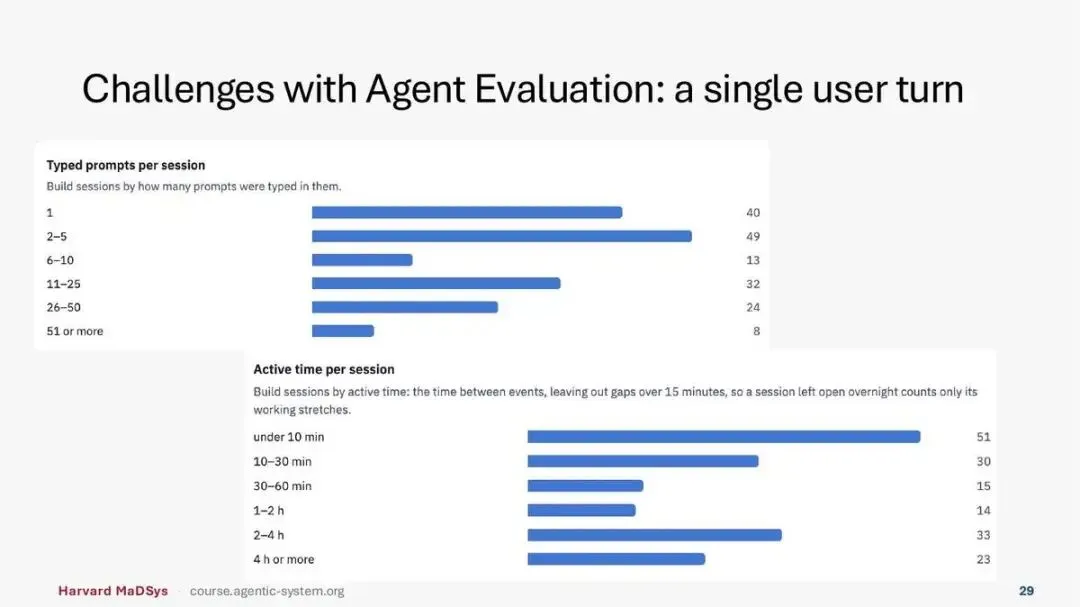
第 29 页还是作业一的数据,两张横条图。
上面是每个会话里手打了几条 prompt:1 条的 40 个会话,2 到 5 条的 49 个,6 到 10 条的 13 个,11 到 25 条的 32 个,26 到 50 条的 24 个,51 条以上的 8 个。
下面是每个会话的活跃时长。活跃时长的算法是:事件之间的间隔加起来,超过 15 分钟的空档不算,所以开着过夜的会话只算真正在干活的时间段。不到 10 分钟的 51 个,10 到 30 分钟 30 个,30 到 60 分钟 15 个,1 到 2 小时 14 个,2 到 4 小时 33 个,4 小时以上 23 个。
两张图的会话数加起来都是 166 个。课件没有在这两页写文字结论;放在「单轮输入」这个标题下,对照的是第 27 页:真实使用里,用户会在一个会话里来回输入很多次。
 CS2680 第 7 讲课件 · 第 30 页
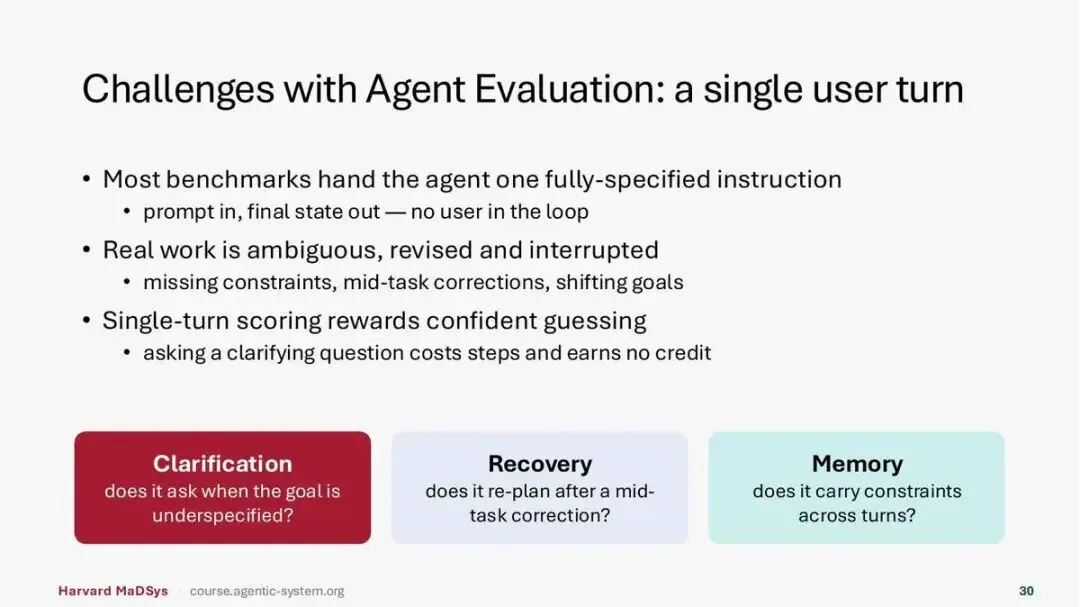
第 30 页重复第 27 页的三条,下面加了三个要测的能力。澄清:目标没说清时,它会不会问?恢复:做到一半被纠正,它会不会重新规划?记忆:约束能不能在多轮之间带下去?
九、更多挑战,以及基准饱和得有多快(第 31–33 页)
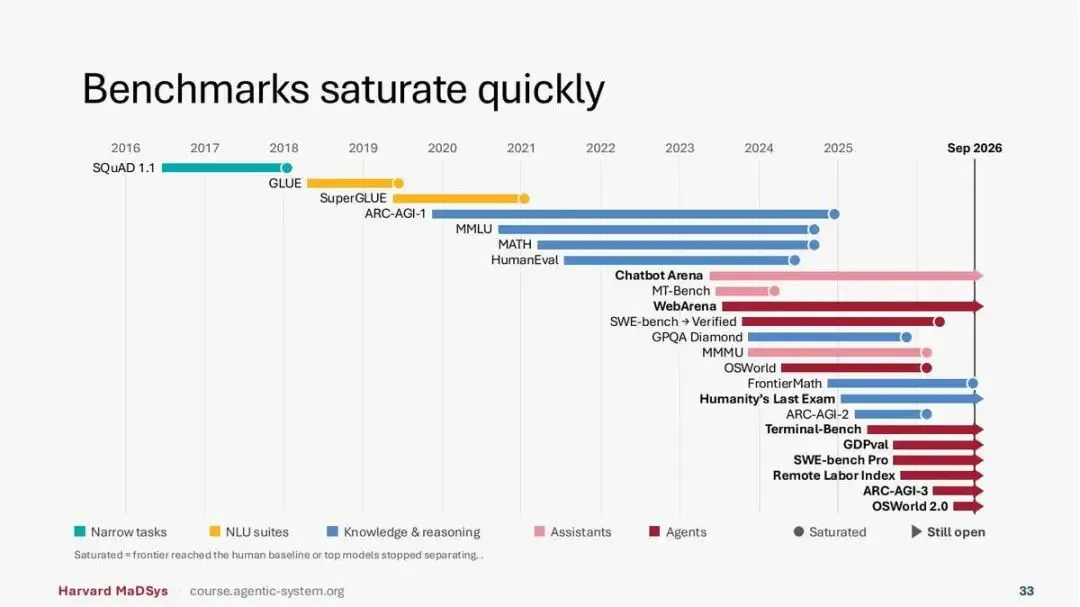
第 33 页:23 个基准里,到 2026 年 9 月还没被做饱和的有 9 个,大多是 agent 类。
 CS2680 第 7 讲课件 · 第 31 页
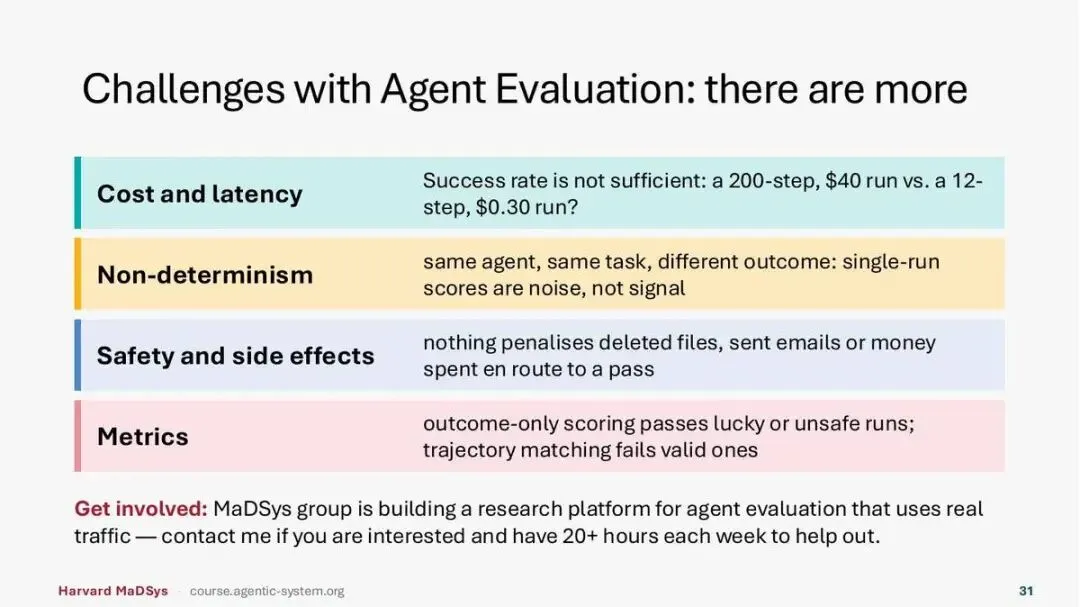
第 31 页列出另外四个挑战。
成本和延迟:只看成功率不够。一次跑 200 步花 40 美元,一次跑 12 步花 0.30 美元,都算成功,差别很大。非确定性:同一个 agent 做同一个任务,结果会不一样,只跑一次的分数是噪声,不是信号。安全和副作用:通过之前删了文件,发了邮件,花了钱,都不扣分。指标:只看结果的打分会让碰运气或不安全的运行过关;按轨迹逐步比对,又会把合理但走法不同的运行判错。
底部一条招募:MaDSys 组在做一个用真实流量评测 agent 的研究平台,有兴趣,并且每周能投入 20 小时以上的同学可以联系讲师。
 CS2680 第 7 讲课件 · 第 32 页
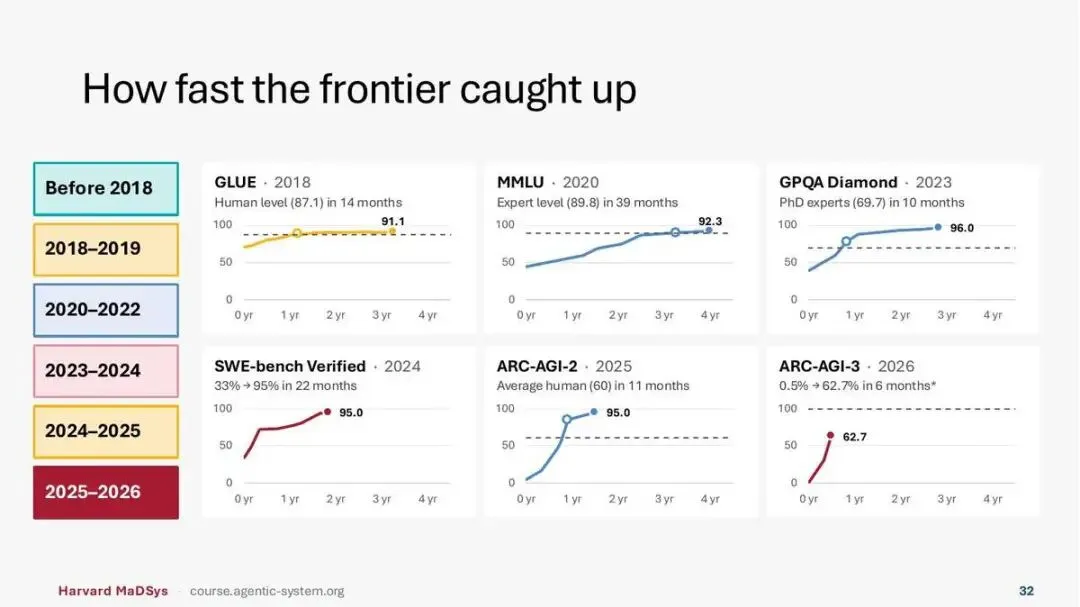
第 32 页的标题是:前沿模型追上来有多快。六张小图,每张横轴是基准发布后的年数,纵轴 0 到 100。
GLUE(2018):14 个月达到人类水平 87.1,图上最高 91.1。MMLU(2020):39 个月达到专家水平 89.8,最高 92.3。GPQA Diamond(2023):10 个月超过博士专家的 69.7,最高 96.0。SWE-bench Verified(2024):22 个月从 33% 到 95%。ARC-AGI-2(2025):11 个月达到普通人的 60 分,最高 95.0。ARC-AGI-3(2026):6 个月从 0.5% 到 62.7%,课件在这一项后面加了星号。
左边一列是第 7 页的六个时期,颜色和第 33 页的图例对应。
 CS2680 第 7 讲课件 · 第 33 页
第 33 页是一张时间线:基准饱和得很快。横轴从 2016 年到 2026 年 9 月,每个基准一根横条,从发布画到被做饱和。圆点表示已饱和,箭头表示还没饱和。颜色分五类:窄任务,NLU 套件,知识和推理,助手,agent。
图下注明饱和的定义:前沿模型达到了人类基线,或者顶尖模型之间已经拉不开差距。
已饱和的有 SQuAD 1.1,GLUE,SuperGLUE,ARC-AGI-1,MMLU,MATH,HumanEval,MT-Bench,SWE-bench(到 Verified),GPQA Diamond,MMMU,OSWorld,FrontierMath,ARC-AGI-2。截至 2026 年 9 月还没饱和的,标签加粗:Chatbot Arena,WebArena,Humanity's Last Exam,Terminal-Bench,GDPval,SWE-bench Pro,Remote Labor Index,ARC-AGI-3,OSWorld 2.0。其中 WebArena,Terminal-Bench,GDPval,SWE-bench Pro,Remote Labor Index,ARC-AGI-3,OSWorld 2.0 七个画成 agent 类的颜色。
十、评测在怎样变,作业三怎样评(第 34–36 页)
第 35 页:作业三按能力,成本,速度三个指标评,排名取帕累托前沿。
 CS2680 第 7 讲课件 · 第 34 页
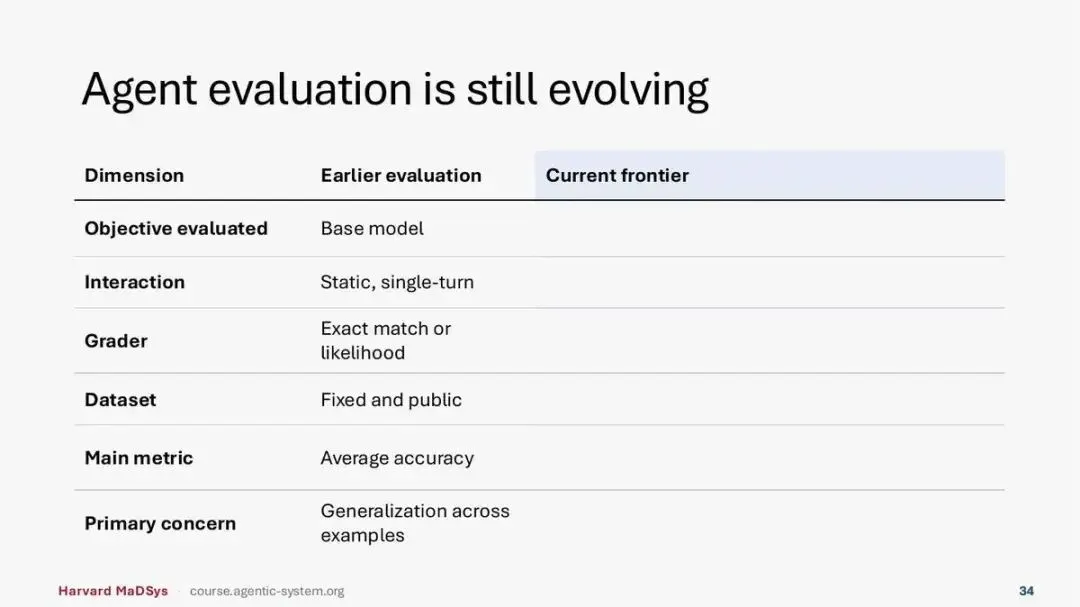
第 34 页对比早期评测和现在的前沿,六个维度。截图里右栏「当前前沿」是空的,是动画还没出来的一帧;PDF 的文字层里有这一栏的内容,我按文字层转述。
评测的对象:早期是基础模型,现在是模型加 prompt 加工具加 agent harness。交互:早期是静态的单轮,现在是有状态的长程交互。打分者:早期是精确匹配或似然,现在是测试,环境状态,人或裁判模型。数据集:早期固定且公开,现在是新的,隐藏的,动态的,或考虑了污染问题的。主要指标:早期是平均准确率,现在除了任务成功,还看系统效率,可靠性,质量,成本和延迟。主要关心的问题:早期是能否在样本之间泛化,现在是在真实约束和安全要求下能否稳健地完成。
 CS2680 第 7 讲课件 · 第 35 页
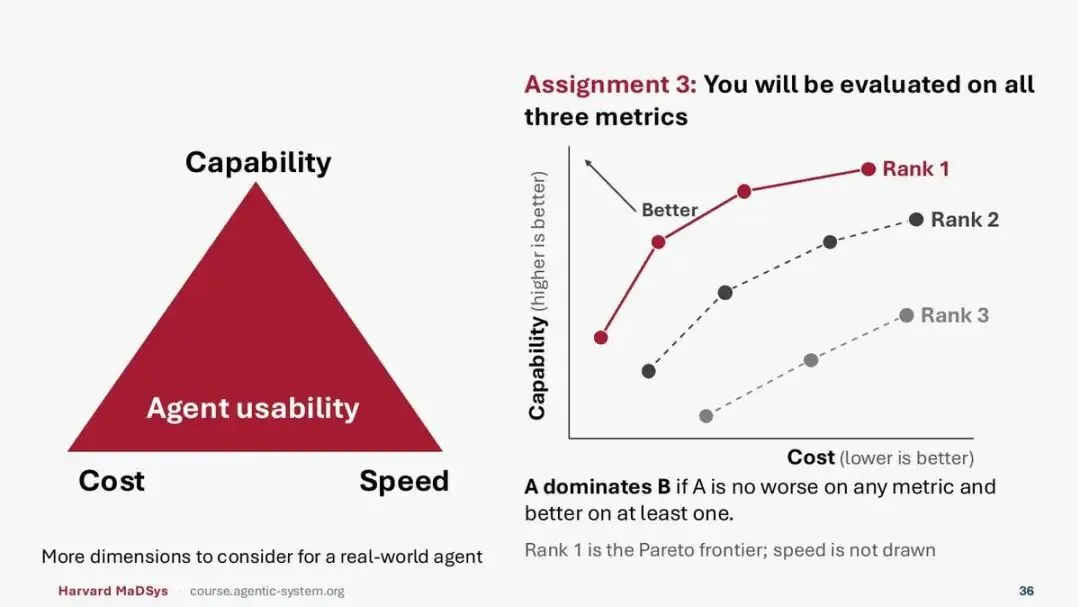
第 35 页讲作业三怎样评分。左边是一个三角形,三个角是能力,成本,速度,中间写「agent 可用性」,下面一句:真实世界的 agent 还要考虑更多维度。
右边标题:作业三,你们会在这三个指标上全部被评。图的纵轴是能力,越高越好;横轴是成本,越低越好;左上角的箭头指向「更好」。三条折线从上到下是第 1 名,第 2 名,第 3 名。
下面的定义:如果 A 在每个指标上都不比 B 差,并且至少在一个指标上更好,就说 A 支配 B。第 1 名是帕累托前沿;图上没画速度。
补充帕累托前沿是所有「没有被任何别人支配」的点。前沿上的点之间无法简单比较高低,只能说各有取舍:有的更便宜,有的更强。第 2 名是去掉第 1 名之后剩下的点里再取一次前沿,依此类推。官网课表上作业三叫 Mads-Opt: Make every token count,10 月 5 日发布。
 CS2680 第 7 讲课件 · 第 36 页
第 36 页预告下一讲:低成本的 agent,案例研究,不同类型的 agent,agent 框架。第 37 页是空白页。
最后
这一讲的内容可以收成五条,都能在课件里找到原话。
第 6 页:评测 agent 有两种看法,组件级看规划,工具,记忆,错误恢复;端到端看成功率,成本,延迟。
第 11 页:基准评测都是同一个循环,差别在评估器拿什么打分:最终答案,最终环境状态,还是轨迹。GAIA 只看答案;WebArena,OSWorld,SWE-bench,Terminal-Bench 看最终状态;τ-bench 看数据库状态加回复;TheAgentCompany 按检查点给部分分。
第 19 页:pass^k 要求 k 次全部成功,比 pass@k 严格;第 31 页:只跑一次的分数是噪声。
第 26 页:泄漏可能出现在 agent 栈的每一层,「模型没在测试集上训练过」远远不够。
第 27 页和第 33 页:大多数基准只给一轮完整指令,奖励自信地猜;基准饱和得很快,2026 年 9 月还开着的大多是 agent 类。
官网为这一讲列的阅读是一份参考资料,标题是 Agent evaluation and benchmarks:
https://cs2680.com/notes/agent-evaluation
补充第 6 讲课件第 2 页说明过,这类参考资料由 AI 生成,读物清单由讲师挑选,资料由讲师和助教审过。官网课表上,10 月 5 日是 Snowflake 的 Harsh Nilesh Pathak 的客座讲座,讲企业场景里怎样开发和评测 agent,没有挂课件;下一份课件是 10 月 7 日的「Advanced agent design I: Cost and performance」,也就是本系列第 8 篇。
本文是哈佛 CS2680《Modern AI Systems: Agents and System Optimizations》(Fall 2026)第 7 讲课件的逐页讲解,非官方笔记,内容以课件为准。课件版权归讲师 Juncheng Yang。课程主页 https://cs2680.seas.harvard.edu/ ,本讲课件 PDF https://cs2680.seas.harvard.edu/slides/7_agent_design_4.pdf 。
