滤波落地最费时间的,不是写算子,是给参数。
σ 取多大、窗口选几、阈值定多少——这串数字定不好,前面算法全白做。这篇把两条路线摊开讲:经验公式和网格搜索,各自的真实代价是什么。
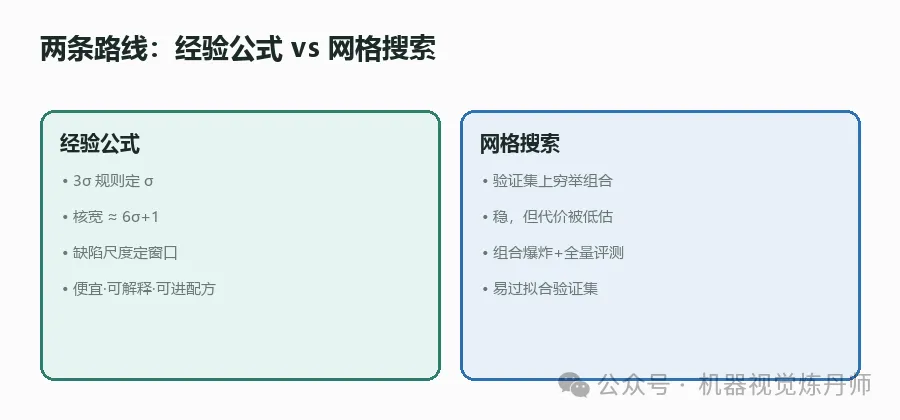
结论先说:经验公式便宜、可解释、能进配方,但只保证「不离谱」。网格搜索稳,代价却被普遍低估——组合爆炸、每格全量评测、还易过拟合验证集。工程上推荐两级法:经验定区间,小范围粗搜,只微调 1~2 个关键参数。并且,参数必须随算子一起进配方、进账本,否则换机器复现不出来。
一、参数三件套:σ、窗口、阈值
滤波要填的空,本质就三个。
σ 决定平滑多狠;窗口决定看多大一片邻域;阈值决定什么算「过」。
高斯类的 σ 和窗口是绑定的:σ 一大,支撑域变宽,窗口不够就截断、边缘糊。
形态学那一支(呼应 seq33 结构元尺寸),定的是结构元的形状与边长。
阈值类(二值化、迟滞、非极大抑制)更直白:给个数,超了就留、低了就删。
可换光照、换相机,那个「刚好」的数就飘了。
二、经验公式:便宜、可解释、可进配方
经验公式就是几条教科书规则,先把参数圈进「不离谱」的区间。
① 3σ 规则:高斯核有效范围取到 3σ,外面权重已可忽略。
② 核宽 ≈ 6σ+1(向上取奇):罩得住 3σ,又不浪费。
③ 缺陷尺度→窗口:想保住的最小缺陷约多大,窗口就别小于它。
这套的好处是能进配方:标准作业里写死「σ=1.5、窗口 11×11」,新人照配就行。
它不保最优,但保不离谱、可解释、可审计。
三、网格搜索:稳,但代价被低估
网格搜索的直觉朴素:验证集上把参数组合穷举一遍,选指标最好的那个。
它确实稳,尤其参数之间耦合不强的时候。
但代价被严重低估,三笔账:
一是组合爆炸,σ、窗口、阈值各取 10 档,就是 1000 组。
二是每格都要跑一遍全量评测,1000 组乘全图集,时间肉眼可见。
三是过拟合验证集——缺陷样本很少时,「搜出的最优」往往只对那几张图最优。
最坑的是最后这笔:验证集本该小、该精,你却拿它当训练目标反复挑。
换批缺陷进来,那个「最优」立刻不最优。
四、两级法:把两条路线拼起来
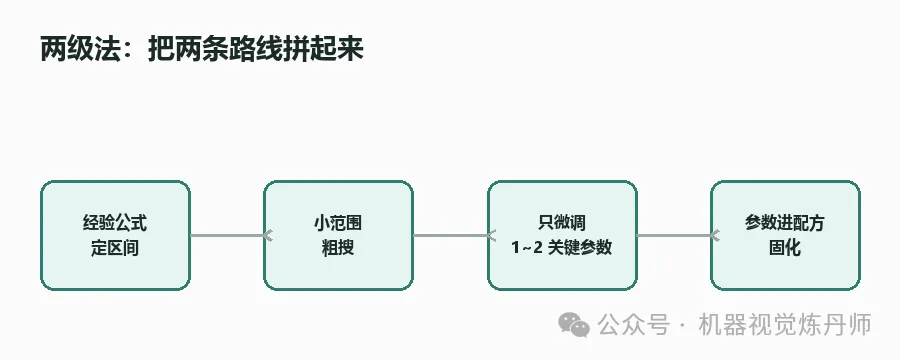
工程上的解不是二选一,是两级。
第一级,经验公式定区间:用 3σ、核宽、缺陷尺度,把 σ、窗口框到合理范围。
这一步把搜索空间砍掉九成。
第二级,小范围粗搜:只在经验区间内,对 1~2 个关键参数做稀疏网格。
别全格穷举,组合已少一个数量级。
第三级,只微调:锁定其余参数,只对真正影响结果的旋钮做细调。
多数产线,真正敏感的就 1~2 个,其余用经验值足够。
五、参数必须进配方、进账本
最重要的一条常被忽略:参数不是算完就完,它必须随算子进配方、进账本。
呼应 seq39:边界怎么补、归一化怎么做,才是 bug 高发区。
而边界行为又与 σ、窗口绑死。
参数只存在某台机器的脚本里,换台机器、换个人,结果就复现不出来。
这正是 seq39 强调差分账本的原因。
我们的习惯:滤波算子交付时,这几项要一起登记进配方。
σ、窗口、阈值、边界模式、归一化方式,连同 golden 对照值。
算子能复现,前提是参数也能复现。
三问
拿任何一家的「滤波参数」来对分之前,先问三句:
参数是经验定的,还是搜出来的?
区间怎么来的,搜的空间多大?
参数进配方了吗,换机器能复现吗?
三句问完,大半「对不上」当场解决。
最后
滤波参数选得好不好,决定前面算法是白做还是真用。
经验公式保不离谱、可进配方;网格搜索稳但代价被低估,尤其怕过拟合验证集。
两级法把二者拼起来:经验定区间,粗搜关键参数,只微调 1~2 个。
且参数随算子进账本。
把数字写进配方,让账本替记忆干活,才是算子库该干的事。
σ、窗口、阈值三件套,先用 3σ 与缺陷尺度定区间(便宜、可解释、可进配方)。真正敏感的参数通常只有 1~2 个,小范围粗搜即可,别全格穷举。最贵的一笔是过拟合验证集——缺陷少时「搜出的最优」只对那几张图最优。参数必须随算子进账本,否则换机器复现不了。下一篇到算法线:《二值化全家桶:固定阈值、Otsu、自适应》。同一张图,三种阈值法结果能差出多少?差在光照还是噪声。方法背景:3σ 规则、核宽≈6σ+1,迟滞与非极大抑制,均为公开教科书级结论。本文未引用任何自研或第三方实验基准数字。两张插图均为自绘示意,未使用论文原图或数据集图片。本文仅陈述公开算法原理与通用工程判断,不涉及自研实现细节。观点仅代表作者,与任何厂商无关。