NeurIPS 2025 数据集与基准 track 收录了一篇中医方向的工作:TCM-Ladder,首个面向中医大模型的多模态问答基准,由密苏里大学与上海中医药大学等机构合作构建。数据集包含 52,169 个问答实例,其中文本问答 21,326 题、诊疗长文本对话 25,163 段,另含图像、音频、视频模态,榜单在 tcmladder.com 持续更新。
论文用同一个基准测试了 9 个通用域大模型与 5 个中医专用模型,并请两名高级职称中医师作人类基线。结果有些意外:人类 top-1 准确率 64%,比表现最好的模型还低约 4 个百分点。
一、现有中医评测缺什么
主流医学评测基准以西医为核心,MedQA、MIMIC-CXR 等覆盖的是现代临床任务。中医特有的辨证论治、症状诊断与方药配伍,在这些基准里没有对应位置。
中医方向的已有基准各有短板。TCMBench 从执业医师考试整理了 5,473 题,纯文本;TCM-3CEval 构建 4,000 余题的三轴认知评测,同样纯文本;ShenNong 用知识图谱加 GPT-3.5 生成 113,000 条指令数据,规模大但未经专家验证;MedBench 收录 40,041 题,是当前最全的中文医疗评测平台,但中医仅占一部分,且 API 访问受限。
把这些基准放在同一张表里,缺口很清楚:多模态与专家验证很难同时满足。舌象、草药图谱、脉诊音频这些临床常用的信息形态,此前没有进入任何统一基准。
二、五个来源拼出一个多模态数据集
TCM-Ladder 的文本部分覆盖 7 个子学科:基础理论、诊断学、方剂学、内科、外科、中药鉴定学与儿科学。
图像部分有两个主力。草药图像 6,061 张,按 1998 年版《中药药理学》收录的药名从公开资源收集,并由团队在中药制药企业实拍补充。舌象 1,394 例由上海中医药大学的舌诊仪采集,设备能提供稳定一致的光照条件;另一部分来自该团队此前的 iTongue 项目。舌象采集通过了所在机构伦理审查,为保护贡献者隐私,仅公开部分图像图块与对应标签。
视频与音频填补剩余模态。49 段视频由上海中医药大学针灸推拿学院教师录制,演示推拿与针刺的操作要领;6,420 段音频来自公开数据集,包含咳嗽、语音与脉搏信号。按论文统计表汇总,全部问答对的答案共 238,867 条,图像合计 7,455 张。
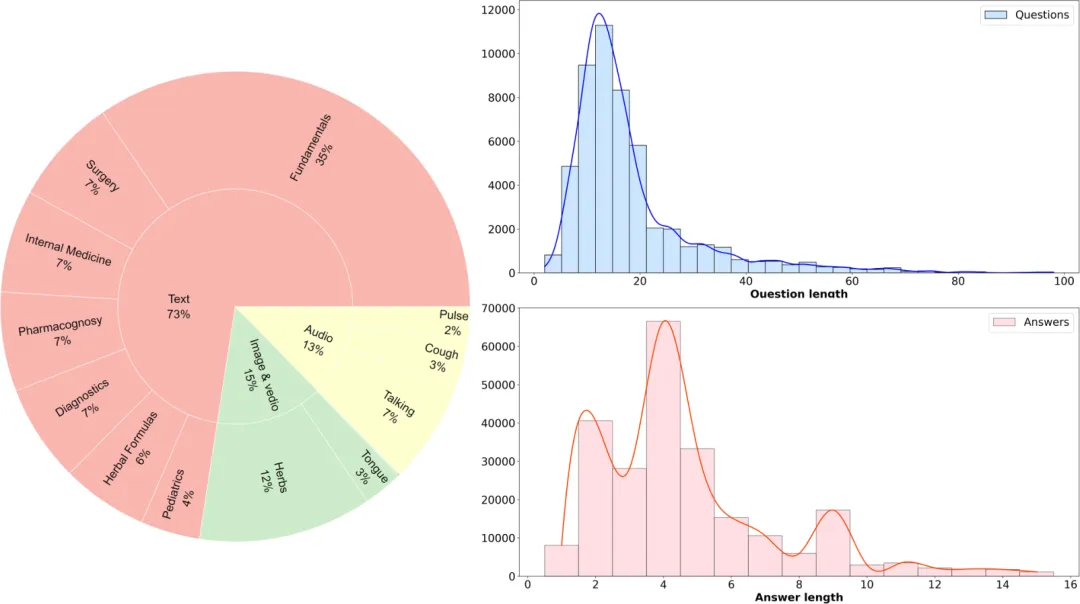
论文原图 Figure 2:数据分布与问答长度统计,文本占 73%;来源:Xie et al., TCM-Ladder, NeurIPS 2025 Datasets and Benchmarks Track,CC BY 4.0
三、题目怎么造、怎么审
文本问答来自两条线。第一条是 5,000 题由持证中医师按统一的命题协议手写,每道题再由另外两名中医师独立审核定稿;第二条来自国家执业医师资格考试与公开在线资源。
视觉问答混合了人工与自动两种构建方式。人工部分由领域专家从草药图库中选图命题;自动部分走模板管道,以标注正确的草药图作为答案,从知识库随机抽取 3 张干扰图,套用「下列哪张图显示的是黄芪」一类模板生成题目。舌象任务采用同样做法。
汇总后做三重去重:字符串编辑距离、TF-IDF 余弦相似度、BERT 语义编码,删除高度相似的题目,再由两名持证中医师人工复核全部问答对。最终数据按 80%、10%、10% 切分为训练、验证与测试集。
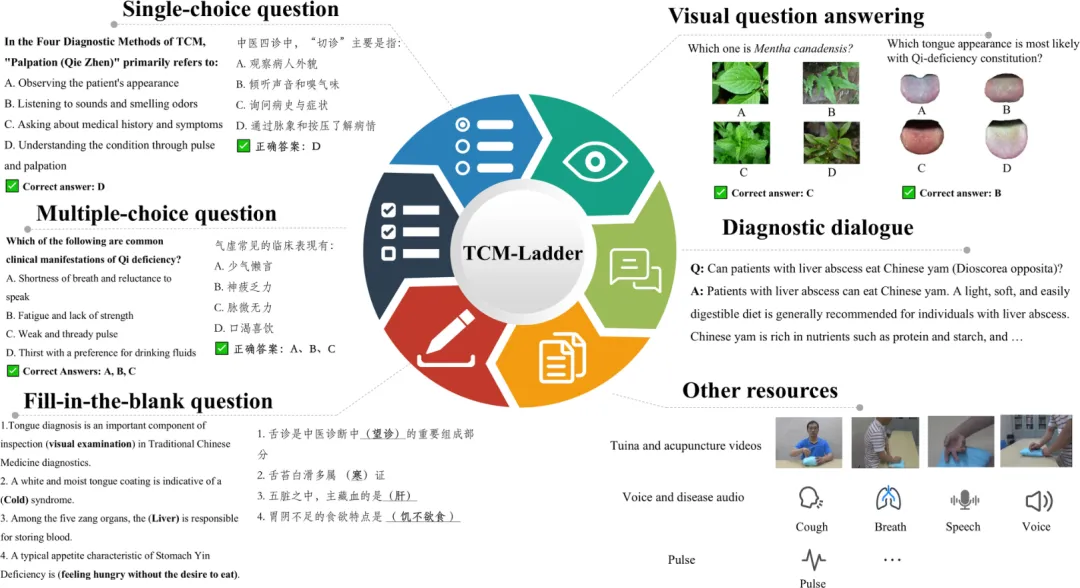
论文原图 Figure 1:TCM-Ladder 六类任务总览;来源:Xie et al., TCM-Ladder, NeurIPS 2025 Datasets and Benchmarks Track,CC BY 4.0
四、Ladder-Score:给开放式回答打分
诊疗对话与填空属于开放式生成任务,回答措辞多样但可能同样正确,BLEU 与 ROUGE 这类基于字面重叠的指标会低估语义等价的回答。
论文提出 Ladder-Score,由两项加权合成:TermScore 衡量中医术语使用的准确性与完整性,SemanticScore 由大模型按逻辑一致性、语义准确性、知识全面性与表达流畅度打分。默认权重 0.4 与 0.6,可按实际需要调整。
Ladder-Score 的形式化定义
Ladder-Score = 0.4 × TermScore + 0.6 × SemanticScore
TermScore 评估中医术语使用的准确性与完整性;SemanticScore 由大模型按逻辑一致性、语义准确性、知识全面性与表达流畅度评分。权重可按需调整。
五、主结果:专用模型领先,通用模型分化
文本单选与多选上,作者基于 Qwen2.5-7B-Instruct 用 GRPO 训练的 Ladder-base 在全部学科取得最高总体准确率,中药鉴定、方剂与儿科的 exact match 超过 0.85。通用模型里 Gemini 2.5 Pro、DeepSeek 与 Qwen3 表现稳定,在 0.65 至 0.75 之间;Claude 3、GPT-4o mini 与中医专用模型 BenTsao 在外科、儿科等临床细分领域明显偏弱。
诊疗对话任务上,Ladder-base 取得最高 BLEU-4 0.0249 与 ROUGE-L 0.2431,Ladder-Score 0.803;Qwen3 拿到最高 Ladder-Score 0.861。填空任务中,基于 ChatGPT 微调的 BenCao 以 0.9034 的准确率居首。对比之下,同为专用模型的 BenTsao 填空准确率只有 0.1620,低于多数通用模型,说明「中医专用」这个标签并不保证领域性能。
视觉任务进一步拉开差距。BenCao 草药识别超过 80%,舌象分类超过 65%;Gemini 2.5 Pro 等通用模型草药识别在 65% 至 75% 之间,舌象降至 50% 至 60%;GPT-4o、Claude 3、Kimi k1.5 与 Grok 3 的舌象准确率不足 40%。Ladder-base 与 Zhongjing 因架构不支持图像输入,未参与该项评测。
训练成本也有参照价值:Ladder-base 的 GRPO 阶段在两块 A100 80GB 上跑了约 60 小时,2 轮 epoch、组大小 6、批大小 12。一个 7B 模型加上约 60 小时的强化学习,就能在全部学科压过通用旗舰模型,这是专用微调性价比的直接证据。
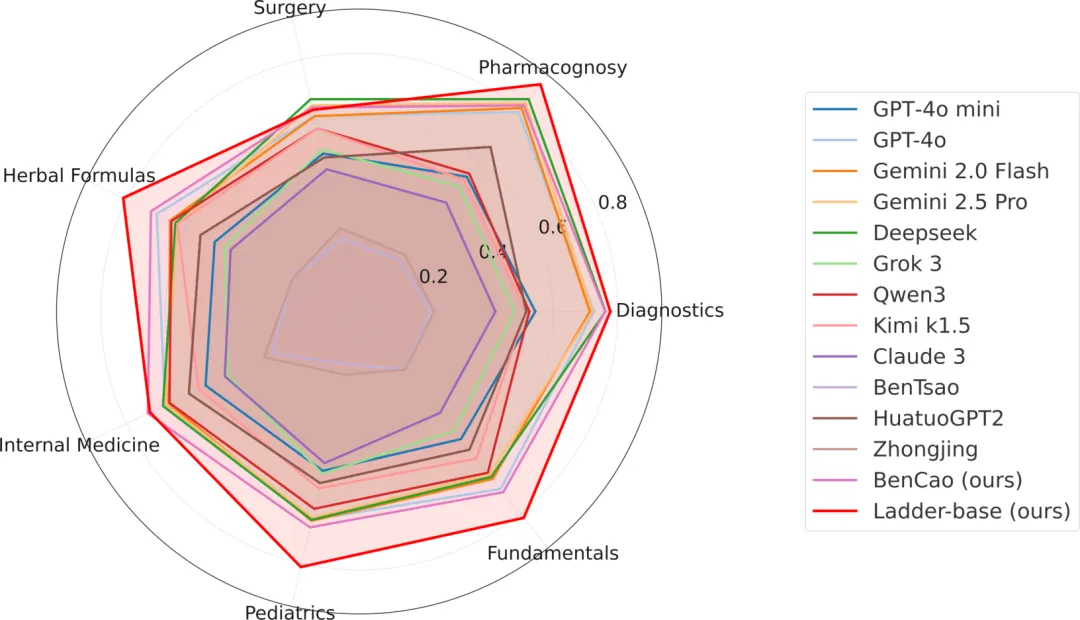
论文原图 Figure 3:各模型在文本单选与多选任务上的表现;来源:Xie et al., TCM-Ladder, NeurIPS 2025 Datasets and Benchmarks Track,CC BY 4.0
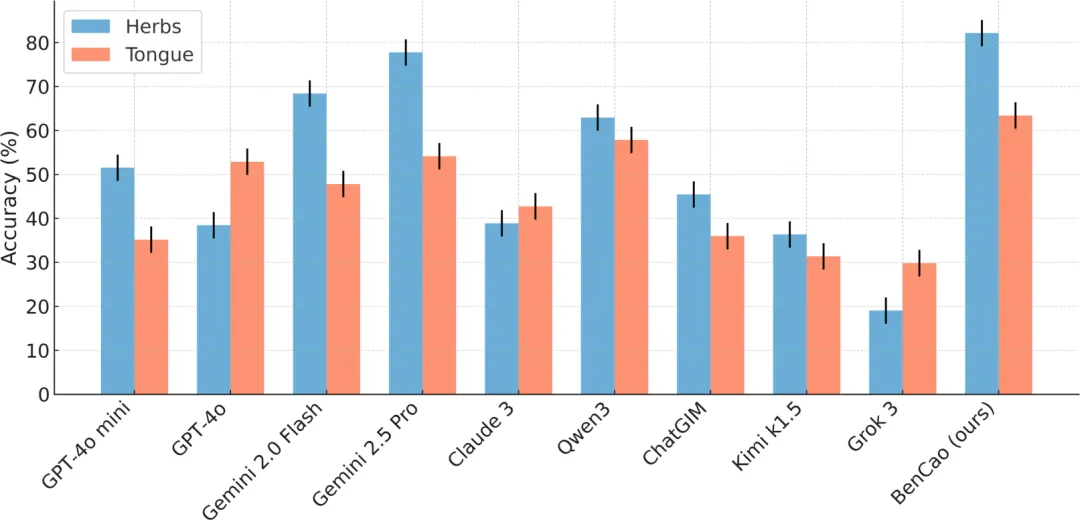
论文原图 Figure 4:各模型在草药识别与舌象分类任务上的表现;来源:Xie et al., TCM-Ladder, NeurIPS 2025 Datasets and Benchmarks Track,CC BY 4.0
六、人类 64% 意味着什么
人类评估由两名未参与数据标注的高级职称持证中医师完成,覆盖 20% 测试集。两人 top-1 准确率为 64%,比表现最好的 BenCao 低约 4 个百分点。
论文把原因说得很直接:基准横跨 7 个学科,任何单一专家都难以在全部领域保持高置信度。两位医师反馈,仅凭图像识别草药尤其困难,同一味药在生品、饮片、煎剂等形态下外观差异很大,这类任务更接近药店药剂师的执业范围,而非临床医师。
因此 64% 不能读成「模型超过中医师」。它说明的是这个基准对人类同样困难,跨学科评测的人类上限本身难以确立。另需注意,受 API 成本限制,全部评测仅单次运行,论文在检查清单中自承未提供统计误差。
七、局限与适用边界
论文在局限性一节承认:数据规模尚不足以覆盖中医知识全貌;舌诊、脉诊与嗅诊相关模态的利用仍然有限;自动生成的视觉问答是模板式题目,答案图已知、干扰图随机,难度上限存疑。
数据主要来自中国临床人群,族群与地域多样性受限,向其他人群外推需谨慎。
对中医大模型的研发者而言,TCM-Ladder 的价值在于提供了一个统一、可扩展且持续更新的评测底座;对使用者而言,这组结果提示当前中医专用模型的优势集中在结构化知识与术语任务,视觉理解与开放推理仍是短板。
论文:Xie J, et al. TCM-Ladder: A Benchmark for Multimodal Question Answering on Traditional Chinese Medicine. NeurIPS 2025 Datasets and Benchmarks Track.
数据集与榜单:tcmladder.com | 代码:github.com/orangeshushu/TCM-Ladder
本文配图为论文原图,遵循 CC BY 4.0 许可并注明出处。点击文末「阅读原文」可查看论文页面。
🗣️ 互动一下
如果你是命题人,你会给中医大模型加一道什么题?舌象、脉象还是医案?评论区聊聊。
