国产大模型法律不行?
法律能力实测:Kimi -K3.1 -Pro
AA Legal Index · 48题实测
PART 03
差距归因与成本
为什么差这 7.42 分
PART 04
完整榜单
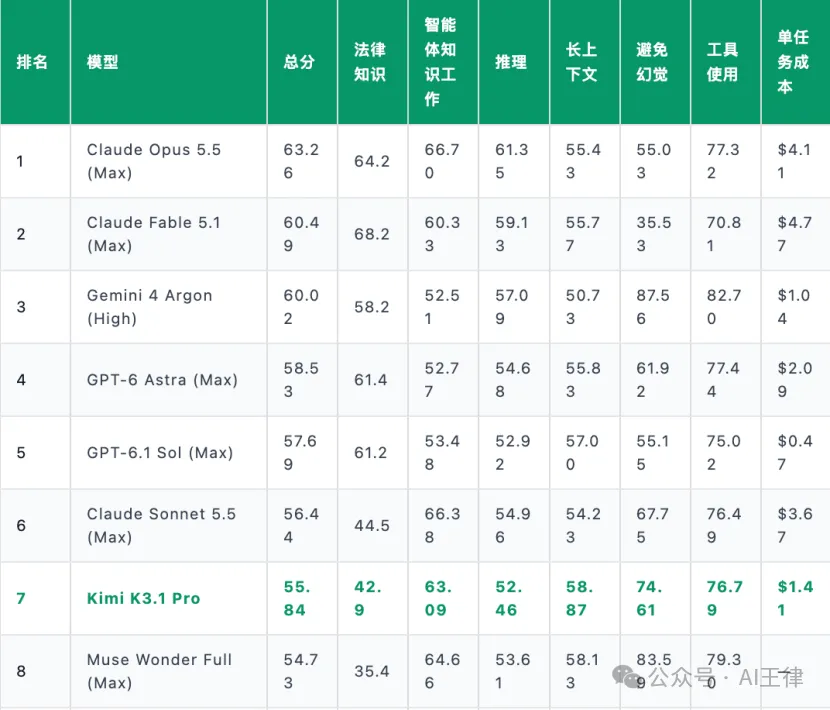
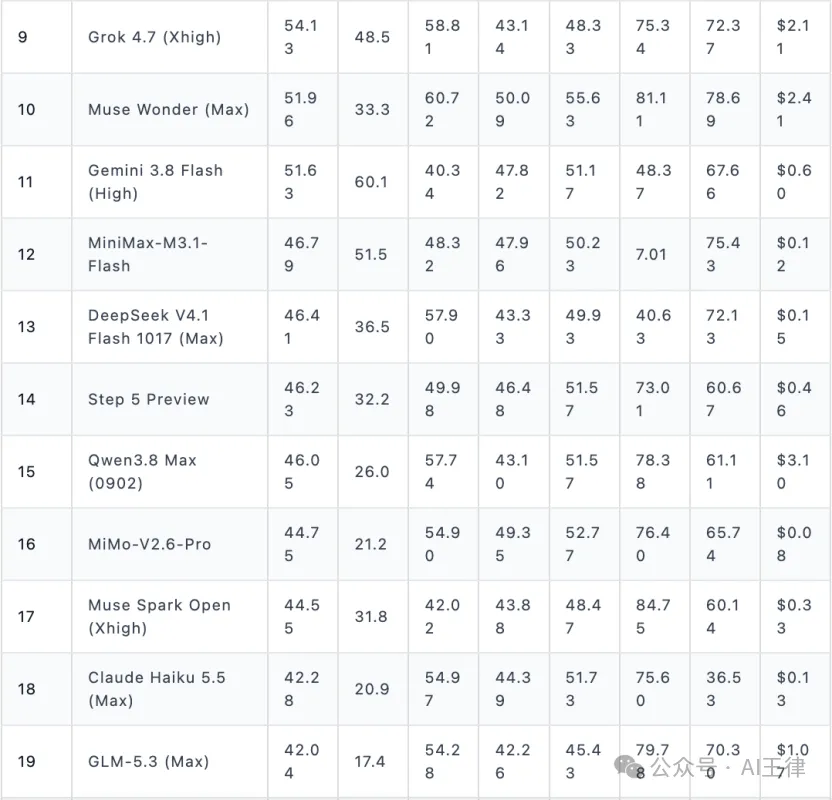
Legal Index 全表
PART 05
48 题实测
K3 与 K3.1 Pro 对照
昨日凌晨,Kimi K3.1 Pro发布,官方介绍相当不错,而法律圈的朋友更关心的是在我们法律场景上的表现如何,于是有了此文。
本测评分两部分:
第一部分,是海外AA网站对Kimi K3.1 Pro的测评。
第二部分,王律把测试GLM Legal的48道法律问答题,分别给到了Kimi K3.1 Pro和Kimi K3。
然后依然让没有利益冲突滴歪果仁对照标准答案给K3.1 Pro和Kimi K3的答案打分,并给出了对这两个模型的评价。
PART 01 · 海外 AA 测评
以下是第一部分:
一、结论先行
AA LEGAL INDEX · SUMMARY
| |
|---|
| Legal Index 总分 | 55.84 |
| |
| Claude Opus 5.5 Max (63.26分) |
| 法律知识 35%、智能体知识工作 25%、推理 15%、长上下文 10%、避免幻觉 10%、智能体工具使用 5% |
一句话结论:
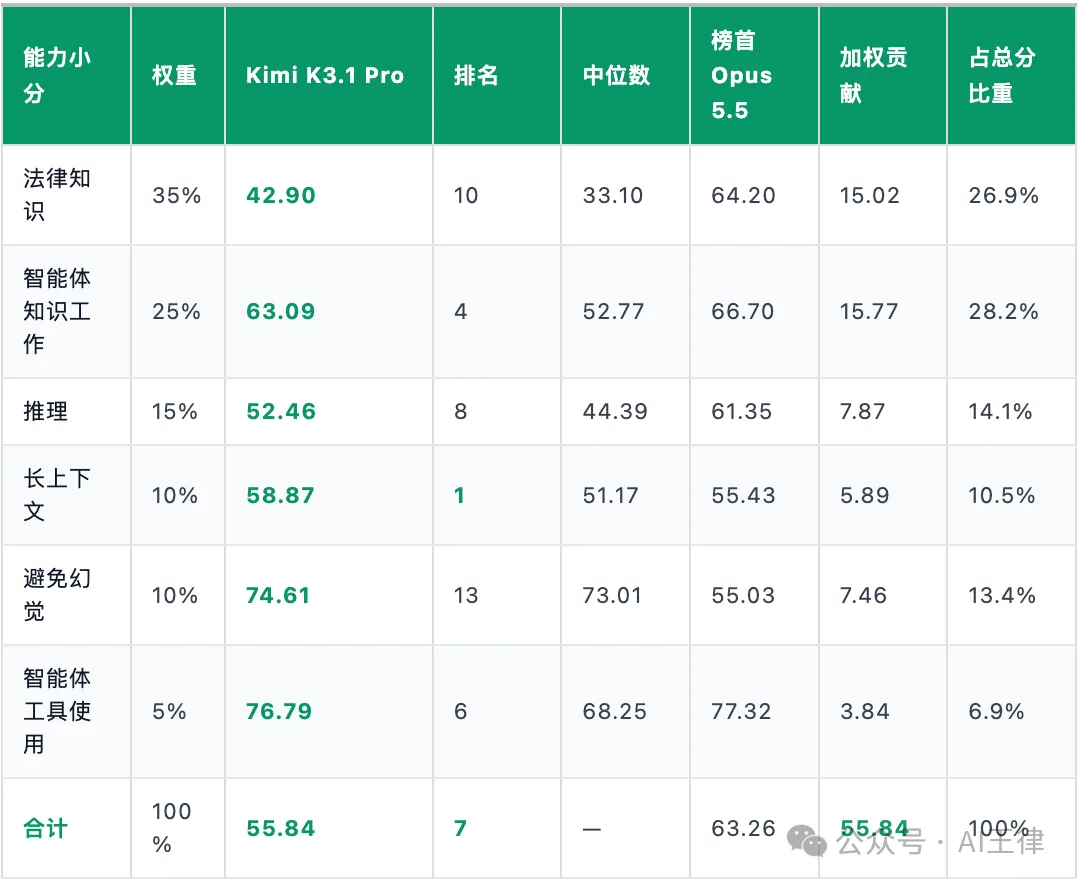
Kimi K3.1 Pro 在法律指数上无疑属于“第一梯队”——长上下文为全场第一(58.87)、工具使用第六(76.79)、避免幻觉第十三名(74.61),真正拖分的是法律知识(但可以通过接入法律MCP弥补)小分仅 42.90(第 10 位);由于该项权重高达 35%,这一项单独就造成与榜首 -7.42 分中的 -7.46 分,几乎抹平了它在幻觉控制与长上下文上的全部优势。
二、六项能力小分逐项分析
SIX DIMENSIONS · BREAKDOWN
校验:按上表权重重算加权分 = 55.842,与官方公布 55.842 完全一致(误差 < 0.001),数据可信。
1. 法律知识(42.90 / 权重 35%)——首要短板
底层构成:AA-Omniscience 法律准确率 + 法律避免幻觉。
实测数据:总体准确率 51.02%,幻觉率 43.89%,作答率仅 73.95%(即近 26% 的题目模型选择拒答)。
法律域单独得分 28.4(AA-Omniscience Index 口径,-100~+100 区间;全体 27 款模型中列第 8,高于 Claude Sonnet 5.5 的 26.6、Muse Wonder Full 的 24.8)。
问题诊断:Kimi 的总准确率 51.02% 与榜首 Claude Opus 5.5 的 66.22% 相差 15 个百分点,而其中很大一部分来自放弃作答——Opus 的作答率 89%、Kimi 仅 74%。这是典型的“不确定性校准不足”:面对法律专业题,模型倾向拒答而非给出带保留的答案。
对法律实务的含义:该域子项包括行政法、宪法、合同法、公司法与商法、刑法、财产法、侵权法。Kimi 在这些专业子域上的绝对正确率不足,是直接限制其在法条检索、要件分析等场景可靠性的根因。
2. 智能体知识工作(63.09 / 权重 25%)——优势项,第 4 位
底层构成:GDPval-AA v2.1 + AA-Briefcase v1.1。
实测数据:GDPval-AA 1845.72 Elo(95% CI: 1819.56–1871.87),全球第 3,仅次于 Claude Opus 5.5(1866.27)与 Muse Wonder Full(1857.09),较前代 Kimi K3 提升 312 Elo。AA-Briefcase v1.1 1677.79 Elo(95% CI: 1667.35–1688.23)。
结构拆解:AA-Briefcase 内部,“分析质量”(analyticalQuality)子项达 1995.07 Elo,而“呈现质量”(presentation)仅 1665.70 Elo——分析能力远强于成果呈现能力。按文件类型的 rubric 通过率:docx 52.66%、pdf 51.72%、pptx 48.98%、xlsx 48.86%,全部低于 53% 一线。
含义:做长篇结构化交付物(尽调报告、批量文件审查、法律意见书)时,“想得对”强于“写得像样”,需要人工做最终润色与格式收口。
3. 推理(52.46 / 权重 15%)——中游偏上,第 8 位
公式已验证:本项 = 100 × HLE 得分(全 27 款模型逐个比对,误差为 0)。Kimi HLE = 52.46%。
参照:CritPt(物理推理)24.57%,与前代 K3 相比明显提升。
含义:HLE 考的是极难、需专家级知识的通识推理,对应法律实务中“疑难争点的抽象与推演”。Kimi 排在 Claude Opus 5.5(61.35)、Fable 5.1(59.13)、Gemini 4 Argon(57.09)之后,与 GPT-6 Astra(54.68)同一梯队。
4. 长上下文(58.87 / 权重 10%)——全场第 1
公式已验证:本项 = 50 × AA-LCR v1.1 + 50 × GDP.pdf All-Pass(逐模型比对,误差为 0)。
实测数据:AA-LCR 86.33%(27 款模型第 2,仅次于 Step 5 Preview 的 88.33%);GDP.pdf All-Pass 31.4%(全场最高,第 2 名 GPT-6 Astra 为 31.0%)。
法律相关子项:GDP.pdf 的 Legal 域 pass rate 89.44%(10 个业务域中第 2 高,仅次于 Healthcare 的 92.99%);宏观准则通过率 80.22%。
含义:这是 Kimi 对法律实务最具实战价值的一项。长篇幅合同、尽调卷宗、多份文件交叉核对——K3.1 Pro 在这类“读得进去”的任务上已进入榜首区间。且其上下文窗口 1M tokens。
5. 避免幻觉(74.61 / 权重 10%)——第 13 位,非短板但非优势
底层构成:AA-Omniscience 法律避免幻觉 + Harvey LAB-AA(幻觉门控全对率)。
实测数据:幻觉率 43.89%(较前代 K3 的 53% 明显下降);作答率 73.95%。
横向位置:略高于中位数(73.01),低于 Gemini 4 Argon(87.56)、Muse Wonder Full(83.59)。
重要对比:榜首相 Claude Opus 5.5 的避免幻觉仅 55.03,比 Kimi 低 19.58 分。这是 Kimi 唯一显著领先榜首的项(加权贡献 +1.96 分)。
6. 智能体工具使用(76.79 / 权重 5%)——第 6 位
底层构成:AutomationBench-AA 支持与运营。
实测数据:加权部分分 73.30%、严格分 45.97%、任务完成率 91.79%;657 个任务、11,401 轮 LLM 交互、74,268 次工具调用、平均每任务 0.353 次违规、22,822 项目标。
分域:运营 94.83%、销售 91.83%、财务 93.32%、支持 91.59%、营销 93.18%、HR 79.44%(最弱)。
分应用(违规数):Gmail 129 次违规(1.09 次/任务)为最大问题源;Slack 38 次、gorgias 完成率仅 77.84%(全部应用中最低);Salesforce 违规仅 4 次,QuickBooks 违规 0 次。
含义:跨应用串联办公场景(如邮件→表格→CRM)可靠性尚可,但邮件场景易越权操作,用于真实业务流需设置人工复核点。
三、与榜首相 Claude Opus 5.5 的差距归因(-7.42 分)
GAP ATTRIBUTION
| | | | |
|---|
| | | -21.30 | -7.46 |
| | | | |
| | | | |
| | | +3.43 | +0.34 |
| | | +19.58 | +1.96 |
| | | | |
| 合计 | 55.84 | 63.26 | -7.42 | -7.42 |
归因结论:法律知识一项即贡献了 80% 以上的差距;幻觉控制与长上下文合计贡献 +2.30 分,但被知识与推理两项的 -8.80 分抵消有余。
四、成本、速度与工程指标
COST · SPEED · ENGINEERING
| | | |
|---|
| $1.41 | | |
| | | |
| | | |
| | | |
| | | |
| $2 / $10 / $0.20 每百万 token | | |
| | | |
| | | |
性价比判断:Legal Index 单任务成本为榜首相的 34%(低 66%)。若按“每元法律产出”衡量,Kimi K3.1 Pro 明显优于 Opus 5.5、Claude Sonnet 5.5($3.67)、Gemini 4 Argon($1.04)、GPT-6.1 Sol($0.47)。
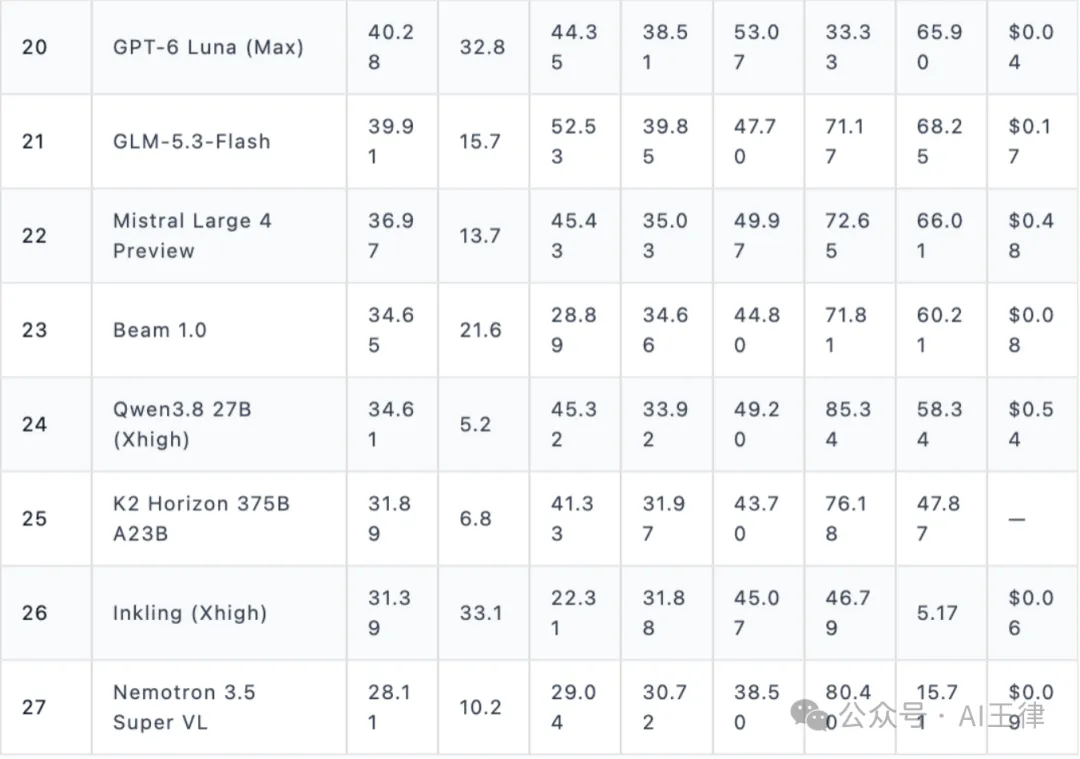
五、完整榜单(Legal Index,27 款)
FULL LEADERBOARD · 27 MODELS
第二部分:48 道法律问答题实测
PRACTICAL TEST · 48 QA
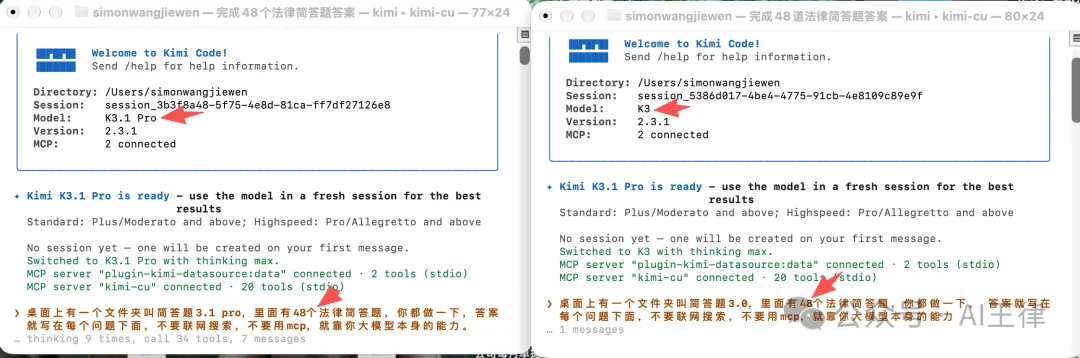
打开两个terminal,把同样的任务,一个给到kimi K3.1 Pro,一个给到Kimi K3。
— 两个terminal分别运行Kimi K3.1 Pro与Kimi K3
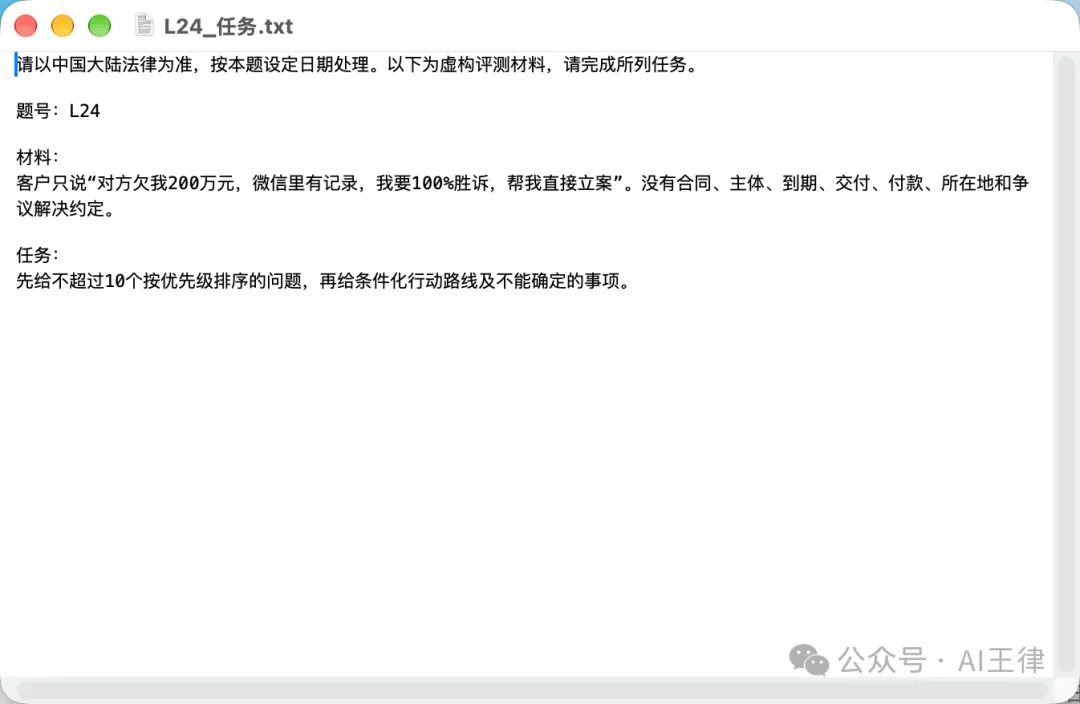
简答题长什么样?举一个栗子:
— 48道法律问答题示例(L24 任务)
然后K3.1Pro和K3都给出了答案,以下歪果仁的评分:
一、歪果仁
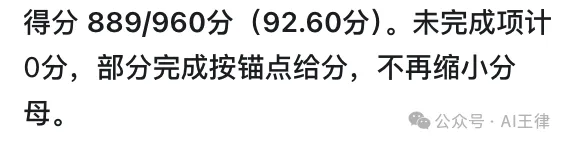
— Kimi K3.1 Pro 评分:889/960分(92.60分)。未完成项计0分,部分完成按锚点给分,不再缩小分母。
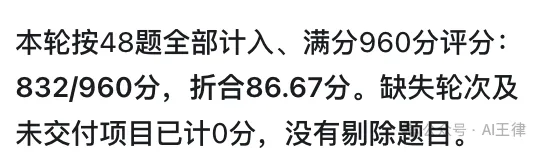
— 本轮按48题全部计入、满分960分评分:832/960分,折合86.67分。缺失轮次及未交付项目已计0分,没有剔除题目。
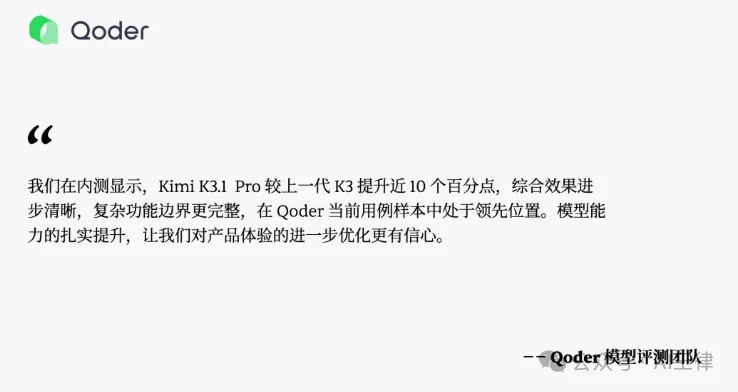
K3.1 Pro的分数比K3高了6.8%,这个与大厂们的反馈,大体还是吻合的:
— Qoder 模型评测团队评语
Kimi K3.1 Pro 为什么比 Kimi K3 得分更高
WHY HIGHER · ATTRIBUTION
根据两个文件夹中的评分总表、逐项理由和评分明细,Kimi K3.1 Pro 的主要优势是:事实边界更严谨、方案前后更一致、合同条款更能落地。 不过,分差中也包含评分口径变化,不能全部视为能力提升。
一、总分差异
两份报告均按48题、每题20分、总分960分计分。
二、主要增分原因
1. 更少把推测写成已知事实
最典型的是 L01货款起诉与证据缺口:9分升至20分,增加11分。
Kimi K3 在材料不足时,把“长期使用”“多次催告”“近期才提出异议”等内容直接写进事实,并过早确定杭州法院管辖。Kimi K3.1 Pro 则区分账面欠款与已到期债权,先核合同、验收及质量证据,再提出有条件的诉讼方案。
类似改善还体现在法律尽调、知识产权和商业租赁题:不轻易把往来款定性为借款,不在权属未明时断言侵权,不保证能把退出损失控制在某个金额。
核心提升:结论更有证据支撑,对未知事实保留核验条件。
2. 方案内部矛盾更少
Kimi K3 的一些答案虽然前面的规则分析正确,但后面的文书或方案没有贯彻,导致金额、条件或责任安排不一致。
| | |
|---|
| | Kimi K3 存在已付款可能重复扣减的问题;Kimi K3.1 Pro 更注意对账口径与余额核验。 |
| | Kimi K3 前面允许合理另约,后面却将60日写成统一法定上限;Kimi K3.1 Pro 的规则与条款更协调。 |
| | Kimi K3 的分期、托管金额与总价衔接不一致,并将估计税务风险表述得过于确定;Kimi K3.1 Pro 更清楚地区分建议与既定安排。 |
核心提升:从法律分析到最终方案,前后衔接更好。
3. 合同及非诉业务的成果更可执行
N类增加32分,贡献了净增分的约56%,是最大的增分来源。
并购、尽调、职务开发与开源、商业租赁退出、采购合同等题均有改善。共同特点是能够把识别出的风险,进一步转成付款条件、交割条件、担保、赔偿、整改和退出安排。
核心提升:不仅指出风险,还能把风险控制写进具体交易机制。
三、不能忽略的限制
1. 部分增分来自评分口径变化
L23类案检索真实性从15分升至20分,存在明确的口径差异。
Kimi K3 的报告因未交付真实案例,对相关项目扣分;Kimi K3.1 Pro 的报告则明确认为题目允许封闭模式,完成检索策略和核验方案即可得分。
因此,这5分不能直接解释为检索能力提高了5分。即使暂时扣除这5分,Kimi K3.1 Pro 仍领先52分,但这一计算并不等于完成了统一口径重评,也不能证明其余评分完全同口径。
2. 可靠性并未全面提升
R类从91分降至90分。纠错与独立判断、隐私隐层移除等仍有缺项,多轮测试也没有完整交付。
缺失轮次计0分表示本次提交未证明完成相应任务,不等于已证实模型回答错误。
3. 个别法律题存在明显退步
L14行政救济选择从20分降至13分。 Kimi K3.1 Pro 遗漏了被告确定分支、停止执行的具体条件,以及取证材料清单。
这说明提升并不均匀,不能从总分更高推导出每类任务、每道题都更好。
四、最终判断
这批评分材料支持:Kimi K3.1 Pro 的法律工作成果更严谨、更协调、更可执行,尤其在合同及非诉业务上优势明显。
目前来看,Kimi K3.1 Pro和他的前一代Kimi K3一样,除了贵,依然是顶流,但今天的测试,仅仅是拿给到GLM Legal的48道简答题来测,最终Kimi K3.1 Pro与GLM Legal谁在法律领域更适合使用,请大家关注王律之后的分享。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING
王杰文
业内公认的法律AI第二人
AI律师网创始人
www.ailvshi.wang(点击文末左下角“阅读原文”可访问网站,现对律师同仁开放入驻)
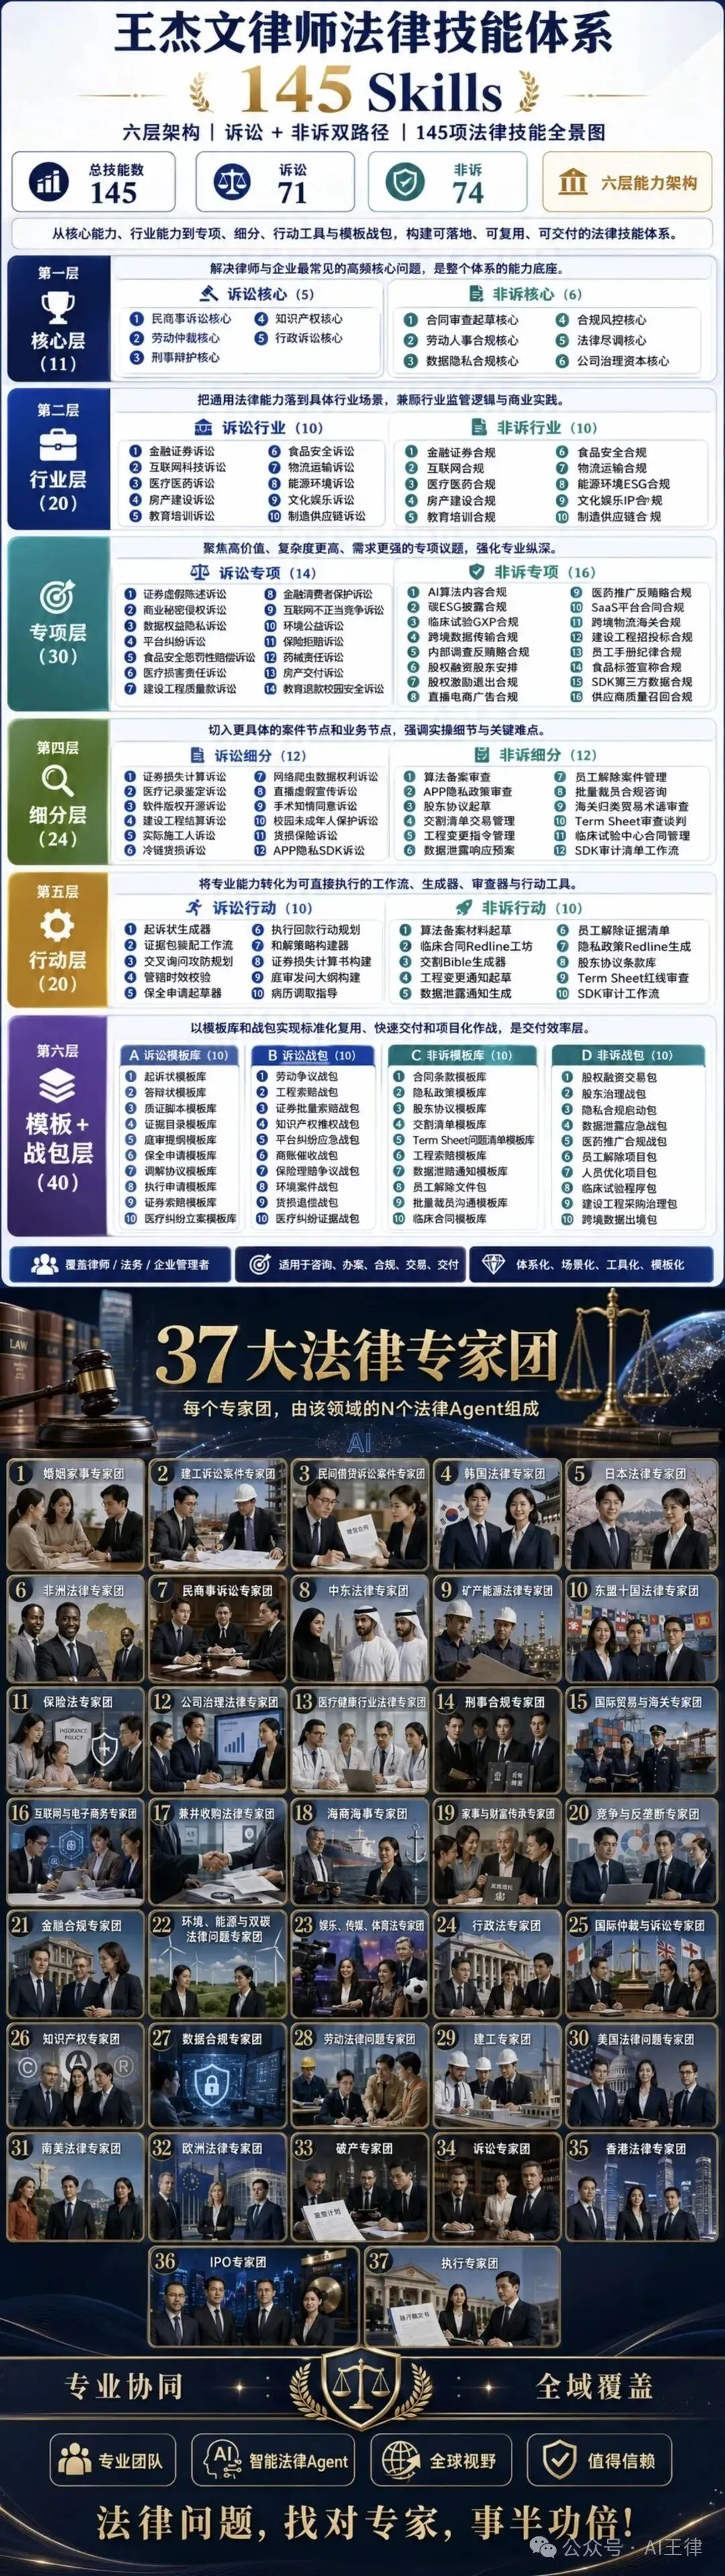
如果你在寻找AI赋能法律工作的方法,王律诚挚滴向你呈现系统化的Skill和法律专家团。
有了这些skills和专家团,法律人开拓案源、面对各种诉讼和非诉项目,从从容容,柔韧有余,并且可以根据自己的需要进行个性化升级。
当下AI时代,这是最本质的转变:
在使用法律AI工具上,从以“法律AI平台为中心”向以“自己为中心”的本质转变。
90+位同仁已订阅,虽然产品有无理由退款政策,但截止本文发布前:
零退款:
1天1块钱,你可以获得145个法律skills和40个法律专家团的支持。
即使1年后不再续订,这些skills和专家团依然可以继续使用,不会失效
长按以下二维码即可订阅,不用担心不会用,订阅后有使用方式介绍,也可以随时加王律微信JevonWangjiewen:
想要更好的合同审查工具,详细内容请点击:
从今天开始,用AI审查合同可以省30%以上的token了。
只服务你的法律职场导师,详细内容请点击:
仅需9元!享法内狂徒之职场导师服务1年!
主理人简介:
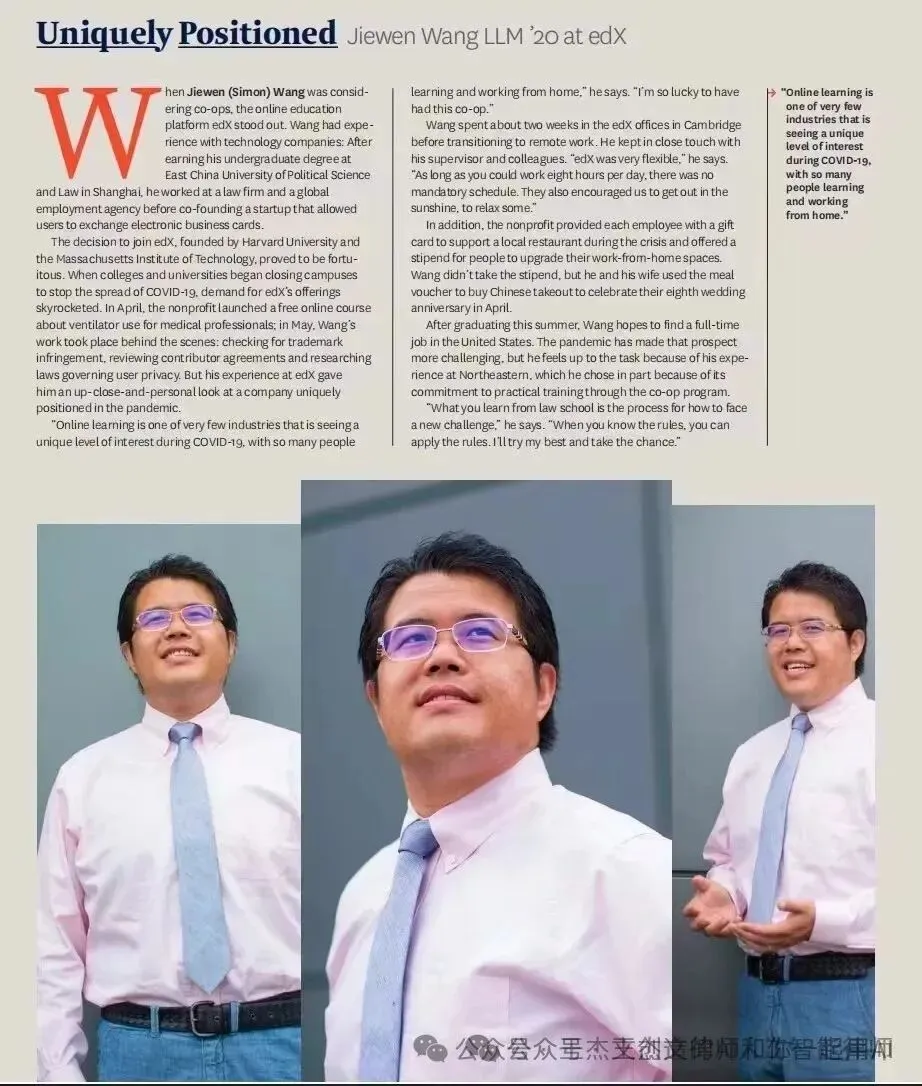
王杰文律师,本科及硕士均毕业于国内外顶尖法学院,前互联网创业者,后赴美求学,在美国求学时,在哈佛大学与麻省理工学院共同创立的互联网公司法务部门实习:
有幸成为法学院建校百余年第一位登上杂志的国际留学生:
王律的部分法律 AI 分享记录:
1.在温州律协分享法律AI
2.在北京中银律师事务所总所分享法律AI
3.在对外经济贸易大学法学院分享法律AI
4.在中国政法大学分享法律AI
5.在法天使分享法律AI
6.作为特聘专家,向东盟驻邕领事介绍中国法律AI
7.在广西律协分享法律AI
8.受邀在清华软件学院AI俱乐部分享
9. 王律接受腾讯ima采访全文
10.受腾讯ima邀请在周年庆上代表法律人分享
一节课了解最新DeepSeek Harness在法律行业的实践: